RSNA Knee, Part 0: MRI 한 검사와 열두 소견
그림은 눌러서 확대할 수 있습니다. 좁은 화면에서는 넓은 표와 수식을 좌우로 움직여 보세요.
RSNA Knee Abnormality Detection 대회는 무릎 MRI 한 검사에서 열두 소견의 확률을 예측하는 문제다. 입력은 여러 촬영 series로 이뤄지지만 출력은 열두 숫자로 고정돼 있다. 모델은 각 소견을 판단하는 데 필요한 정보를 영상에서 찾아 검사 단위의 예측으로 모아야 한다.
학습 데이터에서는 라벨을 만드는 과정부터 중요하다. 전체 4,407건 중 열두 소견의 전문가 라벨이 제공된 검사는 58건뿐이다. 나머지 4,349건은 아홉 언어로 작성된 판독문에서 학습 라벨을 얻어야 한다. Test에서는 판독문이 주어지지 않으므로, 영상 모델은 학습에 사용한 텍스트 없이 MRI만 보고 소견을 예측해야 한다.
예측 단위와 출력 구조
MRI 검사에는 촬영 방향과 sequence가 다른 여러 series가 있고, 각 series는 연속된 slice로 구성된다. 입력과 출력을 간단히 쓰면 다음과 같다.
\[\begin{aligned} \mathcal X&=\{x_{v,k}:v=1,\ldots,V;\ k=1,\ldots,n_v\},\\ \hat{\mathbf p}(\mathcal X)&\in[0,1]^{12}. \end{aligned}\]$v$는 series를, $k$는 그 안의 slice를 가리킨다. Series의 종류와 slice 수가 검사마다 달라도 모델은 같은 열두 출력을 만들어야 한다.
예측할 소견은 전방십자인대(ACL)와 내측측부인대(MCL)의 이상, 내측·외측 반월상연골의 이상, 내측·외측·슬개대퇴 구획의 골관절염, 관절삼출, 활막염, 베이커낭종, 타박상, 골절이다. 여러 소견이 함께 나타날 수 있으므로 각각 따로 예측해야 한다. 여러 범주 중 하나만 고르고 확률의 합이 하나가 되는 분류 문제와 다르다.
라벨이 검사 전체에 붙어 있다는 점도 모델 구조에 영향을 준다. 판독문에 반월상연골 파열이 적혀 있어도 어느 slice에 보이는지는 표시돼 있지 않다. 이 라벨을 모든 slice에 그대로 붙이면 파열이 보이지 않는 영상까지 양성 예제로 취급하게 된다. 따라서 개별 영상을 각각 분류하기보다는, 여러 영상의 정보를 모아 검사 단위로 예측하는 구조가 필요하다.
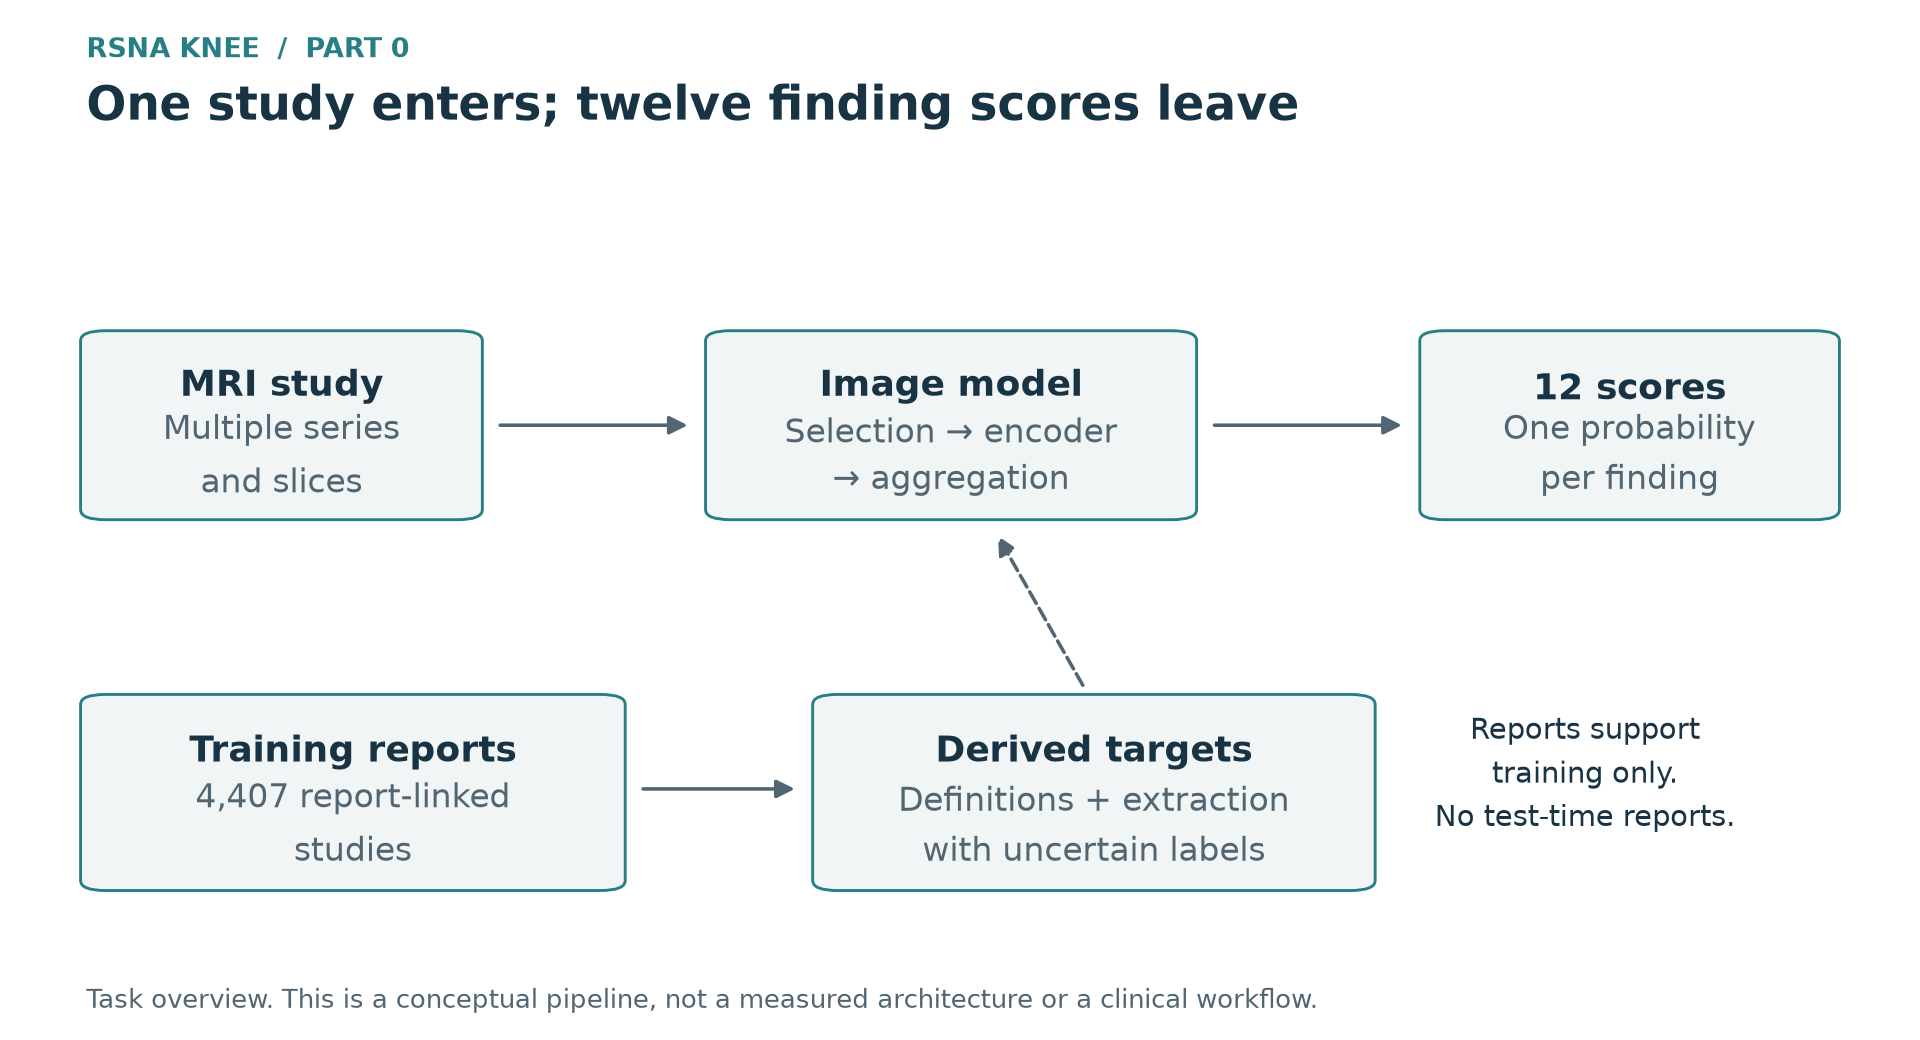 그림 1. Test에서는 영상이 입력이 된다. 판독문으로 만든 학습 라벨은 개별 slice가 아니라 검사 전체에 붙는다.
AUC와 검사 간 순위
대회 점수는 열두 ROC AUC의 단순 평균이다.
\[S=\frac{1}{12}\sum_{t=1}^{12}\operatorname{AUC}(y_t,p_t).\]한 소견의 AUC는 그 소견이 있는 검사와 없는 검사를 쌍으로 비교한다. 각각의 집합을 $\mathcal P$, $\mathcal N$이라고 하면 다음과 같이 쓸 수 있다.
\[\operatorname{AUC} =\frac{1}{|\mathcal P|\,|\mathcal N|} \sum_{i\in\mathcal P}\sum_{j\in\mathcal N} \left[\mathbf 1(p_i>p_j)+\tfrac12\mathbf 1(p_i=p_j)\right].\]순서를 맞힌 쌍에는 하나, 뒤집힌 쌍에는 영, 동점에는 절반을 준다. 검사 하나의 순위를 크게 잘못 매기면 여러 쌍에서 점수를 잃을 수 있다. 계산에는 0.5 같은 판정 기준값이 들어가지 않는다. 특정 기준값으로 소견의 유무를 나누는 대신, 소견이 있는 검사에 더 높은 점수를 주는지를 평가한다.
이 성질은 점수를 해석할 때도 중요하다. 첫째, 한 모델의 모든 예측값에 엄격히 증가하는 변환을 똑같이 적용하면 순서와 동점이 유지되므로 AUC도 유지된다. 따라서 AUC가 높다고 출력값 0.8이 임상적으로 보정된 80% 확률인 것은 아니다. 둘째, 각 소견은 발생 빈도와 관계없이 최종 점수에서 같은 비중을 차지한다. 흔한 소견에는 학습 예제가 더 많지만, 최종 평균에서 차지하는 비중까지 커지지는 않는다. 입력 구성을 바꿀 때도 전체 평균뿐 아니라 열두 소견 각각의 변화를 봐야 한다.
Ensemble에서는 예측값의 척도가 다시 중요해진다. 확률을 평균하면 모델이 낸 점수 사이의 간격을 그대로 사용하고, rank를 평균하면 그 간격 대신 상대적인 순위를 사용한다. 각 모델의 AUC가 같아도 변환한 뒤 합친 예측의 순서는 달라질 수 있다. 따라서 예측을 합치는 방법도 모델의 일부로 봐야 한다.
판독문 미언급과 영상 소견
판독문에는 검사의 모든 소견이 빠짐없이 기록되지는 않는다. 소견이 있다고 쓰거나, 없다고 명시하거나, 불확실성을 덧붙이거나, 아예 언급하지 않을 수 있다. 이를 열두 값으로 바꿀 때도 이런 차이를 살려야 한다.
다음은 이 문제를 설명하기 위해 만든 가상의 문장이다.
The anterior cruciate ligament is intact. A tear involves the medial meniscus. A small joint effusion is present.
첫 문장은 한 소견이 없다는 근거이고, 둘째는 다른 소견이 있다는 근거다. 셋째는 대회가 정한 소견의 정의에 맞춰 정도를 해석해야 한다. 나머지 소견은 적혀 있지 않다. 판독문에서 빠졌다는 이유만으로 영상에도 없다고 정할 수는 없다. 실제로 소견이 있는 검사에서도, 없는 검사에서도 해당 항목이 언급되지 않을 수 있기 때문이다.
규칙 기반 추출기는 문장을 정규화하고 해부학적 구조와 소견을 찾으며 부정 표현을 처리할 수 있다. 왜 그런 값을 냈는지 확인하기는 쉽지만, 언어별 어휘와 문장 구조를 얼마나 다루느냐에 따라 성능이 달라진다. LLM은 더 다양한 표현을 해석할 수 있다. 다른 문장의 단서로 소견을 추론할 수는 있어도, 판독문에서 빠진 영상 소견을 직접 확인하는 것은 아니다. 적힌 내용을 잘못 읽은 경우와 애초에 필요한 정보가 적혀 있지 않은 경우를 구분해야 한다.
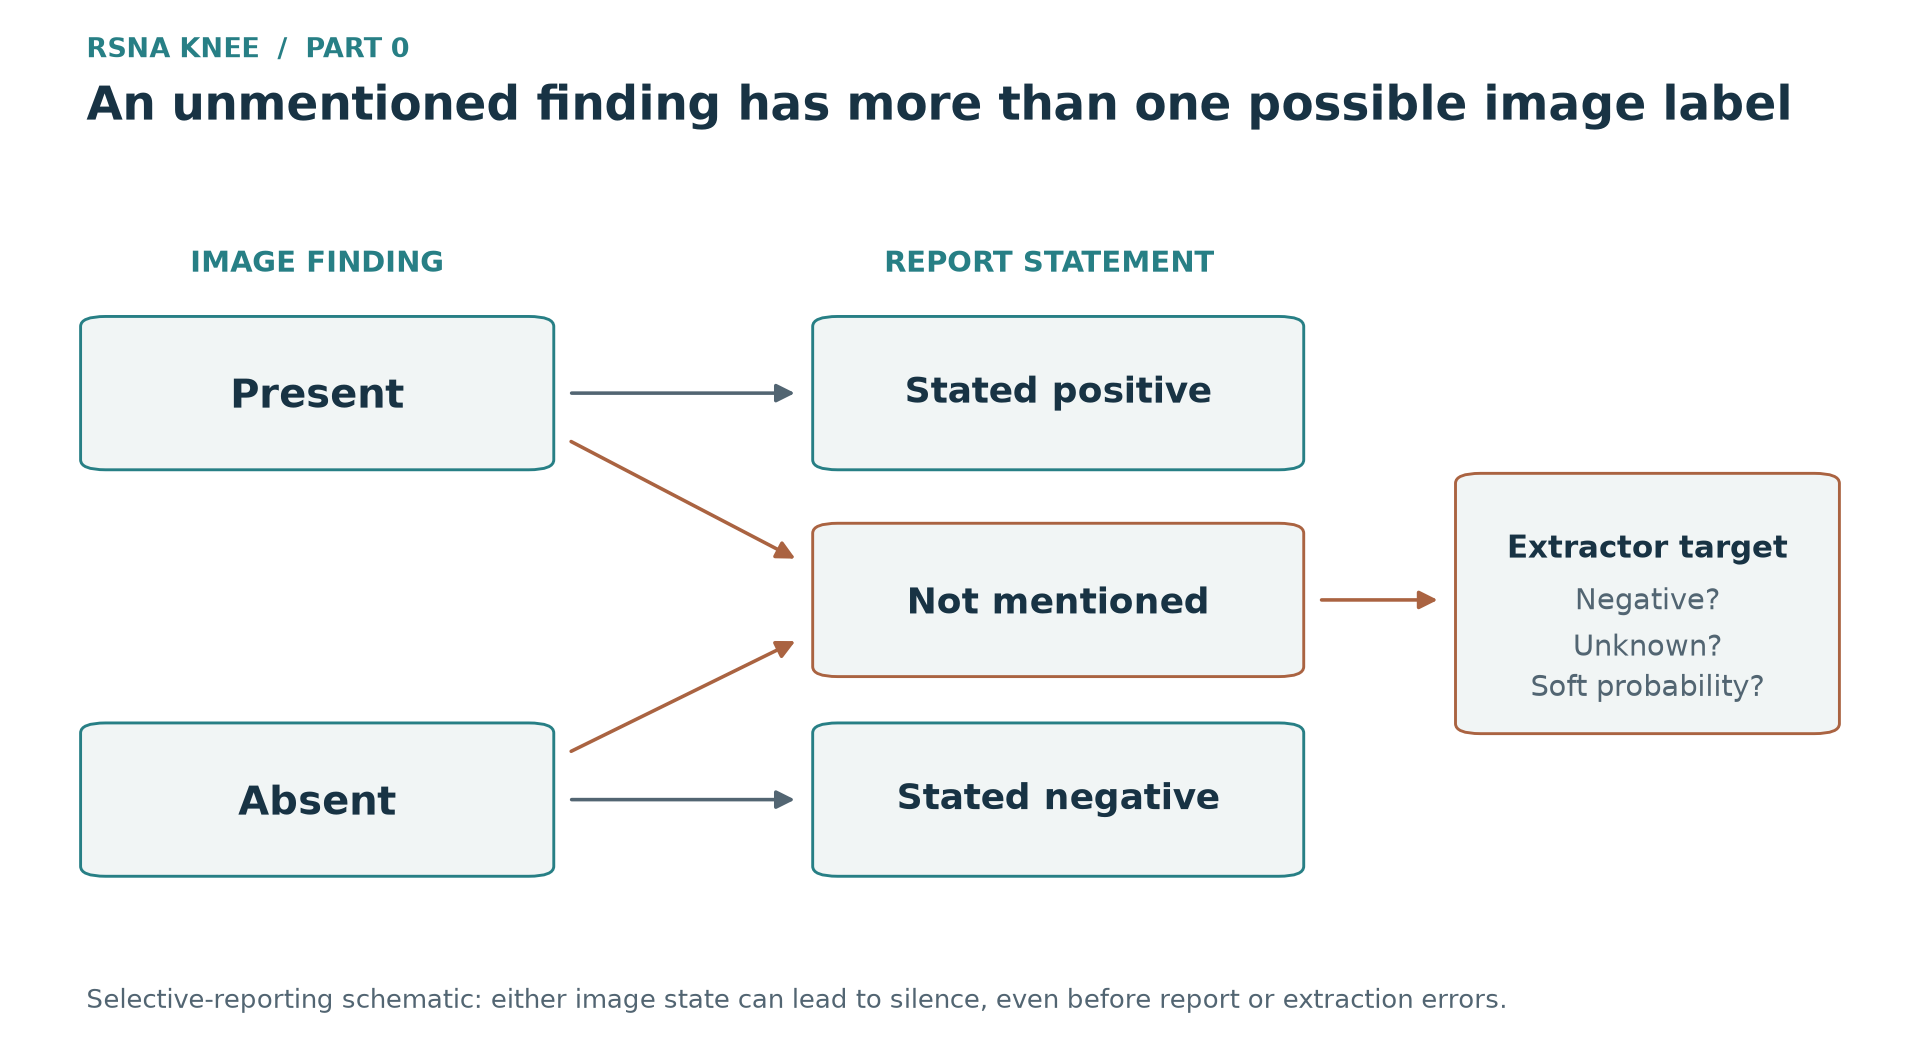 그림 2. 영상에 소견이 있어도 없어도 판독문에서 언급되지 않을 수 있다. 이를 음성, 미확인, soft target 중 무엇으로 표현할지는 학습 라벨을 정하는 선택이다. 이 그림은 실제 언급 빈도를 추정하지 않는다.
이렇게 얻은 라벨은 weak supervision이다. 명시적 부정과 미언급에 서로 다른 값을 주거나, 불확실한 진술에 soft target이나 별도의 학습 가중치를 줄 수 있다. 무엇을 택하느냐에 따라 영상 모델이 맞추도록 요구받는 값도 달라진다. 판독문을 제대로 해석했다는 신뢰도와 영상에 실제 소견이 있을 확률 역시 구분해야 한다.
전문가 라벨이 있는 58건에서는 추출한 라벨이 전문가 주석과 얼마나 일치하는지 살펴볼 수 있다. 다만 이는 라벨 표의 평가다. 영상 모델을 평가하려면 학습에서 제외한 검사에 대한 예측이 필요하다. OOF는 각 검사를 해당 모델의 학습에서 제외하지만, 추출한 라벨로 채점한다면 측정하는 것은 여전히 그 라벨과의 일치도다. 판독문을 더 잘 해석하는지와 영상 소견을 더 잘 예측하는지는 따로 확인해야 한다.
영상 표현과 관찰 범위
전처리에서 잘라낸 해부학적 구조는 모델이 직접 볼 수 없다. 그 부위의 소견을 추론하려면 남은 영상의 단서에 의존해야 한다. Series 선택, 물리적 크기, slice sampling도 encoder만큼 중요한 이유다.
입력은 여섯 sequence slot으로 구성한다. 지방 억제를 적용한 sagittal·coronal·axial fluid-sensitive 영상, 지방 억제가 없는 sagittal fluid-sensitive 영상, coronal·sagittal T1 영상이다. Sequence description과 header 값으로 각 slot에 넣을 series를 고르고, 빠진 slot도 명시적으로 표현한다. 같은 종류의 영상을 같은 slot에 넣으면 검사마다 입력의 역할을 맞출 수 있다. 모델이 뒤섞인 영상에서 각 series의 역할까지 알아내야 하는 부담을 줄이는 방식이다.
한 series 안에서는 물리적 위치를 기준으로 slice를 정렬한다. 파일 이름은 식별자일 뿐이므로, 이름순으로 정렬하면 해부학적으로 의미 없는 순서가 될 수 있다. 같은 stack에 속하고 방향이 일관된 영상이라면 DICOM의 orientation과 position으로 공간 좌표를 구할 수 있다.
DICOM geometry로 slice를 정렬하는 방법
영상 평면의 두 방향 벡터 $\mathbf r$과 $\mathbf c$를 외적하면 slice의 법선을 얻는다.
\[\mathbf n=\mathbf r\times\mathbf c.\]영상 위치 $\mathbf x_i$를 이 법선에 투영한 값이 정렬 좌표다.
\[k_i=\mathbf x_i\cdot\mathbf n.\]위치가 중복되거나 orientation이 일정하지 않은 영상, localizer, header가 불완전한 영상은 별도로 처리해야 한다. Instance number를 보조 수단으로 쓸 수는 있지만, 그것만으로 slice들이 일관된 공간 구조를 이루는지 확인할 수는 없다.
Crop에서는 물리적 범위를 얼마나 남길지 정해야 한다. 폭 $L$ mm를 잘라 $P$ 픽셀로 크기를 맞추면 출력 영상의 명목상 pixel pitch는 다음과 같다.
\[s_{\mathrm{eff}}=\frac{L}{P}\quad\text{millimetres per pixel}.\]넓은 촬영 범위를 336 pixel로 줄인 영상과 관절 주위만 좁게 잘라 336 pixel로 만든 영상에서는 같은 구조도 다른 크기로 보인다. 좁게 자르면 국소 구조에 더 많은 pixel을 할당할 수 있지만 주변 정보가 사라진다. 출력 해상도를 높이면 세부 정보를 더 남길 수 있는 대신 메모리와 연산량이 늘어난다. 위 식은 전처리한 입력의 pixel pitch를 나타낸다. 원래 촬영의 해상도와 contrast가 가진 한계까지 바뀌는 것은 아니다.
Volume에서 slice를 고를 때도 비슷한 절충이 필요하다. 개수를 고정한 채 넓게 고르면 더 많은 해부학적 범위를 포함할 수 있지만, slice 사이의 간격이 벌어져 작은 병변을 건너뛸 수 있다. 촘촘히 고르면 인접 slice의 관계를 더 잘 보존하는 대신 관찰 범위가 좁아진다. 중요한 slice가 입력에서 빠졌다면 encoder의 크기만 키워 해결하기는 어렵다.
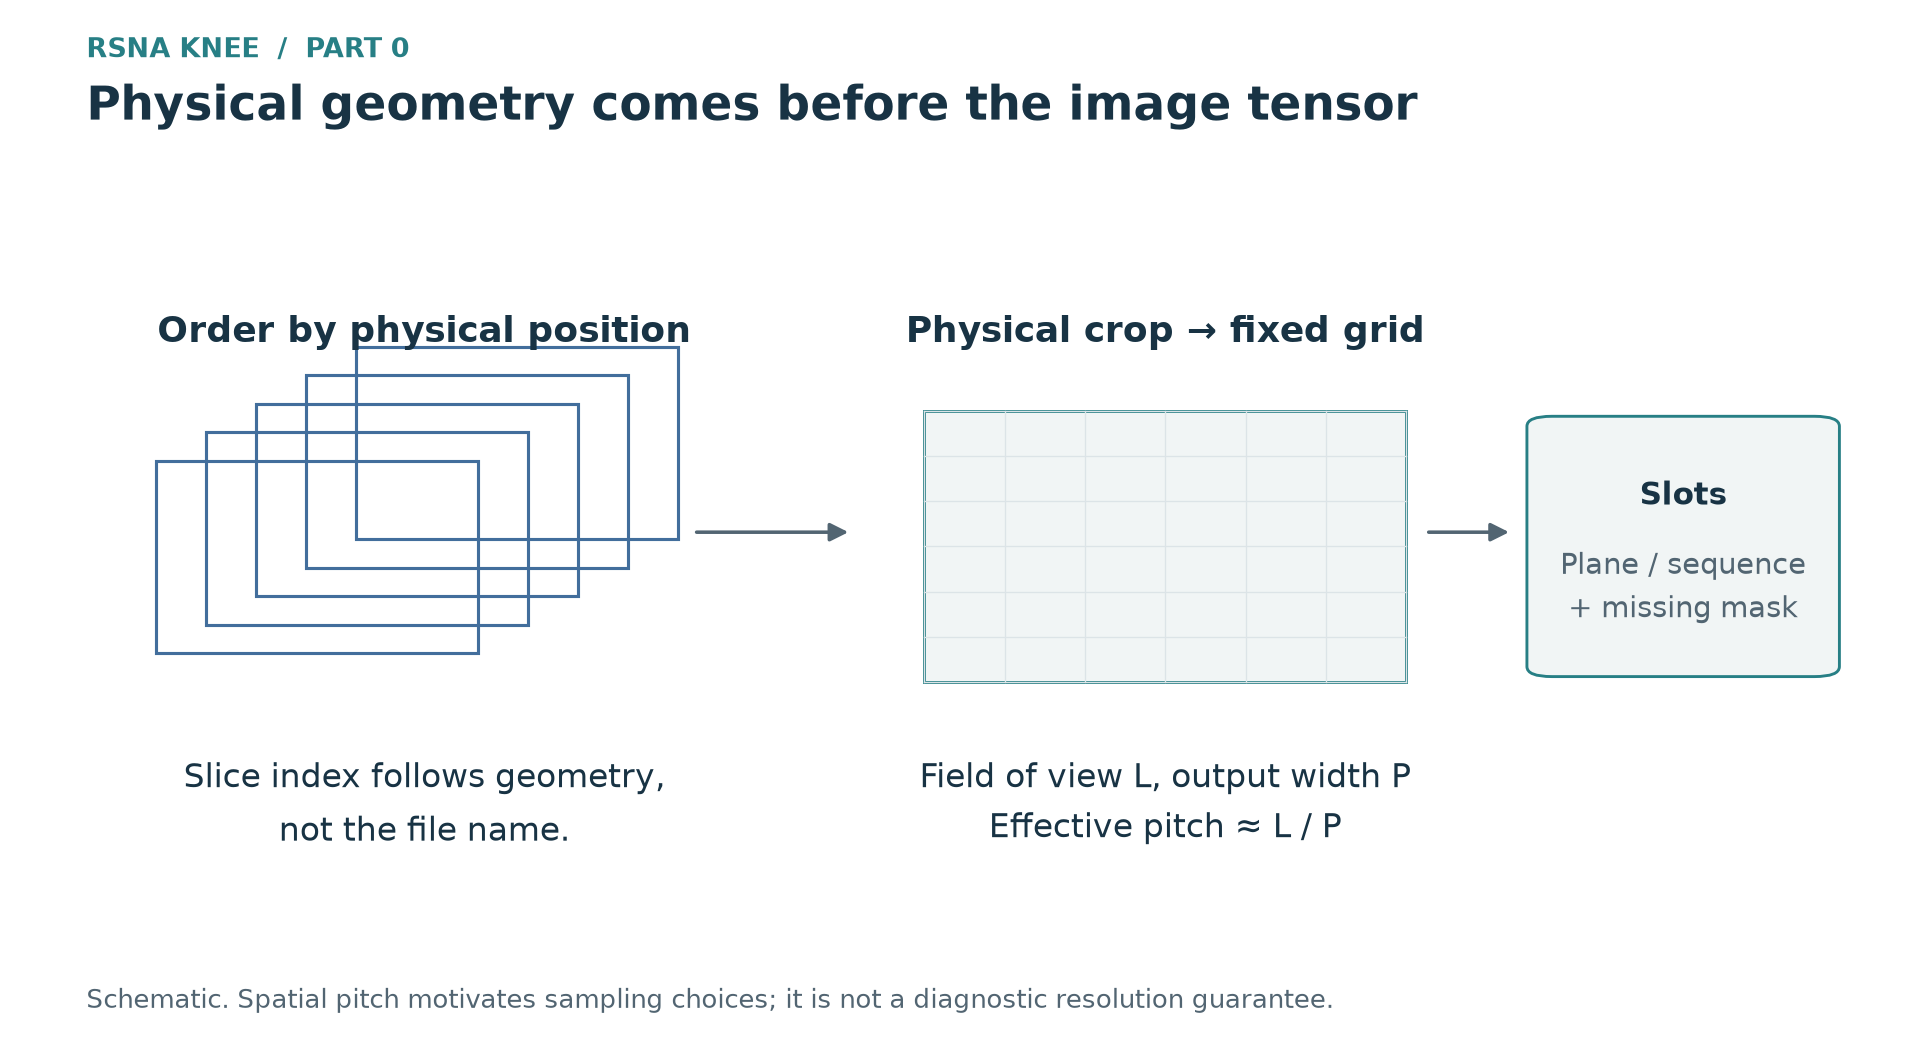 그림 3. Geometry로 공간적 순서와 크기를 정한다. 이어서 crop과 표본화 밀도에 따라 모델에 들어가는 해부학적 근거가 달라진다.
영상 특징과 검사 단위 예측
사전학습한 encoder는 선택한 각 영상을 특징으로 바꾸고, 뒤쪽 모델은 여러 slice와 촬영 방향에서 얻은 특징을 합친다. 개별 영상의 라벨과 검사 전체의 라벨이 다르다는 점이 여기서 중요해진다. 모델은 어떤 영상이 각 소견의 판단에 도움이 되는지 학습해야 한다.
단순 평균은 선택한 모든 영상을 같은 비중으로 다룬다. 소견이 몇 slice에만 보인다면 무관한 영상이 많을수록 그 신호가 희석될 수 있다. Attention을 사용하면 특징마다, 나아가 소견마다 다른 가중치를 학습할 수 있다. 다만 어떤 영상이 중요한지 알려 주는 것은 여전히 검사 단위 라벨이다. Attention 가중치를 볼 수 있다는 사실만으로 병변의 위치를 정확히 찾았다고 할 수는 없다.
라벨과 영상 구성의 영향은 이 단계에서 맞물린다. 미언급을 반복해서 음성으로 처리하면 영상에 소견이 있어도 높은 예측값에 손실을 부과할 수 있다. 반대로 관련 영상이 입력에서 빠지면 정확한 양성 라벨이 있어도 그 모습을 배우지 못한다. 라벨 표, crop, 집계 방법 중 하나를 바꾸면 다른 구성 요소의 효과도 달라질 수 있다. 따라서 무엇을 바꿔 얻은 결과인지 구분하지 않고 encoder 이름만으로 성능을 설명해서는 안 된다.
추론 경로와 비용 제약
T4 GPU 두 장에서 아홉 시간이라는 한도는 hidden test 전체의 추론에 적용된다. 영상 decoding과 전처리, 모델 계산, 예측 집계, 출력 파일 생성까지 모두 이 안에 끝내야 한다. 학습 비용과 최종 추론 비용은 따로 계산해야 한다.
전처리한 영상을 cache에 저장하면 학습할 때마다 같은 DICOM을 읽고 준비하는 비용을 줄일 수 있다. Pixel당 한 byte를 쓴다면 주요 저장 용량은 대략 다음 항에 비례한다.
\[N_{\mathrm{studies}}\,N_{\mathrm{slots}}\,N_{\mathrm{slices}}\,P^2.\]영상의 가로와 세로를 두 배로 늘리면 mask나 저장 형식에 필요한 부가 용량을 제외해도 이 항은 네 배가 된다. 해상도를 높일 때는 모델의 GPU 사용량뿐 아니라 전처리 비용과 저장 공간도 고려해야 한다.
초기에는 검사마다 window를 몇 개 읽을지도 비교했다. Window는 한 번에 고른 영상 묶음이다. 같은 모델이 여러 window를 읽으면 검사의 서로 다른 부분을 볼 수 있다. $M$개의 checkpoint가 각각 $W$개의 window에서 낸 확률을 평균한다면, 한 소견의 최종 예측은 다음과 같다.
\[\bar p_t=\frac{1}{MW}\sum_{m=1}^{M}\sum_{w=1}^{W}p_{m,w,t}.\]Window를 추가하면 관찰 범위를 넓히거나 여러 예측을 평균해 불안정성을 줄일 수 있다. 별도로 학습한 모델을 추가하면 다른 특징을 활용하거나 학습 과정에서 생긴 변동을 줄일 수 있다. 둘 다 추론 시간을 더 쓰지만 보완하려는 오류는 다르다. 예측 개수가 늘어난다는 이유만으로 같은 선택으로 볼 수는 없다.
초기 local 비교에서 window를 하나, 네 개, 열 개 읽었을 때 AUC는 각각 0.8218, 0.8397, 0.8428이었다. 하나에서 열 개로 늘려 얻은 개선의 대부분은 네 개만 읽어도 얻었다. 여섯 개를 더 읽어 추가로 얻은 개선은 0.0031이었고, 모델이 처리하는 window 수도 네 개에서 열 개로 늘었다. 이 수치는 8월 8일 local 실험 결과다. 대회 점수도 아니고 실제 실행 시간을 측정한 결과도 아니다.
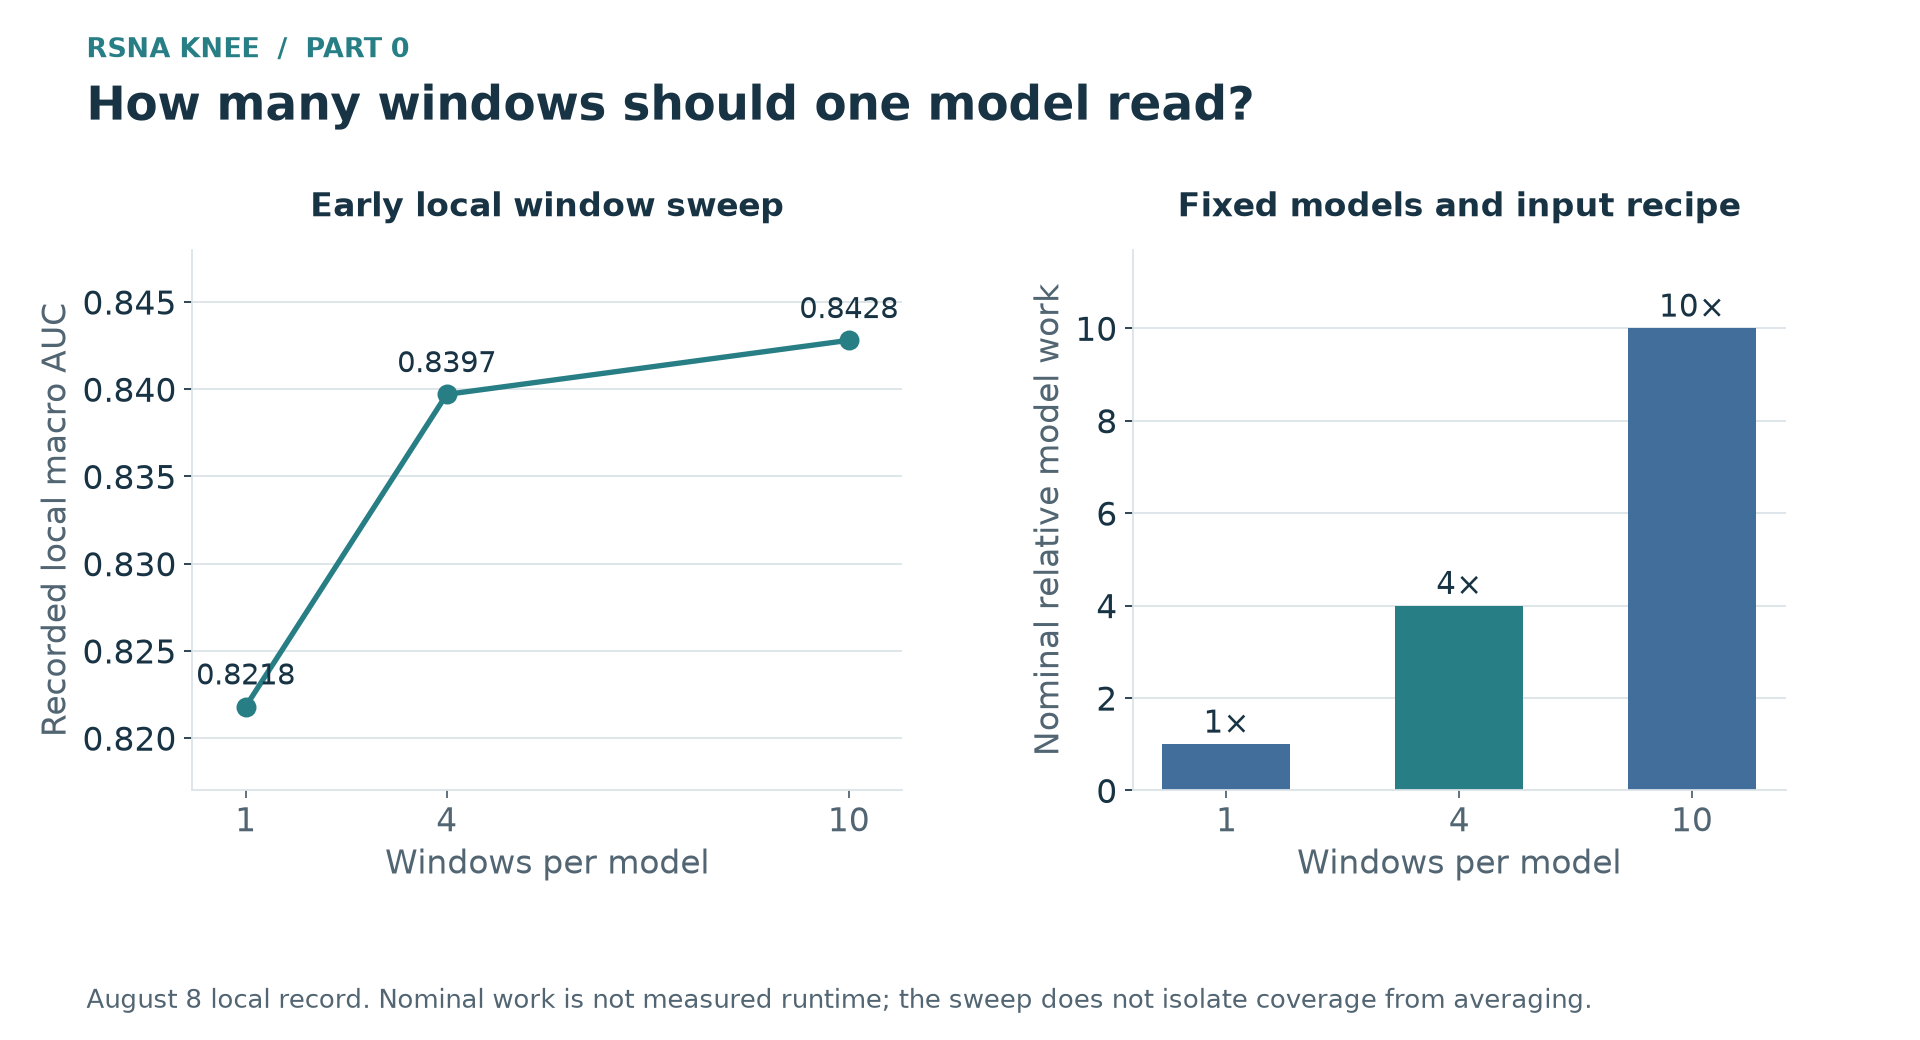 그림 4. 이 비교에서는 window를 늘릴수록 local AUC가 높아졌지만 추가 개선 폭은 줄었다. 오른쪽은 모델과 입력 구성을 고정했을 때의 명목상 계산량이며 실제 실행 시간이 아니다. 해부학적 범위를 더 본 효과와 여러 예측을 평균한 효과는 이 비교에서 분리하지 않았다.
전체 모델을 실행하고도 시간이 충분히 남는다면 열 window를 읽을 만하다. 시간이 빠듯하다면 마지막 몇 window를 읽는 대신 다른 checkpoint나 입력 구성에 시간을 쓰는 편이 나을지 비교해야 한다. 이 곡선만으로 그 답을 정할 수는 없다. 다만 영상을 읽는 방법도 모델 선택에 포함해야 한다는 점은 분명하다. 같은 모델이라도 어떤 영상을 보느냐에 따라 예측이 달라진다.
Ensemble의 추론 시간은 모델들이 어떤 계산을 공유할 수 있는지에 따라 달라진다. 같은 전처리 영상을 쓰면 decoding과 전처리를 재사용할 수 있지만, crop이나 slice 구성이 다르면 추가 준비가 필요할 수 있다. Checkpoint 개수만 세어서는 제한 시간 안에 들어갈지 알 수 없다. 검사 전체에서 어떤 정보를 읽고 열두 예측값을 만드는지, 그 과정이 허용된 장비에서 얼마나 걸리는지를 함께 비교해야 한다.