Enveda CASMI 2026: 질량스펙트럼에서 분자 구조를 찾아내는 AI
CASMI 2026은 어떤 대회이며 무엇부터 시작해야 할까? 미지 분자 하나의 식별 과정을 따라 물리화학, 데이터와 평가, 공개 노트북·리더보드의 현재 수준, 첫 실험과 향후 전략을 연결한다.
시작하며: 제약 조건이 있는 분자 구조 순위화 문제
Enveda CASMI 2026의 과제는 탠덤 질량스펙트럼에서 원자의 연결 구조를 추론하는 것이다. 미지 분자마다 SMILES를 최대 25개까지 순서대로 제출하며, 호변이성질체 정규화 후 InChIKey14가 정답과 일치하는 첫 후보의 순위로 점수를 받는다. 세 가지 어려움이 맞물린 역문제다. 관찰값은 측정 조건에 따라 달라지고, 서로 다른 구조에서 비슷한 조각이 나올 수 있으며, 정답 구조가 후보 데이터베이스에 없을 수도 있다.
따라서 실제 시스템에는 후보 검색, 스펙트럼·구조 표현 학습, 후보 순위화, 필요에 따른 구조 생성이 함께 들어간다. 2012년에 시작된 CASMI(Critical Assessment of Small Molecule Identification)의 과학적 목표는 정답 참조를 그대로 찾는 단계를 넘어 어디까지 식별할 수 있는지 평가하는 데 있다. 참가자의 구현 목표는 이 방법들을 하나의 오프라인 노트북으로 묶어 정해진 시간 안에 미지 분자를 처리하는 것이다. 대회 소개 · 데이터
이 글은 확률·최적화·기초 화학을 학부 수준에서 접한 독자를 대상으로 한다. 공개된 Caffeine 실측 스펙트럼으로 데이터가 실제로 어떻게 표현되는지 따라가고, Eugenol/Isoeugenol로 같은 분자식 안에서 구조를 구별하는 문제를 살펴본다. 계산 예제는 실측값과 구분하며, 도식만으로 모델 성능을 주장하지 않는다. 1–6절은 과제와 물리적 증거, 7–10절은 모델 설계, 11–15절은 분자 단위 OOF 검증과 학습 예산·제출 시 모델 선택을 다룬다.
프로젝트의 핵심 질문은 모델·후보 자료·관찰을 하나 더 넣었을 때, 추가 추론 비용을 감수할 만큼 검증 분자의 순위가 좋아지는가이다. 단독 성능이 강한 모델도 앙상블에서는 중복일 수 있다. 반대로 단독 점수가 낮아도 다른 분자를 해결한다면 가치가 있다. 다만 후보 구성 단계에서 정답을 제거했다면 어느 모델도 그 정답의 순위를 높일 수 없다. 12절의 공개 현황과 프로젝트 상태는 2026년 9월 27일 기준이며, 이후의 실험 설계는 새로 측정한 개선 결과가 아니라 다음 비교를 위한 제안이다.
1. 입력과 출력: 실측 스펙트럼 세 개를 따라가 보기
예측 단위는 분자 하나다. molecule_id가 같은 여러 행을 모아 하나의 SMILES 순위 목록을 만든다. 공식 설명에 따르면 숨은 테스트에는 Bruker timsTOF로 측정한 약 400개 분자, 약 1,500개 스펙트럼이 들어 있다. 분자당 관찰 수는 1–16개이며 중앙값은 3개다. 데이터 설명
실제 숫자로 살펴보기 위해 MassBank에 공개된 Eawag의 Caffeine 측정 기록 EA030309, EA030311, EA030312를 사용하자. LTQ Orbitrap XL에서 얻은 HCD 실측 스펙트럼이며, CASMI 관측값은 아니다. 세 기록 모두 선택 전구체가 m/z 195.0877의 [M+H]+이고, 연결 구조를 나타내는 키는 RYYVLZVUVIJVGH로 같다. 30% 기록 · 60% 기록 · 75% 기록
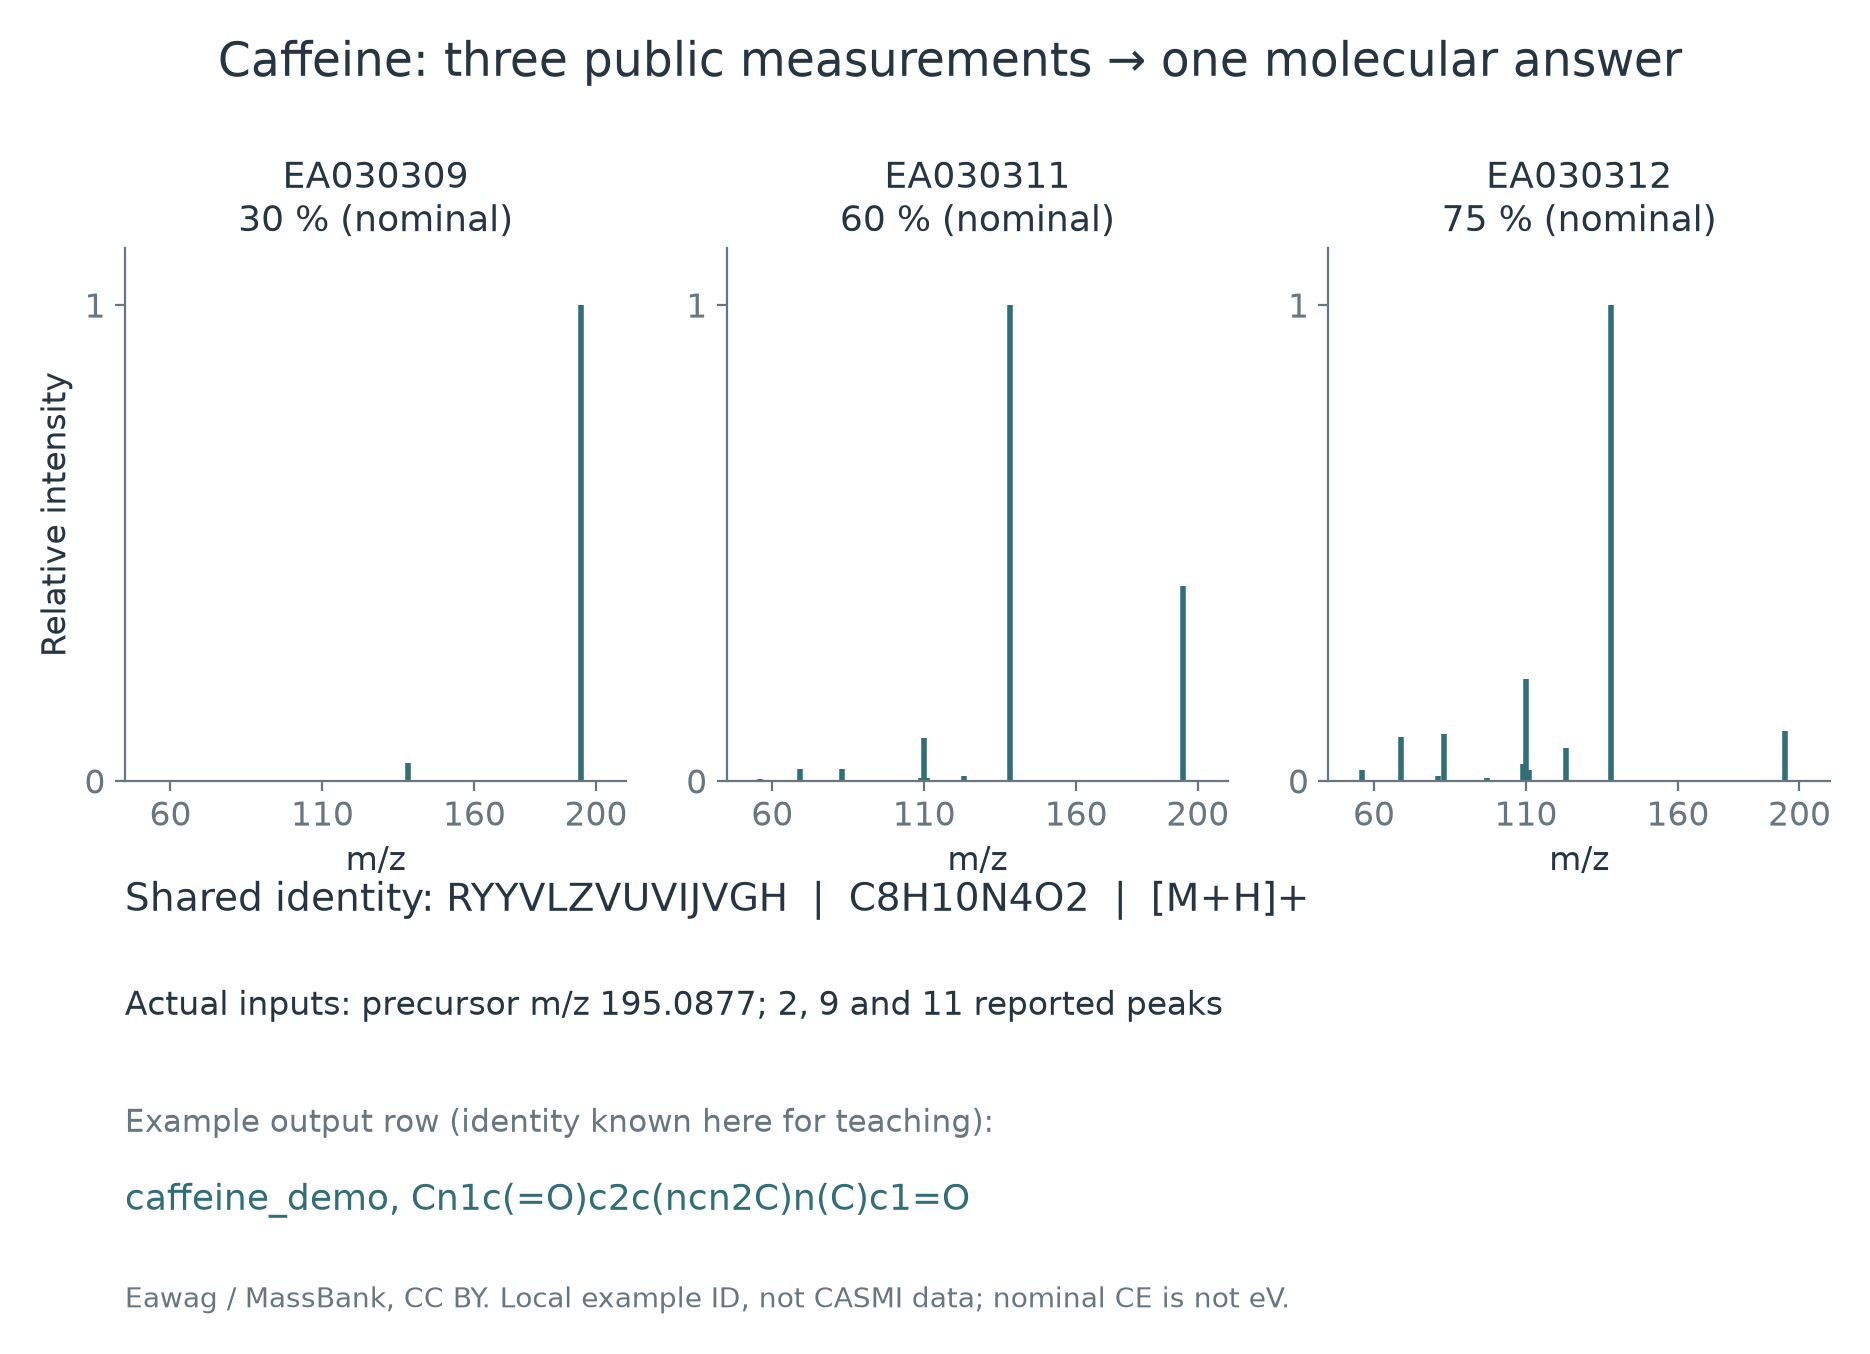
| MassBank 기록 | 원문 충돌 에너지 | 기재된 피크 수 | m/z 195.0877 부근 강도 | m/z 138.0662 부근 강도 | m/z 110.0713 부근 강도 |
|---|---|---|---|---|---|
| EA030309 | 명목값 30% | 2 | 1.0000 | 0.03693 | 미기재 |
| EA030311 | 명목값 60% | 9 | 0.40994 | 1.0000 | 0.08968 |
| EA030312 | 명목값 75% | 11 | 0.10565 | 1.0000 | 0.21480 |
위 강도는 원래 신호값에서 다시 계산해 각 스펙트럼의 최대값을 1로 맞췄다. 처리된 기록에 피크가 없다는 사실만으로 실제 존재량이 0이었다고 단정할 수는 없다. 원본 기록, 전체 피크, 계산에 사용한 메타데이터는 공용 예제 JSON에 담았다.
30% 측정값의 피크 두 개 전체를 CASMI 입력의 관련 필드에 맞춰 적으면 다음과 같다. ID는 예제용이고, source_collision_energy는 출처를 보존하기 위해 추가한 필드다. 대회 공식 열은 아니다. 명목 에너지의 % 값을 eV로 바꿔 쓸 수 없으므로 eV 필드는 결측으로 남긴다.
1
2
3
4
5
6
7
8
9
10
11
12
example = {
    "molecule_id": "caffeine_demo",
    "spectrum_id": "EA030309",
    "precursor_mz": 195.0877,
    "adduct": "[M+H]+",
    "ionization_mode": "positive",
    "instrument_type": "LC-ESI-ITFT",
    "collision_energy_ev": None,
    "source_collision_energy": "30% nominal",
    "ms2_mzs": [138.0661, 195.0877],
    "ms2_normalized_intensities": [0.0369303417, 1.0],
}
EA030311과 EA030312에도 같은 caffeine_demo를 부여하되 각 기록의 피크 배열과 측정 조건은 유지한다. 식별 모델은 세 관찰로 구조 후보의 순서를 정해야 한다. 스펙트럼마다 답을 따로 내는 것이 아니다. 이 설명에서는 Caffeine이라는 정답을 알고 있으므로 출력 형식을 다음처럼 보여줄 수 있다.
molecule_id,smiles
caffeine_demo,Cn1c(=O)c2c(ncn2C)n(C)c1=O
실제 예측에서는 두 번째 필드에 후보를 최대 25개까지 신뢰도순으로 쓰고 세미콜론으로 구분한다. 위 행은 그룹화와 파일 형식을 보여주는 예제이며 모델의 식별 성능을 뜻하지 않는다.
| 정보 | 대회 열 | 예제에서의 의미 |
|---|---|---|
| 질의 그룹 | molecule_id, spectrum_id | Caffeine 기록 세 개를 한 답으로 묶되 각 측정값을 추적할 수 있게 한다. |
| 전구체 | precursor_mz, adduct | 195.0877과 [M+H]+로부터 중성 질량 약 194.080424 Da를 얻는다. |
| 조각 이온 | ms2_mzs, ms2_normalized_intensities | [138.0661, 195.0877]과 [0.03693, 1.0]이 원소별로 짝을 이룬다. |
| 측정 조건 | ionization_mode, instrument_type, collision_energy_ev | 극성과 장비 정보를 유지하고 근거 없는 eV 변환을 하지 않는다. |
| 학습 정답·출처 | normalized_smiles, inchikey, ingest_lib | 학습 구조를 식별하고 어느 라이브러리에서 측정했는지 확인한다. |
확인한 학습 파일에는 테스트용 ID 열이 없으므로 정규화한 구조로 학습 그룹을 만든다. 에너지 배열과 결측값도 실제 스키마에서 확인해야 한다. 정답 분자식이나 완전한 MS1 동위원소 분포가 테스트 입력에 일반적으로 주어지는 것은 아니다.
데이터 참고: 내려받을 수 있는 test.parquet은 학습 자료에서 만든 실행 확인용 파일이다. 입출력·실행 시간은 이 파일로 점검하고, 정확도는 별도의 분자 검증 집합에서 측정한다. Kaggle 공개 점수는 숨은 평가 데이터에서 나온다. 공식 데이터 설명 참고.
2. MRR@25: 정답을 찾는 것과 앞에 놓는 것
평가 지표는 Mean Reciprocal Rank, 평균 역순위다. 각 분자의 후보 목록에서 첫 번째 정답의 위치가 \(r\)이면 \(1/r\)점을 얻고, 25개 안에 정답이 없으면 0점이다. 이를 분자 수 \(U\)로 평균한다. 기준은 공식 평가 설명과 코드다.
\[\begin{aligned} \operatorname{MRR@25}&=\frac{1}{U}\sum_{u=1}^{U}\operatorname{RR}_u,\\ \operatorname{RR}_u&=\begin{cases} 1/r_u, & r_u\leq25,\\ 0, & \text{otherwise}. \end{cases} \end{aligned}\]예를 들어 네 분자의 정답 순위가 각각 1위, 2위, 5위, 목록 밖이라면 다음 점수가 된다.
\[\frac{1+0.5+0.2+0}{4}=0.425.\]이 숫자는 계산을 설명하기 위한 가상 예제다. 어떤 모델의 실제 성능을 의미하지 않는다.
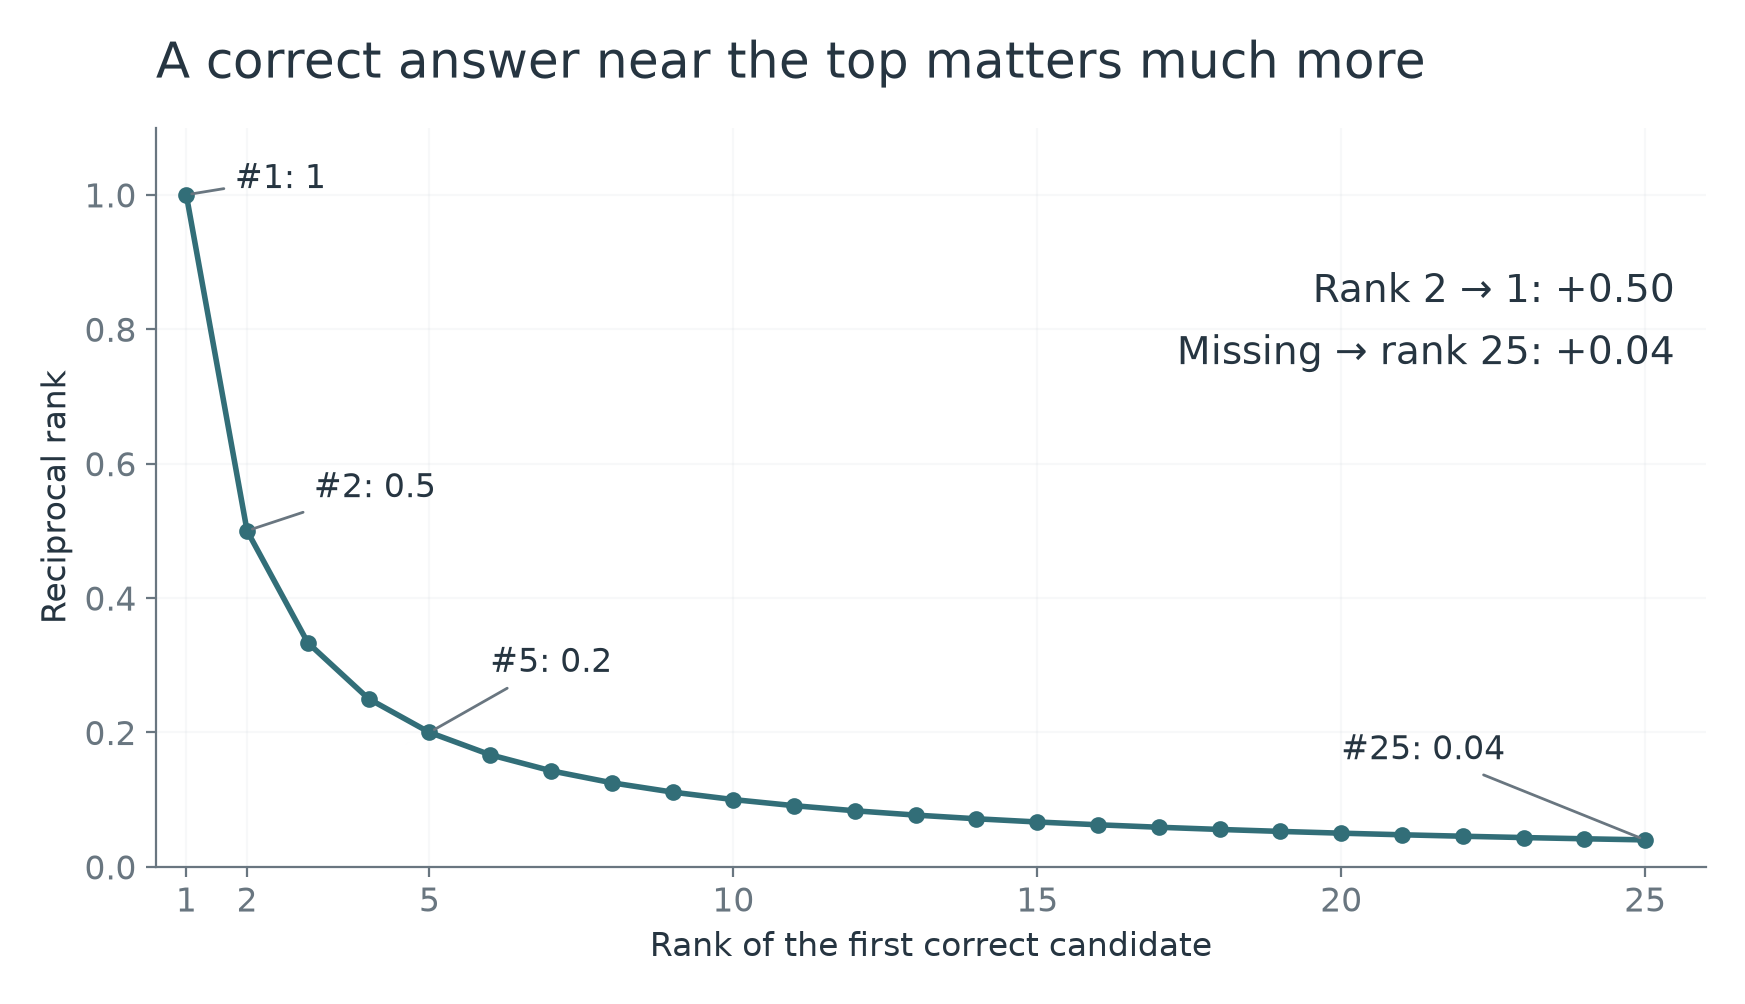
이 평가에는 두 가지 중요한 성질이 있다. 첫째, 25위에 간신히 넣는 것도 정답을 놓치는 것보다는 낫다. 둘째, 이미 2위에 있는 정답을 1위로 올리는 이득은 훨씬 크다. 한 분자에서 2위→1위의 변화는 0.5, 목록 밖→25위의 변화는 0.04이므로 전자가 12.5배 크다.
그래서 대회를 후보 생성 하나로만 볼 수 없다. 정답이 후보 안에 들어오는지와 들어온 정답을 앞에 배치하는지를 따로 측정해야 한다.
| 지표 | 답하는 질문 |
|---|---|
| 후보 포함률(Recall@K) | 순위 모델에 넘기는 K개 중 정답이 있는가? |
| 최종 정답 포함률(Hit@25) | 제출할 25개 안에 정답이 있는가? |
| 1순위 정확도(Top-1) | 가장 앞에 놓은 후보가 정답인가? |
| MRR@25 | 정답을 얼마나 자주, 얼마나 앞에서 찾는가? |
K가 1,000인 검색 후보 풀과 최종 25개 목록은 서로 다른 단계다. 후보 풀에 정답이 없다면 이후 순위 모델은 그 분자를 맞힐 수 없다. 반대로 Recall@1,000이 높아도 정답이 늘 50위에 머무르면 최종 점수는 낮다.
무엇을 같은 분자로 인정하는가
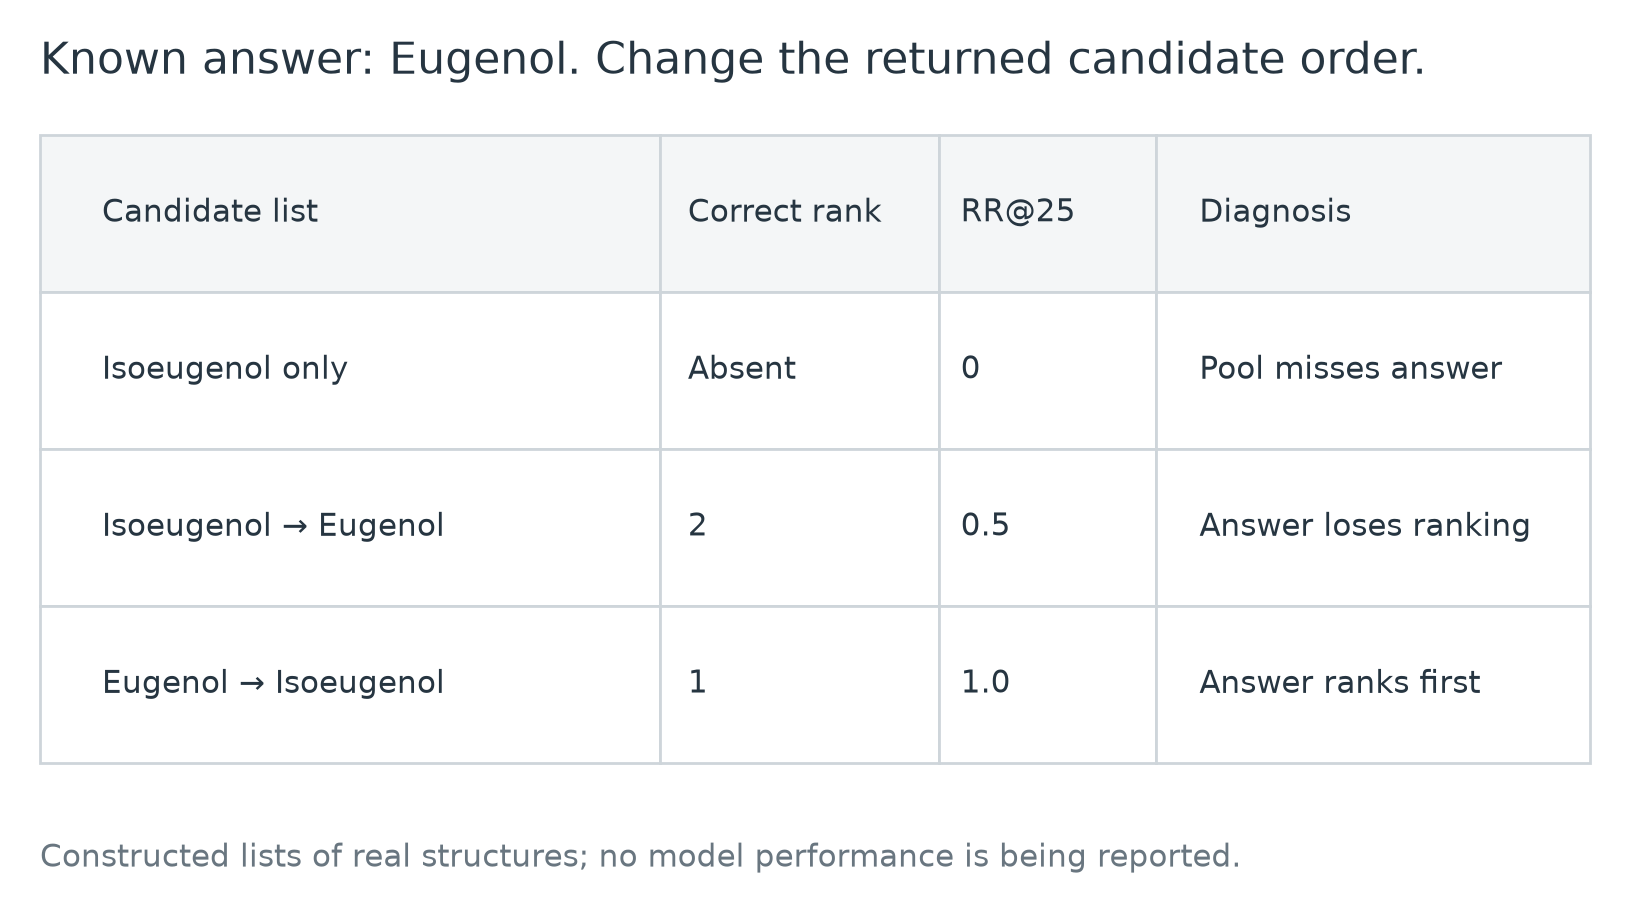
대회는 RDKit 2026.03.3으로 호변이성질체를 정규화한 뒤, InChIKey의 앞 14자리를 비교한다. 호변이성질체(tautomer)는 수소의 위치와 결합 배치가 달라지는 서로 관련된 구조다. 이 절차를 거치면 대회가 동일한 것으로 취급하는 형태들을 같은 키로 묶을 수 있다. InChIKey의 앞부분을 사용하므로 입체화학 차이도 최종 일치 판단에서는 구별하지 않는다. 공식 평가 코드
이는 “분자식이 같으면 정답”이라는 뜻은 아니다. Eugenol과 Isoeugenol은 앞의 예처럼 다른 키를 갖는다. 반면 Isoeugenol의 E/Z 입체이성질체는 이 평가에서 같은 연결성으로 취급된다. 대회에서 정답으로 인정받는 것과 실험실에서 구조를 완전히 규명하는 것은 범위가 다르다.
코드로 확인하기: 점수 계산용 키와 후보 중복 제거
다음은 정상적인 단일 분자 SMILES에 대해 핵심 정규화 규칙을 확인하는 작은 예제다. 전체 제출 형식 검사와 공식 채점기의 예외 처리를 대체하지는 않는다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
from rdkit import Chem, rdBase
from rdkit.Chem.MolStandardize import rdMolStandardize

assert rdBase.rdkitVersion == "2026.03.3"
tautomers = rdMolStandardize.TautomerEnumerator()

def scoring_key(smiles):
    mol = Chem.MolFromSmiles(smiles)
    if mol is None:
        raise ValueError(f"Invalid SMILES: {smiles}")
    canonical = tautomers.Canonicalize(mol)
    key = Chem.MolToInchiKey(canonical)
    if not key:
        raise ValueError("InChIKey conversion failed")
    return key[:14]

def unique_candidates(ranked_smiles, limit=25):
    seen, result = set(), []
    for smiles in ranked_smiles:
        key = scoring_key(smiles)
        if key in seen:
            continue
        seen.add(key)
        result.append(smiles)
        if len(result) == limit:
            break
    return result

assert scoring_key("COc1cc(CC=C)ccc1O") != scoring_key("COc1cc(C=CC)ccc1O")
assert scoring_key("C/C=C/c1ccc(O)c(OC)c1") == scoring_key("C/C=C\\c1ccc(O)c(OC)c1")
모델이 생성한 잘못된 SMILES를 처리할 때는 먼저 파싱 실패를 기록하고 후보에서 제외하는 별도의 단계를 둔다. 최종 파일을 만드는 단계에서는 이런 입력이 남아 있지 않도록 확인한다. 원본 후보 순서를 유지하며 중복을 제거해야 순위가 의도대로 보존된다.
후보 재현율은 점수의 상한을 정하지만 점수 자체는 아니다
최종 목록을 후보 풀 \(C_u\) 안에서만 만든다면 표본의 점수는 다음처럼 분해된다.
\[\begin{aligned} \operatorname{MRR@25}&=\widehat P(y_u\in C_u)\\ &\quad\times\widehat E\!\left[\frac{\mathbf1\{r_u\leq25\}}{r_u}\;\middle|\;y_u\in C_u\right]. \end{aligned}\]예를 들어 후보 재현율이 80%이고 정답이 있는 분자들의 평균 RR이 0.5라면 MRR은 0.40이다. 데이터베이스를 넓혀 재현율을 90%로 올려도 추가 오답 후보 때문에 조건부 RR이 0.4로 낮아지면 0.36이 된다. 프로젝트 결과가 아니라 계산 예제다. 후보 확장은 재정렬을 마친 뒤 평가해야 하며, 바뀐 풀을 두 항에 모두 반영해야 한다.
3. 세 가지 유형: 사용할 수 있는 정보를 하나씩 없애 보기
주최 측은 질의 외부에서 얻을 수 있는 정보에 따라 미지 분자를 구분한다. 스펙트럼 라이브러리에는 측정 피크와 알려진 구조가 짝으로 들어 있다. 반면 구조 데이터베이스에는 측정 스펙트럼 없이 분자 그래프만 있을 수도 있다. 유형 구분 설명
| 유형 | 정답 구조의 참조 스펙트럼 | 공개 데이터베이스의 정답 구조 | 필요한 능력 |
|---|---|---|---|
| 유형 1 | 있음 | 알려져 있음 | 측정 조건이 달라도 같은 구조를 찾아낸다. |
| 유형 2 | 없음 | 있음 | 해당 구조의 참조 스펙트럼 없이 알려진 후보를 순위화한다. |
| 유형 3 | 없음 | PubChem·COCONUT에 없음 | 두 데이터베이스 밖의 구조를 제안한다. |
Caffeine으로 조건을 통제한 예제
EA030312(명목 CE 75%)를 질의로 고정하자. 이 실측 스펙트럼은 그대로 두고 시스템이 사용할 수 있는 정보만 바꿀 수 있다.
| 통제 조건 | 시스템에 남겨 두는 정보 | 성공했을 때 확인하는 능력 |
|---|---|---|
| 유형 1에 가까운 조건 | 참조 라이브러리에 EA030309·EA030311을 두고 후보 풀에도 Caffeine을 유지한다. | 에너지에 따른 피크 강도 변화에도 Caffeine을 검색한다. |
| 유형 2에 가까운 조건 | 모든 Caffeine 참조 스펙트럼과 지도학습 예제를 제외하되, 질량 조건에 맞는 후보 중에는 구조를 남긴다. | 학습한 조각·구조 정보나 유사 분자의 증거로 정답을 회수한다. |
| 유형 3에 가까운 후보 제외 실험 | 모든 검색 후보 자료에서도 Caffeine을 제거한다. | 그래프를 생성하고 중복 제거 후 충분히 높은 순위에 놓는다. |
Caffeine은 공개적으로 알려진 분자다. 따라서 세 번째 행은 조건을 통제한 대리 실험이며 실제 유형 3 테스트 분자의 예가 아니다. 두 번째와 세 번째 조건을 제대로 구현하려면 관련 라이브러리와 학습 단계 전체에 제외 규칙이 적용되어야 한다. MassBank 두 행만 지우고 다른 Caffeine 자료를 남겨 두면 안 된다.
이 차이는 실험의 결론을 바꾼다. 정답이 전부 들어 있는 후보 풀에서 순위를 완벽히 맞혀도 생성 능력은 확인되지 않는다. 반대로 유형 2 후보 풀에서 정답을 지우면 의도보다 어려운 과제를 평가한다. 생성 모델이 분자식을 요구한다면 그 식도 실제 입력에서 추정해야 한다. 정답인 C8H10N4O2를 직접 주는 실험은 정답 분자식을 아는 조건의 진단이지, 전체 식별 과정의 검증은 아니다.
4. 같은 무게의 분자를 어떻게 구별할까
Eugenol과 Isoeugenol은 분자식 \(\mathrm{C}_{10}\mathrm{H}_{12}\mathrm{O}_{2}\)와 단일 동위원소 질량이 같지만 곁사슬의 결합 위치가 다른 구조 이성질체다. PubChem의 Eugenol과 Isoeugenol 항목에서 두 구조를 확인할 수 있다.
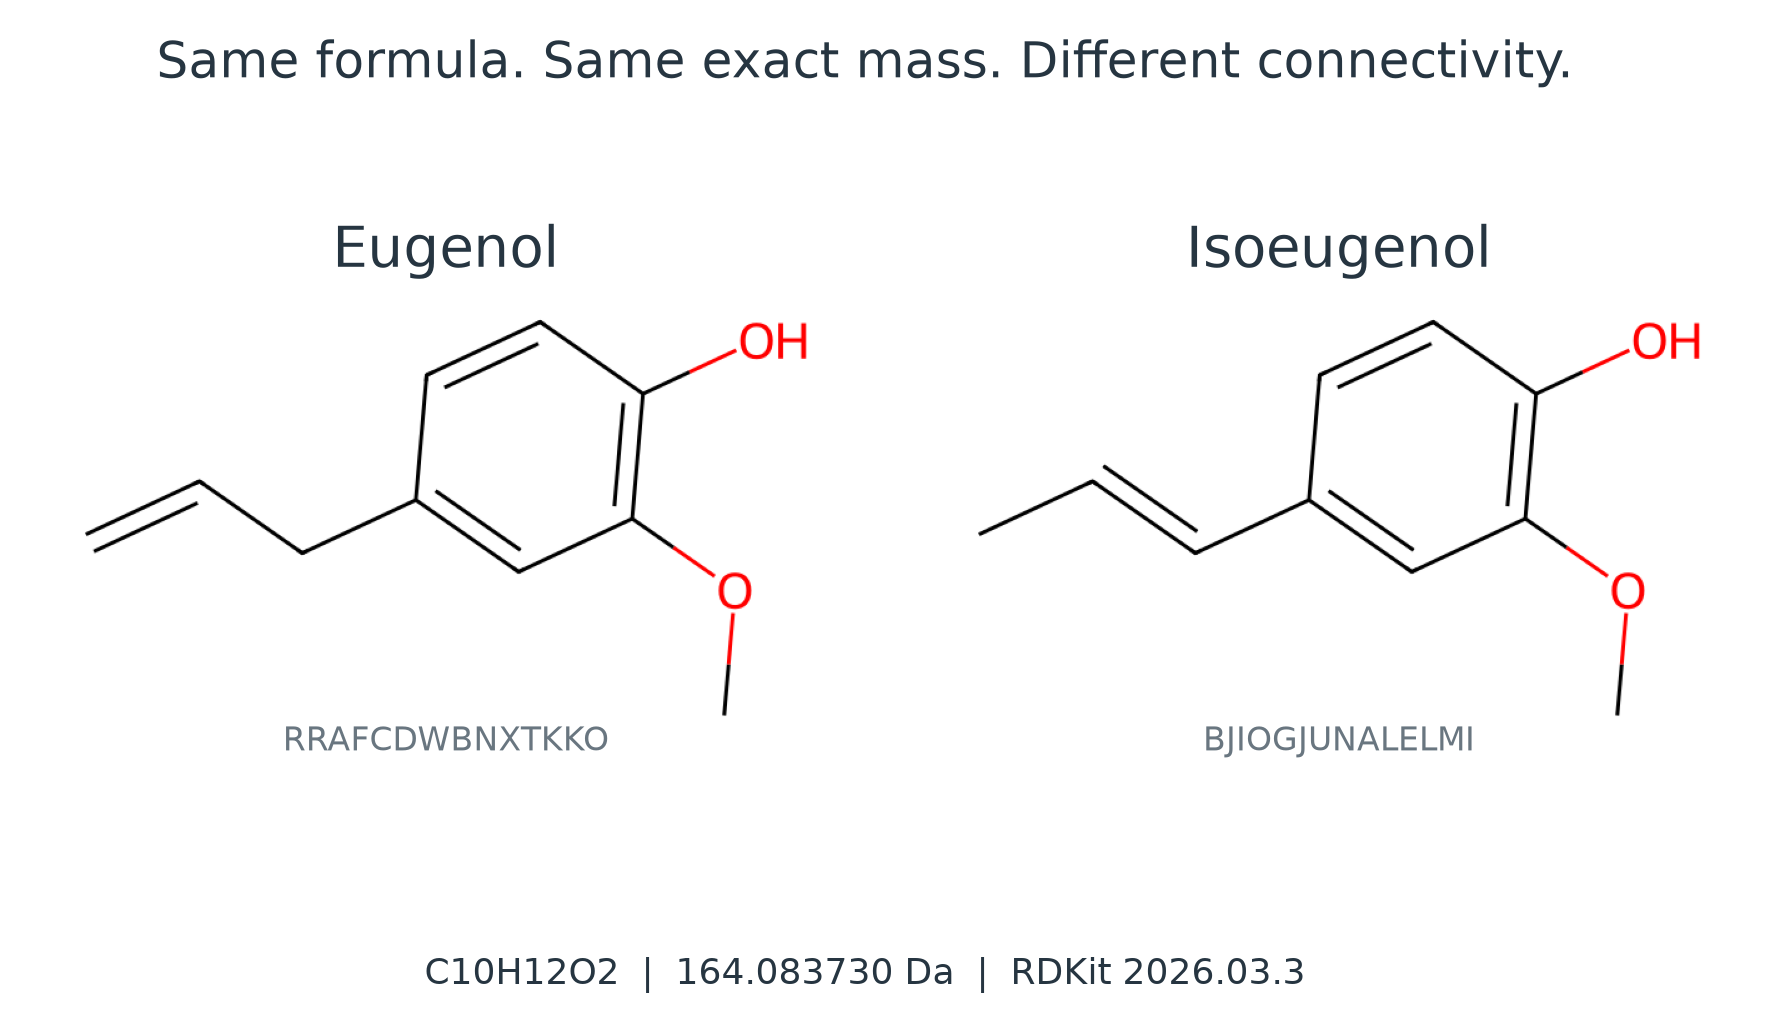
두 분자는 고리에 붙은 세 탄소 사슬에서 이중결합의 위치가 다르다. 같은 재료를 다른 방식으로 연결한 구조 이성질체인 셈이다. 따라서 “질량이 약 164.083730 Da다”라는 정보만으로는 둘 중 어느 것인지 정할 수 없다.
이 지점에서 분자를 쪼개어 얻은 조각들의 정보가 필요해진다. 결합 위치가 달라지면 잘 끊어지는 부분, 전하가 남는 부분, 조각의 상대적인 양도 달라질 수 있다. MS/MS는 이런 차이를 관찰할 수 있게 해 준다. 다만 실제 구별이 얼마나 잘되는지는 측정 조건과 스펙트럼의 품질에 달려 있다. 구조가 다르다고 언제나 명확히 구분되는 스펙트럼을 얻는 것은 아니다.
컴퓨터에는 구조를 어떻게 넣을까
SMILES는 분자 그래프를 한 줄의 문자열로 적는 표기법이다. 원자는 글자로, 결합과 가지, 고리의 연결은 기호로 나타낸다. 위 두 분자를 다음처럼 표현할 수 있다.
1
2
Eugenol:     COc1cc(CC=C)ccc1O
Isoeugenol:  COc1cc(C=CC)ccc1O
소문자 c는 방향족 탄소, =는 이중결합, 괄호는 가지를 뜻한다. 지금 모든 문법을 외울 필요는 없다. 대회에서 예측하는 대상은 이 문자열이 나타내는 분자 구조라는 점만 기억하면 된다.
같은 분자라도 어느 원자부터 읽느냐에 따라 SMILES 문자열은 달라질 수 있다. 그래서 예측 문자열과 정답 문자열을 그대로 비교하면 안 된다. 대회가 구조를 정규화한 뒤 비교하는 이유이며, 2절에서 살펴본 점수 키가 바로 이 역할을 한다.
아래 코드는 두 분자의 분자식과 질량을 직접 계산한다. RDKit은 분자 구조를 읽고 계산하는 데 널리 쓰이는 오픈소스 도구다.
1
2
3
4
5
6
7
8
9
10
11
12
from rdkit import Chem
from rdkit.Chem import Descriptors, rdMolDescriptors

structures = {
    "eugenol": "COc1cc(CC=C)ccc1O",
    "isoeugenol": "COc1cc(C=CC)ccc1O",
}

for name, smiles in structures.items():
    mol = Chem.MolFromSmiles(smiles)
    print(name, rdMolDescriptors.CalcMolFormula(mol),
          f"{Descriptors.ExactMolWt(mol):.6f}")
1
2
eugenol C10H12O2 164.083730
isoeugenol C10H12O2 164.083730
이 값은 일반적인 성분표의 평균 분자량과 구분해야 한다. 정확질량(exact mass)은 어떤 동위원소로 구성되었는지 지정하고 계산한 질량이다. 여기서는 각 원소의 가장 풍부한 동위원소를 사용하는 단일 동위원소 질량(monoisotopic mass)을 계산했다. 고해상도 질량분석의 작은 질량 차이를 다룰 때 필요한 값이다.
왜 질량을 소수점 아래까지 계산할까
원자핵에 있는 양성자 수는 원소를 정하고, 중성자 수가 다른 원자는 같은 원소의 동위원소가 된다. 탄소의 대표적인 동위원소인 \(^{12}\mathrm C\)의 질량은 정확히 12 Da지만, \(^1\mathrm H\)와 \(^{16}\mathrm O\)의 질량은 각각 약 1.007825 Da, 15.994915 Da다. 원자의 질량을 단순히 정수로 더하면 이 차이가 사라진다. 수치의 기준은 NIST 탄소·수소·산소 동위원소 표다.
특정 동위원소 조합에 대해 분자의 질량은 다음처럼 원자 질량의 합으로 계산한다. 이 정밀도에서 화학 결합 에너지에 해당하는 극히 작은 질량 차이는 무시한다.
\[m_{\mathrm{exact}}=\sum_e n_e\,m_e.\]\(n_e\)는 해당 원자의 개수, \(m_e\)는 선택한 동위원소의 질량이다. 따라서 Eugenol의 예는 다음과 같다.
\[\begin{aligned} m&=10(12)+12(1.007825032)\\ &\quad+2(15.994914620)\\ &\simeq164.083730\ \mathrm{Da}. \end{aligned}\]원자의 개수가 다른 두 분자식이 정수 질량에서는 같아도 소수점 아래에서 갈라질 수 있다. 반대로 분자식까지 같은 Eugenol과 Isoeugenol은 질량을 아무리 정밀하게 재도 이 단계에서 구별되지 않는다. 질량 정확도를 높이는 일은 조성을 좁히는 데 도움을 주지만, 원자의 연결 순서를 직접 알려 주지는 않는다.
동위원소는 질량스펙트럼의 추가 피크도 만든다. 예를 들어 탄소 하나가 \(^{12}\mathrm C\)에서 \(^{13}\mathrm C\)로 바뀌면 질량이 약 1.003355 Da 늘어난다. 같은 전하수 \(z\)의 이온이라면 두 피크의 \(m/z\) 간격은 다음과 같다.
\[\Delta(m/z)\simeq\frac{1.003355}{|z|}.\]충분한 동위원소 패턴이 있으면 전하수와 원소 조성에 대한 단서가 된다. 그러나 CASMI에서 내려받는 입력에는 전체 MS1 동위원소 포락선이 별도 배열로 제공되지 않는다. 일반 질량분석에서 유용한 정보라는 이유만으로, 대회 파일에도 그 정보가 있다고 가정해서는 안 된다. MS2 목록에 남아 있는 피크를 어떻게 활용할지는 실제 전처리 상태와 함께 확인해야 한다.
분자식에서 알 수 있는 것: 원자가와 불포화도
분자식을 후보로 생성할 때는 질량만 맞추면 되는 것도 아니다. 보통의 유기분자에서 탄소는 네 개, 산소는 두 개, 중성 질소는 세 개의 결합을 이루는 원자가(valence)를 기본으로 생각한다. 이런 제약 때문에 아무 원자 개수의 조합이나 유효한 분자 그래프가 되지는 않는다.
이를 이해하기 쉬운 예가 불포화도, 또는 DBE(double-bond equivalent)다. 중성·닫힌껍질의 보통 원자가를 갖는 C/H/N/O/할로젠 분자에 한정하면 다음 식을 사용할 수 있다.
\[\operatorname{DBE}=1+C-\frac{H+X}{2}+\frac{N}{2}.\]각 문자는 원자의 개수이고, \(X\)는 F·Cl·Br·I 같은 할로젠 원자 수의 합이다. 산소는 두 결합으로 사슬 사이에 들어갈 수 있어 이 식에 직접 나타나지 않는다. 포화된 비고리 탄화수소에서 수소가 두 개 줄어들면 고리 하나나 이중결합 하나에 해당하는 여지가 생긴다. 삼중결합은 두 단위로 센다.
Eugenol의 분자식에서는 \(1+10-12/2=5\)다. 벤젠 고리의 고리 하나와 이중결합 세 개가 4, 곁사슬의 이중결합 하나가 1을 더한다. Isoeugenol도 같은 값이다. 따라서 DBE는 가능한 구조의 범위를 설명하지만, 두 이성질체의 순서를 정해 주지는 않는다.
대회에서는 이 지식을 분자식·생성 후보의 점검에 사용할 수 있다. 다만 이 간단한 식을 모든 이온과 원소에 대한 탈락 규칙으로 만들면 안 된다. 전하, 라디칼, 인·황의 여러 원자가 상태가 개입하면 해석이 달라진다. 이러한 한계는 분자식 필터를 연구한 Kind와 Fiehn의 원 논문에서도 다룬다. 화학적 제약은 적용 범위를 명시하고, 정답 후보를 얼마나 잘못 제거하는지도 검증해야 한다.
5. 실측 피크에서 물리적 모델로
LC로 혼합물을 분리하고 기체상 이온을 만든 뒤, 선택한 전구체를 분해해 생성 이온을 측정한다. CASMI의 출발점은 원시 크로마토그램이 아니라 처리된 MS/MS 피크 목록이다. 스펙트럼은 보정된 m/z와 검출 상대 강도를 짝지은 희소 배열로 표현된다.
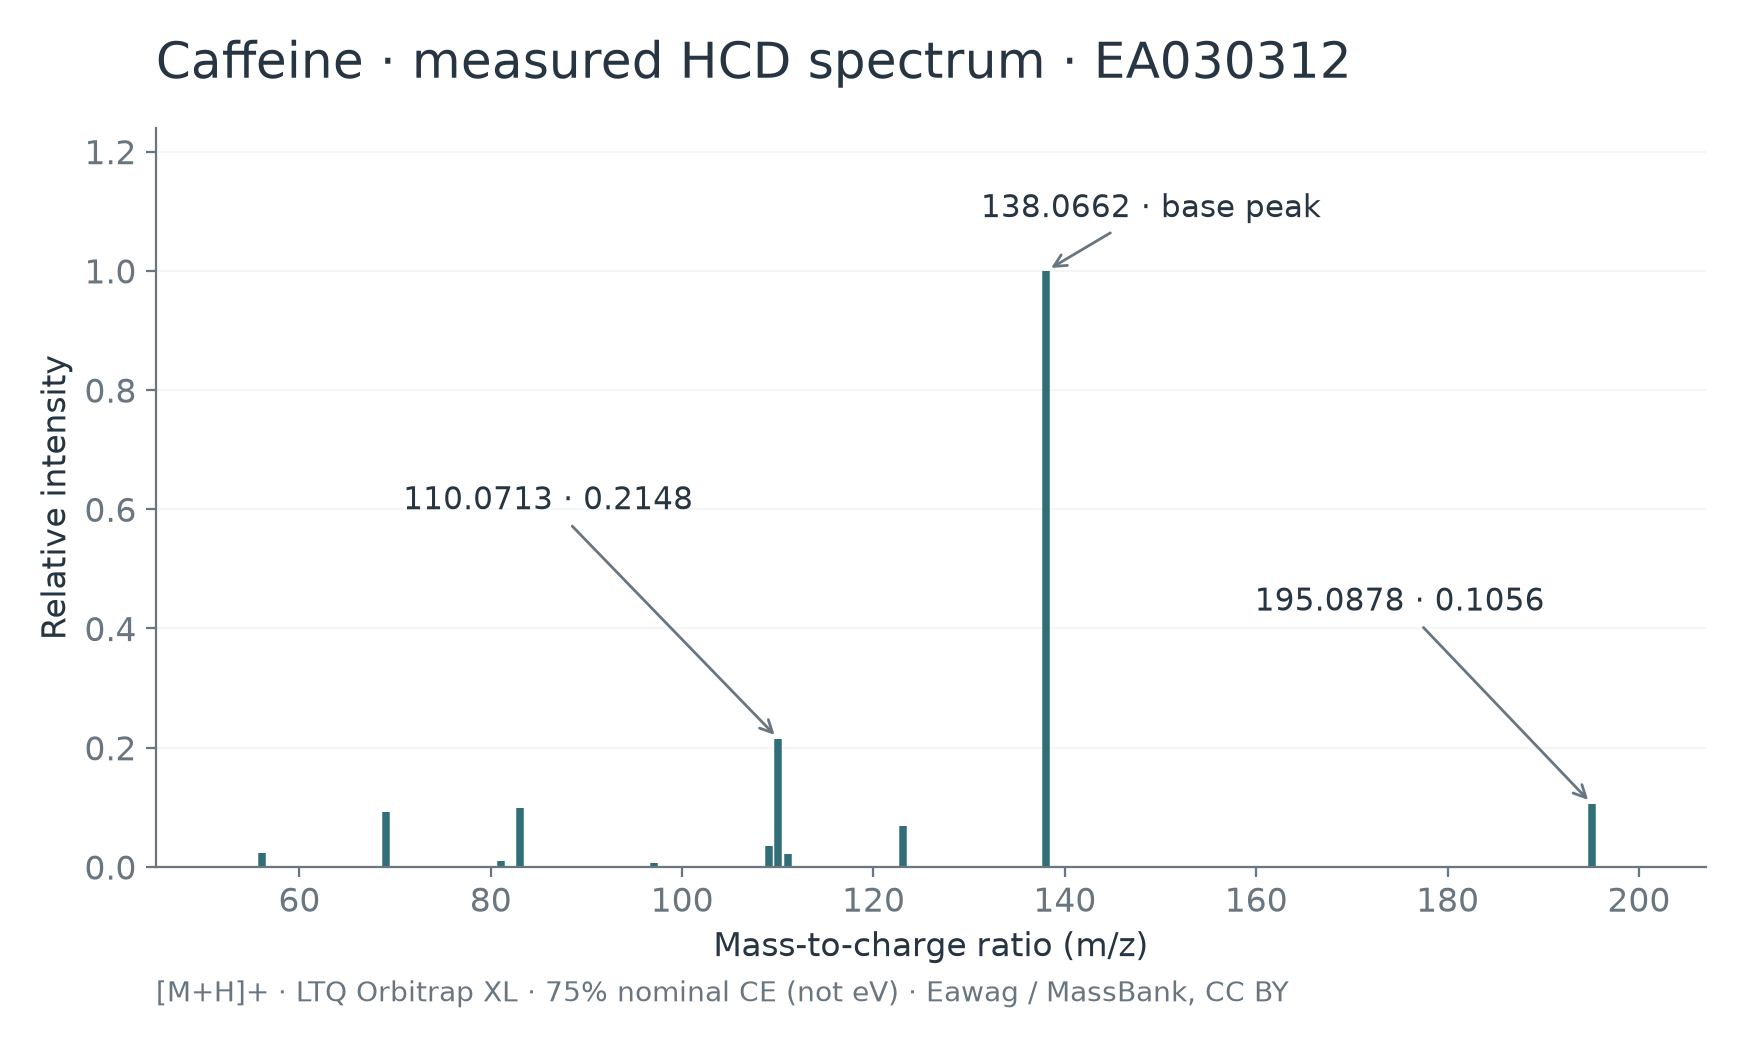
예를 들어 30% Caffeine 기록 전체는 ms2_mzs = [138.0661, 195.0877], 정규화 강도 [0.0369303417, 1.0]이며, 그림 5의 75% 기록에는 피크가 11개 있다. 가장 강한 피크가 base peak다. 배열의 같은 위치가 질량과 강도를 연결하지만, 피크 수나 최대 강도 1이라는 값이 식별 확신을 뜻하지는 않는다. 이 표현에 어떤 정보가 남고 측정 조건이 무엇을 바꾸는지 물리적 원리와 연결해 보자.
장비는 분자의 질량을 어떻게 읽을까
대회에 등장하는 timsTOF는 이온 이동도 장치와 사중극자·비행시간 질량분석기를 결합한 계열이다. 이 중 TOF(time of flight)의 기본 발상은 가속한 이온이 일정 거리를 날아가는 시간을 측정하는 것이다. Bruker의 장비 원리 안내
초기 운동에너지를 무시하고 전압 차이 \(V\)로 이온을 가속하는 이상적인 모형에서는 에너지 보존으로 다음 관계를 얻는다.
\[\begin{aligned} |z|eV&=\frac12m_{\mathrm{ion}}v^2,\\ t&=\frac Lv=L\sqrt{\frac{m_{\mathrm{ion}}}{2|z|eV}}. \end{aligned}\]\(e\)는 기본 전하, \(v\)는 속도, \(L\)은 비행 거리다. 이 식의 질량은 kg, 전압은 V, 거리는 m인 SI 단위로 계산한다. 같은 전압과 경로에서는 비행 시간이 질량 대 전하 비의 제곱근에 비례한다. 따라서 이온의 도착 시간을 보정된 \(m/z\)로 바꿀 수 있다. 실제 장비에는 이온의 에너지 분포와 비행 경로를 보정하는 더 복잡한 장치가 들어간다.
대회에서는 이 변환을 다시 수행할 필요 없이 이미 계산된 피크 위치를 받는다. 또한 timsTOF에 이온 이동도 기능이 있다는 사실만으로 충돌 단면적(CCS)이나 이동 시간까지 대회 입력에 들어 있다고 가정하지 않는다. 장비가 측정할 수 있는 것과 파일에 실제로 제공된 것은 구분해야 한다.
물리량을 읽을 때 구분할 단위. 기호가 비슷해도 아래 값은 서로 바꿔 쓸 수 없다.
| 물리량 | 뜻과 단위 | 이 글에서 구분할 점 |
|---|---|---|
| 중성 분자의 정확질량 | 동위원소 조성으로 계산한 질량, Da | 이온화 전의 분자 질량 |
전하 수 z | 기본 전하의 정수배, 부호 포함 | m/z 계산에서는 크기 |z|로 나눔 |
| 스펙트럼의 m/z | 이온 질량 대 전하 수의 비 | 이온 형태와 전하를 알아야 중성 질량으로 환산 가능 |
| 충돌 에너지 | 이온의 충돌 조건, eV 등 | 장비 전압·NCE·실제 내부 에너지와 구분 |
| 몰당 활성화 에너지 | 반응 장벽의 몰당 표현, kJ/mol 등 | 아레니우스 식의 R과 단위를 맞춰야 함 |
| 상대 세기 | 스펙트럼 안의 정규화된 신호, 무차원 | 다른 스펙트럼 사이의 절대량 비가 아님 |
규모를 계산해 보면, 단일 전하를 가진 195 Da 이온을 5,000 V로 가속해 1 m 이동시키는 이상화된 조건에서 비행 시간은 약 14.22 μs다. 질량이 두 배면 시간은 √2배가 된다. 설명을 위해 고른 경로 길이와 전압이며 timsTOF의 실제 동작 사양은 아니다. CASMI에는 보정된 m/z가 이미 주어지므로 비행 시간 시뮬레이터보다 질량 오차를 적절히 다루는 처리가 필요하다.
전구체의 m/z는 중성 분자의 질량과 다르다
분석기는 전기장으로 이온을 움직이고 분리한다. 따라서 전하가 없는 분자 자체보다 어떤 이온 형태로 들어왔는가가 중요하다. LC-MS에서 흔히 쓰는 전기분무 이온화(ESI)는 대전된 액적에서 용매가 제거되는 과정을 거쳐 기체 상태의 이온을 만든다. 비교적 온화한 이온화 방법이어서 분자 전체를 보존한 이온을 관찰할 수 있지만, 모든 분자가 같은 효율과 같은 형태로 이온화되지는 않는다. Agilent의 LC/MS 원리 설명
예를 들어 [M+H]+는 중성 분자 \(M\)에 양성자 하나가 붙은 이온이다. [M-H]-는 양성자를 잃은 음이온, [M+Na]+는 나트륨 이온이 붙은 형태다. 대회에서는 이 구분을 이온 형태(adduct) 정보로 제공한다. 용액의 산·염기 성질, 분자의 작용기, 용매와 염 등이 어떤 형태를 관찰하기 쉬운지에 영향을 준다. LC 조건과 이온화에 대한 기술 설명
이온을 만들면서 더해지거나 빠지는 질량을 부호가 있는 값 \(\Delta m_{\mathrm{ion}}\)으로 묶으면 다음과 같이 쓸 수 있다. 아래 식에서는 질량을 Da 단위로 사용한다.
\[\begin{aligned} (m/z)_{\mathrm{precursor}} &=\frac{m(M)+\Delta m_{\mathrm{ion}}}{|z|},\\ m(M)&=|z|(m/z)_{\mathrm{precursor}}-\Delta m_{\mathrm{ion}}. \end{aligned}\]단일 전하의 몇 가지 예를 쓰면 더 분명해진다.
| 이온 형태 | 중성 분자에 대한 질량 변화 \(\Delta m_{\mathrm{ion}}\) | 중성 질량을 구하는 계산 |
|---|---|---|
[M+H]+ | 약 +1.007276 Da | 전구체 값에서 1.007276을 뺀다 |
[M-H]- | 약 −1.007276 Da | 전구체 값에 1.007276을 더한다 |
[M+Na]+ | 약 +22.989221 Da | 전구체 값에서 22.989221을 뺀다 |
[M-H2O+H]+ | 약 −17.003288 Da | 전구체 값에 17.003288을 더한다 |
앞서 본 Eugenol이 [M+H]+로 측정된다면 전구체는 약 165.091006이다. 이 값을 중성 질량으로 잘못 사용하면 검색 단계에서 정답을 놓치게 된다. 또한 표의 1.007276은 양성자 질량이다. 중성 수소 원자의 질량 1.007825와는 전자 하나의 질량만큼, 약 0.000549 Da 차이가 난다. 164 Da 부근에서는 약 3.3 ppm에 해당하므로 작은 질량 창을 다룰 때 무시할 차이가 아니다. 여기의 수치는 질량 계산 관례에 대한 설명이지 측정 피크에 일괄 보정을 더하라는 뜻은 아니다.
따라서 “가까운 질량의 분자를 찾는다”는 첫 단계에도 이온 형태 해석이 들어간다. 대회는 데이터 설명에서 양·음이온과 물 손실을 포함한 여러 이온 형태를 안내하고 있으며, 학습 자료의 물 손실 표기를 보완한 업데이트 공지도 제공했다.
Caffeine 전구체로 직접 확인하면 195.0877 − 1.0072764666 = 194.0804235334 Da다. 원문에 반올림해 적힌 중성 정확질량 194.0804와 일치한다. 여기서 5 ppm 창은 약 ±0.0009704 Da다. 이온 형태를 [M+Na]+로 잘못 읽으면 중성 질량이 약 22 Da 어긋난다. 이런 범주 오류는 ppm 허용 폭을 조금 넓혀 해결할 수 없다.
양성자가 어디에 붙었는지도 분해를 바꾼다
[M+H]+는 양성자가 하나 더 있다는 조성 정보이지, 그 양성자의 위치까지 지정한 구조식은 아니다. 질소와 산소를 여러 개 가진 분자에서는 서로 다른 위치가 양성자를 받을 수 있고, 분해 중 양성자가 이동할 수도 있다. 전하 위치가 달라지면 결합의 전자 분포와 접근하기 쉬운 분해 경로도 달라진다. 소분자를 대상으로 이를 조사한 CIDMD 연구는 이런 차이가 스펙트럼 예측에 중요함을 보여 준다.
이때 유기화학의 공명과 공액도 등장한다. 전하가 한 원자에만 집중되지 않고 여러 원자에 퍼질 수 있는 구조는 특정 조각 이온을 안정화할 수 있다. 하지만 안정한 조각이 존재한다는 사실과, 실험 시간 안에 그 조각을 많이 만드는 반응 경로가 있다는 사실은 서로 다르다.
이를 모델에 반영할 때는 측정 조건부터 구분해야 한다. 같은 중성 구조라도 양·음이온과 이온 형태를 무시한 채 하나의 정답 스펙트럼으로 취급하면 서로 다른 현상을 섞게 된다. 구조→스펙트럼 모델에는 가능한 측정 조건을 주고, 학습 자료에서 지원하지 않는 이온 형태에 대해서는 그 한계를 따로 확인해야 한다. 용액에서의 산성도만으로 기체 이온의 양성자 위치를 확정하는 것도 적절하지 않다.
양성자가 붙는 위치가 다른 두 형태(protomer)가 가능하다면 조건부 스펙트럼을 \(p(s\mid c,\theta)=\sum_h p(s\mid c,h,\theta)p(h\mid c,\theta)\)처럼 혼합으로 생각할 수 있다. \(h\)는 양성자가 붙은 상태를 구분한다. 두 상태가 서로 다른 조각을 강조한다면 임의의 한 위치만 선택하는 모델에는 체계적인 잔차가 생길 수 있다. 이는 모델링 관점의 해석이며 공개 FPNet이 실제로 protomer를 열거한다는 뜻은 아니다. 실무에서는 먼저 모델이 지원하는 양·음이온 조건을 분리하고 검증 오류부터 비교하는 편이 좋다.
충돌 에너지는 특정 결합에 직접 넣는 에너지가 아니다
충돌 유도 해리(CID)에서는 이온이 중성 기체와 충돌하며 병진 운동에너지의 일부를 내부에너지로 바꾸고, 그 결과 분해가 일어난다. 내부에너지에는 분자의 진동 등이 포함된다. 이것이 IUPAC의 CID 정의가 설명하는 과정이다.
“충돌 에너지가 30 eV이므로 결합 하나에 30 eV를 주었다”라고 해석하면 안 된다. 가장 단순한 경우로, 정지해 있는 기체 입자에 이온 하나가 충돌한다고 하자. 실험실 좌표계의 이온 운동에너지 \(E_{\mathrm{lab}}\)와 질량중심 좌표계에서 상대 운동에 사용할 수 있는 에너지 \(E_{\mathrm{cm}}\)는 다음 관계를 갖는다.
\[E_{\mathrm{cm}} =\frac{m_{\mathrm{gas}}}{m_{\mathrm{ion}}+m_{\mathrm{gas}}} E_{\mathrm{lab}}.\]이 관계는 두 물체의 운동에너지에서 질량중심 전체의 이동에너지를 빼면 얻어진다. 설명용 예로 이온 질량 300 Da, 기체 입자 질량 28 Da, \(E_{\mathrm{lab}}=30\) eV이면 \(E_{\mathrm{cm}}\simeq2.56\) eV다. 이온이 1,000 Da라면 약 0.82 eV다. 그 에너지가 전부 이온의 내부에너지로 들어가는 것도 아니다. 실제 장비에서는 충돌 횟수, 기체, 체류 시간과 에너지 분포를 함께 고려해야 한다. 에너지 전달과 반응 속도를 함께 다루는 MassKinetics 연구가 이 연결을 설명한다.
여기서 \(E_{\mathrm{lab}}\)는 이온 전체의 운동에너지로 정의했다. 장비가 가속 전압이나 정규화된 충돌 에너지를 표시한다면 먼저 그 정의를 확인해야 한다. 대회의 collision_energy_ev를 이 식에 넣어 실제 내부에너지를 바로 복원할 수 있다는 뜻은 아니다.
따라서 같은 20 eV 표기라도 다른 장비의 스펙트럼이 완전히 같은 조건에서 나온 것은 아닐 수 있다. 충돌 에너지는 유용한 모델 입력이지만 장비와 이온의 조건을 함께 봐야 한다. 숫자가 없는 행을 에너지 0으로 채우는 것도 “측정값을 모른다”와 “에너지를 주지 않았다”를 혼동하게 만든다.
실측 예제에서는 단위 문제가 분명히 드러난다. 30%, 60%, 75%는 원문에 기록된 명목 HCD 에너지 설정값이며 30, 60, 75 eV가 아니다. 같은 장비의 시리즈 안에서는 비교할 수 있지만, 숫자가 같다는 이유로 숨은 timsTOF의 에너지 척도와 맞출 수는 없다. 조건 인코더에는 단위 관례와 결측 여부를 구분해 넣고, 필요한 정보를 받을 수 없는 체크포인트라면 문서에 명시된 전처리 규칙을 따라야 한다.
어떤 조각이 많이 생기는가: 안정성과 반응 속도
구조 그림의 결합을 모두 한 번씩 잘라 보면 실제 스펙트럼이 될까? 그렇지 않다. 특정 조각이 생기려면 그 경로의 활성화 장벽을 넘어야 하고, 관측 시간 안에 반응이 일어나야 한다. 수소 이동이나 구조 재배열을 거치는 경로도 있다. 중성 분자의 평균 결합 해리 에너지만으로 이온의 모든 분해 경로를 정렬하기 어려운 이유다.
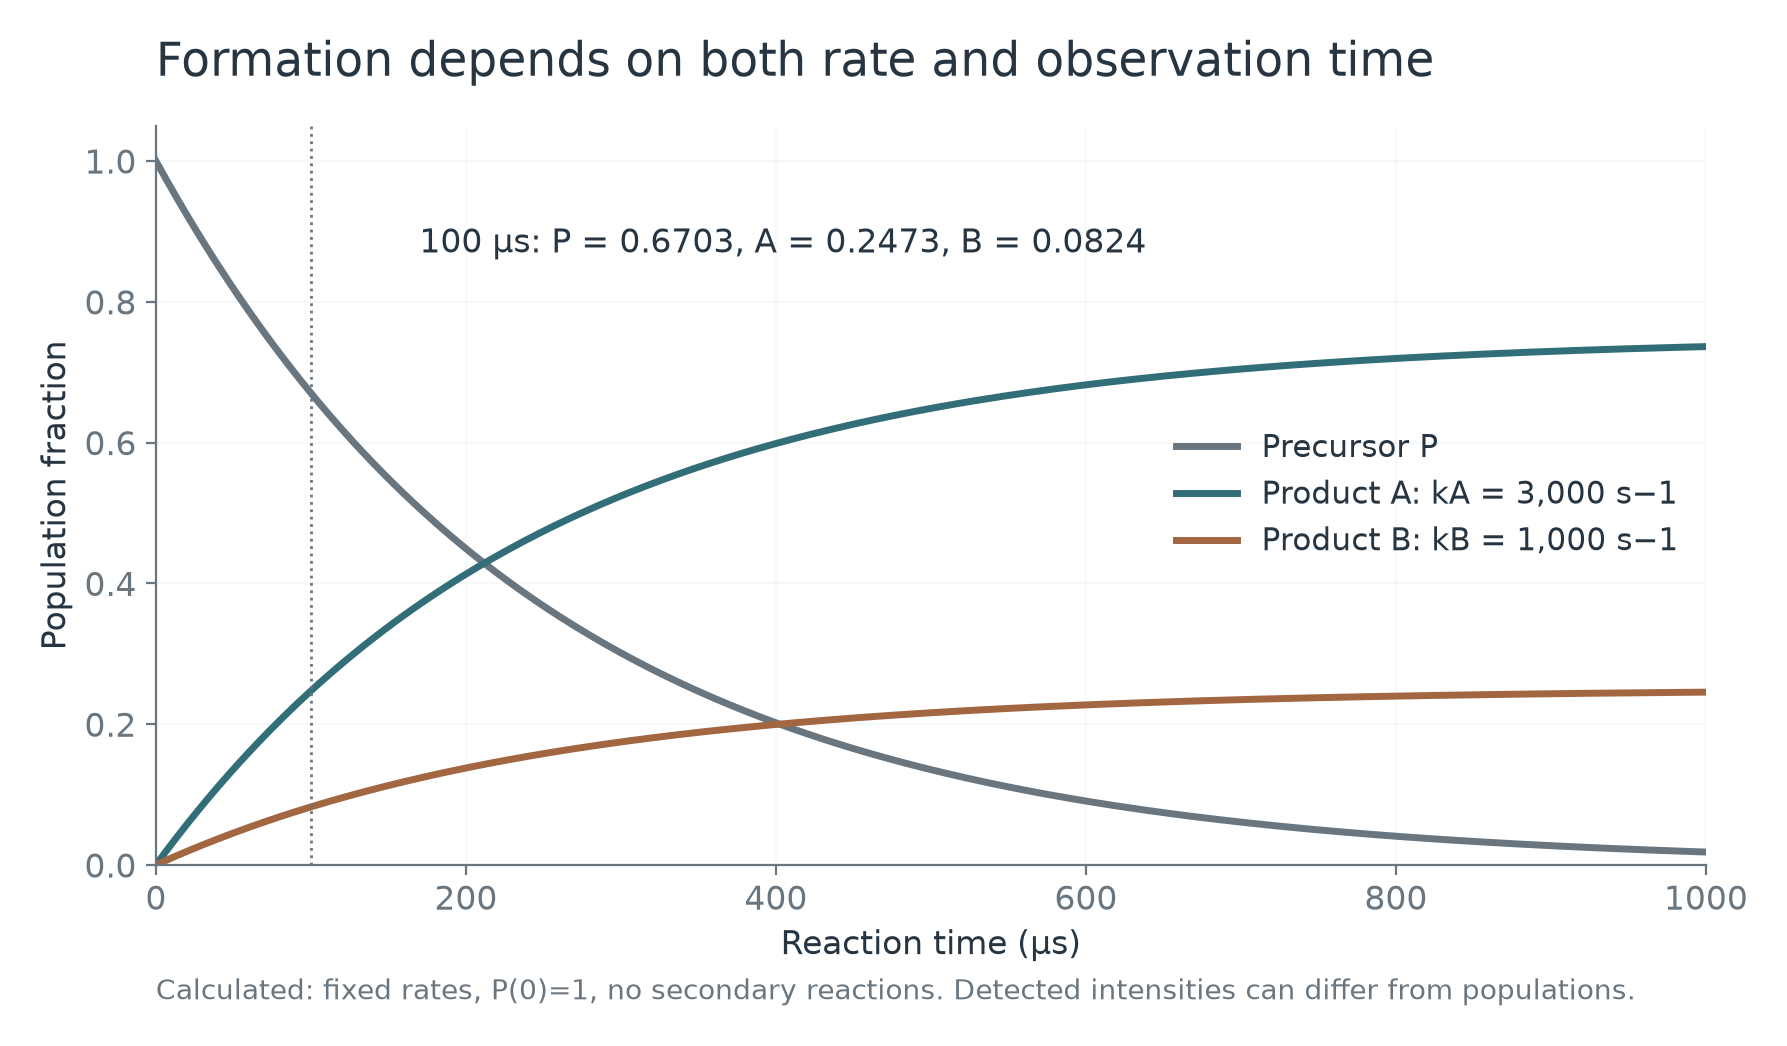
이를 계산적으로 이해하는 가장 간단한 예는, 여기된 전구체 이온 \(P^{+*}\)에서 두 경로가 경쟁하는 모형이다.
\[P^{+*}\xrightarrow{k_A}A^++N_A, \qquad P^{+*}\xrightarrow{k_B}B^++N_B.\]\(N_A,N_B\)는 검출되지 않는 중성 생성물이고, \(k_A,k_B\)는 각 경로의 속도상수다. 두 반응만 있고, 속도상수가 일정하며, 생성물이 다시 분해되지 않는다고 가정하면 전구체에서 반응한 비율은 다음과 같다.
\[f_{\mathrm{reacted}}(t)=1-e^{-(k_A+k_B)t}.\]생성된 이온 중 A와 B로 갈라지는 비율은 각각 \(k_A/(k_A+k_B)\), \(k_B/(k_A+k_B)\)다. 가령 A의 속도가 B의 세 배라면, 이 단순 모형에서 생성된 이온의 비율은 3:1이다. 측정 세기가 곧바로 3:1이라는 뜻은 아니다. 이온의 전달·검출 효율이 다르거나 생성물이 추가로 분해되면 비율이 달라진다.
이 작은 모형만으로도 피크의 존재와 세기를 별도로 예측할 이유가 생긴다. 어떤 조각이 가능한지 아는 것과 실제로 그 조각이 얼마나 생기고 살아남는지 아는 것은 다른 문제다. 정방향 예측 모델에서 조각 생성과 세기 예측을 나누는 설계도 이런 관점에서 이해할 수 있다.
조금 더 들어가기: 아레니우스 식과 RRKM 관점
화학 반응 속도를 처음 배울 때 자주 보는 식은 아레니우스(Arrhenius) 식이다.
\[k(T)=A\exp\!\left(-\frac{E_a}{RT}\right).\]\(E_a\)는 몰당 활성화 에너지, \(R\)은 기체상수, \(T\)는 온도다. 이 식은 장벽과 속도의 관계를 이해하는 데 도움이 된다. 그러나 질량분석의 충돌 에너지 값을 그대로 \(RT\)에 대입해서는 안 된다. 기체 이온 집합의 내부에너지 분포와 열평형 온도는 같은 입력이 아니다.
고정된 내부에너지 \(E\)를 가진 이온의 단분자 반응을 통계적으로 다루는 대표적인 틀은 RRKM 이론이다. 가장 기본적인 형태는 다음과 같다.
\[k(E)=\frac{N^{\ddagger}(E-E_0)}{h\rho(E)}.\]\(E_0\)는 문턱 에너지, \(\rho(E)\)는 반응물의 상태 밀도, \(N^{\ddagger}\)는 그 에너지로 접근할 수 있는 전이상태의 상태 수, \(h\)는 플랑크 상수다. 통계적으로 에너지가 분포한다는 등의 가정이 필요하고, 모든 분해가 이 모형을 따르는 것도 아니다. 실제 적용 예는 기체 이온의 분해 에너지를 추정한 연구에서 볼 수 있다.
이 대회를 시작하려고 직접 RRKM 계산기를 구현할 필요는 없다. 중요한 시사점은 분해 속도가 결합 하나의 에너지뿐 아니라 분자 전체의 상태 수와 내부에너지에 의존한다는 것이다. 따라서 조각의 질량이 맞는다는 사실만으로 피크의 세기를 결정할 수 없다.
두 경로 예제에 \(k_A=3{,}000\ \mathrm{s}^{-1}\), \(k_B=1{,}000\ \mathrm{s}^{-1}\)를 넣어 보자. 100 μs 뒤 전구체는 초기 개체 수의 0.6703, A와 B는 각각 0.2473, 0.08242다. 1 ms 뒤에는 0.01832, 0.7363, 0.2454가 된다. A의 전달·검출 계수가 0.5이고 B가 1이면 검출 비율은 생성 비율 3이 아니라 1.5다. 반응 속도를 고정하고 후속 반응을 없앤 해석적 계산이며 Caffeine에 맞춘 결과는 아니다. 강도 예측값을 해석할 때 장비 응답과 반응 시간이 함께 필요한 이유를 보여 준다.
중성 손실: 보이지 않는 조각을 질량 차이로 읽는다
이온이 분해되어 한쪽은 전하를 유지하고 다른 쪽은 중성이 되면, 보통 검출되는 것은 전하를 가진 쪽이다. 전구체와 생성물의 질량 차이를 보면 검출되지 않은 중성 손실(neutral loss)에 대한 단서를 얻을 수 있다.
전구체와 생성물의 전하수가 모두 같은 단일 전하이고, 하나의 중성 분자가 빠지는 경로를 생각하면 다음 관계가 성립한다.
\[m_{\mathrm{loss}} \simeq(m/z)_{\mathrm{precursor}}-(m/z)_{\mathrm{fragment}}.\]양쪽 전하수가 같아도 \(\lvert z\rvert>1\)이면 이 차이에 \(\lvert z\rvert\)를 곱해야 한다. 전하수가 달라지거나 다른 반응이 섞이면 단순 뺄셈으로 같은 해석을 할 수 없다.
| 중성 분자의 예 | 단일 동위원소 질량 | 해석할 때의 질문 |
|---|---|---|
| 물, H₂O | 약 18.010565 Da | 탈수가 가능한 원자 조성과 경로가 있는가? |
| 암모니아, NH₃ | 약 17.026549 Da | 질소와 수소를 포함한 손실을 설명할 수 있는가? |
| 일산화탄소, CO | 약 27.994915 Da | 이 조성의 손실을 만들 수 있는 경로가 있는가? |
| 이산화탄소, CO₂ | 약 43.989829 Da | 탈탄산 등을 설명할 구조와 경로가 있는가? |
이 수치들은 중성 분자의 조성에 대한 계산값이다. 약 18.010565 Da 차이의 피크가 있다고 곧바로 특정 위치에 OH기가 있다고 확정할 수는 없다. 물은 여러 원자에서 수소가 이동하고 재배열되는 과정으로 생길 수도 있다. 반대로 OH기가 있어도 해당 조건에서 물 손실이 충분히 관측되지 않을 수 있다.
대회에서는 원래의 조각 이온 \(m/z\) 목록과 함께 중성 손실 목록을 비교하거나, 후보의 원자 조성으로 설명되는 조각 비율을 특징으로 만들 수 있다. 다만 강제 탈락 조건보다는 다른 증거와 합치는 점수로 먼저 검증할 만하다. 원소의 질량 계산에는 앞의 NIST 표와 질소 동위원소 표를 사용했다.
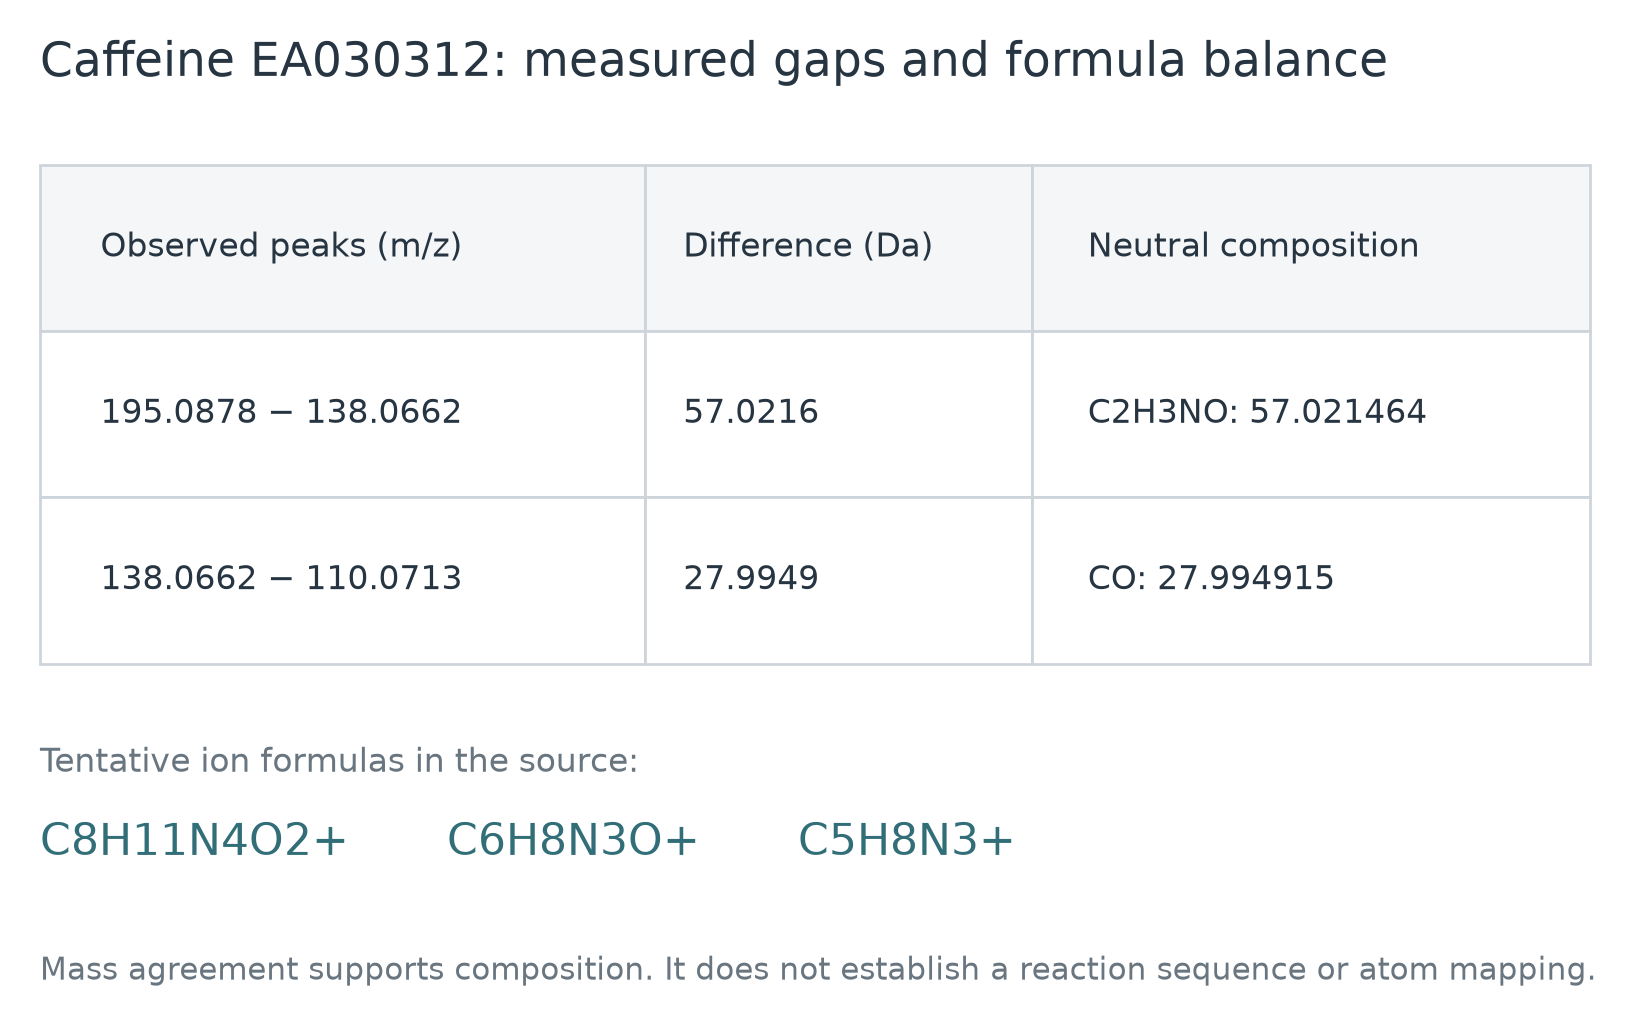
이제 EA030312의 실측 피크를 보자. 원문은 138.0662에 C6H8N3O+, 110.0713에 C5H8N3+를 잠정적으로 부여한다. 차이는 27.9949 Da로, 계산한 CO 질량 27.994915 Da와 맞는다. 잔존 전구체 피크 195.0878에서 138.0662를 빼면 57.0216 Da이며, 중성 C2H3NO의 57.021464 Da 및 원문의 잠정 이온 분자식과 부합한다. 선택 전구체 메타데이터는 195.0877이므로 그 값을 쓰면 57.0215가 된다. 무엇을 뺐는지 명시해야 한다. 실측 기록과 잠정 주석
이 일치는 원소 조성의 질량 수지를 제약한다. 하지만 195 → 138 → 110이라는 연속 반응 경로, 빠져나간 원자의 위치, 재배열의 유무를 증명하지는 않는다. 모델은 두 질량 차이의 잔차를 특징으로 사용하되, 입증된 반응 연결로 취급하지 않을 수 있다.
분해능과 질량 정확도는 다른 성질이다
서로 가까운 피크를 나누어 볼 수 있는 능력이 질량 분해능이다. 피크 폭을 반치전폭(FWHM), 즉 최대 높이의 절반에서 잰 폭으로 정하면 다음처럼 표현할 수 있다. IUPAC 정의
\[R=\frac{m}{\Delta m_{\mathrm{FWHM}}}.\]반면 질량 정확도는 측정한 피크 중심이 실제 값에 얼마나 가까운지에 관한 성질이다. 피크가 좁더라도 전체가 한쪽으로 이동하면 질량 오차가 생긴다. 분해능이 높다는 이유만으로 검색 허용 오차를 극단적으로 좁혀도 되는 것은 아니다.
CASMI의 ms2_mzs는 피크 위치의 목록이며 피크마다 원시 파형과 FWHM이 함께 제공되는 형식은 아니다. 따라서 소수점 자릿수가 많다는 사실만으로 실측 분해능을 추정하지 않는다. 라이브러리를 비교할 때에는 보유한 정답 자료에서 전구체와 조각의 오차 분포를 구분해 확인하고, 그에 맞는 피크 대응 허용 오차를 정한다.
m/z 200에서 \(R=30{,}000\)이면 FWHM은 0.00667이고, 중심값 오차 5 ppm은 0.00100이다. 하나는 피크 폭, 다른 하나는 위치의 어긋남을 뜻한다. 고정된 0.01 폭의 bin도 가까운 별개 피크를 합칠 수 있지만, 희소 피크 매칭은 정확한 위치를 유지할 수 있다. 소수점 자릿수를 장비 분해능으로 간주하지 말고 처리 목적과 실제 오차 분포에 맞춰 표현 해상도와 허용 오차를 정한다.
여러 충돌 에너지는 구조에 대한 여러 질문이다
같은 분자라도 낮은 에너지에서는 전구체나 큰 조각이 남고, 높은 에너지에서는 추가 분해된 작은 조각이 나타날 수 있다. 먼저 만들어진 조각이 다시 분해되면, 그 피크는 에너지를 올릴수록 증가하다가 감소할 수도 있다.
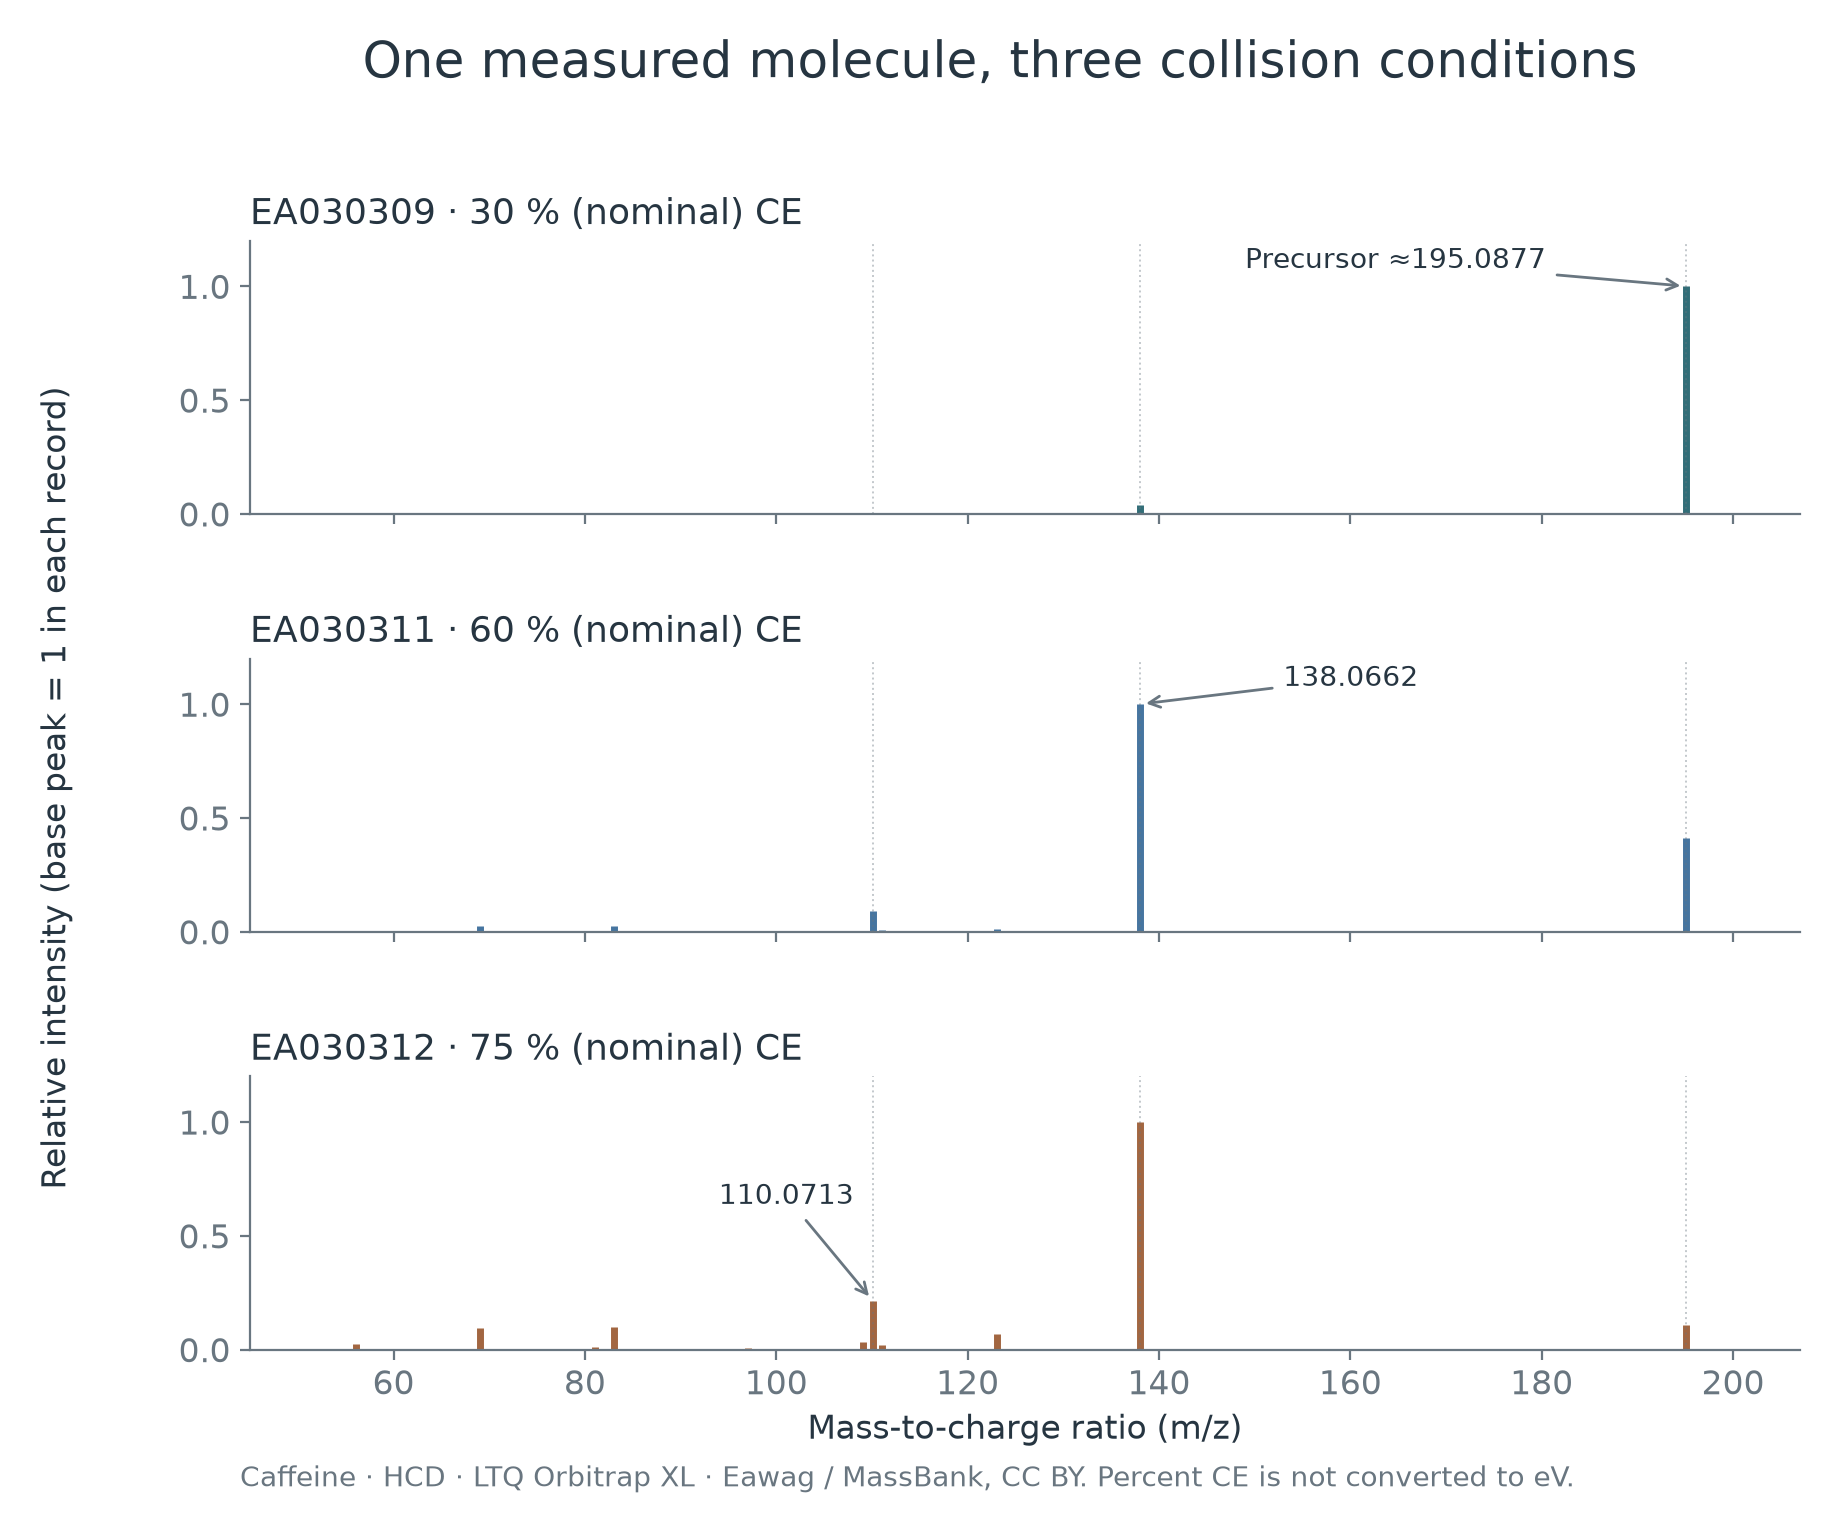
낮은 에너지에서 큰 조각을 잘 설명하는 후보와 높은 에너지에서 작은 조각을 잘 설명하는 후보가 다를 수 있다. 여러 조건이 같은 후보를 지지한다면 더 강한 증거가 된다. 다만 거의 같은 조건에서 얻은 중복 스펙트럼을 독립적인 증거 여러 개로 세면 확신을 과장할 수 있다.
피크 세기를 정규화하는 의미도 여기서 중요하다. 대회의 기준 피크 정규화를 식으로 쓰면 다음과 같다.
\[\widetilde I_i=\frac{I_i}{\max_j I_j}.\]이 변환은 한 스펙트럼 안의 상대적 모양을 보존하지만 절대 세기 규모를 제거한다. base_peak_intensity가 따로 있어도 장비의 증폭, 이온화 효율, 주입량 등을 보정하지 않은 채 그것을 분자의 양이나 예측 신뢰도로 바로 해석해서는 안 된다. 빈약한 스펙트럼과 풍부한 스펙트럼의 최대 정규화 피크는 모두 1일 수 있다.
실측 시리즈에서 138 피크는 0.03693 → 1.0000 → 1.0000, 잔존 전구체는 1.0000 → 0.40994 → 0.10565, 110 피크는 미기재 → 0.08968 → 0.21480으로 변한다. 각각 정규화한 상대 신호이며 이온 생성 수율이 아니다. 30% 기록은 주로 전구체 잔존과 조각 하나를 보여 주고, 75% 기록은 피크 11개로 더 많은 조각 정보를 준다. 에너지별 관찰을 남겨 두지 않고 스펙트럼을 병합하면 이 차이가 사라진다.
관찰을 합칠 때는 스펙트럼별 평균과 측정 조건별 평균을 비교해 볼 수 있다. 한 조건에서 거의 같은 측정을 열 번 하고 다른 조건에서 한 번 했다면 단순 행 평균에서는 첫 조건의 영향이 열 배다. 이것이 독립적인 구조 증거 열 개를 뜻하는지, 단지 측정 빈도 차이인지는 구분해야 한다.
이 배경을 예측 문제로 옮기면
미지 구조를 \(c\), 관찰 스펙트럼 묶음을 \(\mathcal S\), 측정 조건들을 \(\Theta\)라고 쓰면 구조 동정은 다음과 같은 역문제로 생각할 수 있다.
\[p(c\mid\mathcal S,\Theta) \propto p(\mathcal S\mid c,\Theta)\,p(c\mid\Theta).\]오른쪽의 첫 항은 “이 구조라면 이런 측정이 나올 만한가”, 둘째 항은 “측정을 보기 전 이 구조에 얼마의 가능성을 줄 것인가”다. 이 식은 대회의 공식 채점식이 아니라, 이후에 나올 모델의 역할을 정리하는 틀이다.
정방향 예측 모델은 후보 구조가 관측 스펙트럼을 얼마나 잘 설명하는지 평가하는 데 쓰인다. 검색 라이브러리와 구조 데이터베이스는 어떤 후보를 비교할지 정한다. 학습 자료에서 흔한 구조에 주는 높은 점수에는 두 번째 항에 해당하는 편향도 섞일 수 있다. 따라서 모델이 스펙트럼을 설명해서 맞혔는지, 단지 익숙한 후보를 선호해서 맞혔는지를 구분하는 검증이 필요하다.
Bayesian 관점에서도 구체적인 차이가 드러난다. Eugenol과 Isoeugenol은 같은 정확질량 조건을 통과하므로 그 조건만으로 두 후보의 상대적인 가능성은 바뀌지 않는다. 조각 패턴 점수는 우도비를 바꿀 수 있고, 데이터베이스에서 자주 나타난다는 특징은 사전확률과 비슷한 선호를 더한다. 출처가 다른 자연물 검증 집합에서는 질량이 완벽히 맞아도 후자의 선호가 실패할 수 있다. 같은 후보를 유지한 특징 제거 실험으로 비교하고, 같은 분자식의 어떤 구조 쌍에서 순서가 바뀌는지 확인한다.
이제 앞에서 본 입력 열이 단순한 숫자 목록이 아니라 측정 조건이 담긴 증거라는 점을 이해할 수 있다. 다음에는 학습 자료가 어떤 분자와 장비를 담고 있는지 살펴보고, 이 증거를 후보 검색과 순위화에 연결한다.
6. 250만 개의 스펙트럼은 어떤 학습 자료인가
공식 안내는 약 250만 스펙트럼과 약 27만 5천 구조 규모의 학습 자료를 제공한다고 설명한다. 여러 공개 라이브러리와 Enveda 자료가 합쳐져 있다. 대회 데이터
이번 프로젝트에서 로컬 학습 파일을 집계했을 때는 2,539,608개 행, 제공된 구조 키 기준 275,810개 구조였다. 이 구조 수는 파일에 들어 있던 키의 집계다. 앞 절의 점수 계산용 정규화를 모두 다시 적용한 고유 구조 수와 반드시 같다고 가정하지 않는다.
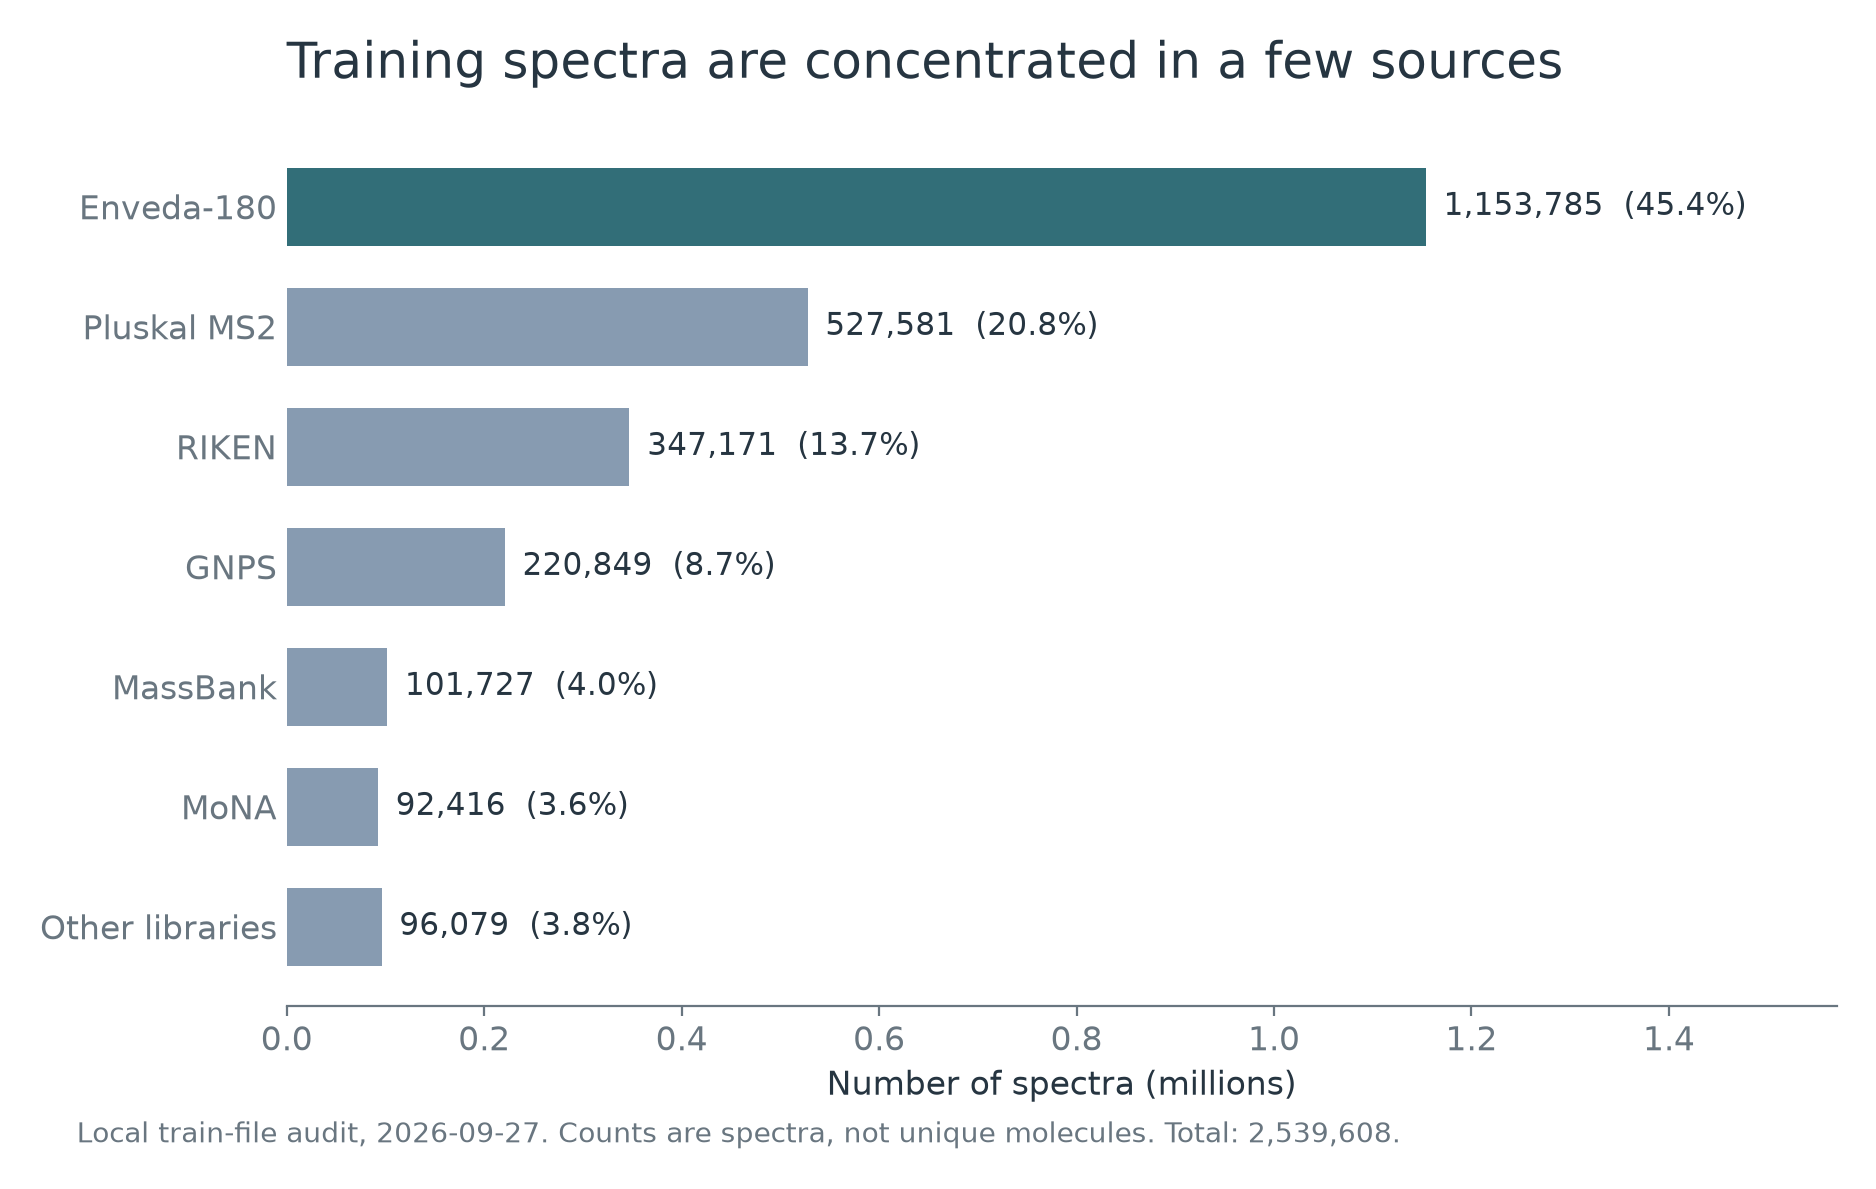
ingest_lib를 집계한 결과. 막대는 분자 수가 아니라 스펙트럼 수다. 기타 자료(그림의 Other libraries)에는 SpectraVerse, MS-DIAL, drug_plus, 자연물 예제, Masaryk 자료를 합쳤다.학습 자료에서는 Enveda-180이 가장 큰 비중을 차지한다. 약 115만 스펙트럼으로 전체의 약 45%를 차지한다. Enveda가 공개한 처리 코드는 이 자료의 구성과 처리 배경을 이해하는 데 도움이 된다.
하지만 행 수가 많다는 사실만으로 목표 분자에 대한 학습 정보가 충분하다고 말할 수는 없다. 같은 구조에서 여러 충돌 에너지로 얻은 스펙트럼들이 있고, 출처마다 화학적 성격과 측정 장비가 다르다. 스펙트럼 100개가 서로 다른 분자 100개에서 왔는지, 같은 분자 10개를 여러 번 측정한 것인지에 따라 학습의 의미가 달라진다.
장비가 맞는 것과 화학적 분포가 맞는 것은 다르다
숨은 테스트가 timsTOF 측정이라는 점에서 Enveda 자료는 우선 살펴볼 만하다. 다만 Enveda-180의 큰 축은 합성 화합물이고, 이번 대회가 관심을 두는 자연물과 그 유사체의 구조적 분포가 그대로 같지는 않다. 다른 라이브러리에는 다양한 자연물 정보가 있지만 장비와 충돌 에너지 조건이 다를 수 있다.
따라서 두 종류의 차이를 함께 생각해야 한다.
- 측정 조건의 차이: 같은 분자라도 장비·에너지·이온 형태에 따라 스펙트럼이 바뀐다.
- 화학 공간의 차이: 같은 장비로 측정했더라도 학습하지 못한 골격과 부분구조가 등장할 수 있다.
특정 라이브러리의 행 수만큼 학습 가중치를 주면 큰 라이브러리가 학습을 지배하기 쉽다. 반대로 자연물 예제만 반복해서 사용하면 작은 집합에 과적합할 수 있다. 분자와 출처를 고려한 샘플링은 실험할 만한 선택이지만, 효과는 구조 단위 검증에서 확인해야 한다.
학습 파일은 두 가지 역할을 한다. 정답 구조가 붙은 측정 스펙트럼이므로 곧바로 검색의 참조 자료가 되고, 동시에 스펙트럼과 구조 사이의 관계를 배우는 학습 예제가 된다. 자료가 많은데도 먼저 검색부터 시작하는 이유가 여기에 있다.
학습 가중치를 평가 단위에 맞춘다
어떤 분자는 스펙트럼 20개, 다른 분자는 2개를 제공한다고 하자. 행 평균 손실에서는 첫 분자의 총가중치가 열 배지만 MRR에서는 두 분자를 한 번씩 센다. 다음은 이를 보정하는 한 가지 방법이다.
\[\mathcal L=\frac1U\sum_{u=1}^{U}\frac1{n_u}\sum_{i=1}^{n_u}\ell(s_{ui},y_u).\]각 분자 안에서 관찰 손실을 평균한 뒤 분자에 같은 가중치를 준다. 출처 균형은 별도의 선택이다. 분자 가중치가 같아도 화학 구조나 장비의 분포까지 같아지지는 않는다. 같은 검증 그룹에서 행 샘플링, 분자 샘플링, 출처별로 나눈 분자 샘플링을 비교하고 전체 MRR과 timsTOF·자연물 관련 하위 집단의 결과를 함께 본다. 그림 9의 출처별 개수는 어느 자료가 학습을 지배할 수 있는지 보여 줄 뿐, 최적 가중치를 알려 주지는 않는다.
7. 검색과 유사 구조로 후보를 모은다
가장 이해하기 쉬운 출발점은 라이브러리 검색이다. 정답을 아는 참조 스펙트럼들과 질의 스펙트럼을 비교하고, 닮은 측정값의 구조를 후보로 가져온다.
피크를 맞춘 뒤 유사도를 계산한다
단순한 방법은 가까운 \(m/z\)의 피크를 대응시킨 뒤 코사인 유사도를 계산하는 것이다. 정렬된 세기 벡터를 \(x,y\)라고 하면 다음과 같다.
\[\operatorname{cosine}(x,y) =\frac{x\cdot y}{\lVert x\rVert_2\lVert y\rVert_2}.\]실제로는 두 스펙트럼의 피크 위치가 정확히 같지 않으므로 허용 오차 안에서 대응시키는 과정이 먼저 필요하다. 세기에 제곱근을 취해 강한 피크의 지배를 줄이는 방법, 전구체에서 조각까지의 질량 차이인 중성 손실을 함께 비교하는 방법도 있다. 구현의 출발점으로는 Fast Spectral Cosine 기준 모델과 matchms가 도움이 된다.
이 방법의 장점은 해석하기 쉽다는 것이다. 왜 이 구조가 후보가 되었는지 참조 스펙트럼을 보여 줄 수 있다. 한계도 분명하다. 정답 구조의 참조 스펙트럼이 없다면, 단순한 동일 구조 검색으로 정답을 가져올 수 없다.
질량으로 구조 후보를 좁힌다
이때 COCONUT이나 PubChem처럼 구조를 모아 둔 데이터베이스를 사용한다. 우선 전구체와 이온 형태로 중성 질량을 추정하고, 허용 오차 안에 있는 구조를 모은다.
질량 오차를 ppm(parts per million)으로 표현하면 다음과 같다.
\[\operatorname{ppm\ error} =10^6\frac{m_{\mathrm{candidate}}-m_{\mathrm{query}}}{m_{\mathrm{query}}}.\]164.083730 Da에서 ±10 ppm은 약 ±0.001641 Da다. 이 값은 허용 오차의 크기를 보여 주는 예시이며, 대회에 사용할 최적의 질량 창을 뜻하지 않는다. 너무 좁히면 측정 오차나 이온 형태 처리 문제로 정답을 버리고, 너무 넓히면 후보 수와 계산량이 늘어난다.
질량 창을 통과했다는 것은 후보가 될 자격을 얻었다는 뜻이다. 구조가 맞다는 증거는 아직 아니다. Eugenol과 Isoeugenol처럼 같은 분자식의 구조들은 이 단계를 함께 통과한다.
닮은 분자의 스펙트럼을 이용한다: 유사 구조 전달
정답 자체의 측정값이 없어도 유사한 구조의 스펙트럼은 있을 수 있다. 질의 스펙트럼과 닮은 참조 분자를 먼저 찾고, 그 분자와 구조적으로 가까운 후보에 점수를 전달하는 방법이 유사 구조 전달(analog propagation)이다. 공개 기준 모델에서 이 접근의 실제 구현을 볼 수 있다.
아이디어를 단순화하면 다음 점수로 표현할 수 있다. 실제 공개 구현의 세부 수식과 동일하다는 뜻은 아니다.
\[S_{\mathrm{analog}}(c\mid q) =\sum_{a\in\mathcal N(q)} w(q,a)\,T\!\left(f(c),f(a)\right).\]여기서 \(q\)는 질의 스펙트럼, \(a\)는 그와 비슷한 참조 분자, \(c\)는 평가할 구조 후보다. \(w\)는 스펙트럼 유사도에서 얻은 가중치다. \(f\)는 분자 구조를 비트 벡터로 표현한 분자 지문(fingerprint), \(T\)는 두 분자 지문의 타니모토 유사도다.
분자 지문은 “이 분자에 이런 국소 구조가 있는가”를 많은 비트로 요약한다. 켜진 비트 집합을 \(A,B\)라고 할 때 타니모토 유사도는 다음처럼 교집합을 합집합으로 나눈 값이다.
\[T(A,B)=\frac{|A\cap B|}{|A\cup B|}.\]이 방식은 측정 스펙트럼이 없는 구조도 점수를 받을 수 있게 한다. 다만 질의와 가까운 스펙트럼이 반드시 구조적으로 가장 가까운 분자에서 왔다고 보장되지는 않는다. 결국 검색 단서는 여러 점수 중 하나로 사용하는 편이 자연스럽다.
실측 검색 점수와 유사 구조 점수를 계산해 본다
공개 Caffeine 기록의 모든 피크를 사용해 10 ppm 안에서 일대일로 매칭하고, 최대값 1로 정규화한 강도에 제곱근을 취하자. 매칭되지 않은 피크도 벡터의 norm에는 남긴다. EA030312와 EA030311의 cosine은 0.9268, EA030312와 EA030309는 0.3925다. 이 작은 기록들에서는 매칭 후보가 중복되지 않는다. 모두 같은 분자를 측정한 스펙트럼 사이의 재현 가능한 유사도이며 분류 성능이 아니다. 30%와 75% 사이의 낮은 유사도에는 강한 잔존 전구체의 차이도 작용한다. 전구체를 제거하면 검색 규칙이 달라지므로 별도로 비교해야 한다.
Cosine은 계산을 직접 따라갈 수 있는 예제다. 재현한 엔진에는 entropy 기반 검색과 이온 형태에 따른 질량 이동을 고려한 검색 채널도 들어 있다. 주요 유사 구조 특징 중 하나는 앞의 설명용 합산식과 달리 스펙트럼 유사도의 세제곱과 Tanimoto의 곱을 최댓값으로 모은다. 두 참조의 (스펙트럼 유사도, Tanimoto)가 (0.8, 0.6), (0.7, 0.9)라고 가정하면 지지 점수는 0.3072, 0.3087이고 최댓값은 0.3087이다. 합산하면 0.6159가 되어 유사한 참조가 반복될 때 다른 효과가 난다. 이 가정값은 집계 방식이 확률의 항등식이 아니라 모델 선택임을 보여 준다.
검색으로 후보를 모았다고 선택까지 끝난 것은 아니다. Eugenol과 Isoeugenol이 모두 남았다면, 다음에는 미지 스펙트럼이 어느 구조의 특징을 더 지지하는지 물을 수 있다.
8. 각 후보를 뒷받침하는 구조 특징을 예측한다
구조 후보를 확보했다면, 질의 스펙트럼이 어떤 부분구조를 시사하는지 직접 학습할 수 있다. 스펙트럼→분자 지문 모델은 각 비트가 켜질 가능성을 예측하고, 이를 후보 구조의 분자 지문과 비교한다. MIST는 이 방향을 이해하는 데 좋은 연구 구현이다.
예를 들어 모델이 특정 방향족 부분구조와 산소를 포함한 부분구조를 강하게 예측했다면, 그런 특징을 갖는 후보에 높은 점수를 줄 수 있다. 출력은 분자 이름 한 개가 아니라 구조 특징에 대한 여러 확률이다.
각 비트의 예측 확률을 \(p_j\), 후보의 비트를 \(f_j(c)\in\lbrace 0,1\rbrace\)라고 하면, 독립적인 베르누이 비트를 가정한 점수는 다음처럼 쓸 수 있다.
\[\begin{aligned} S_{\mathrm{FP}}(c)&=\sum_j f_j(c)\log p_j\\ &\quad+\sum_j(1-f_j(c))\log(1-p_j). \end{aligned}\]실제 분자 지문 비트들은 서로 독립적이지 않으므로 이것은 유용한 점수 모형이지 정확한 화학적 확률의 증명은 아니다. 확률 보정, 희귀 비트의 처리, 비슷한 이성질체를 구분하는 학습이 성능에 영향을 준다.
스펙트럼 표현을 먼저 배울 수도 있다
정답 구조가 달린 자료로 바로 학습하는 대신, 많은 스펙트럼에서 공통 패턴을 먼저 배우는 방법도 있다. DreaMS는 이런 사전학습된 스펙트럼 표현을 제공하는 연구다. 이를 검색용 임베딩으로 쓰거나, 분자 지문 예측 모델의 기반으로 사용할 수 있다.
하지만 좋은 표현을 배웠다는 사실만으로 현재의 후보 순위가 개선되지는 않는다. “스펙트럼끼리 닮았는가”, “구조가 닮았는가”, “이 후보가 정확한 정답인가”는 다른 학습 목표다. 가져온 표현이 마지막 질문에 도움이 되는지는 현재 검증 후보들에서 확인해야 한다.
여러 점수를 하나의 순위로 합친다
후보마다 다음과 같은 증거를 모을 수 있다.
| 점수·특징 | 의미 |
|---|---|
| 직접 검색 유사도 | 이 구조의 실제 참조 스펙트럼과 닮았는가? |
| 유사 구조 전달 점수 | 질의와 닮은 참조 분자들이 이 후보를 지지하는가? |
| 분자 지문 점수 | 스펙트럼에서 예측한 부분구조와 맞는가? |
| 질량·이온 형태 일관성 | 전구체 정보와 양립하는가? |
| 여러 스펙트럼의 일치 | 다른 에너지와 이온화 조건에서도 지지가 유지되는가? |
여러 점수를 가중합으로 묶을 수도 있고, 순위 모델(ranker)에 입력해 후보의 순서를 학습할 수도 있다. 순위 모델에는 정답과 함께 “질량은 맞지만 구조는 틀린” 어려운 오답을 보여 주어야 한다. 무작위로 가져온 전혀 다른 질량의 오답만 학습하면 실제 후보 목록의 어려움을 배우기 힘들다.
Two Rankers, One Engine 같은 공개 노트북은 이런 신호들을 한 추론 경로에서 연결하는 참고 자료다. 여기서 살펴볼 것은 모델 이름의 개수보다, 어떤 후보가 만들어지고 어떤 특징이 최종 순서를 바꾸는지다.
Bernoulli 우도에서 코드의 logit 내적으로 연결하기
후보에 따라 달라지는 항과 같은 질의에서 공통인 항을 나누면 다음과 같다.
\[\begin{aligned} S_{\mathrm{FP}}(c)&=\sum_j f_j(c)\log\frac{p_j}{1-p_j}\\ &\quad+\underbrace{\sum_j\log(1-p_j)}_{\mathrm{const.}}. \end{aligned}\]따라서 이 점수 가정에서는 후보 분자 지문과 예측 logit의 내적만 계산해도 같은 순서를 얻는다. 수치 안정성을 위해 확률을 적절히 제한하거나 유한한 logit을 직접 사용한다. 재현한 엔진도 이런 내적을 순위 모델의 특징 하나로 사용한다. 모든 구조에 대해 보정된 사후확률이라는 뜻은 아니다.
비트 네 개로 계산해 보자. \(p=[0.9,0.2,0.7,0.1]\)이고 후보 A가 [1,0,1,0], B가 [1,1,0,0]이면 전체 로그 점수는 −0.7905, −3.0241이다. 상대적인 증거는 서로 다른 두 비트에서 나오며 공통 비트는 비교에서 상쇄된다. 설명용 비트 벡터이며 Eugenol·Isoeugenol의 화학적 주석이 아니다. 해시된 분자 지문에서는 한 비트가 항상 하나의 명명 가능한 작용기와 일대일로 대응하지 않으므로 비슷한 구조가 여전히 구분되지 않을 수 있다.
순위 모델의 학습 목적도 선택해야 한다
공개 엔진의 pointwise 분류기는 MRR을 직접 최적화하지 않고 후보별 정답 여부를 학습한다. 가능한 대안으로 정답 \(c^+\)와 질량 조건에 맞는 오답 \(c^-\)의 순서를 학습하는 pairwise 손실을 생각할 수 있다.
\[\ell_{\mathrm{pair}}=\log\!\left(1+\exp[-(s(c^+)-s(c^-))]\right).\]점수 차이가 +1이면 손실은 0.3133, −1이면 1.3133이다. Eugenol과 Isoeugenol처럼 같은 분자식의 후보 쌍이 이 목적에서 구분해야 할 대상이다. 무작위로 고른 500 Da 오답으로는 그 판단을 연습할 수 없다. 이 식은 대안적 학습 목적이며 현재 HGB 구현을 설명하는 식은 아니다. 정답이 후보 풀에 없는 질의는 별도의 후보 누락으로 집계해야 하고, 풀 안에서 일반적인 정답–오답 쌍을 만들 수 없다.
분자 지문은 여러 구조 특징을 압축해서 보여 주지만, 닮은 후보가 비슷한 지문 점수를 받을 수도 있다. 이때 질문의 방향을 바꿔 볼 수 있다. 각 후보가 정말 정답이라면 어떤 스펙트럼을 만들까?
9. 후보가 관찰된 스펙트럼을 설명하는지 묻는다
지금까지는 스펙트럼에서 구조 쪽으로 추론했다. 반대 방향도 가능하다. “이 후보가 정답이라면 어떤 조각들이 나와야 할까?”를 계산하고, 예측한 스펙트럼을 관측값과 비교하는 것이다.
이처럼 구조에서 스펙트럼을 예측하는 것을 정방향 예측 모델(forward model)이라고 부른다. ICEBERG와 GLACIER는 이 방향의 공개 연구 구현이다. 후보를 분해했을 때 생길 조각과 상대적 세기를 예측하는 정보를 순위화에 사용할 수 있다.
\[\begin{aligned} \widehat{s}_c&=g(c,\theta),\\ S_{\mathrm{forward}}(c)&=\operatorname{sim}(s_{\mathrm{observed}},\widehat{s}_c). \end{aligned}\]여기서 \(\theta\)는 이온 형태, 충돌 에너지, 장비 같은 측정 조건을 묶어 쓴 것이다.
다시 Eugenol과 Isoeugenol을 생각해 보자. 질량만으로는 두 후보의 순서를 정할 수 없지만, 후보별로 예측한 조각 패턴이 관측값과 얼마나 맞는지는 추가 정보가 될 수 있다. 바로 이런 같은 분자식 안의 순위 결정이 정방향 예측 모델을 시험할 이유다.
그러나 예측 스펙트럼에도 오차가 있다. 학습한 장비, 이온 형태, 에너지가 목표 조건과 다르면 두 후보를 구별하는 핵심 피크를 잘못 예측할 수 있다. 따라서 기존 점수를 모두 버리고 예측 스펙트럼 유사도 하나로 교체하기보다, 추가 특징으로 넣었을 때 분자별 순위가 어떻게 달라지는지 비교하는 출발점이 합리적이다.
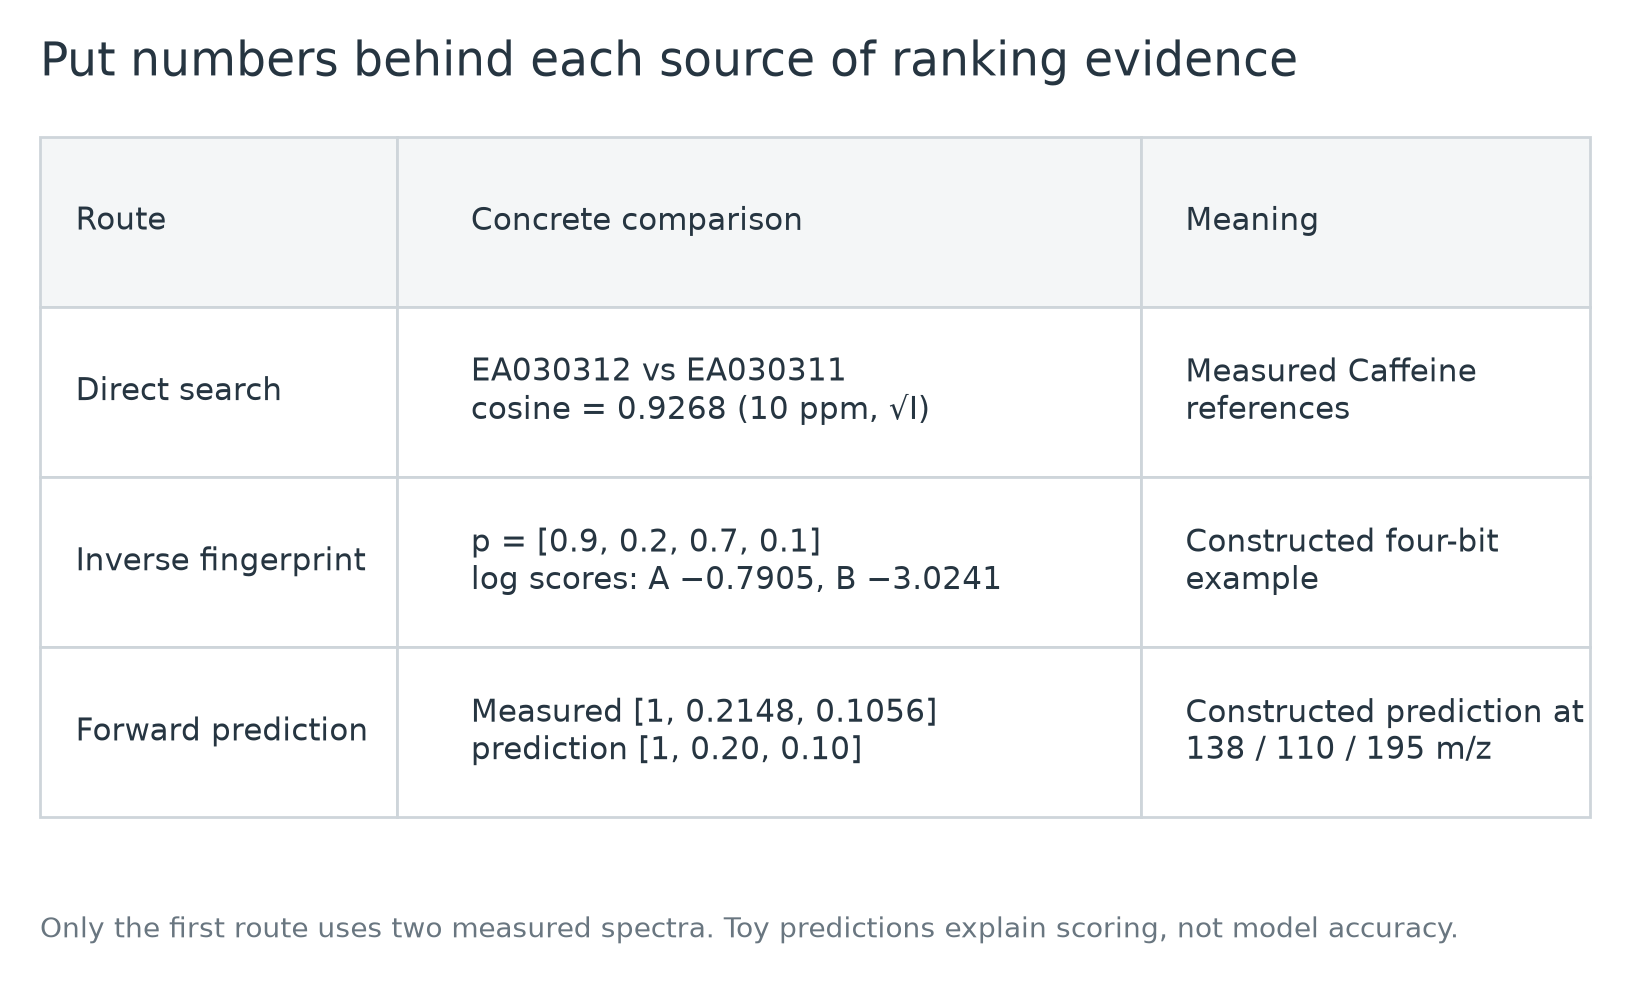
접근별로 무엇을 얻고, 어디서 실패할 수 있는가. 앞의 세 방법과 analog·생성 경로를 함께 놓으면 실험 목적을 구분하기 쉽다.
| 접근 | 추가하는 증거 또는 후보 | 특히 확인할 실패 | 먼저 기록할 결과 |
|---|---|---|---|
| 직접 스펙트럼 검색 | 실제 참조 측정값과의 일치 | 정답 참조가 없거나 조건 차이가 큼 | 참조 유무별 순위와 피크 일치 |
| 유사 구조 전달 | 유사 참조 구조가 지지하는 후보 | 스펙트럼 유사성이 구조 유사성으로 이어지지 않음 | 후보 Recall@K와 오답의 구조 관계 |
| 분자 지문 예측 | 관측값이 시사하는 부분구조 | 같은 분자식의 이성질체가 비슷한 특징을 가짐 | 같은 분자식 후보 사이의 순위 |
| 정방향 예측 | 후보가 관측 스펙트럼을 설명하는 정도 | 조건 불일치, 조각·세기 예측 오차 | 분자별 순위 변화와 추가 시간 |
| 신규 구조 생성 | 고정 데이터베이스 밖의 구조 | 유효한 SMILES가 정확한 정답은 아님 | 정답 키 생성률과 기존 정답의 순위 손실 |
이 표는 방법을 선택하기 위한 비교 기준이다. 특정 모델의 성능이나 계산 비용을 측정해 우열을 정한 결과는 아니다.
모든 후보에 무거운 계산을 할 필요는 없다
후보가 수십만 개라면 구조마다 스펙트럼을 예측하는 것은 비쌀 수 있다. 먼저 빠른 검색과 분자 지문 점수로 후보를 줄이고, 상위 K개에만 정밀 계산을 적용한다.
가령 설계 예시로 400개 분자에 대해 각각 100개 후보, 3개 관찰 조건을 사용하면 최대 12만 개의 후보·조건 비교가 생긴다. 이것은 숨은 테스트의 정확한 작업량 예측이 아니다. 실제로는 분자별 스펙트럼 수가 다르고, 같은 후보·조건을 캐시할 수 있는지에 따라서도 비용이 바뀐다.
MRR이 얼마나 늘었는지와 함께, 그 개선을 얻는 데 실행 시간과 메모리가 얼마나 더 들었는지도 봐야 한다. 정확하지만 시간 제한을 넘기는 방법은 제출 경로에 그대로 넣을 수 없다.
실측 증거와 가정한 모델 출력을 구분한다
75% Caffeine 관측값의 [138.0662, 110.0713, 195.0878]에서 정규화 강도는 [1.0000, 0.21480, 0.10565]다. 어떤 후보의 조건부 모델 예측이 이 위치에서 [1.0, 0.20, 0.10]이고 다른 예측이 [1.0, 0.02, 0.50]이라고 하자. 둘 다 최대 피크를 설명하지만, 두 번째는 110 조각을 과소 예측하고 전구체 잔존을 과대 예측한다. 재점수가 무엇을 비교하는지 보여 주기 위해 만든 예측값이며 실제 체크포인트를 실행한 결과가 아니다. 실제 점수에는 세 피크 외에 누락·과잉 예측된 피크도 포함해야 한다.
공개 정방향 예측 모델을 시험하기 전에는 지원 이온 형태, eV·정규화 에너지 중 무엇을 받는지, 장비 조건화, 질량 범위, 출력 bin, 학습 구조를 명시한다. [M+H]+로 학습한 체크포인트가 음이온 재점수에도 그대로 유효하다고 볼 수는 없다. 분자식 조건부 모델 역시 분자식 추정 단계를 추가하지 않고 알 수 없는 테스트 정답 분자식을 입력받을 수는 없다.
이 경로들도 지금까지는 이미 제안된 구조를 평가한다. 데이터베이스 어디에도 정답이 없다면 관찰값을 잘 설명하는 구조를 새로 제안하는 단계가 필요하다.
10. 데이터베이스 밖의 분자: 신규 구조 생성의 역할
유형 3의 정답은 PubChem과 COCONUT에 없다. 우리가 만든 후보 풀에도 정답이 없다면 그 풀 바깥의 구조를 제안하는 경로가 필요하다. 이처럼 새로운 분자 구조를 제안하는 방법을 신규 구조 생성(de novo generation)이라고 한다. 스펙트럼을 보고 SMILES를 생성하거나, 추정 분자식에 맞는 분자 그래프를 탐색하거나, 기존 후보의 일부를 변형할 수 있다.
MassSpecGym은 검색뿐 아니라 신규 구조 생성과 스펙트럼 예측을 구분된 과제로 제공한다. FOAM은 분자식 제약 아래에서 구조를 탐색하고 스펙트럼 예측 모델을 평가 함수로 사용하는 접근을 살펴볼 수 있는 자료다.
생성 모델의 결과는 다음 단계를 차례로 통과해야 한다.
- 문법적으로 읽을 수 있는가: RDKit으로 파싱되는 SMILES인가?
- 질량과 분자식이 맞는가: 전구체 정보와 모순되지 않는가?
- 화학적으로 그럴듯한가: 비정상적인 결합이나 부적절한 구조가 아닌가?
- 관측 스펙트럼을 설명하는가: 실제 조각 패턴이 생성 후보를 뒷받침하는가?
- 정답 연결성인가: 대회의 구조 식별 키가 정답과 같은가?
첫 단계의 성공률이 높아도 마지막 단계의 성공률은 낮을 수 있다. 정답과 분자 지문이 아주 비슷한 구조를 생성했더라도, 대회는 정확한 키가 다르면 점수를 주지 않는다.
생성 후보를 어디에 넣는지도 예측의 일부다
후보를 생성했다고 무조건 1위에 삽입하면 기존의 맞는 답을 뒤로 밀 수 있다. 원래 정답이 1위였는데 오답을 앞에 끼워 넣으면 그 분자의 점수는 1에서 0.5로 줄어든다.
목록 끝의 빈자리에 후보를 추가하면서 기존 순서를 그대로 유지한다면 그 앞의 정답 순위는 변하지 않는다. 하지만 최종 25개를 넘기거나 중간에 후보를 삽입하면 효과가 달라진다. 생성 모델은 후보의 품질뿐 아니라 기존 후보를 대체할 만큼 신뢰할 수 있는지까지 검증해야 한다.
이 때문에 첫 실험에서 바로 대규모 생성 모델을 학습하기보다는, 검색 후보의 누락과 순위 오류 중 어느 쪽이 더 큰 문제인지 먼저 알아보려 한다. 후보 안에 정답이 많은데 같은 분자식의 오답이 앞서는 경우라면, 생성보다 순위 개선이 직접적인 다음 단계가 된다.
그래프를 실제로 바꾸는 예와 그 한계
Isoeugenol의 COc1cc(C=CC)ccc1O에서 곁사슬 이중결합 위치를 옮기면 Eugenol의 COc1cc(CC=C)ccc1O이 된다. C10H12O2, 정확질량, DBE = 5는 바뀌지 않는다. 두 문자열은 모두 유효하지만 평가 키는 다르다. 빠진 후보를 그래프 편집으로 제안하는 구체적인 예이며, 어느 구조가 관측 스펙트럼에 맞는지까지 알려 주지는 않는다. 알려진 구조 벤치마크에서 Eugenol을 제외하면 생성의 대리 실험이 될 뿐, 새 분자를 발견한 것은 아니다.
분자식 제약 탐색이라면 분자식 후보 목록부터 평가한다. 질의 100개 중 90개에서만 정답 분자식이 들어 있다면, 그 목록 안으로 제한한 탐색은 최대 90개까지만 회수할 수 있다. 그래프 유효율, 중복 제거 후 구조 수, 정답 키 재현율, 결합 후 순위, 모델 호출 수를 따로 기록한다. Beam을 문자열 100개에서 1,000개로 늘려도 중복만 주로 늘 수 있으므로 문자열 수보다 고유 구조와 정확한 정답 회수가 중요하다.
검색·예측·생성을 결합할수록 로컬 점수를 쉽게 높이는 경로도 늘어난다. 하지만 새 분자를 이해해서 얻은 개선과 정답을 이미 본 효과는 다르다. 다음 절에서는 그 둘을 구분할 검증 조건을 정한다.
11. 분자 단위 OOF: 어디까지 학습에서 제외해야 하나
OOF(out-of-fold) 예측은 각 샘플이 포함된 fold를 학습에서 제외한 모델로 만든 예측이다. 정답을 직접 학습한 효과를 줄인 상태에서 모델을 비교하고 앙상블 가중치를 정하는 데 쓴다. OOF는 예측을 만드는 절차다. 같은 구조들로 학습한 여러 시드의 모델을 평균했다고 OOF가 되지는 않는다. 그룹 교차검증 · 스태킹
하나의 분할이 전체 파이프라인을 따라가야 한다
그룹은 평가와 같은 정규화 구조 키로 정한다. 실측 예제의 Caffeine 스펙트럼은 모두 RYYVLZVUVIJVGH에 해당하므로, 충돌 에너지나 출처 라이브러리가 달라도 같은 바깥 fold에 들어간다. SMILES 표기나 호변이성질체가 달라도 정규화 결과가 같다면 마찬가지다. 행을 무작위로 나누면 한 Caffeine 스펙트럼으로 학습하고 다른 Caffeine 스펙트럼으로 검증하게 된다.
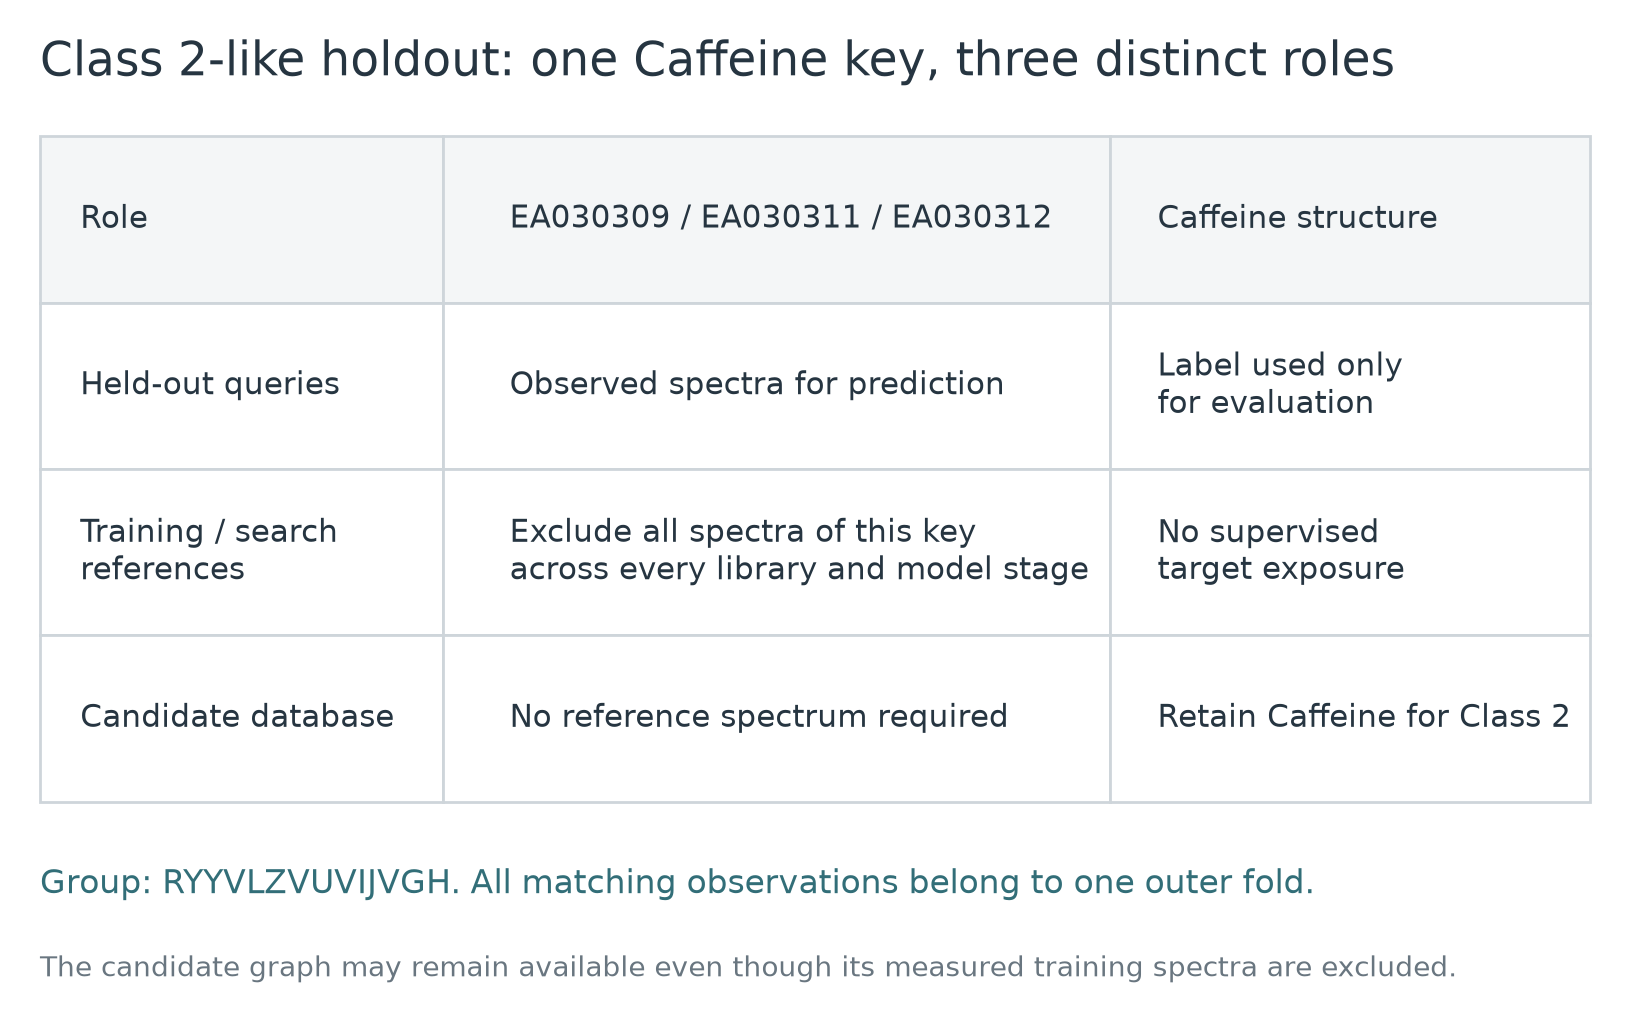
유형 2에 가까운 비교에서는 검증 분자가 세 가지 역할을 한다. 질의 스펙트럼은 예측에 사용하고, 참조 스펙트럼과 지도학습 정답은 학습·검색에서 제외하며, 구조 자체는 후보로 남겨 둔다. 세 역할을 한 테이블로 취급해 분자를 모두 지우면 후보 제외 실험으로 바뀐다.
| 구성 요소 | 바깥 검증 fold의 Caffeine 처리 | 이유 |
|---|---|---|
| 참조 스펙트럼 라이브러리 | 모든 라이브러리에서 같은 정규화 키의 스펙트럼을 제거한다. | 검증 구조의 참조 측정값을 직접 찾아 정답을 회수하지 못하게 한다. |
| 분자 지문 인코더·스펙트럼 예측 모델 | 지도학습에서 해당 구조의 예제를 제외한다. 고정된 사전학습 가중치는 따로 확인한다. | 검색 자료에서 지웠다고 가중치의 학습 내용까지 사라지지는 않는다. |
| 구조 후보 데이터베이스 | 유형 2에서는 Caffeine을 유지하고, 유형 3에 가까운 생성 검증에서는 제거한다. | 정답 후보의 존재 여부가 평가할 과제를 결정한다. |
| 순위 학습 행·보정 모델·앙상블 가중치·중단 임계값 | 바깥 검증 fold 없이 학습·선택한다. | 이 단계의 정답과 선택도 파이프라인 학습의 일부다. |
| 후보 구조에서 계산한 질량·분자 지문 | 유형 2에서는 Caffeine의 후보 측 정보로 사용할 수 있다. | 구조에서 결정적으로 계산한 특징은 정답 스펙트럼의 관측값과 다르다. |
기본 모델의 OOF와 스태커의 독립 평가는 다르다
분자 \(u\)가 속한 fold를 \(f(u)\)라 하면, 후보 \(c\)에 대한 모델 계열 \(m\)의 OOF 출력은 다음처럼 쓸 수 있다.
\[z_{u,c}^{(m)}=s_m^{(-f(u))}(\mathcal S_u,c).\]위 첨자는 해당 fold를 제외하고 학습했다는 뜻이다. 후보별 표에는 분자 키와 후보 키를 함께 인덱스로 저장한다. 어떤 모델의 0번 행인 후보 A가 다른 모델의 0번 행인 후보 B와 잘못 결합되면 안 된다. 후보 풀이 다르면 합집합을 명시적으로 만들고, 반환되지 않은 후보를 따로 표현한다. 순위 기반 점수라면 미반환 후보에 지지 점수 0을 줄 수 있으며, 이를 1위로 취급해서는 안 된다.
각각 1,000개 구조가 있는 5개 fold를 생각해 보자. 분자 지문 모델이 5,000개 전체에 OOF 예측을 만들었다고 하자. 그 표 전체로 순위 모델을 학습한 뒤 같은 표에서 점수를 보고하면, 순위 모델은 평가 정답을 이미 본 것이다. 인코더 출력은 OOF였지만 파이프라인 전체가 독립적으로 평가된 것은 아니다.
엄격한 설계에서는 바깥쪽 구조 분할로 파이프라인 전체를 평가한다. 바깥 학습 구조 안에서 다시 내부 OOF 특징을 만들어 순위 모델과 보정 모델을 학습한다. 이어서 인코더를 바깥 학습 구조 전체로 다시 학습하고 바깥 검증 질의를 예측한다. 순위 모델은 이 질의의 정답을 보지 않은 상태여야 한다. 이를 바깥 fold마다 반복한다. 이 예측으로 앙상블 가중치까지 고른다면, 선택된 조합의 성능 추정에는 추가로 남겨 둔 평가 집합이나 더 바깥의 선택·평가 분리가 필요하다. 추가 학습 비용이 크므로, 작은 규모에서는 개발·선택·최종 점검 집합을 고정해서 나누는 방법도 현실적인 대안이다.
전체 데이터로 미리 만든 인코더 OOF 표를 다시 나눠 순위 모델을 교차검증하는 것만으로는 충분하지 않다. 순위 모델의 학습 행을 만든 인코더가 바깥 평가 구조를 학습했을 수 있으므로, 특징 생성도 바깥 학습 집합 안에서 다시 해야 한다. 순위 점수로 보정 모델이나 경로 선택 규칙을 학습한다면 순위 모델 자체의 cross-fitted 출력도 구분해 만든다. 바깥 평가 집합을 끝까지 보존한 경우에는 그 집합에서 전체 절차를 독립적으로 평가할 수 있다.
후보 생성도 같은 분할을 따라야 한다. 실제 검색 경로의 후보 재현율을 측정해야 한다. 검증 후보 풀에 정답을 강제로 넣는 실험은 정답 후보가 있다는 조건에서 순위 모델을 진단할 때는 유용하지만, 전체 파이프라인의 MRR로 보고할 수는 없다.
앙상블을 숫자로 읽어 보기
검증 분자 세 개를 놓고 계산한 예제다. 모델 A의 정답 순위가 [1, 2, 25], 모델 B가 [2, 1, 25], 후보 키를 맞춰 결합한 결과가 [1, 1, 25]라고 가정하면 MRR은 각각 0.5133, 0.5133, 0.6800이다. 결합 후 순위는 예제를 위한 가정이다. 정답의 순위 세 개만으로 실제 결합 결과를 유도할 수는 없으며, 경쟁하는 모든 후보의 점수나 순위가 필요하다.
반면 세 번째 모델이 A와 완전히 같은 순서를 반환한다면 단독 점수가 강하더라도 새 순위 정보를 더하지 못한다. 실제 OOF에서는 후보 점수 사이의 의존성과 분자별 reciprocal rank 변화를 함께 본다. 부트스트랩도 반복 측정 스펙트럼이 아니라 분자를 재표집한다. 후보 Recall@K, MRR, Top-1에 더해 이온 형태·질량·장비와 출처·관찰 수별 결과를 남긴다. 골격 단위 holdout은 더 먼 화학 구조로의 일반화를 보는 추가 점검이지, 원래 평가하려는 과제의 정의를 대신하지 않는다.
공개 사전학습 가중치의 학습 구조를 모른다면 그 한계는 남는다. 뒤쪽 분할에 GroupKFold를 썼다는 사실만으로 앞쪽 표현 모델까지 독립적이 되지는 않는다. 필요한 학습 제외가 확인되지 않았다면 고정된 공개 모델을 사용한 평가라고 기록한다.
12. 공개 작업은 지금 어디까지 왔나
공개된 출발점은 이미 가장 비슷한 스펙트럼 하나를 찾는 수준을 넘어섰다. 측정 스펙트럼 라이브러리, 학습 자료와 COCONUT에서 가져온 구조 후보, 분자 지문 예측 모델, 여러 증거를 결합하는 순위 모델을 연결할 수 있다. 처음 참가하는 입장에서는 무엇을 먼저 재현하고, 그다음 어떤 오류를 조사할지 정하는 것이 중요하다.
리더보드는 확인 시각이 있는 측정값으로 읽는다
2026년 9월 27일 02:59:30 UTC에 내려받은 공개 리더보드에는 점수가 있는 팀 1,608개가 들어 있었다. 아래 표는 그 파일을 집계한 결과이며 실시간 수치가 아니다. 공개 리더보드
| 당시 관찰한 항목 | 값 | 읽는 방법 |
|---|---|---|
| 공개 MRR@25 최고점 | 0.425 | 공개 평가의 선두 수준이다. 이 숫자만으로 사용한 방법은 알 수 없다. |
| 공개 점수 2위와 3위 | 0.421 / 0.412 | 여러 팀이 0.40을 넘었다. |
| 팀 점수의 중앙값 | 0.292 | 내려받은 팀 항목의 절반이 이 값 이하였다. |
| 0.335 이상 0.342 이하인 팀 수 | 263 | 공개 기준 방법과 가까운 좁은 구간에 많은 팀이 모여 있다. 같은 코드를 쓴다는 증거는 아니다. |
MRR 0.425는 분자의 42.5%를 1위로 맞혔다는 뜻이 아니다. 순위의 역수를 평균하므로, 1위 정답·하위 순위 정답·실패의 서로 다른 조합에서 같은 값이 나올 수 있다. 공개 순위만으로 비공개 최종 순위를 알 수도 없다. 공개 점수가 조금 달라졌다면, 소수점만 보고 새로운 능력이 생겼다고 해석하기보다 따로 남겨 둔 검증 분자 중 무엇이 달라졌는지 확인하는 편이 유용하다.
공개 노트북은 무엇을 더했나
아래 점수는 같은 9월 27일 조사에서 노트북의 실제 점수 표시를 확인한 것이다. 표시한 버전에 해당하며, 구성 요소 하나만 바꾼 통제 실험의 비교표는 아니다. 특히 노트북의 최고점(Best Score)은 화면에 현재 표시된 소스보다 이전 버전의 결과일 수 있다.
| 공개 노트북과 확인 버전 | 표시된 공개 점수 | 전체 흐름에서 읽을 부분 |
|---|---|---|
| Analog Propagation, 최고점 버전 V10 | 0.335 | 측정 스펙트럼 검색, 닮은 구조를 통한 증거 확장, 학습된 특징의 결합으로 이어지는 공통 기반이다. 조사 당시 소스 화면은 V32였지만 0.335는 V10의 점수다. |
| Fast Spectral Cosine baseline, V17 | 0.339 | 단순 검색을 연상시키는 이름과 달리, 전처리 선택과 여러 점수 경로를 이어받아 발전한 파이프라인을 볼 수 있다. |
| Two Rankers, One Engine, V1 | 0.337 | 공통 후보 엔진 안에서 서로 다른 순위와 그 결합을 명시적으로 다룬다. |
| Evgen Dvorkin의 Enveda CASMI 노트북, V15 | 0.342 | 공개 two-ranker 변형으로, 실제로 재현하며 시작하기 좋은 기반이다. |
| Ahmed Beratozer의 v3 추론 노트북, V6 | 0.358 | 더 풍부한 엔진에 별도로 제어하는 PubChem 후보 경로를 더했다. 필요한 입력 일부는 비공개다. |
| Ahmed Beratozer의 v4f 추론 노트북, V1 | 0.362 | 더 많은 순위 증거와 ICEBERG 재평가가 포함된다. 비공개 입력 때문에 노트북만으로 독립 재현하기는 어렵다. |
이 사례들에서는 이미 측정한 분자를 알아보기 → 참조 스펙트럼이 없는 알려진 구조로 확장하기 → 갈수록 비슷한 후보를 구별하기라는 흐름을 읽을 수 있다. 그렇다고 추가된 구성 요소마다 인과적인 성능 향상이 입증된 것은 아니다. 점수가 높은 노트북은 학습 자료·후보 집합·특징·모델을 함께 바꿨을 수 있다. 예를 들어 0.362는 그 제출 파이프라인의 결과이지, 그 자체로 측정된 “ICEBERG의 개선 폭”은 아니다.
공개 코드를 보면 모델 이름만으로는 방법을 재현할 수 없다는 점도 드러난다. 노트북의 입력 탭에서 구조 목록은 가능한 답을 제공하고, 분자 지문 가중치는 스펙트럼을 구조 증거로 바꾸며, 모의 순위 학습 자료는 후보의 순서를 가르친다. 패키지 파일은 오프라인 실행을 가능하게 한다. 이 조합을 재현하려면 입력 버전도 서로 맞아야 한다. 비공개 가중치에 의존하는 코드에서도 아이디어는 배울 수 있지만, 곧바로 실행 가능한 기준 방법을 얻는 것은 아니다.
지금 진전을 막는 것은 무엇으로 보이나
약 30회 제출을 돌아본 참가자 글은 정답 구조가 후보에 있어도 같은 분자식의 오답이 앞서는 경우를 자주 보고한다. 점수 정체에 관한 논의에서도 특징이나 모델을 추가했지만 개선이 작았던 사례를 볼 수 있다. 이는 각 참가자의 실험 조건에서 나온 관찰이며 숨은 데이터 전체를 측정한 결과는 아니다.
앞의 Eugenol·Isoeugenol 예제가 이런 선택의 성격을 보여 준다. 질량 필터는 둘 다 통과시킬 수 있고, 대략적인 구조 특징도 둘 다 지지할 수 있다. 여기서 필요한 새 신호는 타당한 이유로 두 후보의 상대 순위를 바꾸는 정보다. 더 큰 데이터베이스가 빠진 정답을 찾아 줄 수도 있지만, 비슷한 오답만 주로 늘린다면 순위 모델의 과제는 더 어려워진다. 정답을 후보에 포함하는 능력과 그 후보를 앞에 놓는 능력을 따로 재야 한다.
그래서 공개된 0.34 부근의 방법을 반복적인 파라미터 조정으로 따라갈 점수보다 작동 원리를 이해할 기준점으로 삼으려 한다. 선두의 공개 점수는 그 위에 여지가 있음을 보여 준다. 그 여지가 후보 범위, 순위화, 생성, 또는 상위 팀이 공개하지 않은 조합 중 어디서 나왔는지는 점수만으로 알 수 없다.
이 프로젝트가 확보한 것과 아직 확인하지 못한 것
이 프로젝트에서도 두 순위 모델을 결합한 공개 엔진을 바탕으로 한 제출이 완료되어 공개 MRR@25 0.342를 얻었다. 공개 기준 방법을 재현한 결과이며, 새로운 모델링 개선을 입증한 것은 아니다. 이 수치는 프로젝트의 제출 기록과 Kaggle의 완료 응답으로 확인했다.
다음으로 해결해야 할 일은 믿을 만한 로컬 비교다. 특히 유형 2를 평가하려면 남겨 둔 구조의 정답 스펙트럼과 지도학습 노출은 제거하면서도, 정답 구조 자체는 후보 풀에 유지해야 한다. 이 프로젝트는 새로운 정방향 모델·순위 모델·생성 방법으로 독립 검증된 개선을 아직 확보하지 않았다. 현재 위치는 분명하다. 시스템이 실행되고 숨은 평가의 기준 점수도 생겼다. 이제 어느 변화를 다음 버전에 넣을지 판단할 증거를 만들어야 한다.
자료는 다음 판단에 필요한 순서로 읽는다
| 자료 | 먼저 볼 부분 | 이 프로젝트에서 답하려는 질문 |
|---|---|---|
| Fast Spectral Cosine 기준 모델 | 라이브러리 검색 부분의 피크 처리와 질량 인덱스 | 직접 검색을 어떻게 구현하는가? 전체 노트북 점수에는 다른 경로의 효과도 포함된다. |
| 유사 구조 전달 기준 모델 | 후보 풀, 유사 분자 전달, 분자 지문 점수 | 측정값이 없는 구조에 어떻게 점수를 주는가? |
| Two Rankers, One Engine | 여러 점수의 결합과 분자별 출력 | 각 증거가 최종 순서에 어떻게 반영되는가? |
| MassSpecGym | 검색·신규 구조 생성·스펙트럼 예측 과제와 분할 | 서로 다른 능력을 어떻게 나누어 평가하는가? |
| MIST · DreaMS | 스펙트럼 표현과 구조 특징 예측 | 검색에서 얻지 못한 정보를 학습할 수 있는가? |
| ICEBERG·GLACIER | 후보별 스펙트럼 예측과 조건 입력 | 같은 분자식의 후보를 더 잘 구별하는가? |
| FOAM | 분자식 제약 탐색과 호출 예산 | 제한된 계산 안에서 새 구조를 만들 수 있는가? |
13. 효율적으로 학습하고, 제출 예산에 맞는 앙상블을 고른다
CASMI에서도 검증 예측을 바탕으로 서로 보완하는 모델을 고르는 Kaggle의 전형적인 문제가 나타난다. 여기에 모델마다 후보 집합이 다르고 비싼 중간 계산을 공유할 수 있다는 조건이 더해진다. 목표는 개별 모델 점수의 합이 아니라 시간·메모리 예산 안에서 최종 후보 순서의 MRR을 높이는 것이다.
서로 다른 세 가지 시간 예산
| 예산 | 포함되는 작업 | 실제 의미 |
|---|---|---|
| 오프라인 개발 | 모델 학습, fold별 예측, 후보 구성, 순위 모델 학습, 앙상블 선택 | 추론 9시간 제한이 이전의 모든 학습을 합쳐 9시간 안에 끝내라는 뜻은 아니다. |
| Kaggle 개발용 GPU 할당량 | 개발 세션과 버전 실행에서 사용하는 계정의 GPU 시간 | 공식 안내는 주당 30시간 또는 자원·수요에 따라 그 이상으로 설명한다. 실제 할당량을 확인해야 한다. |
| 제출 노트북 한 번의 실행 | 로딩, 전처리, 검색, 실행 중 학습, 추론, 결합, CSV 검사 | CPU·GPU 모두 인터넷 없이 9시간 이내에 전체 과정을 마쳐야 한다. |
세 제약은 따로 계산해야 한다. 주최 측은 비공개 외부 클라우드에서 학습한 뒤 가중치를 Kaggle로 가져오는 방법을 명시적으로 허용했다. 대회 데이터를 공개해도 된다는 뜻은 아니다. 실행 조건 · Kaggle GPU 할당량 · 주최 측 답변
예산 계산 예제로, 모델 계열 3개 × fold 5개 × 시드 2개 × 학습당 선택한 백엔드 할당량 2시간이면 벌써 60 GPU시간이다. OOF 특징 생성과 최종 재학습 비용은 아직 더하지 않았다. 각 학습이 해당 백엔드 할당량을 두 시간씩 소비한다고 가정할 때, 주당 30시간이 주어진다면 두 주의 할당량 전체에 해당한다. GPU를 병렬로 쓰면 경과 시간은 줄어도 GPU시간의 총비용이 사라지지는 않는다. 따라서 새 표현 모델을 고정된 개발 집합에서 먼저 평가한 뒤 전체 fold와 여러 시드로 확장하는 편이 CSV 저장 몇 초를 줄이는 것보다 훨씬 큰 차이를 만들 수 있다.
현재 재현한 엔진은 무엇을 앙상블하는가
현재 공개 코드 기반 엔진은 스펙트럼별 FPNet과 병합 스펙트럼용 FPNet 두 종류를 불러온다. 또 서로 다른 순위 학습 표에서 시드와 클래스 사전확률을 바꿔 gradient-boosting 분류기 16개와 12개를 학습한다. 각각 31개와 51개 특징을 사용한다. 집합 안에서는 확률을 평균하고, 두 집합은 주로 분자 안에서 정규화한 순위를 0.88/0.12로 결합한다. 원시 확률을 이 비율로 더하는 방식은 아니다. 같은 학습 행을 공유하는 시드 앙상블만으로 파이프라인 전체의 OOF 검증이 성립하지도 않는다. 공개 엔진의 계보
이 작은 분류기 28개의 학습은 현재 노트북 실행 중에 이루어지므로 제출 시간에 포함된다. 미리 학습해 직렬화하면 이 비용을 오프라인으로 옮길 수 있겠지만, 데이터·패키지 버전·수치 연산·최종 출력이 일치하는지 확인해야 한다. 아직 이 프로젝트에서 검증한 변경이 아니라 최적화 제안이다.
CPU·GPU 작업이 섞인 구간부터 계측한다
기존 실행 로그를 보면 규모를 구체적으로 가늠할 수 있다. 아래 두 실행은 모두 공개 예제 파일의 1,213개 스펙트럼·400개 분자를 처리했다. 실행 측정값이며 숨은 테스트의 정확도나 소요 시간을 보장하는 수치는 아니다.
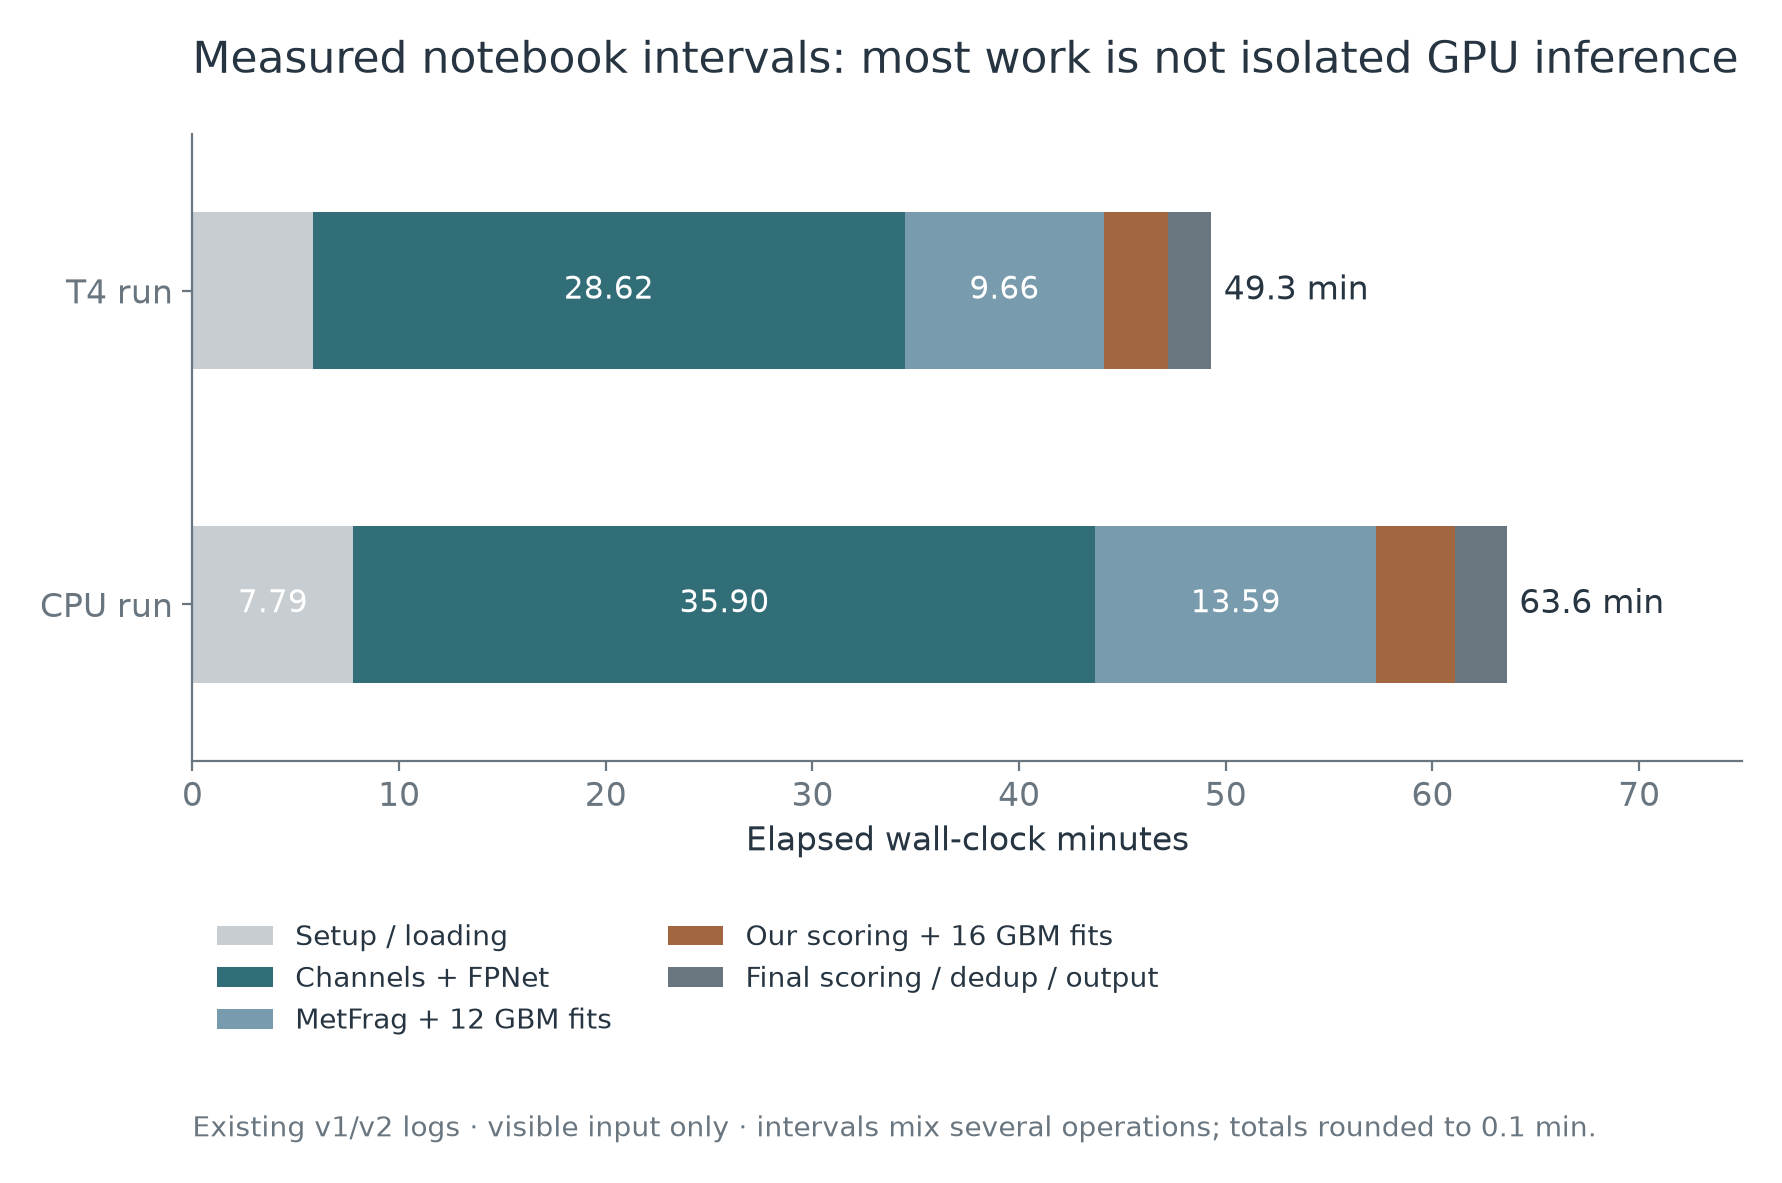
| 로그 구간 | T4 실행, 분 | CPU 실행, 분 | 실제 포함된 작업 |
|---|---|---|---|
| 테스트 로드 완료 → MetFrag 시작 | 28.62 | 35.90 | 스펙트럼 검색 채널과 FPNet. GPU 추론만의 시간이 아니다. |
| MetFrag 시작 → GBM 12개 학습 완료 | 9.66 | 13.59 | 조각 특징 계산과 GBM 12개 학습. |
| GBM 12개 학습 완료 → GBM 16개 학습 완료 | 3.08 | 3.83 | 해당 경로의 점수 계산과 GBM 16개 학습. |
| GBM 16개 학습 완료 → 제출 표 준비 완료 | 2.10 | 2.49 | 나머지 점수 계산, 중복 제거, 제출 표 구성. |
| CSV 구성까지 보고된 경과 시간 | 49.3 | 63.6 | Manifest에 기록된 시간. 이후 해시 계산·플랫폼 종료는 제외한다. |
더 빠른 가속기를 사용해도 CPU 검색·로딩·순위 모델 학습은 없어지지 않는다. 전체 시간을 스펙트럼 수의 비율로 단순 확대해서도 안 된다. 준비 작업은 대체로 고정 비용이고, 스펙트럼 추론은 관찰 수에, 후보 점수 계산은 후보 수와 밀도에 따라 늘어난다. 이 로그는 더 세분된 프로파일링의 출발점이지 특정 구성 요소의 속도 향상을 따로 입증한 결과는 아니다.
학습 계산량을 어디에 쓸 것인가
우선 서로 다른 오류를 고칠 가능성이 있는 서로 다른 모델 계열을 비교한다. 예를 들어 스펙트럼 인코더, 정방향 예측 모델, 별도 증거를 쓰는 순위 모델이다. 같은 그룹 분할과 데이터 예산에서 각 계열의 통제된 설정 하나부터 비교한다. 학습비가 크다면 작은 고정 집합에서 선별하고, 유용한 설정만 전체 fold와 여러 시드로 확장한다. 선별 점수는 모델 선택용이며, 선택된 시스템을 확인할 평가 집합은 따로 남긴다.
모델·fold·후보 구성 규칙을 고정한 뒤에는 후보 키를 맞춘 OOF 예측을 한 번 저장한다. 가중치를 바꾸거나 가벼운 결합 모델을 비교할 때마다 인코더를 다시 학습할 필요는 없다. 원본 파싱이나 후보 구조에서 결정적으로 계산한 특징도 공유할 수 있다. 다만 학습되는 변환, 정답에서 만든 참조 라이브러리, 지도학습 특징에는 fold 경계가 적용된다. 전역 캐시로 저장했다고 분할 사이에 공유해도 되는 것은 아니다.
학습 epoch와 조기 종료 기준에도 바깥 평가 정답을 쓰지 않는다. 실패하거나 버린 학습까지 포함해 명시한 계산 예산에서 개선량을 비교한다. 시드 두 개를 더 돌려도 같은 분자를 틀리는데 새 표현 모델은 그 오류를 고친다면, 다음 학습 예산은 새 표현에 쓰는 편이 나을 수 있다. 판단 근거는 새로운 모델 이름이 아니라 같은 분자에서 비교한 순위 변화다.
OOF를 만들었다고 제출 때 모든 fold 모델을 써야 하는 것은 아니다
5-fold 학습을 마치면 체크포인트 다섯 개가 남는다. 제출에서는 전부 쓰거나, 검증한 일부만 쓰거나, 허용된 전체 자료로 다시 학습한 모델 하나를 쓸 수 있다. 추론비·분산 감소·학습 자료 크기 사이의 선택이다. 전체 자료 재학습은 점수 보정도 바꿀 수 있다. 하나의 fold 모델이 만든 OOF 특징으로 학습한 순위 모델에 다섯 모델의 평균 특징을 넣으면 입력 분포가 달라질 수 있으므로, 체크포인트의 개수가 아니라 실제로 배포할 구성을 검증해야 한다.
전체 자료를 다섯 fold로 나눠 학습한 모델을 검증 분자에 모두 평균하면 OOF 예측이 아니다. 그중 네 모델은 해당 분자를 학습했을 수 있다. 배포할 앙상블을 평가할 때는 기여하는 모든 모델에서 바깥 검증 분자를 제외해야 한다.
예를 들어 분자 400개, 분자당 스펙트럼 3개, 각 입력 형태마다 fold 모델 5개라면 개별 스펙트럼과 병합 스펙트럼 인코딩은 대략 5 × (1,200 + 400) = 8,000회다. 후보 100개를 세 조건에서 평가하는 정방향 예측 모델은 최대 5 × 400 × 100 × 3 = 600,000회의 후보–조건 계산이 필요하다. 한 번의 연산 크기가 다르므로 횟수 비율이 곧 속도 비율은 아니다. 배치 처리 효과까지 반영한 후보–조건당 실측 비용이 10 ms라고 가정하면 이 단계만 100분이다. 10 ms는 설명을 위한 가정이며 여기서 측정한 값이 아니다.
모델 선택을 제약이 있는 조합 최적화로 본다
직렬 실행을 가정하면 비용을 다음처럼 나눌 수 있다.
\[\begin{aligned} T(\mathcal M,g)&=T_{\mathrm{load}}+T_{\mathrm{shared}}\\ &\quad+\sum_{m\in\mathcal M}T_m^{\mathrm{incremental}}(g)\\ &\quad+T_{\mathrm{runtime\ fit}}+T_{\mathrm{output}}. \end{aligned}\]공유 후보 인덱스나 인코더 특징은 한 번만 센다. 추가 비용은 이미 선택한 모델과 경로 선택 규칙 \(g\)에 따라 달라진다. 병렬 실행에서는 직렬 합이 실제 시간을 예측한다고 가정하지 말고 작업 의존성과 자원 경합을 함께 측정한다.
모델 선택은 다음 문제로 정리할 수 있다.
\[\begin{aligned} \max_{\mathcal M,w,g}\quad &\widehat{\operatorname{MRR}}_{\mathrm{selection}} \!\left(\operatorname{Fuse}_{w,g}(\mathcal M)\right)\\ \text{subject to}\quad &\widehat T_{\mathrm{stress}}(\mathcal M,g)+\Delta\leq9\ \mathrm{h},\\ &M_{\mathrm{peak}}\leq M_{\mathrm{available}}. \end{aligned}\]\(w\)는 결합 파라미터, \(\Delta\)는 측정에 근거해 남긴 여유 시간이고, 모자 기호는 추정값임을 뜻한다. 새로운 입력의 작업량까지 보장하는 식은 아니다. 명시적인 작업량 상한과 전체 실행 점검이 여전히 필요하다. 선택한 시스템의 최종 정확도는 11절에서 남겨 둔 독립 평가 집합으로 확인한다.
다음은 가상의 조합 비교다. 공유 작업은 0.75시간, 추가 모델 비용은 A가 2.0시간, B가 1.5시간, C가 4.5시간이라고 하자. MRR은 완전한 후보 목록을 실제로 결합했을 때 얻었다고 가정한 값이며 개별 모델 점수의 평균이 아니다.
| 선택 모델 | 가정한 선택 집합 MRR | 공유 작업을 포함한 총시간 | 예시로 정한 8시간 작업 예산 충족? |
|---|---|---|---|
| A | 0.340 | 2.75 | 예 |
| B | 0.330 | 2.25 | 예 |
| C | 0.350 | 5.25 | 예 |
| A + B | 0.360 | 4.25 | 예 |
| A + C | 0.365 | 7.25 | 예 |
| A + B + C | 0.367 | 8.75 | 아니요 |
여유 시간을 한 시간 남기기로 했다면, 세 모델을 모두 쓸 때 추정 MRR이 가장 높더라도 위 선택지 중에서는 A + C를 고른다. 한 시간 여유는 운영상 가정이지 Kaggle 규칙은 아니다. 작업량의 불확실성이 더 크다면 저렴한 A + B가 나을 수도 있다. 추가 MRR을 추가 시간으로 나눈 값은 선별에 유용하지만, 모델 사이의 상호작용 때문에 탐욕적으로 고른 조합이 전체 최적이라고 보장할 수는 없다.
모델이 실제로 시간을 쓰는 곳에서 줄인다
분자 지문 모델은 관찰을 한 번 인코딩한 뒤 후보 비트 벡터와 logits를 비교한다. 정방향 예측 모델은 구조·지원하는 측정 조건·모델 버전을 키로 예측을 재사용하고 후보를 배치로 처리한다. 지원하지 않는 에너지나 이온 형태의 예측을 대신 쓰면 과제가 바뀐다. 저렴한 첫 단계에서 K = 100으로 자르면 정답이 101위인 분자는 회수할 수 없으므로 이 상한을 쓰기 전에 Recall@K를 측정한다.
저장 형식도 차이를 만든다. 711,705 × 6,930 이진 분자 지문 행렬은 부가 정보를 제외하고 비트 단위 압축 시 약 0.574 GiB, uint8이면 4.59 GiB, float32이면 18.37 GiB다. 후보 전체를 한 번에 풀면 압축의 이점이 사라지므로 점수 계산을 블록으로 나눠 작업 메모리를 제한한다. 과도한 CPU 스레드 경쟁, 반복적인 가중치 로딩, 지나치게 작은 GPU 배치는 별도로 측정할 항목이다.
비싼 정방향 예측 모델을 일부 분자에만 적용하려면 추론 시 얻을 수 있는 값으로 경로를 골라야 한다. 두 순위 모델의 불일치나 좁은 점수 차이는 사용할 수 있지만, “정답이 현재 2위인 분자”라는 조건은 쓸 수 없다. 검증 예측으로 경로 선택 규칙을 정하고, 자신 있게 틀리는 분자까지 포함해 평가한다. 후보가 많은 질의, 긴 피크 배열, 관찰 수가 많은 분자를 넣어 RAM·VRAM 최대 사용량과 전체 실행 시간을 확인한다.
실용적인 실행 설계는 먼저 모든 분자에 유효한 기본 답을 만들고, 이후 정해진 범위에서 비싼 재정렬을 수행한다. 후보 수·beam 크기·중단 조건·대체 경로는 평가할 모델 정책의 일부다. 시간 초과를 피하려고 분자마다 적용 모델을 임의로 바꾸면 정확도도 달라질 수 있다. 단순한 구현 문제가 아니다.
외부 자료와 재현성
코드 라이선스만으로 연결된 가중치의 라이선스와 학습 출처까지 확인되지는 않는다. 정확한 체크포인트를 확인해야 한다. 주최 측의 사전학습 모델 설명은 허용 자료와 제한된 데이터에서 파생된 모델을 구분한다. 이전 CFM-ID 허용 답변은 이후의 CFM-ID 4·METLIN 학습 출처 질문에 대한 답이 아니며, 후자는 이 글의 확인 시점까지 답변이 없었다.
대회 데이터에는 CC BY-NC 조건과 공유 제한이 적용된다. 이 글에 재현한 실측 스펙트럼은 별도의 공개 자료인 Eawag/MassBank CC BY 기록 세 개다. 그림 출처에 저자·원본 파일·변환 과정을 남겼으며, 대회 학습 자료에서는 출처별 집계값만 제시한다. 규칙 · 주최 측 공지
14. 첫 실험을 어떻게 시작할까
처음 참가한다면 읽고 이해하기 위한 작은 검색 예제와, 실제 비교를 위한 공개 엔진 재현을 구분하면 좋다. 앞의 예제로 입력과 점수를 익히고, 12절의 두 순위 모델을 결합한 공개 엔진을 고정된 기준점으로 삼는다. 이 프로젝트는 이미 그 기준점의 제출까지 마쳤으므로, 다음 단계는 독립적인 검증과 실패 분석이다.
1단계: 입력과 정답 기준부터 확인한다
처음에는 전체 학습 자료를 메모리에 올리지 않아도 된다. Parquet는 열 단위로 저장하는 형식이므로 스키마와 작은 배치를 먼저 읽을 수 있다. 아래 코드는 프로젝트의 data/train.parquet가 준비되어 있다고 가정한다. Kaggle 노트북에서는 연결된 입력 파일의 실제 경로로 바꾸면 된다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
from pathlib import Path
import pyarrow.parquet as pq

path = Path("data/train.parquet")
pf = pq.ParquetFile(path)
print("rows:", pf.metadata.num_rows)
print("columns:", pf.schema_arrow.names)

columns = ["normalized_smiles", "precursor_mz", "adduct",
           "ms2_mzs", "ms2_normalized_intensities"]
batch = next(pf.iter_batches(batch_size=8, columns=columns))
sample = batch.to_pydict()
for mzs, intensities in zip(sample["ms2_mzs"],
                           sample["ms2_normalized_intensities"]):
    assert len(mzs) == len(intensities)
    print("peaks:", len(mzs), "base peak:", max(intensities))
여기서 확인할 것은 열 이름, 배열 길이, 결측값과 정규화 범위다. 학습 데이터에는 구조가 있다는 것과 테스트에서는 그 구조를 예측해야 한다는 차이도 직접 보게 된다. 이어서 2절의 점수 키가 기대대로 동작하는지 확인한다.
패키지 준비와 함께 학습 자료 수정 공지도 확인한다. 일부 샘플에 물 손실을 반영한 이온 형태가 추가되었다. 작은 데이터 갱신도 중성 질량 계산과 후보 필터에 영향을 줄 수 있다는 구체적인 사례다.
2단계: 검증 분자와 후보 풀을 고정한다
평가할 분자 목록과 분할 기준을 먼저 저장한다. 유형 2에 가까운 검증 집합이라면 모든 라이브러리에서 정답 스펙트럼을 제외하고 구조 후보는 유지한다. 자연물과 timsTOF 조건에 가까운 작은 검증 집합을 먼저 만들되, 그 검증 집합 하나만 계속 최적화하지 않도록 더 넓은 구조 집합에서도 결과를 확인한다.
그다음 검색 후보의 Recall@K를 잰다. 정답이 후보에 들어오지 않는다면 순위 모델을 바꾸기 전에 질량 창, 이온 형태 처리, 데이터베이스 범위, 정규화 오류부터 살펴본다.
3단계: 검색과 순위화를 기준점으로 만든다
직접 검색, 유사 구조 전달 점수, 분자 지문 점수를 연결한 기준 방법을 실행한다. 각 점수를 하나씩 빼 보면서 무엇이 실제로 도움을 주는지도 확인한다. 같은 후보와 같은 검증 분자에서 비교해야 그 차이를 해석하기 쉽다.
이 단계의 결과물은 평균 MRR뿐 아니라 분자별 정답 순위와 상위 오답이다. 예를 들어 정답이 2위인 분자들을 모아 보면, 후보 생성보다 순위 특징을 개선해야 할 이유가 구체적으로 보일 수 있다.
4단계: 한 가지 가설을 추가한다
다음 실험으로는 같은 분자식의 어려운 후보에 정방향 예측 점수를 추가하는 방법을 생각하고 있다. 비교는 “기존 순위”와 “같은 후보에 정방향 예측 특징을 추가한 순위”다. 후보 풀과 관찰 스펙트럼을 함께 바꾸면 무엇이 효과를 냈는지 알기 어려워진다.
| 관찰한 실패 | 다음에 시험할 변화 | 함께 확인할 것 |
|---|---|---|
| 정답이 후보에 없다 | 후보 데이터베이스·질량 창·이온 형태 처리 | Recall@K와 후보 수 |
| 정답은 있지만 같은 분자식 오답이 앞선다 | 정방향 예측 점수, 어려운 오답을 이용한 순위 모델 학습 | 분자별 순위 변화와 실행 시간 |
| 관찰 수가 적을 때 급격히 나빠진다 | 여러 조건의 점수 결합과 학습 샘플링 | 1개·소수·전체 관찰에서의 성능 |
| 특정 이온화 조건에서만 나빠진다 | 조건별 전처리·모델 지원 범위 | 해당 조건에서의 후보 누락과 순위 오류 |
| 후보 풀에 정답 구조를 넣을 수 없다 | 제한된 신규 구조 생성 탐색 | 정확한 구조 키의 생성률과 기존 후보에 주는 손실 |
제안한 변화가 검증에서 도움이 되고 전체 실행 시간 안에 들어오면 그다음에 숨은 테스트 제출을 고려한다. 현재 공개 예제 파일의 실행 성공은 이 과정의 형식 확인 단계에 해당한다.
지금 우선할 접근법
현재의 출발점으로는 검색을 중심에 두고 학습된 순위 모델과 선택적인 스펙트럼 예측을 결합하는 방식을 생각하고 있다. 각 방법에 맡길 일이 분명하다. 익숙한 분자는 직접 검색으로 찾고, 구조는 알려졌지만 측정값이 없는 분자에는 유사 구조와 분자 지문을 이용한다. 그래도 닮은 후보들이 잘 구별되지 않는 구간에서 정방향 모델의 도움을 시험한다. 고정된 데이터베이스로 다룰 수 없는 분자를 위한 구조 생성은 별도의 경로로 둔다.
이는 12절의 공개 결과를 바탕으로 고른 출발점이지만, 우리 검증 분자에서도 효과가 있는지는 확인해야 한다. 우선 재현한 공개 엔진을 비교 기준으로 보존하고, 믿을 만한 유형 2 검증 집합을 만든 뒤 상위 오답을 들여다보려 한다. 같은 분자식의 순위 오류가 주된 문제라면 후보 풀을 그대로 둔 채 정방향 모델 특징을 추가한다. 반대로 후보 누락이 주된 문제라면 데이터베이스 범위와 후보 구성부터 손본다. 어디에 더 힘을 쓸지는 그 실험으로 정한다.
첫 변화는 원인을 해석할 수 있을 만큼 작아야 한다. 후보 풀 확대, 새 분자 지문 모델, 순위 모델 교체, 구조 생성을 한꺼번에 적용하면 점수가 움직여도 이유를 설명하기 어렵다. 어떤 분자를 새로 맞혔고 어떤 분자를 놓쳤는지, 그 대가로 실행 시간이 얼마나 늘었는지를 함께 볼 수 있어야 한다.
첫 주에는 어떤 답을 얻으면 좋을까
아래는 단계별 목표의 제안이다. 학습과 데이터 준비가 반드시 며칠 안에 끝난다는 일정표는 아니다.
| 단계별 목표 | 남겨 둘 구체적인 결과 | 답하려는 질문 |
|---|---|---|
| 분자 하나를 처음부터 끝까지 따라간다 | 측정 조건·스펙트럼·구조 후보·정규화 키·최종 출력 행 | 무엇을 예측하는지 이해했는가? |
| 공개 기준 방법을 그대로 실행한다 | 고정한 노트북·입력 버전과 실행 기록 | 그 절차를 재현할 수 있는가? |
| 별도로 남겨 둔 분자에서 비교한다 | 고정한 검증 분자, 분리한 스펙트럼·구조 풀, 분자별 기준 순위 | 로컬 점수가 의도한 종류의 미지 분자를 평가하는가? |
| 실패를 들여다본다 | 후보 누락, 같은 분자식 오답, 특정 조건의 성능 저하 | 어느 단계부터 바꿔야 하는가? |
| 변화 하나를 시험한다 | 분자별 순위 변화, MRR, 후보 재현율, 전체 실행 시간 | 새 증거를 유지할 만큼 도움이 되는가? |
다음 비교를 후보 단위로 재현 가능하게 만든다
첫 정방향 예측 모델 비교에서는 질의 그룹, 참조 제외 규칙, 기준 후보 풀, 기본 점수를 고정한다. (outer_fold, molecule_key, candidate_key, baseline_score, forward_score, is_correct) 같은 행과 모델·데이터 해시, 지원 측정 조건을 저장한다. 정답은 평가 표에만 두고 추론 시 경로 선택에 사용하지 않는다. 각 모델의 하위 후보를 결합 후 올릴 수 있도록 최종 25개보다 충분히 깊은 후보 목록을 남긴다.
Fold 경계를 지켜 특징을 만들고, 개발·내부 OOF 자료로 결합 모델을 학습한 뒤 선택 집합에서 구성을 고른다. 정해진 파이프라인은 남겨 둔 최종 평가 집합에서 확인한다. 분자별 ΔRR와 전체 ΔMRR, 후보 포함 여부 변화, 전체·추가 실행 시간, 최대 메모리를 보고한다. 정방향 예측 경로가 2위 정답 열 개를 1위로 올리지만 다른 1위 정답 열 개를 2위로 내린다면, 다른 분자의 변화가 없을 때 순이득은 0이다. 회수한 사례만 세면 이 손해를 놓친다.
이렇게 하면 저렴하게 조합을 탐색할 OOF 예측 묶음과 실제 배포 비용 비교가 함께 남는다. 새 경로를 유지할지, 검증한 선택 규칙으로 적용 범위를 줄일지, 제외하고 다음 학습 예산을 다른 곳에 쓸지 구체적으로 결정할 수 있다.
15. 앞으로 대회는 어떻게 전개될까
공개 작업은 이미 단순한 스펙트럼 검색을 넘어섰다. 후보 확장, 학습된 구조 특징, 여러 종류의 순위 점수를 이용할 수 있다. 앞으로는 방법을 하나 더 붙이는 것보다 그 방법이 어떤 불확실성을 줄여 주는가가 더 중요해질 것으로 본다. 아래는 가능한 전개에 대한 예상이며, 공개되지 않은 상위 팀의 구조를 설명하는 것은 아니다.
공유 기준점이 널리 쓰일수록 작은 변형의 해석이 어려워진다
많은 노트북이 같은 후보 풀, 분자 지문 가중치, 순위 특징을 물려받으면 시드나 혼합 가중치를 바꾸는 것만으로도 접전인 몇몇 후보의 순서는 달라질 수 있다. 다만 새로운 화학적 증거가 생긴 것은 아닐 수 있다. 이런 조정도 도움이 될 수 있지만, 공개 점수의 작은 상승만으로 비공개 평가에서도 개선이 유지될지 알기는 어렵다.
그다음에는 관찰 수와 데이터 출처를 달리해도 어떤 검증 분자가 꾸준히 좋아지는지를 묻는 비교가 중요해질 것이다. 참조 라이브러리나 검증 출처를 바꾸자 효과가 사라진다면 일반화가 다음 문제다. 여러 조건에서 효과가 유지된다면 최종 선택의 근거가 더 강해진다. 노트북이 계속 바뀌는 동안에도 이전 기준점을 분명히 남겨 두어야 하는 이유다.
비슷한 구조를 구별하는 능력의 가치가 커진다
정답이 이미 다룰 만한 크기의 후보 풀에 있다면, 다음 기회는 그럴듯한 오답과 정답을 나누는 데 있다. 어려운 오답 후보(hard negative)란 구별하기 까다로운 잘못된 답이다. 예를 들어 질량과 분자식은 맞지만 원자의 연결 방식이 다른 구조가 여기에 해당한다. 이런 후보를 상대로 학습하면 정답과 전혀 관계없는 분자를 구분할 때보다 실제 선택 문제에 가까워진다.
측정 조건을 반영한 스펙트럼 예측, 중성 손실의 더 나은 활용, 평가 구조가 학습에 섞이지 않은 분자 지문 모델 등이 새 증거를 줄 수 있다. 반대로 순위 모델이 이미 가진 정보를 되풀이할 수도 있다. 이 방향이 유효하다는 증거는 같은 분자식 후보의 정답 순위가 꾸준히 좋아지고, 계산 비용을 감당할 수 있으며, 확실한 참조 일치를 망가뜨리지 않는 것이다. 12절의 참가자 보고는 이를 시험할 이유가 되지만, 특정 정방향 모델을 붙이기만 하면 된다는 근거는 아니다.
생성은 다른 경로가 닿지 못하는 정답을 가져올 때 도움이 된다
유형 3의 정답이 PubChem과 COCONUT에 없다는 점에서 구조 생성이 맡을 역할은 분명하다. 두 데이터베이스로 만든 후보 풀이 제공하지 못하는 답을 제안하는 것이다. 다만 경쟁력은 대회가 인정하는 정확한 구조를 만들고, 그 후보를 높은 순위에 놓아도 되는지 판단하며, 정해진 추론 시간 안에 탐색을 마치는 데 달려 있다. 화학적으로 유효한 문자열을 만들었다는 사실만으로 이 세 가지가 해결되지는 않는다.
먼저 제한된 탐색 예산으로 시험하면서, 새로 찾은 정답과 생성 후보 때문에 뒤로 밀린 좋은 후보를 함께 비교하는 방식이 적절할 것으로 본다. 유형 3에 가까운 검증에서 정확한 구조 키를 회수하고 순위도 믿을 만하게 매긴다면 계산량을 더 배정할 이유가 있다. 그럴듯하지만 틀린 구조만 주로 만든다면, 검색과 순위화로 풀 수 있는 분자에서 성능을 높이는 쪽이 더 생산적이다. 숨은 유형 비중을 충분히 알지 못하므로 이 배분을 미리 고정하기는 어렵다.
무엇이 이 계획을 바꿀 수 있을까
출처가 명확한 새 후보 자료는 정답을 포함하는 범위를 바꿀 수 있다. 필요한 측정 조건을 지원하는 허용된 체크포인트가 공개되면 스펙트럼 예측의 비용이 달라질 수 있다. 데이터 수정과 주최 측의 해석에 따라 사용할 입력이 달라질 수도 있다. 학습 데이터 갱신과 CFM-ID 특정 가중치에 관한 질문은 해당 변화가 생겼을 때 다시 확인해야 할 사례다. 학습 데이터 갱신 · 모델 사용 조건 · CFM-ID 추가 질문
이런 일이 생기면 이전 비교 기준을 보존한 채 그 변화가 뜻하는 바를 따로 시험하면 된다. 지금은 확실한 라이브러리 일치를 알아보고, 가까운 후보를 더 잘 구분하며, 해결되지 않은 분자에 무거운 계산을 쓰는 시스템에 무게를 두고 있다. 검증에서 순위보다 후보 누락이나 구조 생성 쪽에 더 많은 개선 여지가 드러난다면 그 판단도 바꿀 것이다.
다음 병목은 계산량 대비 새로운 증거일 가능성이 크다
다음 단계에서는 체크포인트를 가장 많이 모은 시스템보다 후보 키를 맞춘 OOF 앙상블이 경쟁할 가능성이 크다. 새 인코더는 기존 표현 위에 더하는 이득을, 정방향 예측 모델는 후보·조건별 비용을 쓰고도 이성질체를 구별하는 능력을, 생성 모델은 고정 풀에서 빠진 정답 키를 추가하는 능력을 보여 줘야 한다. 예를 들어 네 시간을 더 써서 MRR 0.002를 얻는 경로와 20분으로 0.010을 얻는 경로는 배포 선택에서 다르게 취급된다. 가상의 비교이며 실제 방법의 위치는 통제된 측정으로만 알 수 있다.
실행 시간 예산별로 독립 평가에서 확인한 최고 MRR, 후보 재현율, 하위 집단의 실패를 함께 추적하려 한다. 유용한 허용 체크포인트, 저렴한 증류 모델, 검증된 선택 실행 규칙이 이 경계를 바꿀 수 있다. 리더보드만 보며 반복 조정해서는 경계가 실제로 개선됐는지 작은 공개 집합에 더 맞춰졌는지 구분하기 어렵다.
16. 일정과 첫 번째 이정표
공식 일정은 다음과 같다. 마감 시각은 모두 23:59 UTC이며, 한국 시각으로는 다음 날 오전이다. 대회 일정
| 항목 | UTC | 한국 시각 |
|---|---|---|
| 참가 마감·팀 병합 마감 | 2026년 12월 7일 23:59 | 12월 8일 08:59 |
| 최종 제출 마감 | 2026년 12월 14일 23:59 | 12월 15일 08:59 |
현재 규칙은 하루 제출 5회, 최종 선택 2개, 팀 최대 5명이다. 총상금은 5만 달러다. 실제 참가와 최종 선택 전에는 규칙 페이지와 일정 변경 공지를 다시 확인한다.
첫 단계에서 만들고 싶은 것은 어떤 분자는 검색으로 해결되고, 어떤 분자는 순위를 잘못 매기며, 어떤 분자는 후보 자체가 없는지 보여 주는 실험이다. 이 구분이 생기면 다음 모델을 고르는 이유도 분명해진다. CASMI를 통해 배우려는 것은 스펙트럼을 입력받는 신경망 하나를 만드는 법에 더해, 불완전한 측정과 제한된 화학 지식을 연결하여 검증 가능한 구조 후보를 제안하는 방법이다.
참고 자료와 이 글의 확인 범위
이 글의 구조·질량 계산, 점수 키 예제와 가상 MRR 계산은 RDKit 2026.03.3 환경에서 확인했다. 동위원소 질량 합, 이온 형태와 중성 손실의 질량 차이, DBE, 질량중심 에너지의 수치 예도 별도로 계산했다. Parquet 예제는 로컬 학습 파일의 작은 배치로 확인했다.
Caffeine 그림은 Stravs M·Schymanski E·Singer H(Eawag 환경화학 부서, Copyright 2012 Eawag)의 MassBank 기록 EA030309·EA030311·EA030312를 재현했다. 세 원본의 라이선스 표기는 모두 CC BY이며 버전은 명시되어 있지 않다. 원래 최대 피크의 신호로 강도를 나눴고, 명목 충돌 에너지의 % 값을 eV로 변환하지 않았다. 원본 파일, 출처 commit·해시, 변환 과정, 그림 코드는 그림 출처 문서에 남겼다. 반응 속도, 후보 순서, 비트 네 개의 예측, 정방향 출력, 앙상블 조합은 계산·가정 예제로 구분했다. 실행 시간 그림은 기존 프로젝트 로그에서 가져왔다. 본문 그림 12개는 영문판과 공유한다. 30% 원본 · 60% 원본 · 75% 원본
리더보드 분포는 2026년 9월 27일 02:59:30 UTC에 내려받은 전체 공개 순위 파일에서 집계했다. 여섯 노트북의 점수와 버전은 같은 날 실제 점수 표시에서 확인했다. 팀 최고점을 개별 노트북의 결과로 대신하지 않았으며, 이 비교는 구성 요소별 효과를 분리한 실험이 아니다. 프로젝트의 0.342는 이번 글 수정 전에 완료된 기준 방법의 제출 결과다.
공개 연구 모델의 설명은 원 저자의 구현과 문서를 검토한 내용이며, 이 글을 위해 모델 학습이나 Kaggle 제출을 수행한 것은 아니다. 성능 수치로 제시한 가상 예제와 자료의 집계 통계는 구분해서 표시했다.
더 읽을 자료를 목적별로 모으면 다음과 같다.
- 대회 기준: 개요·평가·일정, 입력 데이터, 공식 평가 지표, 규칙.
- 물리화학의 기초: NIST 동위원소 질량표, LC/MS와 이온화, CID 정의, 질량 분해능 정의, 분자식 제약과 그 한계.
- 분해 경로를 더 이해하기: 양성자 위치와 소분자 CID 예측, 에너지 전달·반응 속도·관측을 연결하는 MassKinetics, RRKM의 실제 적용 예.
- 데이터를 이해하기: Enveda-180 처리 코드, COCONUT, PubChem, MassSpecGym.
- 검색과 구조 특징: 유사 구조 전달, Spectral Cosine, matchms, MIST, DreaMS.
- 정밀 순위화와 생성: ICEBERG·GLACIER, FOAM.
- 검증과 운영 논의: 자연물 CV의 구조 중복, 여러 변형의 성능 정체, 제출에서 얻은 순위화 교훈, 사전학습 자료의 허용 조건.