BioHub Cell Tracking 작업 기록 6: 로컬 검증이 제출 파이프라인과 달랐던 문제
시리즈 안내와 참고 링크
관련 공개 노트북
시리즈 소개. BioHub는 3D 현미경 영상에서 세포의 lineage graph를 복원하는 대회다. 라벨이 있는 학습 자료는 두 배아에서 촬영한 영상 199편이며, hidden test의 29%는 Public, 나머지 71%는 Private 점수에 반영된다. hidden test는 학습에 쓰이지 않은 배아에서 나온다. 각 편은 해당 기간의 기록을 따라가며, 나중에 확인한 사실과 회고는 따로 표시했다.
나중에 확인한 내용 — 2026-09-23. 본문은 9월 4일까지의 기록이다. 여기서 다룬 embryo-out replay에는 실제 제출 가중치를 쓰지 않았다. 그 가중치로 평가한 결과는 7편에서 다루며, ±0.002 Public 동점 기준은 9월 5–6일에 정했다.
5편의 division verifier는 로컬 replay에서 \(+0.0053\)을 얻었다. 8월 29일 v79의 Public 점수는 직전 \(0.921\)보다 \(0.014\) 높은 \(0.935\)였다. 이 차이 때문에 로컬 검증이 무엇을 재고 있는지 다시 살폈다.
8월 29일–9월 4일에는 분열 단계를 끈 제출로 그 단계 전체의 Public 효과를 확인했다. 더 결정적인 발견은 로컬에 있었다. 제출 코드의 그래프 처리 단계를 embryo-out 가중치로 재현하자, 같은 199편에서 예전 comparator보다 \(0.149\) 높았다. 검증을 그 코드와 후보 집단에 맞추자 쓸 만한 verifier 재학습안이 나왔고, 예전 수정안의 우선순위도 달라졌다.
0. 로컬 검증과 맞지 않았던 Public 결과
제출한 Kaggle 노트북(커널)은 시드가 다른 검출기 두 개의 검출 logit 맵을 섞어 세포 노드를 만들고, transformer로 프레임 사이 링크에 점수를 매기고, ILP(integer linear program)로 그래프를 고른 뒤 후처리 단계를 거친다. 가장 최근에 붙인 후처리 단계가 division verifier다. 함께 제출한 후보 테이블로 노트북 안에서 다시 학습하는 gradient boosting 모델이고, 어떤 분기를 추가할지 정한다.
대회가 제공하는 라벨 달린 예시 영상 네 편은 학습 영상의 사본이다. 그래서 전체 학습 데이터로 학습한 배포 모델을 이 영상으로 채점하면 hold-in 확인이 된다. 망가진 것은 잡아내지만 후보를 고르는 데는 쓸 수 없다. 당시 프로젝트는 후보 선택에 embryo-out replay를 썼다. 학습 영상 199편은 배아 두 개(71편, 128편)에서 나왔고, 두 폴드가 각각 한 배아를 다른 배아로 학습한 모델로 채점한다. 두 배아 모두에서 변화량이 음수가 아니어야 한다는 규칙이었다. 여기서 embryo-out은 backbone의 학습 분할을 가리킨다.
| 2026-08-29 시작 시점의 항목 | 값 |
|---|---|
| comparator replay(5편의 OOF comparator), 영상 199편, 이전 분열 단계를 그대로 둔 상태 | 0.6014 |
| 그 comparator에서 잰 배포 division verifier의 로컬 이득 | +0.0053 |
| 첫 division verifier 제출(v79)의 Public 점수 | 0.935 |
| 직전 제출본의 Public 점수 | 0.921 |
v79는 로컬 판단을 처음 보는 배아에서 확인하는 sanity check였다. Public 상승은 로컬 이득보다 컸고, 로컬 기준 점수 \(0.60\)과 Public \(0.94\) 사이에도 큰 차이가 있었다. 먼저 학습 자료를 늘려 보고, Public에서 분열 단계를 끈 다음, 같은 영상에서 로컬과 제출 파이프라인을 비교했다.
8월 28일의 운영 규칙에는 여전히 Public이 목적함수로 적혀 있었다. 실제 후보 선택은 계속 로컬 근거로 했으며, 이 기간에는 두 규칙의 충돌을 정리하지 못했다.
1. 첫 해석: division verifier의 데이터가 부족하다
\(0.935\)에 대한 첫 해석은 division verifier가 통하니 더 밀어붙이자는 것이었다. division verifier의 이득은 정답을 이용한 진단의 \(+0.0557\)과 비교하면 약 10분의 1이었고, 양성 학습 사례는 약 \(80\)개였다. 대회 전체에서 주석이 있는 분열 이벤트는 \(151\)개였다. 그래서 첫 시도들은 데이터 부족을 겨냥했고, 검출기도 함께 시험했다. 여기 나오는 division verifier 수치는 comparator replay에서 잰 것이다. 그 부호는 이 replay 안의 측정값으로 남는다. 3절에서 기준을 바꾼 뒤에도 같은 부호가 유지된다고 가정할 수는 없다.
1.1 division verifier에 대한 네 가지 시도
| 시도 | 겨냥한 병목 | 결과 |
|---|---|---|
| 후보 생성기의 범위 넓히기 | 재현율: 151개 중 75개에만 도달 | positive 80 → 110, 후보 집합은 거의 두 배; 적용 delta +0.0053 → +0.0021 |
| 패치 세 장의 appearance를 보는 CNN, 배아가 섞이지 않게 학습 | 특징이 기하와 track 정보뿐 | training loss 1.42 → 0.075; 두 폴드 모두 held-out 실제 분열의 중앙값이 negative의 99번째 백분위수보다 낮음 |
| 공개 합성 데이터셋으로 pretrain한 순위 모델 | positive가 너무 적음 | positive 163,422개, holdout AUC 0.9988; 특징으로 넣으면 소수 넷째 자리까지 같은 점수 |
| 공개 zebrafish 데이터셋의 실제 분열 23,977개로 학습한 CNN | 도메인이 다름 | 배아가 바뀌어도 일반화됨; 추가 이득은 10⁻⁴ 미만 |
후보 집합을 넓히자 기존 설정이 통과시키는 후보도 바뀌었다. CNN의 학습 폴드에는 positive가 \(61\)개와 \(19\)개뿐이었고, 학습 손실은 줄어도 held-out 순위는 낮아 과적합을 의심했다. 합성 데이터에서 AUC가 높았던 ranker도 실제 데이터 구성에 이득을 더하지 못했다. 네 시도 모두 verifier를 적용한 점수를 개선하지 못했다.
1.2 검출기에 대한 두 가지 시도
검출기 쪽에서는 epoch만 늘리는 것과, 주최 측이 명시적으로 허용한 dense 외부 데이터셋을 시험했다. 레시피를 그대로 두고 epoch \(200\)에서 \(400\)까지 늘리자 embryo-out 검증 점수는 \(0.8151\)에서 epoch \(218\)에 \(0.8326\)까지 올랐다가 \(0.7907\)로 떨어졌다. epoch \(400\)의 평가 결과가 epoch \(200\)과 바이트 단위까지 같아서 best checkpoint 저장의 resume 버그가 드러났고, 그래서 외부 데이터 fine-tuning에서는 epoch마다 같은 checkpoint에서 resume한 대조군을 짝지었다. 미리 적어 둔 게이트 \(+0.005\)에 대해 결과는 \(+0.0466\)으로, 프로젝트에서 나온 검증 이득 가운데 가장 컸다. trainer의 검증 수치는 그래프가 아니라 검출기를 설명한다. 그래서 fine-tuning 모델을 primary 검출기로 넣고, embryo-out 예시 영상 두 편에서 배포 파이프라인을 끝까지 돌렸다.
전체 파이프라인을 돌린 예시 영상 2편의 embryo-out 평가다.
| 구성 | 점수 | 노드 재현율 | 고밀도 영상의 노드 수 |
|---|---|---|---|
| 대조군 쌍 | 0.8028 | 0.9662 | 64,477 |
| fine-tuning 모델을 primary로 | 0.7756 | 0.9625 | 66,122 |
end-to-end 지표는 \(-0.0272\) 움직였다. 예측 객체는 늘었는데 매칭된 노드의 재현율은 줄었다. 검출 범위나 peak 위치가 달라졌을 수 있지만, 이 집계만으로 위치 정확도를 원인으로 분리할 수는 없다. 두 번째 검출 logit 맵 빼기, 임계값 옮기기, 두 검출기의 역할 바꾸기는 모두 손해였다. single-detector base를 가정했을 때 약 \(+0.03\)으로 보이던 조건도 그 base를 실제로 돌려 보니 \(-0.0082\)였다. 영상 두 편의 결과로 이 fine-tuning 모델을 배포용 검출기로 쓰는 안은 중단했다. 배포 파이프라인 밖에서 계산한 검증 지표는 파이프라인의 점수가 아니다.
2. 분열 단계 전체의 Public 효과를 재다
2.1 예시 영상 네 편으로 확인할 수 없었던 것
앞의 시도들은 hidden test에서 분열 단계가 얼마인지 답하지 못했다. 예시 영상 네 편에서 배포된 분열 단계는 그래프를 \(45\)번 수정했지만 간선 점수 변화는 정확히 0이었다. 수정 \(45\)개가 모두 정답 주석이 듬성듬성 달린 영역 밖에 있었다. 이 영상들에서는 수정의 이득을 잴 수 없었으므로, Public에서 다른 집단에 대한 단계 전체의 효과를 시험했다.
2.2 분해 제출
분해 제출(decomposition probe)은 정확히 한 단계만 다른 제출 두 개다. 두 점수의 차이로 로컬 대용 지표를 거치지 않고 hidden test에서 그 단계 전체의 효과를 잰다. 2026-09-01에 제출 두 번을 여기에 썼다. v80은 배포 노트북에서 분열 단계의 임계값과 적용량 설정만 sweep으로 고른 값으로 바꿨다. v81은 첫 division verifier 제출의 노트북(모델과 테이블 포함)에서 division verifier의 apply 단계(고른 분기를 그래프에 써 넣는 함수)만 입력을 그대로 돌려주는 함수로 바꿨다. 모델 학습과 입력 테이블은 그대로 두고, 선택한 분기를 그래프에 적용하는 함수만 아무 수정도 하지 않도록 바꿨다. 그 함수에 들어가기 전까지의 입력은 같지만, 이후 단계가 받는 그래프는 달라질 수 있다. 분기를 적용하지 않으면 v79와 v80의 division verifier 설정도 출력에 영향을 주지 않으므로, v81을 둘 모두의 단계 제거 대조군으로 쓸 수 있었다.
| 구성 (Public split) | 내용 | Public |
|---|---|---|
| v79 | 첫 division verifier 제출 | 0.935 |
| v80 | sweep으로 고른 임계값과 적용량 설정, division verifier 작동 | 0.937 |
| v81 | v79 노트북에서 apply만 무력화 | 0.903 |
두 점수의 차이는 단계 전체를 켜고 끈 효과다.
\[\Delta S = \Delta J_{\mathrm{edge}}^{\mathrm{adjusted}} +0.1\,\Delta J_{\mathrm{division}}.\]v79 − v81은 \(+0.032\), v80 − v81은 \(+0.034\)였다. v81에 분기가 없어 분열 항은 0이지만, 분기를 추가하거나 부모를 바꾸는 과정은 간선 점수도 바꾼다. 따라서 이 차이가 그대로 분열 항 전체는 아니다. 직전 제출 대비 v79의 \(+0.014\)도 별도의 비교다.
hidden test 데이터에서 보정 간선 점수 변화가 무시할 만큼 작다고 가정하면, \(0.1\)로 나눈 분열 Jaccard는 \(0.32\)~\(0.34\) 부근이 된다. \(+0.032\) 차이에 반올림 오차만 반영하면 같은 가정 아래 약 \(0.31\)~\(0.33\)이다. 예시 영상으로는 hidden test 데이터의 간선 변화를 알 수 없으므로, 이는 직접 측정값이 아닌 조건부 추정이다. 로컬 분열 Jaccard는 \(0.062\)였다.
v80의 로컬 이득 \(+0.0007\)은 단독 변경에 요구한 \(+0.001\)에 못 미쳤고, \(0.937\)과 \(0.935\)는 이 시리즈에 나중의 해석 기준을 적용하면 동점이다. C13은 단계 제거 실험으로 Public의 전체 효과를 재고, metric 항을 분리하려면 필요한 가정을 함께 밝히는 것으로 읽어야 한다.
3. 단서: 로컬 검증은 다른 파이프라인을 replay하고 있었다
3.1 Public과 로컬 차이에 대한 두 가지 해석
단계 전체의 효과를 비교해도 Public 쪽이 컸다. v79 − v81은 \(+0.032\)였고, comparator replay에서는 반올림한 점수로 계산해 약 \(0.6067-0.6005=+0.0062\)였다. 이 차이를 hidden test 집단의 특성으로 설명하기 전에, 로컬이 실제 제출 파이프라인을 재고 있는지 직접 확인할 수 있었다.
여기서 다루는 division verifier와 순위 모델은 어떤 파이프라인을 학습 영상에 돌려 만든 후보 테이블로 학습한 선택 모델이다. 한 파이프라인이 만드는 후보 그래프 전체를 그 파이프라인의 환경(universe)이라고 부르겠다. 문제가 되는 경우는 선택 모델 \(\phi^{*}\)를 로컬 검증이 replay하는 파이프라인의 후보 \(\mathcal{C}(\mathcal{U}_{\mathrm{fit}})\)로 튜닝하고, 노트북이 실제로 돌리는 파이프라인의 후보 \(\mathcal{C}(\mathcal{U}_{\mathrm{run}})\)에 적용하는데, \(\mathcal{U}_{\mathrm{fit}} \ne \mathcal{U}_{\mathrm{run}}\)인 경우다. 후보 집단의 불일치는 누수와 다른 문제이며, 학습 자료를 올바로 분리해도 생길 수 있다. 어느 한쪽 파이프라인만 평가해서는 다른 쪽과 후보 분포가 같은지 알 수 없다.
3.2 제출 파이프라인 replay
제출 파이프라인 replay(deployed-stack replay)는 노트북의 파이프라인을 학습 영상 199편 전체에 그대로 돌린다. backbone의 gradient 학습에서 평가 배아를 뺀 가중치로 각 영상을 처리하고, 결과는 공식 채점기로 채점한다. probe 결과가 나오자 2026-09-02에 이것부터 돌렸다.
두 replay는 같은 영상 199편과 공식 채점기를 사용하고, 기반 가중치는 embryo-out으로 학습했다.
| replay한 파이프라인 | 점수 | 최종 노드 재현율 |
|---|---|---|
| comparator replay, 분기 제거: 로컬 검증이 replay하던 파이프라인으로, 최근의 로컬 선택은 모두 여기서 이루어짐 | 0.6005 | 0.8870 |
| 제출 그래프 처리 단계의 로컬 replay: 실제 제출 가중치 대신 embryo-out 가중치 사용 | 0.7499 | 0.9255 |
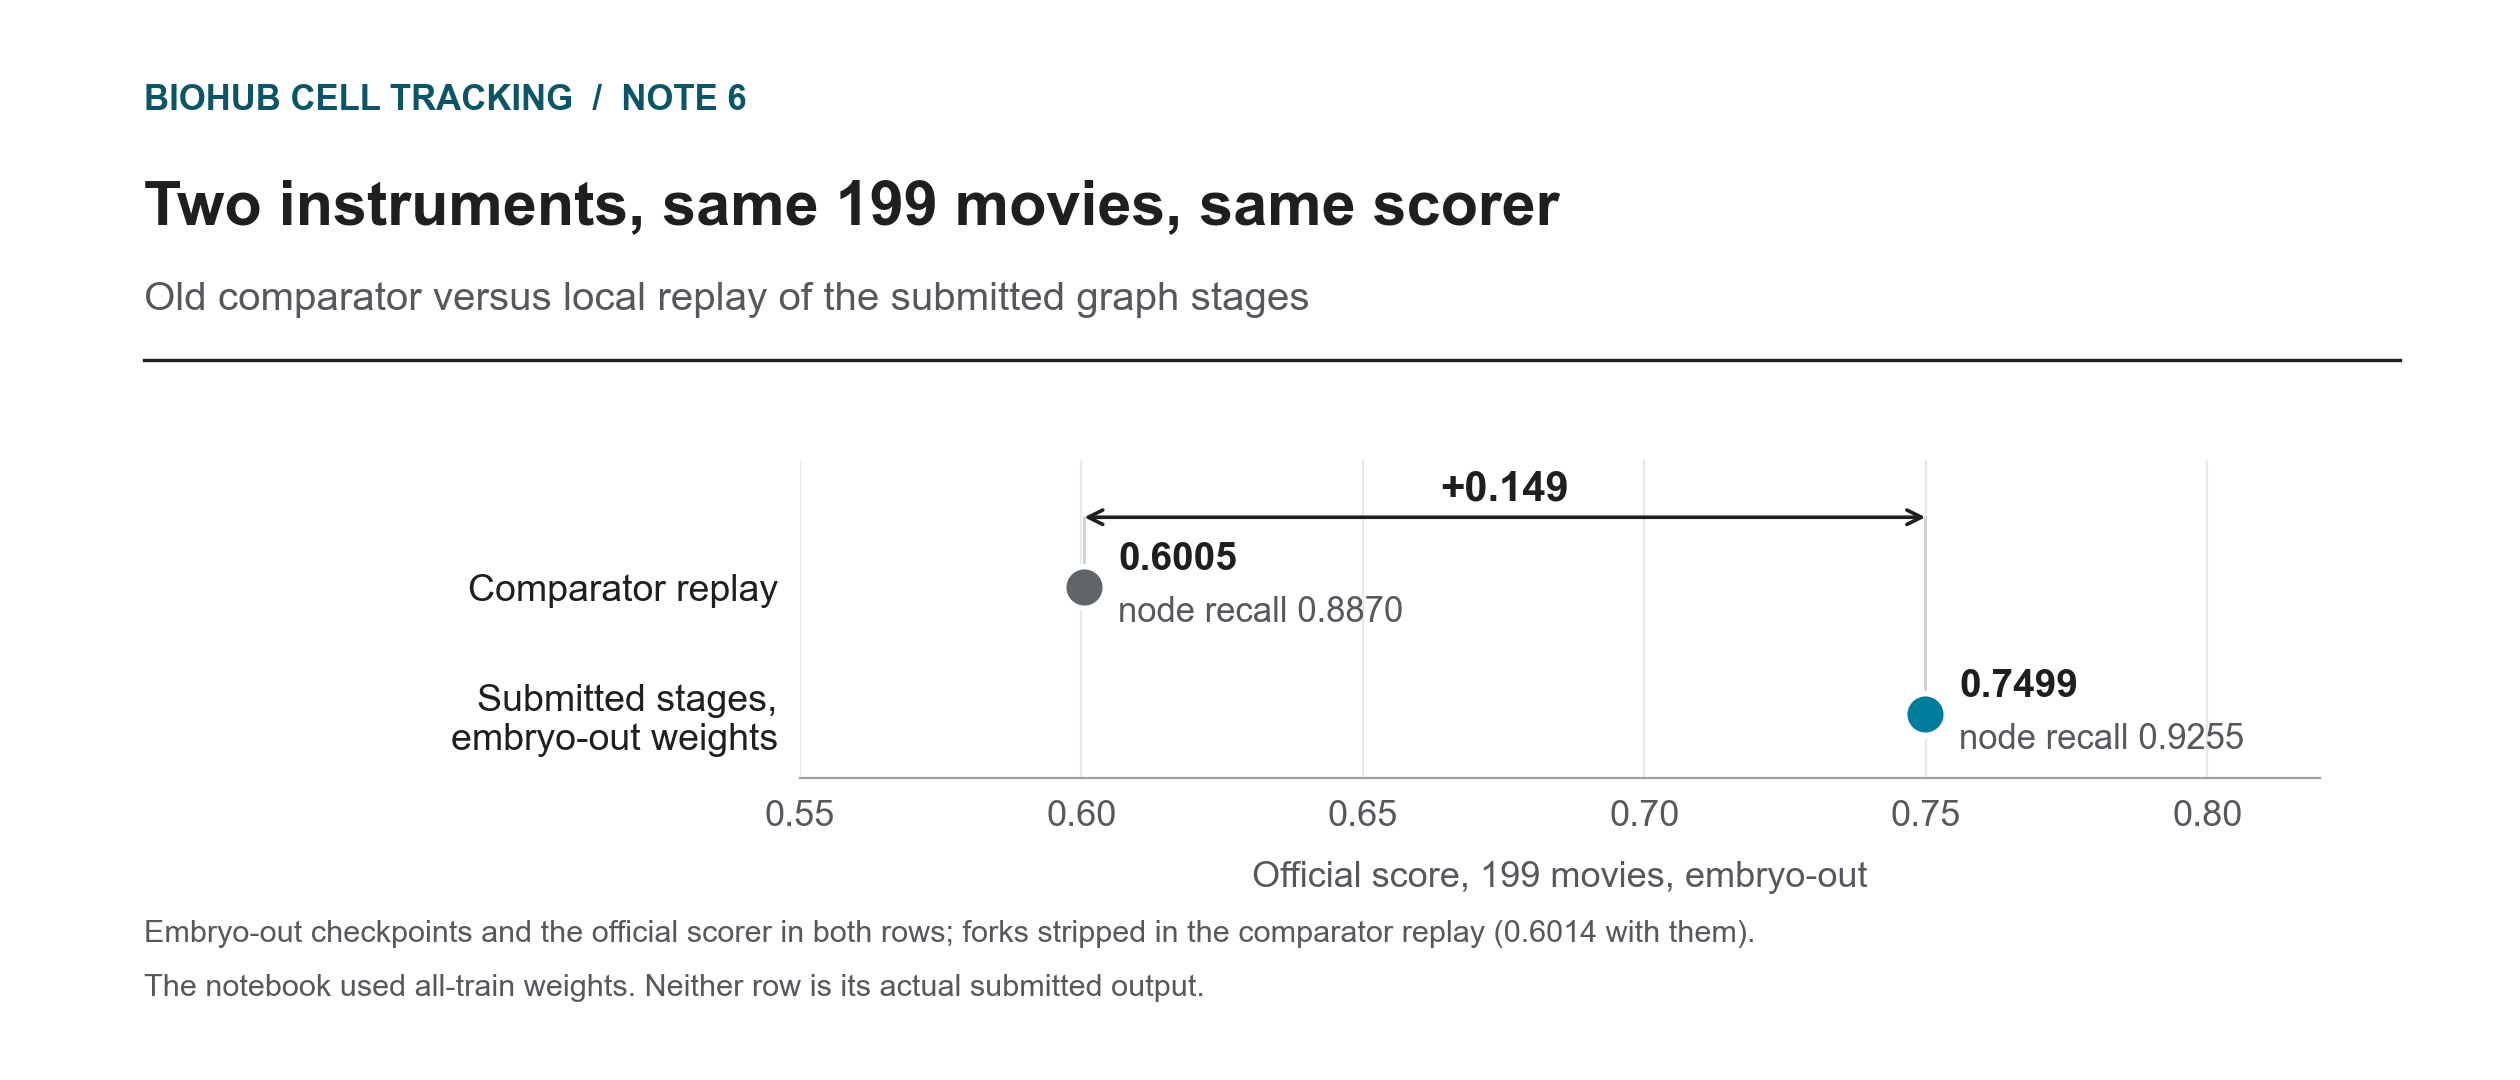 그림 1. 같은 199편을 embryo-out 가중치로 평가한 로컬 replay 두 개. 제출 그래프 처리 단계를 재현하자 \(0.6005\)에서 \(0.7499\)로 올랐다. 실제 노트북은 all-train 가중치를 썼으므로 노트북 출력 자체의 점수는 아니다.
지난 몇 주 동안의 division verifier 임계값, 삭제 규칙, association 설정은 모두 재현율이 더 낮은 comparator replay의 그래프에서 골랐다. 평가 집단을 바꾸기 전에도 두 로컬 replay는 \(0.149\) 차이가 났다. 낮은 로컬 점수를 처음 보는 배아의 어려움만으로 설명할 수 없었던 이유다.
이 replay를 이후 비교의 공통 기준으로 삼았다. 3편부터 서로 다른 기준 그래프 일곱 개를 쓰고 있었다. 0절의 \(0.6014\)는 이전 분기를 남겨 둔 comparator이고, 4편의 research replay(base 약 \(0.74\))는 또 다른 그래프 계열이다.
여기서 노트북이 원래 만든 분기를 모두 접은 base는 \(0.7489\)이고, 아래의 분열 수치는 모두 이 base 위에서 잰 것이다. 이 replay가 만든 후보에 label oracle을 적용하면 점수는 \(0.8007\), 분열 Jaccard는 \(0.5097\)이다(TP \(79\)개, FP \(4\)개, 놓친 분열 \(72\)개). 놓친 \(72\)개에는 후보 행이 아예 없다. ranking을 따지기 전에 주석된 분열의 절반 정도가 후보 생성기 밖에 있다. 원인은 이번 주에 재지 않았다.
3.3 replay로도 설명되지 않은 것
이 replay의 그래프에서 배포된 division verifier는 TP \(2\)개, FP \(3\)개를 냈다. 로컬 분열 Jaccard로 \(0.013\) 부근이고, comparator replay의 \(0.062\)보다 낮다. replay를 바로잡아도 로컬 분열 결과와 조건부 추정치 약 \(0.32\)의 차이는 설명되지 않았다. 모집단의 차이와 측정하지 못한 hidden 간선 효과가 여전히 남았다. 대신 고칠 수 있는 문제가 하나 드러났다. division verifier는 예전 파이프라인의 후보로 학습됐는데, 제출 파이프라인의 후보에 적용되고 있었다. 여기서 C12가 나온다. 로컬 검증은 실제로 제출하는 파이프라인에서 한다.
4. 제출 파이프라인 위에서 다시 학습한 division verifier와 v83
학습 대상이 어긋났다면, 제출 파이프라인 자체의 후보로 학습한 division verifier가 예전 후보로 학습한 division verifier보다 그 파이프라인의 그래프에서 더 잘해야 한다. 시험에서는 그 그래프를 고정하고 division verifier를 학습하는 후보만 바꿨다.
제출 파이프라인 replay의 영상 199편에서 비교했다. 순위 모델 학습은 배아별로 분리했고, 분기 없는 기준 점수는 0.7489다.
| division verifier 학습 자료 | 기준 대비 변화 | 분열 TP / FP |
|---|---|---|
| 배포된 division verifier, comparator replay 후보로 학습 | +0.0013 | 2 / 3 |
| 제출 파이프라인 후보로만 재학습 | +0.0030 | 5 / 13 |
| 두 테이블의 합집합으로 재학습 | +0.0065 | 17 / 90 |
예측대로였다. 배포된 선택 모델의 이득 \(+0.0013\)은 시험한 합집합 재학습의 \(+0.0065\)보다 작았고, 큰 배아에서는 영상 \(128\)편 전체에서 분기를 하나도 만들지 않았다. 순위 모델 학습은 배아별로 나눴지만, 학습 후보와 적용 후보를 만든 파이프라인이 달랐다.
합집합 재학습을 골랐다. sweep에서 비슷한 점수가 넓은 구간에 걸쳐 나왔고, 최고점에서도 두 배아가 모두 양수였다(\(+0.0096\), \(+0.0060\)). 런타임으로 옮기면서 배아별 임계값을, 미리 정한 규칙으로 고른 flat 임계값 하나로 바꿨다. 커널은 예시 영상 네 편의 hold-in 게이트를 통과했고, 간선 수치는 거의 같았지만 TP가 하나 늘고 FN이 하나 줄었다(간선 TP/FP/놓친 수 \(2028/155/99\), 이전 \(2027/155/100\)).
v83은 재학습의 sanity check였고, 결과를 어떻게 읽을지 제출 전에 적어 두었다.
1
2
3
>= 0.940       refit 효과가 유지된다. 새 base로 삼는다
0.937 - 0.939  중립. refit 효과를 구분할 수 없다
< 0.937        flat threshold가 손해였다. 배아별 threshold로 되돌린다
결과는 \(0.944\)로, 구간의 기준인 v80의 \(0.937\)보다 \(+0.007\) 높았고 재학습을 base로 삼는 구간 안이었다. 문제가 발견되지 않았으므로 재학습이 base가 됐다.
이 변화량들의 대조군은 다르다. 로컬 \(+0.0065\)(5절에서 바로잡은 값은 \(+0.0046\))는 분기 없는 그래프를 기준으로 하지만, Public \(+0.007\)은 이미 division verifier가 있던 v80과의 차이다. 그런데도 이후의 분열 개선이 비슷하게 전이될 것이라 기대했다. 당시 몇 차례 제출에서 넓혀 잡은 추측이었다.
5. 제출 코드를 그대로 검증 도구로 쓰다
2026-09-03에는 같은 질문을 한 단계 아래에서 던졌다. 커널 안의 제출 런타임 모듈과 로컬에서 돌린 같은 분열 단계 레시피를 비교하는 parity check였다. 예시 영상 네 편에서 커널은 분열을 각각 \(50\), \(23\), \(3\), \(50\)개 적용했고, 로컬 레시피는 하나도 적용하지 않았다.
원인은 flag 하나였다. 라벨은 정답 주석 영역에서만 나오므로, 로컬에서 분열 테이블을 다시 만들 때마다 주석이 있는 source 주변에서만 후보를 생성했다. 예시 영상 한 편에서 이렇게 만들면 행이 \(7{,}519\)개다. 정답 주석 위치를 모르는 제출 런타임은 \(358{,}000\)개를 만든다. 로컬 탐색에는 런타임 후보의 상당 부분이 빠져 있었다. 따라서 그곳에서 고른 임계값과 예산을 실제 런타임 그래프에서 다시 평가하고, 추가 후보가 만드는 채점 대상 FP까지 집계해야 했다.
해결은 C12를 따랐다. 제출 런타임 모듈 자체를 선택 도구로 쓰고, 다시 만든 테이블은 학습 데이터로만 쓴다. 이렇게 다시 돌리자 시험한 설정 중에서는 배포된 임계값과 적용량 설정이 가장 나았다. 분기가 없는 base \(0.7489\) 대비 \(0.7535\)로 \(+0.0046\)이었고, 두 배아 모두 양수였다. 임계값이나 cap을 어떻게 바꿔도 새 임계값과 적용량 설정에 대해 미리 적어 둔 규칙을 넘지 못했다.
추가한 분기 수와 채점되는 분열 오류 수는 같지 않다. 희소 주석 아래에서 평가할 정답 맥락이 없는 정상 구조의 분기는 무시될 수 있다. 그러나 부모가 매칭되지 않았다는 이유만으로 FP에서 빠지는 것은 아니다. 수정된 채점기는 자식·후손을 통해 판별한 cross-component 분기나 malformed 분기 같은 잘못된 구조도 FP로 센다. 전체 학습 데이터로 학습한 in-sample 실행은 분열을 \(4{,}662\)개 적용했지만 FP는 \(71\)개, TP는 \(42\)개였다. embryo-out 조건에서는 영상당 cap을 네 배 범위로 바꿔도 점수가 \(0.7536\), \(0.7535\), \(0.7535\)였다. 이 실행들에서 추가로 고른 분열 대부분은 채점 집계를 바꾸지 않았다. 로컬에서는 도달 가능한 분열 \(79\)개 중 \(8\)개만 복원했다. 다음 실험에서 후보 순위를 개선할 이유였다. 해당 후보들의 hidden test TP·FP는 알 수 없었다.
6. 예전 개선책 세 가지를 제출 파이프라인에서 다시 재다
6.1 joint lineage action과 폴드 구성
부모와 자식에 대한 결정을 한꺼번에 점수 매기는 조합(joint lineage action)은 배포하지 않은 이득 가운데 가장 자주 언급되던 것이다. 제출 파이프라인 replay에서 \(+0.0187\)이었고, 두 배아 모두 양수였다. 그런데 폴드를 점검해 보니 association head가 폴드 네 개로 학습돼 있었고, 폴드마다 두 배아의 영상이 섞여 있었다. 4편에서 뜯어본 바로 그 결함이다.
두 association head 구성을 같은 영상 199편의 제출 파이프라인 replay에서 비교했다.
| association head 학습 분할 | 합산 | 71편 배아 | 128편 배아 |
|---|---|---|---|
| 두 배아가 섞인 폴드 | +0.0187 | +0.0152 | +0.0191 |
| 배아가 겹치지 않는 폴드 | +0.0004 | +0.0150 | -0.0021 |
128편 배아로 학습한 association head는 다른 배아에서도 통하고, 71편 배아로 학습한 association head는 통하지 않는다. 세 번째 배아가 없으니 영상 수가 적어서인지 일반화를 못 해서인지 구분할 수 없다. 두 배아 모두에서 음수가 아니어야 한다는 규칙에 따라, 시험한 두 association head 구성은 여기서 중단했다.
6.2 line-fit smoothing, sub-voxel 좌표와 대회 규정
9월 1일에는 이전 로컬 replay에 interior line-fit smoothing을 더해 \(0.6005\)에서 \(0.6192\)로, \(+0.0187\)을 얻었다. 6.1절의 joint lineage-action 이득과 우연히 같은 값이지만, 다른 comparator에서 수행한 별도 실험이다. 배포 노트북에는 이미 line-fit smoothing이 들어 있어서 v82는 같은 처리를 두 번 적용했고, hold-in 게이트를 통과하지 못했다. 9월 3일 점검으로 이전 로컬 이득을 그 노트북에 더할 수 없었던 이유가 드러났다.
제출 파이프라인의 replay에서 line-fit을 다시 재다가 다른 비용을 찾았다. 커널은 짧은 track 구간을 따라 위치를 smoothing한 뒤 정수 voxel 좌표로 저장한다. 이때 위치 \(475\)만 개를 정수로 바꾸면 \(0.0050\)을 잃었고, 두 배아 모두 음수였다(\(-0.0005\), \(-0.0057\)). 소수 셋째 자리까지 좌표를 쓰는 커널도 실행은 끝났지만 제출하지 않았다. 대회 Evaluation 페이지는 centroid 좌표를 정수 voxel로 명시한다.
hold-in 확인은 반대 방향이었다(\(2028/155/99\) 대비 \(2024/157/103\)). peak 위치 오차의 차이가 한 가지 설명일 수 있지만, 두 평가는 가중치와 대상 영상도 달랐다. 이 집계만으로 부호가 뒤집힌 원인을 특정할 수는 없었다.
6.3 파이프라인이 바뀌자 부호가 바뀐 삭제 규칙
마지막으로 남은 가벼운 후처리 규칙은 연결된 간선의 확률이 모두 낮은 노드를 지운다. comparator replay에서는 \(+0.0009\)였지만 제출 파이프라인 replay에서는 같은 설정으로 \(-0.0106\)이었고, 가장 좋은 변형은 말 그대로 아무것도 하지 않는 설정이었다. 제출 파이프라인에서는 두 검출기의 점수를 다른 방식으로 합쳐 간선 확률을 만들고, 여러 단계에서 확률이 정확히 0인 간선을 추가한다. 그래서 “연결된 간선의 확률이 모두 낮다”는 조건에 어려운 영역의 실제 세포도 걸릴 수 있다.
7. 새 검증에서 다시 본 검출기 tail
7.1 낮은 재현율의 영상을 살핀 이유
제출 파이프라인 replay에서 영상별 adjusted 간선 Jaccard와 노드 재현율의 상관은 두 배아에서 \(0.82\), \(0.79\)다. 각 배아에서 가장 나쁜 decile의 영상만 그 배아의 중앙값까지 끌어올려도 \(+0.0277\), \(+0.0233\)이 오른다. 점수가 낮은 일부 영상의 영향이 크다는 진단이었다. 중앙값으로 가정해 바꿔 본 계산이므로, 개선 가능한 오류가 그 10%에 전부 모였다는 뜻은 아니다. 가장 나쁜 영상 12편과 중앙값 근처 12편에서 놓친 세포의 비율은 각각 \(36.5\%\)와 \(4.6\%\)였다.
| 가장 나쁜 영상 12편, 3분위 | 낮음 / 중간 / 높음 |
|---|---|
| 정답 위치의 intensity 기준 놓친 비율 | 0.579 / 0.324 / 0.192 |
| 주변 예측 노드 밀도 기준 놓친 비율 | 0.653 / 0.272 / 0.109 |
놓친 세포는 장면이 성긴 곳에 몰려 있고, 밝기에 따라 정도가 갈린다. 가장 나쁜 12편에서는 놓친 세포의 \(48\%\)가 검출기의 검출 logit 맵에서 아예 보이지 않는다(정답 위치의 주변 최댓값 로짓이 0 미만). 현재 검출 출력의 한계다. 중앙값 12편에서는 \(62\%\)가 임계값을 넘었지만 이웃 peak에 흡수됐다. 추론 단계의 성질이다. 다른 배아의 tail 영상은 검출기 자체의 재현율이 \(0.987\)이고, 세포를 그 뒤의 association과 최적화기 단계에서 잃는다.
7.2 밝기 증강 뒤 하위 영상의 재현율은 올랐다
trainer에는 intensity augmentation이 없었고, 밝기에 따라 누락률이 달라져 밝기 증강을 시험할 이유가 있었다. 이 관찰만으로 domain shift가 원인이라고 확인한 것은 아니다. gamma, global gain, 완만하게 밝기를 낮추는 regional dimming field, 밝기 바닥값을 더하는 additive haze floor, voxel별 noise를 넣었다. 진행 조건은 후보가 나오기 전에 적어 두었다.
epoch 10에서 큰 배아의 하위 영상 7편은 raw node recall이 \(0.7123\)에서 \(0.8884\)로 올랐다. 놓친 세포 중 detector 출력에서도 보이지 않는 비율은 \(0.706\)에서 \(0.198\)로 줄었다. 다만 추정 세포당 peak 수도 \(1.701\)에서 \(2.10\)으로 늘었다.
7.3 파이프라인 안에서 재기
이어서 이 검출기를 배포 파이프라인에 넣고 공식 평가지표와 embryo-out으로 쟀다. 대상은 큰 배아의 영상 \(15\)편, 가장 나쁜 7편과 중앙값 근처 8편이다.
| 구성 | 하위 7편 변화 | 중앙값 8편 변화 | 중앙값 중 악화 |
|---|---|---|---|
| primary 검출기, 배포 임계값 | +0.1007 | -0.0198 | 5/8 |
| primary 검출기, 엄격한 임계값 | +0.0583 | -0.0169 | 5/8 |
| detection 전용 세 번째 검출 logit 맵, 낮은 가중치 | +0.0124 | -0.0073 | 5/8 |
| 새 peak union, 엄격한 임계값 | +0.0417 | -0.0306 | 8/8 |
| 빈 곳 채우기 union, 성긴 영역만 | +0.0448 | -0.0175 | 6/8 |
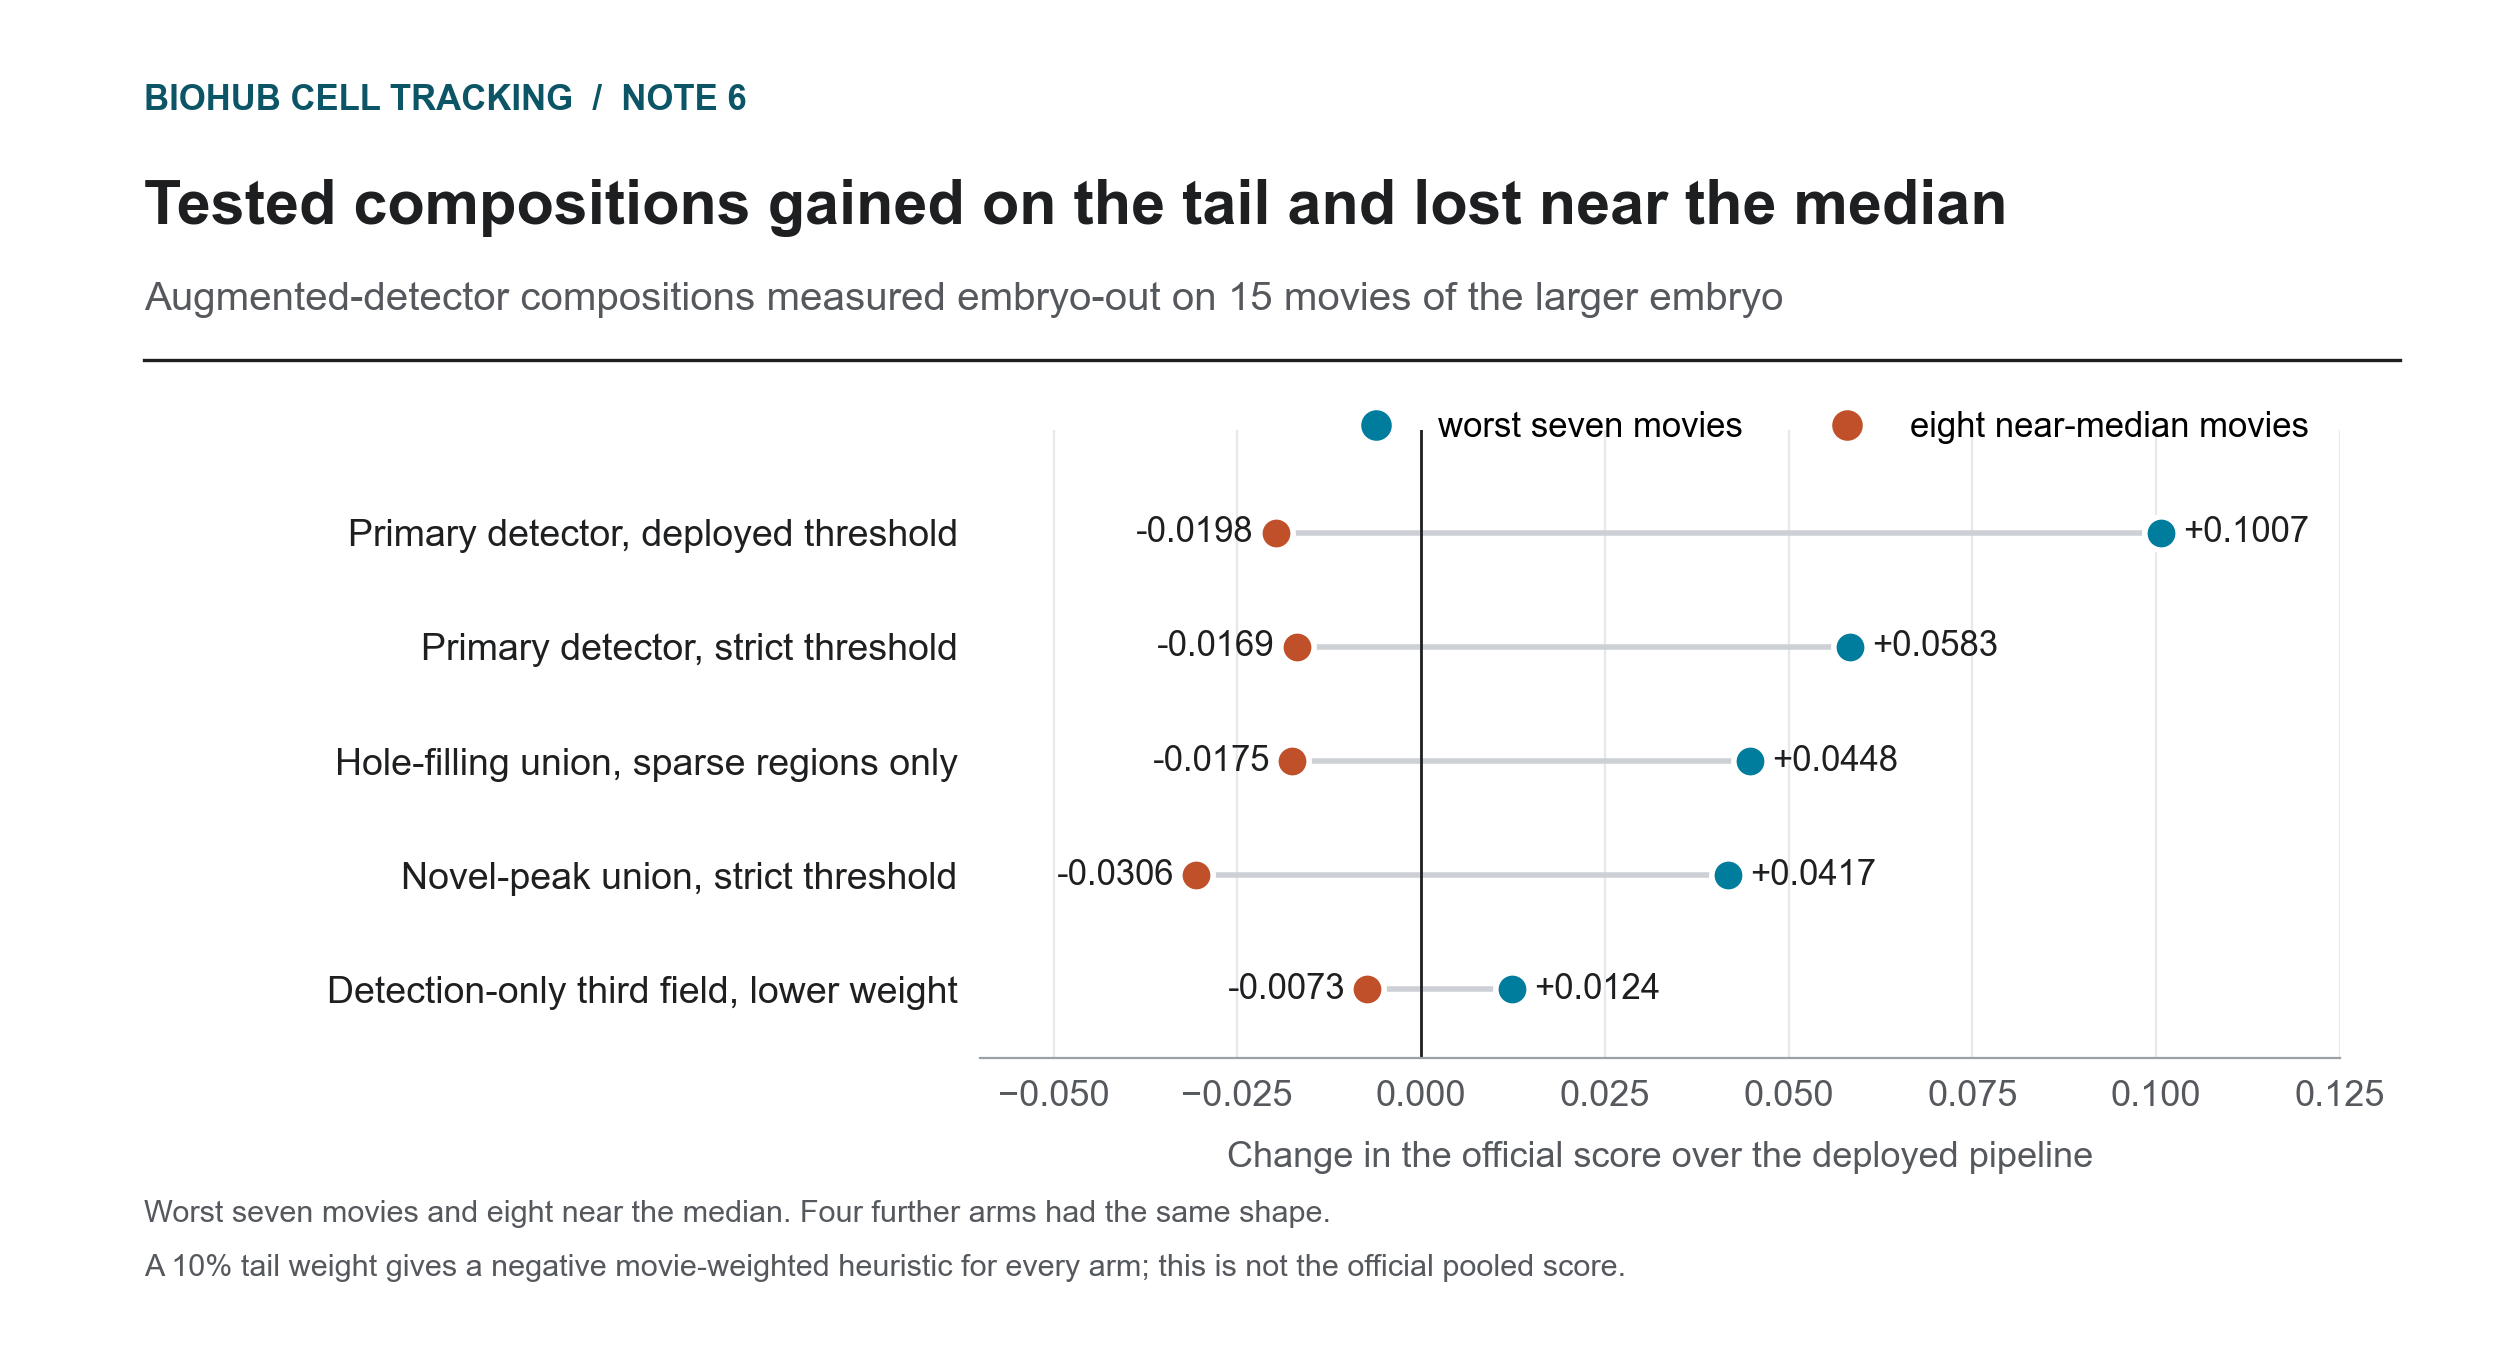 그림 2. 모든 조합이 가장 나쁜 영상 7편에서는 이득을, 중앙값 근처 8편에서는 손실을 냈다. 영상 수 기준으로 tail 비중을 \(0.10\) 정도로 둔 단순 가중값은 모두 음수였다. 간선과 분열을 각각 다르게 집계하는 공식 점수의 추정치는 아니며, 탐색용 보조 계산이다.
같은 모양을 보인 조건이 네 개 더 있었다. 모든 조건에서 augmentation을 적용한 첫 번째 split 모델과 배포된 두 번째 split 모델을 짝지었다(augmentation을 적용한 쌍은 학습하지 않았다). 가장 나쁜 영상에서 공식 adjusted 간선 Jaccard는 \(0.248\)에서 \(0.487\)로 올랐지만, 시험한 구성은 모두 중앙값 근처 영상에서 손실을 냈다. tail 비중을 \(\pi \approx 0.10\)으로 놓고 영상 수로 가중한 값은 약 \(-0.005\)에서 \(-0.025\) 사이였다.
이는 탐색용 보조 계산이었다. 공식 점수는 간선 분모와 분열 집계를 별도로 합치므로, 부분집합의 점수 변화량을 영상 수 비율로 평균낸 값과 일반적으로 다르다. 선택한 영상들이 각 집단을 대표하고 hidden test에도 같은 tail 비중이 있다는 가정도 확인되지 않았다.
객체 추가와 노드 수 보정. 평가지표는 영상마다 간선 Jaccard에 \(1-0.1\,r_i\)를 곱한다. \(r_i\)는 함께 주어지는 대략적인 세포 수 추정치 대비 예측 노드의 상대 초과량이다. 추정치 바로 아래의 영상은 작은 보너스를, 바로 위의 영상은 페널티를 받는다. 추정 세포 수가 \(5{,}257\)개인 중앙값 영상 하나에서 빈 곳 채우기 조건은 노드 수를 \(5{,}047\)에서 \(5{,}439\)로 늘렸고, 점수는 \(0.7735\)에서 \(0.7050\)으로 떨어졌다. 노드 재현율은 \(0.9915\)에서 \(0.9957\)로 올랐을 뿐이다. 노드 \(392\)개를 더해 정답 주석 달린 세포 스무 개 정도를 더 얻었다. 간선 Jaccard를 고정하고 시작 점수 전체를 간선 항으로 보아도, 노드 수 보정만의 손실은 약 \(0.0058\)이다. 시작 점수에 양의 분열 항이 들어 있다면 이 추정치는 더 작아진다. 따라서 관측한 \(0.0685\) 손실을 노드 수 보정만으로 설명할 수는 없다. 추정 세포 수를 넘는 순간 점수가 불연속적으로 떨어지는 식도 아니다.
노드 수만으로는 설명되지 않는 손실. 가장 약하게 섞은 조건에서도 한 영상은 노드가 \(+0.2\%\) 늘었을 뿐인데 점수가 \(0.767\)에서 \(0.722\)로 떨어졌다. 총노드 수가 비슷해도 어떤 peak가 선택됐는지, 위치와 연결이 어떻게 바뀌었는지는 다를 수 있다. 이 관찰만으로 sub-voxel 위치 변화를 손실의 원인으로 확정할 수는 없다. extraction 임계값을 올리자 tail 이득은 절반으로 줄었고 중앙값 영상의 손실은 거의 그대로였다. 그 임계값 조정으로는 조합의 손실을 해결하지 못했다. 2026-09-04의 대조 실험에서 평범한 세 번째 시드를 detection 전용 역할로 넣자 같은 중앙값 8편에서 \(-0.0063\)이었고(\(8\)편 중 \(6\)편 음수), augmentation 모델의 \(-0.0073\)과 비슷했다. 비슷한 손실은 세 번째 검출 logit 맵을 섞는 과정의 영향을 의심하게 했다. 다만 augmentation과 혼합의 원인을 각각 얼마라고 분해한 결과는 아니다.
7.4 실험을 중단한 이유
특정 집단에서만 도움이 되는 수정은 test 시점에 그 집단을 가려낼 routing 신호가 있어야 쓸 수 있다. 시험한 frame contrast와 novel-peak fraction으로는 재현율이 낮은 영상과 중앙값 근처 영상을 구분하지 못했다. 모든 조합이 중앙값 패널에서 손실을 냈으므로 이 실험을 중단했다. 더 넓은 router 탐색과 대표성 있는 전체 표본의 공식 합산 점수는 확인하지 못했다.
마무리
로컬 검증에는 두 불일치가 있었다. comparator는 제출 노트북과 다른 그래프를 만들었고, verifier 탐색은 주석 주변에서만 후보를 생성했다. 제출 단계와 전체 런타임 후보를 replay하자 시도할 변경의 우선순위가 달라졌고, 새 후보로 재학습한 verifier가 v83이 됐다.
hidden test의 분열 집계는 여전히 알 수 없었다. 로컬에서는 올바른 후보가 있어도 verifier가 놓치는 분열이 많아 직접 라벨을 붙이기 시작했다. 첫 \(69\)건 뒤 runtime replay는 \(0.7535\)에서 \(0.7547\)로 올랐다. 다음 질문은 제출 파이프라인의 코드만 재현하면 hidden test에서의 효과도 판단할 수 있느냐는 것이었다.
판단 기록·기준의 변화·남은 질문
아래 표는 당시의 결정과 그 근거를 정리한 것이다. 각 조항은 근거가 뒷받침하는 범위로 읽으며, 앞선 모든 실험이 해당 조건을 충족했다는 뜻은 아니다.
8. 판단 기록
적용하던 규칙은 학습 영상 199편에 대한 2-fold embryo-disjoint OOF replay로, 두 배아 모두 음수가 아니어야 했다. 이번 주에 그 대상이 comparator replay에서 제출 파이프라인 replay와 제출 런타임 모듈로 옮겨 갔다. 제출은 세 번 했다. v80은 로컬에서 고른 설정을 시험하며 예상 점수 \(0.937\)을 적었고, v81은 분기 적용을 꺼서 단계 전체의 효과를 쟀다(2절). v83은 로컬에서 고른 재학습안을 확인하는 제출이었다.
| 결정 | 당시의 이유 | 결과 | 바뀐 것 |
|---|---|---|---|
| 병목을 하나씩 정해 겨냥한 시도 여섯 가지 (1절) | 양성 약 80개로 얻은 이득이 정답 기반 진단의 약 10분의 1 | division verifier 이득 없음; 검출기는 trainer 기준 +0.0466, 파이프라인 기준 -0.0272 | 이 여섯 구성에서 후속 후보를 얻지 못함 |
| v80 설정 확인과 v81 단계 제거 (09-01) | 로컬 sweep 선택을 시험하고, 단계 제거로 hidden 분열 항을 추정하려 함 | Public 전체 효과 +0.032; hidden 간선 변화가 작을 때만 분열 Jaccard 약 0.32; v80은 동점 | C13; 차이를 보면 문제는 로컬 측정 도구 쪽 |
| 제출 파이프라인 replay (09-02) | 조건부 분열 추정; 확인한 적 없는 0.60 대 0.94 차이 | 같은 영상, 같은 채점기에서 0.7499 대 0.6005 | C12; 절대 점수의 기준을 하나로(C5) |
| 제출 파이프라인 후보로 재학습, v83을 그 sanity check로 (09-03) | 다른 파이프라인의 후보로 학습한 배포 division verifier가 TP 2개, FP 3개 | 로컬 +0.0065, 두 배아 모두 양수; Public 0.944, “새 base로 삼는다” 구간 | 재학습이 base가 됨 |
| 제출 런타임을 선택 도구로 (09-03) | 커널은 분열을 수십 개 적용하는데 로컬 레시피는 하나도 적용하지 않음 | 시험한 설정 중 배포 임계값과 적용량 설정이 최선, +0.0046; cap은 점수에 영향 없음 | 다시 만든 테이블은 학습 데이터로만 씀 |
| 예전 개선책 세 가지 다시 재기 | 셋 다 예전 측정에서 양수였음 | JLA는 embryo-disjoint에서 +0.0004; line-fit은 이미 배포됨(v82는 두 번 적용); 정수 변환 비용 0.0050이나 정수 출력 필수; 삭제 규칙 -0.0106 | 셋 다 제출 없이 중단 |
| 검출기 tail 실험 (09-04) | 선택한 low-recall 영상에서 밝기와 누락이 관련됨 | tail 재현율 0.7123 → 0.8884; 모든 조합이 중앙값 영상에서 손해 | router가 없어 중단; 분열 후보를 직접 라벨링하기 시작 |
이 기간이 끝났을 때의 선택 기준
| 조항 | 내용 | 도입 |
|---|---|---|
| C1 | 학습·보정·평가의 의존 관계를 분리하고 그래프 전체를 채점한다. 영상 분리만으로 배아 독립성이 보장되지는 않는다 | 2편 |
| C2 | 게이트는 결과를 보기 전에 정해 둔다 | 3편(07-15) |
| C3 | 규칙은 실제로 적용될 모집단에서 보정한다 | 3편 |
| C4 | 구성 요소는 자체 정확도가 아니라, 파이프라인을 그대로 재현해 만든 그래프로 평가한다 | 3편 |
| C5 | 점수와 변화량에 대조군을 함께 기록한다. 다른 replay의 변화량으로 우열을 매기지 않는다 — 이 편에서 정리(기준은 제출 파이프라인 replay) | 3편 |
| C6 | 후보는 hidden test에서 제한 시간 안에 실행을 마쳐야 한다 | 3편 |
| C7 | 폴드는 배아 단위로 나눈다(embryo-out) | 4편 |
| C8 | 제출 모델이 학습한 영상에서 잰 수치(hold-in)는 일반화의 근거로 쓰지 않는다 | 4편 |
| C9 | Public은 기대치를 미리 적어 둔 sanity check에만 쓰고, 인접한 설정 중 하나를 고르는 데는 쓰지 않는다 | 4편(08-10) |
| C10 | 후보의 도달 범위를 잰다. 상한이라는 말은 선언한 범위를 포괄할 때만 쓴다 | 5편 |
| C11 | 게이트는 결론을 낼 수 있어야 한다 | 5편 |
| C12 (신규) | 로컬 검증은 실제 제출 파이프라인을 그대로 재현해서 한다 | 6편 |
| C13 (신규) | 단계 제거로 전체 효과를 잰다. metric 항을 분리하려면 추가 가정을 밝힌다 | 6편 |
9. 이 기간에 확인된 것
확인된 사실
- v79 − v81의 Public 전체 효과는 \(+0.032\)였다. 분열 Jaccard 약 \(0.32\)라는 해석은 hidden 간선 변화가 작다는 가정에 의존한다. 로컬 값은 \(0.062\)였다.
- 같은 영상 199편과 같은 채점기에서 comparator replay는 \(0.6005\)(노드 재현율 \(0.8870\)), 제출 파이프라인은 \(0.7499\)(\(0.9255\))였다.
- 제출 파이프라인이 만든 같은 그래프에서 합집합 재학습은 배포된 선택 모델의 \(+0.0013\)보다 큰 \(+0.0065\)를 냈고, 제출 런타임으로는 \(+0.0046\)(\(0.7489\)에서 \(0.7535\))이었으며, 두 배아 모두 양수였다.
- 주석 맥락이 없는 정상 분기는 무시될 수 있지만, 부모가 매칭되지 않은 잘못된 분기까지 FP에서 제외되는 것은 아니다. 로컬에서는 도달 가능한 79개 중 8개만 선택했고, hidden false-positive 비용은 측정하지 않았다.
- 제출 파이프라인에서는 주석이 있는 분열 이벤트 \(151\)개 중 \(72\)개에 후보가 아예 없다.
- 외부 데이터로 학습한 검출기는 trainer 검증에서 \(+0.0466\), 영상 두 편의 배포 파이프라인에서 \(-0.0272\)였다.
- joint lineage action의 이득은 두 배아가 섞인 폴드에서 \(+0.0187\), 배아가 겹치지 않는 association head에서 \(+0.0004\)다.
- intensity augmentation은 큰 배아의 가장 나쁜 영상 7편에서 raw 재현율을 \(0.7123\)에서 \(0.8884\)로 올렸고, 파이프라인에서 잰 조합은 모두 보통 영상에서 손해였다.
근거는 있지만 아직 확정하지 못한 판단
- 작은 배아로 학습한 head의 전이가 약한 원인이 배아의 난이도보다 학습 영상 수에 있다는 해석.
- augmentation을 적용한 모델 쌍도 시험한 첫 번째 split과 비슷하게 동작하리라는 예상.
열린 질문
- Public 단계 제거 차이 중 분열 Jaccard와 adjusted-edge가 각각 얼마나 기여했는가?
- 다음에 로컬에서 고른 분열 변경도 조건을 맞춘 Public sanity check를 통과할까?
- 새 라벨 외의 신호로 주석 부모에서의 순위를 개선할 수 있을까?
- 살펴본 두 통계량 외에 test 시점에 쓸 router가 있을까?
- 피크 위치를 보존하도록 학습하면 조합 손실을 피할 수 있을까?
시리즈: