BioHub Cell Tracking 작업 기록 2: Public 점수가 멈췄을 때 — OOF 기반 오류 분석
시리즈 안내와 참고 링크
- 대회: BioHub - Cell Tracking During Development
- 공식 평가지표: RoyerLab kaggle-cell-tracking-competition metrics.md
- 이전 글: BioHub Cell Tracking 작업 기록 1: Lineage Graph 학습과 평가지표에 맞춘 후처리
영문판: BioHub Cell Tracking Working Note 2: From a Leaderboard Plateau to OOF Structural Diagnostics
- 후속 글: BioHub Cell Tracking 작업 기록 3: OOF에 기반한 판단들
관련 공개 노트북
시리즈 소개. BioHub는 3D 현미경 영상에서 세포의 lineage graph를 복원하는 대회다. 라벨이 있는 학습 자료는 두 배아에서 촬영한 영상 199편이며, hidden test의 29%는 Public, 나머지 71%는 Private 점수에 반영된다. hidden test는 학습에 쓰이지 않은 배아에서 나온다. 각 편은 해당 기간의 기록을 따라가며, 나중에 확인한 사실과 회고는 따로 표시했다.
나중에 확인한 내용 — 2026-09-23. 7월 18일에 division metric이 수정됐고, 이후 공지된 재채점에서 Public 선두 점수가 약 0.970에서 0.942로 내려갔다. 여기서 적용한 ±0.002 동점 기준은 9월 5–6일에 정했다.
1편은 어떤 구조적 오류를 처음 보는 배아에서도 고칠 수 있는지 물으며 끝났다. 다시 보정한 UNET400 anchor의 Public 점수는 약 \(0.902\)였지만, checkpoint·임계값·혼합 비율을 더 바꿔도 차이가 뚜렷하지 않았다. 대부분 anchor의 후처리 설정을 물려받았으므로, 오류가 비슷해서인지 조합에 맞는 보정이 부족해서인지 구분할 수 없었다.
다음 질문은 더 구체적이었다. 어떤 그래프 수정이 실제 오류를 고치며, 그 순이득이 학습에서 제외한 배아에서도 유지되는가? 이를 확인하려고 out-of-fold(OOF) 평가를 설계했다. 각 영상을 그 영상 없이 학습한 모델로 예측하고, 그 그래프에서 구조적 오류를 분석하는 방식이다. 7월 14일에는 학습이 진행 중이었고, 아래의 평가는 아직 계획이었다.
0. 첫 번째 글 이후 달라진 것
첫 번째 글을 쓸 때까지의 주된 개선축은 다음과 같았다.
1
2
3
4
5
학습된 노드와 간선 점수
-> ILP 기반 기본 그래프
-> 운동 기반 재연결
-> 짧은 성분 제거
-> 보수적인 공백과 분열 복원
이후에는 같은 계열 안에서 checkpoint, 검출 임계값, TTA, Center 조건, 독립 시드 혼합을 탐색했다. 대표적인 Public 점수는 다음과 같다.
| 실험 계열 | 대표 점수 | 관측된 사실 |
|---|---|---|
| 보정된 UNET400 운동·분열 그래프 | 0.902 | 작업 anchor. 조건부 Center와 0.001 차이 |
| 애매한 공백만 확인하는 Center 조건 | 0.901 | 확인 후보를 좁힌 구성. anchor 대비 이득은 미확인 |
| 모든 합성 공백을 검증하는 광범위 Center 조건 | 0.898 | 조건부 확인보다 0.003 낮았다. 유용한 복원을 거부했을 가능성 |
| 검출 임계값 양쪽 탐색 | 0.899 | 시험한 임계값 범위에서는 anchor를 넘지 못했다. |
| 공유 검출점 기반 association TTA | 0.899–0.900 | 시험한 TTA 설정은 기존 그래프 보정을 넘지 못했다. |
| 독립 시드 고정 비율 혼합 | 약 0.901 | 시험한 고정 비율은 anchor를 넘지 못했다. |
| 점수 차이가 작을 때만 쓰는 시드 합의 | 약 0.901 | 시험한 조건부 게이트에서도 뚜렷한 상승은 없었다. |
Public 점수는 소수 셋째 자리로 반올림된다. 이 결과로 더 시험할 설정의 범위는 좁혔지만, 작은 점수 차이만으로 새로운 배아에서의 우열을 정할 수는 없었다.
당시 상위권 점수는 \(0.970\), \(0.968\), \(0.941\), \(0.938\)이었다. 탐색을 넓힐 이유는 됐지만, 점수만으로 검출·연결·채점 방식 중 무엇이 격차를 만들었는지는 알 수 없었다.
1. checkpoint와 후처리는 하나의 모델이다
전체 제출 파이프라인을 다음과 같이 쓰자.
\[\hat G = P_{\theta} \left( M_W(X) \right).\]여기서
- \(X\)는 3차원 시계열 영상,
- \(M_W\)는 가중치 \(W\)를 가진 Temporal UNet과 간선 Transformer,
- \(P_{\theta}\)는 파라미터 \(\theta\)를 가진 ILP와 그래프 후처리,
- \(\hat G\)는 최종 제출 그래프다.
\(\theta\)에는 단일 임계값 하나가 아니라 다음 요소가 함께 들어간다.
\[\theta= \left[ \tau_{\mathrm{det}}, \tau_{\mathrm{edge}}, \lambda_{\mathrm{motion}}, \lambda_{\mathrm{ILP}}, L_{\min}, C_{\mathrm{gap}}, C_{\mathrm{division}}, \ldots \right].\]학습 횟수가 달라지면 검출 로짓과 간선 로짓의 분포도 달라진다. 같은 임계값을 쓰더라도 후보 노드 수, 후보 순위, ILP의 선택, 복원 대상이 모두 바뀐다. 따라서 다음 두 시스템은 서로 다른 모델이라고 보는 편이 정확하다.
1
2
UNET300 + theta_300
UNET400 + theta_300
두 번째 줄은 단순히 더 오래 학습한 모델이 아니다. 400ep 가중치에 300ep 보정을 잘못 이식한 시스템일 수 있다.
이는 checkpoint 변경 뒤 점수가 내려가고 250–400ep에서 후처리를 다시 맞춘 뒤 회복된 현상의 한 가지 설명이다. 다만 기존 비교는 checkpoint의 성능과 보정 효과를 분리하지 못했다. 학습 손실의 개선과 최종 그래프 점수의 개선은 같은 축이 아니다.
1.1 고정 혼합의 실패가 모델 혼합의 한계를 뜻하지는 않는다
anchor를 \(f_A\), 보조 모델을 \(f_B\), 두 모델의 조합을 \(g_\alpha\), 전체 후처리 파라미터를 \(\theta\)라고 하자. 반복된 Public 리더보드 실험은 anchor에 맞는 한 점 \(\theta_A^*\)를 찾는 과정에 가까웠다.
실제로 시험한 다수의 모델 혼합은 다음 값을 측정했다.
\[S_{\mathrm{LB}} \left( g_{\alpha_0}(f_A,f_B), \theta_A^* \right),\]또는 그 주변의 매우 작은 범위였다. 이 값이 anchor를 넘지 못했다고 해서 다음 부등식이 성립하는 것은 아니다.
\[\max_{\alpha,\theta} S\left(g_\alpha(f_A,f_B),\theta\right) \le \max_{\theta} S\left(f_A,\theta\right).\]두 질문을 분리하면 차이가 더 분명해진다.
\[\Delta_{\mathrm{fixed}} = S_{\mathrm{OOF}}\left(g_{\alpha_0},\theta_A^*\right) - S_{\mathrm{OOF}}\left(f_A,\theta_A^*\right),\] \[\Delta_{\mathrm{joint}}^* = \max_{\alpha,\theta} S_{\mathrm{OOF}}\left(g_\alpha,\theta\right) - \max_{\theta} S_{\mathrm{OOF}}\left(f_A,\theta\right).\]기존 제출은 Public 점수에서 \(\Delta_{\mathrm{fixed}}\)의 잡음 섞인 대리값을 본 셈이다. \(\Delta_{\mathrm{fixed}}\le0\)이어도 공동 보정 뒤의 추가 개선 여지를 뜻하는 \(\Delta_{\mathrm{joint}}^*\)가 0 이하라고 단정할 수는 없다.
모델을 혼합하면 다음 분포가 동시에 바뀐다.
- 검출 로짓의 절대 크기
- 간선 후보의 상대 순위와 점수 차이
- 프레임별 노드 수
- ILP에서 경쟁하는 간선의 비용
- 운동 재연결의 입력 그래프
- 공백과 분열 복원의 후보 모집단
따라서 혼합 모델의 최적점은 \(\theta_A^*\)가 아니라 별도의 \(\theta_{\mathrm{blend}}^*\)일 수 있다.
1.2 현재 점수만으로 구분할 수 없는 세 가설
고정 혼합이 \(0.902\)를 넘지 못한 결과는 적어도 세 가지 방식으로 설명할 수 있다.
| 가설 | 의미 |
|---|---|
| 높은 오류 상관 | 보조 모델도 anchor가 틀린 곳에서 함께 틀린다. |
| 보정 불일치 | 보조 신호는 있지만 anchor용 \(\theta_A^*\)가 조합된 분포에 맞지 않는다. |
| Public LB 적응 | \(\theta_A^*\) 자체가 반복 제출을 통해 Public 부분집합에 과도하게 맞춰졌다. |
현재의 Public 점수만으로 이 셋을 분리할 수 없다. 그러므로 정확한 결론은 다음과 같다.
1
2
3
4
시험한 고정 혼합과 조건부 게이트는
기존 후처리 보정 아래에서 anchor를 넘지 못했다.

공동 보정한 혼합 모델의 최적점이 더 낮다는 사실은 검증되지 않았다.
다만 Public 리더보드에서 모델 혼합과 후처리를 다시 대규모로 공동 최적화하는 것도 해답은 아니다. 그렇게 얻은 추가 상승은 Public 부분집합 적응을 더 심하게 만들 수 있다. 공동 보정의 효과는 모델 학습에 쓰지 않은 영상에서 평가해야 한다.
2. 공식 점수가 정의하는 오류
1편에서는 점수의 구성을 소개했다. 여기서 계획한 진단에는 세부 규칙 세 가지가 중요하다. 희소 주석에서 어떤 거짓 간선을 세는지, 노드 수가 점수에 어떻게 반영되는지, 7월 14일 당시 채점기가 분열을 어떻게 판정하는지다.
2.1 희소 주석 아래의 간선 Jaccard
예측 노드와 정답 노드는 같은 프레임에서 최대 \(7\,\mu\mathrm{m}\) 거리의 최적 이분 매칭으로 짝을 이룬다. 예측 간선의 양 끝이 짝지어진 정답 노드이고, 그 정답 노드 사이에 실제 간선이 있을 때 참 양성이다.
\[J_{\mathrm{edge}} = \frac{TP}{TP+FP+FN}.\]희소 주석 때문에 모든 미매칭 예측 간선이 거짓 양성은 아니다. 정답 문맥 안에서 잘못된 연결로 판정할 수 있는 간선만 FP가 된다. 따라서 단순한 노드 수나 간선 수만으로 오류를 판단하면 안 된다.
2.2 노드 수 보정
샘플 \(i\)의 예측 노드 수를 \(N_{\mathrm{pred},i}\), 제공된 전체 세포 수 추정치를 \(N_{\mathrm{total},i}\)라 두면
\[r_i = \frac{N_{\mathrm{pred},i}-N_{\mathrm{total},i}} {N_{\mathrm{total},i}}\]이고, 보정된 간선 점수는
\[J_{\mathrm{adj},i} = \max \left( 0, J_{\mathrm{edge},i}(1-0.1r_i) \right).\]전체 간선 점수는 샘플별 단순 평균이 아니다. \(D_i=TP_i+FP_i+FN_i\)를 각 영상의 가중치로 사용한다.
\[J_{\mathrm{edge}}^{\mathrm{adjusted}} = \frac{\sum_iD_iJ_{\mathrm{adj},i}} {\sum_iD_i}.\]\(r_i<0\)이면 보정 계수가 1보다 커질 수도 있다. 이는 무조건 노드를 적게 내라는 뜻이 아니다. 노드를 줄여 간선 FN이 늘어나면 기본 Jaccard가 먼저 손상된다. 중요한 점은 노드 검출과 간선 최적화를 서로 독립적으로 다룰 수 없다는 것이다.
2.3 분열은 직접적인 부모-두 자식 모양만 보지 않는다
이 절은 7월 14일 당시의 division 채점 규칙을 설명한다.
최종 점수는 다음과 같다.
\[S = J_{\mathrm{edge}}^{\mathrm{adjusted}} +0.1J_{\mathrm{division}}.\]분열 Jaccard도 영상별 비율의 평균이 아니라 전체 사건을 합친 마이크로 평균이다.
\[J_{\mathrm{division}} = \frac{\sum_iTP_i^{\mathrm{div}}} {\sum_i\left(TP_i^{\mathrm{div}}+FP_i^{\mathrm{div}}+FN_i^{\mathrm{div}}\right)}.\]공식 분열 평가는 예상보다 구조적이다. 정답 분열 하나가 TP가 되려면 하나의 예측 약연결 성분이
- 분열 전 단계의 짝지어진 노드를 포함하고,
- 두 딸세포 lineage를 각각 하나 이상 건드리며,
- 그 노드들을 하나의 성분으로 연결하고,
- 성분 내부에 나가는 간선이 두 개인 예측 갈림점을 포함해야 한다.
따라서 정답 부모와 정확히 같은 시점의 예측 노드가 직접 두 딸에 연결될 필요는 없다. 정답과 짝지어지지 않은 중간 갈림점도 성분의 lineage 연결을 완성하면 유효할 수 있다.
이 사실은 분열 복원을 단순한 다음 프레임의 두 번째 간선 추가 문제에서 다음 문제로 바꾼다.
1
2
분열 전 단계와 두 딸세포 lineage를 덮는 연결 성분을 만들되,
간선 FP와 불필요한 노드를 얼마나 적게 추가할 수 있는가?
3. 실험이 알려준 범위
3.1 300ep와 400ep 비교가 알려준 것
같은 학습 영상 199개에 두 all-train 모델을 다시 적용한 오류 해부에서는 400ep가 300ep보다 나았다.
| 지표 | UNET300 | UNET400 | 변화량 |
|---|---|---|---|
| 간선 TP | 121,669 | 122,151 | +482 |
| 간선 FP | 5,212 | 5,202 | -10 |
| 간선 FN | 7,214 | 6,732 | -482 |
| 전체 간선 Jaccard 대리값 | 0.907334 | 0.910997 | +0.003663 |
| 평균 점수 대리값 | 0.902110 | 0.912574 | +0.010464 |
오류 이유별로도 400ep는 단순히 확률만 높인 모델이 아니었다.
| 오류 유형 | UNET300 | UNET400 | 해석 |
|---|---|---|---|
| 짝지어진 노드 사이의 누락 간선 | 5,535 | 5,384 | 연결 누락 감소 |
| 출발 노드 미매칭 FN | 710 | 548 | 노드 매칭 개선 |
| 도착 노드 미매칭 FN | 709 | 579 | 노드 매칭 개선 |
| 양 끝 모두 미매칭 FN | 260 | 221 | 희소 검출 실패 감소 |
이 수치는 all-train checkpoint를 바꾸면서 어떤 오류가 달라졌는지 보여 줬다. Public 비교로 고른 UNET400 anchor에서 수정 후보를 설계하는 데는 도움이 됐다. 새 정책을 채택하거나 checkpoint 선택을 독립적으로 검증하려면 held-out 예측이 필요했다.
3.2 왜 추가 파라미터 탐색을 멈췄는가
점수가 더 오르지 않던 구간에서 다음 축을 여러 번 시험했다.
1
2
3
4
5
6
7
8
detection threshold
minimum track length
gap distance and cap
division geometry
Center threshold
TTA aggregation
독립 시드 모델의 혼합 비율
low-margin consensus 게이트
각 축에서 현재 anchor 주변의 민감도와 실패 방향을 확인했다. 문제는 다음 제출이 알려주는 정보량이 급격히 줄었다는 데 있다.
예를 들어 고정 혼합이 \(0.901\)을 기록했을 때 다음 중 무엇이 원인인지 Public 점수 하나로는 알 수 없다.
- 보조 모델에 고유한 참 간선이 거의 없다.
- 고유한 참 간선은 있지만 평균 과정에서 희석됐다.
- 로짓 보정이 달라 ILP가 엉뚱한 후보를 선택했다.
- 간선은 좋아졌지만 노드 수 보정이나 분열 점수가 나빠졌다.
- 실제 차이는 반올림 아래에 있다.
이 상태에서 혼합 비율을 하나 더 제출하는 것은 원인을 밝히지 못한다. Public 추가 제출 대신 OOF 오류표를 만들면 각 후보의 TP, FP, FN 변화와 영상별 안정성을 직접 볼 수 있다.
따라서 “더 이상 파라미터를 바꾸지 않는다”는 말은 모든 파라미터의 전역 최적점을 찾았다는 뜻이 아니다. 새로운 OOF 근거 없이 Public LB에서 한 축씩 탐색하는 일을 중단한다는 자원 배분 원칙이다.
4. 엄격한 OOF 설계
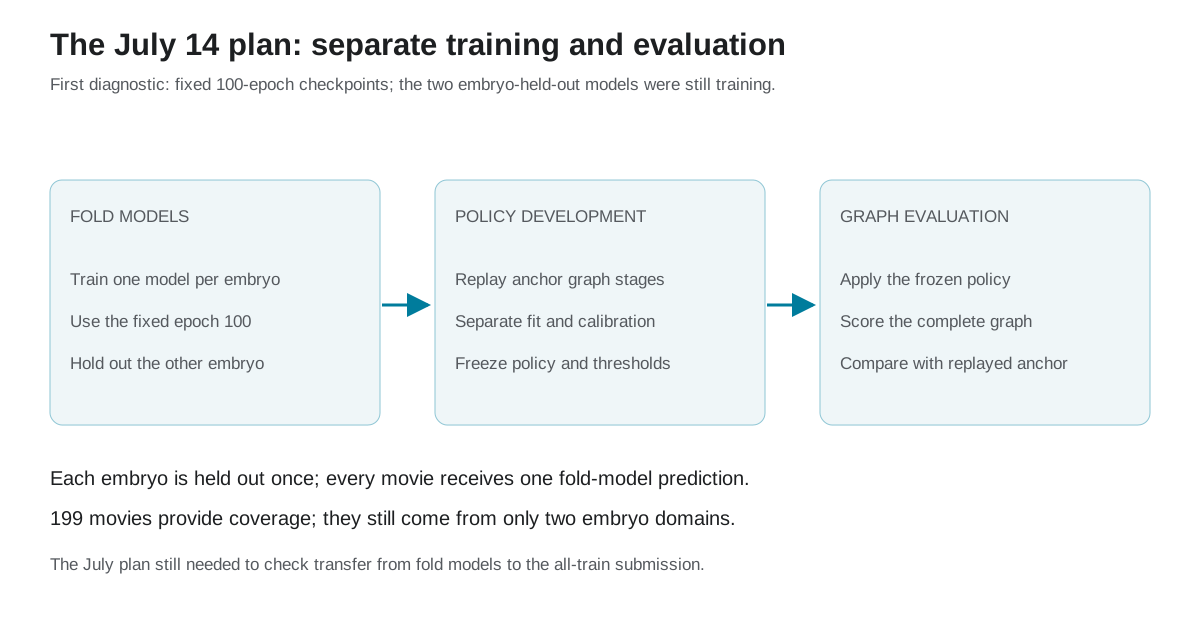 그림 1. 7월에 계획한 검증 순서. 고정 epoch의 폴드 모델로 예측을 만들고, 정책 학습·보정·평가 자료를 나눠 그래프 전체를 비교한다. 평가할 배아는 모든 학습·선택 단계에서 제외해야 한다.
샘플 \(i\)에 대한 OOF 예측은 그 샘플을 학습에 사용하지 않은 모델로 만들어야 한다.
\[\hat G_i^{\mathrm{OOF}} = P_{\theta_0} \left( M_{W_{-k(i)}}(X_i) \right),\]여기서 \(W_{-k(i)}\)는 샘플 \(i\)가 속한 폴드를 제외하고 학습한 가중치다.
현재 구성은 두 배아 계열이 한 폴드에 섞이지 않도록 나눈 2폴드 분할을 사용한다. 각 모델은 자신이 학습에 사용하지 않은 검증 폴드만 예측하고, 전체 학습 영상은 OOF 결과에서 정확히 한 번 나타나야 한다.
OOF 예측을 만들었다고 해서 정책 선택까지 자동으로 공정해지는 것은 아니다. 복원 규칙의 계수와 임계값을 고르는 자료와 최종 순이득을 보고하는 자료도 분리해야 한다.
\[\mathcal D_{\mathrm{fit}}\cap\mathcal D_{\mathrm{cal}} = \mathcal D_{\mathrm{fit}}\cap\mathcal D_{\mathrm{eval}} = \mathcal D_{\mathrm{cal}}\cap\mathcal D_{\mathrm{eval}} = \varnothing,\] \[\phi^* = \arg\max_{\phi} S\left( \mathcal D_{\mathrm{cal}}; R_{\phi}(\hat G^{\mathrm{OOF}}) \right), \qquad \text{report } S\left( \mathcal D_{\mathrm{eval}}; R_{\phi^*}(\hat G^{\mathrm{OOF}}) \right).\]여기서 \(\mathcal D_{\mathrm{fit}}\)은 정책 자체를 학습하는 자료, \(\mathcal D_{\mathrm{cal}}\)은 임계값을 고르는 자료, \(\mathcal D_{\mathrm{eval}}\)은 최종 판정 자료다. 자료가 적으면 outer-training 안에서 정책 학습과 보정 역할을 교차검증으로 나눌 수 있다. 그래도 독립적인 배아는 둘뿐이다. 아래의 고정 epoch 설계는 checkpoint 선택 문제를 다룬다. 정책 개발과 평가까지 분리하려면 위에서 정한 자료의 역할도 지켜야 한다.
코드: OOF 대상이 빠짐없이 한 번씩 포함됐는지 확인
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
from collections import Counter

coverage = Counter()

for fold in folds:
    train_ids = set(split[fold]["train"])
    holdout_ids = set(split[fold]["test"])

    assert train_ids.isdisjoint(holdout_ids)
    assert {embryo_of[m] for m in train_ids}.isdisjoint(
        {embryo_of[m] for m in holdout_ids}
    )

    predictions = predict(
        model=fold_models[fold],
        datasets=sorted(holdout_ids),
    )
    coverage.update(predictions.keys())

assert set(coverage) == set(all_training_ids)
assert all(count == 1 for count in coverage.values())
4.1 외부 검증 폴드로 최적 학습 시점을 고르면 OOF가 아니다
초기 수집 설계에는 중요한 문제가 있었다. 학습 중 외부 검증 폴드 점수가 가장 좋을 때 저장한 edge_predictor_best.pth를 같은 폴드의 OOF 예측에 쓰려고 했다. 이 경우 각 샘플은 가중치 최적화에는 직접 쓰이지 않았지만, 학습 시점을 고르는 데는 사용됐다.
이를 수식으로 쓰면
\[e^* = \arg\max_e S_{\mathrm{outer}} \left(W_e\right)\]를 구한 뒤 같은 외부 검증 자료에서 \(S_{\mathrm{outer}}(W_{e^*})\)를 보고하는 셈이다. 이는 고정된 OOF 추정치가 아니다.
현재 수집 규칙은 다음처럼 바뀌었다.
1
2
3
4
사전에 100ep를 진단 시점으로 고정한다
각 fold의 checkpoint_last.pth@100을 사용한다
두 fold의 epoch와 split, method를 manifest에서 검증한다
외부 검증 폴드로 최적 checkpoint를 고르지 않는다
100ep는 최종 모델의 충분한 학습량을 주장하기 위한 숫자가 아니다. 정책 후보와 오류 유형을 보기 위한 사전 고정 진단 시점이다.
4.2 200ep를 추가하려면
100ep 결과를 본 뒤 200ep가 좋아 보이는지 같은 외부 검증 폴드로 다시 선택하면 다시 누수가 생긴다. 유효한 방법은 둘 중 하나다.
- 해당 외부 검증 폴드의 결과를 보기 전에 200ep를 고정 시점으로 정한다.
- 각 평가 배아를 뺀 학습 폴드 안에 내부 검증 자료를 만들고 epoch 선택은 그 자료에서만 한다.
두 결과는 ep_0100, ep_0200처럼 분리 보존해야 한다. 나중 시점이 앞선 진단을 덮어쓰면 실험의 선택 경로를 복원할 수 없다.
4.3 원시 OOF와 제출 그래프 OOF는 다르다
Temporal UNet과 Transformer가 만든 원시 예측은 최종 제출 그래프가 아니다. 현재 기준 노트북에는 다음 결정적 단계가 뒤따른다.
1
2
3
4
5
6
7
raw model graph
-> ILP selection
-> motion reassignment
-> 짧은 연결 성분 가지치기
-> one-frame gap recovery
-> safe division repair
-> submission graph
원시 폴드 예측의 점수는 모델의 검출·연결 오류를 해부하는 데 유용하다. 하지만 이를 곧바로 \(0.902\) 기준 노트북의 OOF 점수라고 부를 수는 없다. 같은 운동 보정, 가지치기, 공백 복원, 분열 복원을 폴드별 예측에 다시 실행해야 전체 파이프라인을 평가할 수 있다. 단계를 맞추는 것만으로 충분하지는 않다. 편향 없는 추정을 위해서는 checkpoint와 정책을 고르는 과정도 평가 자료와 분리되어야 한다.
어느 그래프를 평가했는지가 달라지므로, 결과를 해석하기 전에 이 둘부터 구분해야 한다.
4.4 고정한 추론 조건
원시 OOF 수집도 anchor와 다른 검출 분포를 만들지 않도록 다음 설정에 고정했다.
| 항목 | 값 |
|---|---|
| 검출 임계값 | 0.9700 |
| 검출 TTA | XY D4 |
| 간선 특징 TTA | 원본 특징 맵 |
| pooling kernel | \(3.0\,\mu\mathrm{m}\) |
| 간선 activation | softmax |
| 간선 임계값 | 0.5 |
| ILP | 사용 |
| association learned-edge bonus | 1.0 |
이 표는 현재 replay의 기준 설정이다. 1편에서는 이전 association bonus \(0.75\)를 설명했고, 여기서는 \(1.0\)을 쓴다. \(0.901\) Center 구성과 \(0.902\) anchor도 전체 구성이 다르므로, 표시 점수 차이를 이 bonus 하나의 효과로 볼 수는 없다.
각 결과에는 다음 값이 함께 기록되어야 한다.
1
2
3
4
5
6
7
fold id
train/holdout split hash
weight SHA256
checkpoint epoch
method name
inference profile
prediction dataset list
가중치 이름이나 폴더 이름만으로 모델을 식별하면, checkpoint가 늘어날수록 같은 실험을 재현하기 어렵다.
5. OOF 오류를 구조적 사건으로 분해하기
OOF 예측이 모이면 전체 점수와 함께 다음 항목을 차례로 살핀다.
- 샘플별 예측 노드 비율
- 간선 TP, FP, FN과 보정 전후 Jaccard
- 분열 TP, FP, FN
- 배아 계열별 변화
- 영상별 변화의 부호와 크기
- 수정 후보별 반사실적 점수 변화
5.1 분열 FN의 구조적 분류
각 정답 분열은 다음 중 하나로 분류할 수 있다.
| 분류 | 의미 | 적절한 개입 |
|---|---|---|
connected_without_fork | 세 단계가 같은 성분에 있지만 갈림점이 없다. | 제한된 두 번째 나가는 간선 |
stages_disconnected | 필요한 노드는 있으나 lineage 단계가 끊겼다. | 연결 간선과 갈림점 후보 점수화 |
missing_pre_stage | 분열 전 단계 검출이 없다. | 검출 모델 또는 Center 특징 |
missing_daughter_lineage | 한 딸세포 lineage가 검출되지 않았다. | 검출 개선; 그래프만으로 억지 복원 금지 |
fork_assignment_conflict | 갈림점은 있으나 다른 사건에 대응한다. | 사건 단위 배정 모델 |
no_matched_nodes | 안전하게 연결할 근거가 없다. | 개입하지 않음 |
이 분류가 중요한 이유는 모든 분열 FN을 같은 연산자로 고칠 수 없기 때문이다. 예를 들어 connected_without_fork에는 간선 하나가 충분할 수 있지만, missing_daughter_lineage에 같은 연산을 적용하면 FP만 늘어난다.
5.2 그래프 수정 후보를 평가하는 목적함수
복원 연산자 \(R\)의 가치는 추가한 참 간선 수만으로 정하지 않는다.
\[\Delta S_R = \Delta J_{\mathrm{edge}}^{\mathrm{adjusted}} +0.1\Delta J_{\mathrm{division}}.\]분열 하나를 살리면서 잘못된 간선을 여러 개 추가하거나 노드 수 보정을 크게 손상하면 최종 점수는 내려갈 수 있다. 반대로 간선 Jaccard 변화가 작더라도 정확한 갈림점 하나가 여러 단계의 분열 조건을 완성할 수 있다.
또한 그래프 수정의 효과는 일반적으로 더할 수 없다.
\[\Delta S(R_1\cup R_2) \ne \Delta S(R_1)+\Delta S(R_2).\]두 수정이 같은 연결 성분, 같은 분열 사건, 같은 Jaccard 분모를 함께 바꿀 수 있기 때문이다. 따라서 개별 후보의 점수뿐 아니라 동시에 허용할 수정 집합의 순서와 상호작용도 공식 점수로 다시 계산해야 한다.
6. OOF에서 검증할 그래프 정책
6.1 보수적인 간선 교체
현재 기준 그래프의 모든 간선을 다시 만드는 모델은 위험하다. 첫 정책은 기존 다음 프레임 연결의 도착 노드만 제한적으로 바꾸는 문제로 축소했다.
출발 노드 \(i\)의 다음 프레임 후보 집합을 \(G_i\)라 하고, 후보 \(j\)의 점수를 \(s_{ij}\)라 하자. 그룹 단위 목적함수는
\[\mathcal L_i = \log\sum_{j\in G_i}\exp(s_{ij}) - \log\sum_{j\in G_i:y_{ij}=1}\exp(s_{ij})\]로 쓸 수 있다.
특징에는 원시 영상 전체 대신 현재 오류와 직접 관련된 값을 넣는다.
\[x_{ij}= \left[ p_{ij}, d_{\mathrm{raw}}, d_{\mathrm{motion}}, \operatorname{rank}_{ij}, |G_i|, \deg^+(i), \deg^-(j), \rho_i, \rho_j, t_{\mathrm{norm}}, \ldots \right].\]기준 운동 배정 점수는 다음 비용의 음수로 볼 수 있다.
\[A_{ij} = -\left( d_{\mathrm{motion}} +0.05d_{\mathrm{raw}} -1.0p_{ij} \right).\]순위 모델이 고른 도착 노드 \(r\)과 기준 도착 노드 \(a\)를 비교해
\[\Delta s=s_{ir}-s_{ia},\] \[\Delta A=\max(0,A_{ia}-A_{ir})\]를 계산한다. 교체는 OOF에서 이득 precision, harmful-change rate, 영상별 안정성 조건을 모두 통과하고 적용량 상한도 지킬 때만 허용한다.
코드: 연쇄 변경을 막는 보수적 교체
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
def can_replace(proposal, graph, frozen_claims, policy):
    source = proposal.source
    current = proposal.current_target
    alternative = proposal.alternative_target

    if graph.out_degree(source) != 1:
        return False
    if graph.in_degree(current) != 1:
        return False
    if alternative in frozen_claims:
        return False
    if proposal.rank_margin < policy.min_rank_margin:
        return False
    if proposal.anchor_penalty > policy.max_anchor_penalty:
        return False
    return True
중요한 제한은 다음과 같다.
- 노드를 추가하지 않는다.
- 분열을 만들지 않는다.
- 이미 점유된 도착 노드를 빼앗지 않는다.
- 교체 결과를 다음 교체의 입력으로 사용하지 않는다.
- OOF 보정이 실패하면 정책은
enabled=false로 저장한다.
마지막 조건은 의도적이다. 제출 후보를 만들기 위해 실패한 OOF 임계값을 손으로 완화하면 OOF를 만든 목적이 사라진다.
6.2 분열 사건 복원
분열 오류의 다수가 connected_without_fork라면 가장 작은 수정은 두 번째 나가는 간선 하나를 더하는 것이다. 후보는 다음 조건으로 제한할 수 있다.
1
2
3
4
5
6
같거나 인접한 분열 허용 시점
두 딸 후보의 충분한 공간 분리
부모 운동과 양립하는 이동량
각 딸의 후속 continuation
기존 in-degree와 out-degree 제약
영상별 및 그래프별 수정 상한
반면 stages_disconnected가 많다면 연결 간선과 갈림점을 함께 평가해야 한다. 이 연산은 간선 FP 위험이 더 크므로 고정 거리 규칙만으로 제출해서는 안 된다.
필요하다면 사건 단위 점수기를 학습할 수 있다.
\[z_{p,d_1,d_2} = \left[ q_{p,d_1}, q_{p,d_2}, r_{\mathrm{motion},1}, r_{\mathrm{motion},2}, d(d_1,d_2), c_{d_1}, c_{d_2}, \rho_p, t_{\mathrm{norm}} \right].\]여기서 \(q\)는 학습된 간선 근거, \(r_{\mathrm{motion}}\)은 운동 잔차, \(d(d_1,d_2)\)는 딸 사이 거리, \(c\)는 필요한 경우에만 쓰는 OOF Center 근거다.
사건 점수는
\[P(y_{p,d_1,d_2}=1\mid z) = \sigma(h_\phi(z))\]로 표현할 수 있다. 이 모델의 목표는 모든 분열을 더 많이 만드는 것이 아니라, 간선 손실보다 분열 이득이 큰 최소 그래프 수정만 선택하는 것이다.
7. 보조 모델을 언제 다시 사용할 것인가
7.1 Center 모델
Center 모델은 모든 검출 노드를 합치는 용도나 일괄 거부 규칙으로는 안정적이지 않았다. 하지만 OOF 오류 해부에서 missing_pre_stage와 missing_daughter_lineage가 충분히 많다면 다시 중요한 특징이 된다.
그때 필요한 것은 all-train Center의 점수가 아니라, 해당 모델의 학습에서 제외된 영상에 대한 Center 점수다. 그 점수를 gap 또는 division 사건 모델의 한 특징으로 넣는다.
1
2
3
그래프와 운동 근거
+ 학습에서 제외한 영상의 Center 근거
-> 사건 단위 판정
Center가 낮다는 이유만으로 후보를 거부하지 않고, 그래프 근거가 약한 곳에서 높은 Center 점수를 추가 양성 증거로 쓰는 원칙은 유지한다.
7.2 독립 시드와 모델 혼합
독립 시드의 가치는 평균 점수보다 고유하게 맞힌 사건에 있다. 두 모델 \((A,B)\)의 상보성은 다음 표로 먼저 본다.
| anchor | 보조 모델 | 의미 |
|---|---|---|
| 정답 | 정답 | 안전한 합의 |
| 정답 | 오답 | 모델 혼합이 anchor를 훼손할 수 있는 구간 |
| 오답 | 정답 | 보조 모델이 회수할 수 있는 핵심 구간 |
| 오답 | 오답 | 단순 앙상블로 해결하기 어려운 구간 |
이상적인 선택기가 사건마다 둘 중 맞는 모델을 고른다고 가정하자. 이 선택기의 점수와 가장 좋은 단일 모델 점수의 차이를 oracle gain(정답을 보고 선택했을 때의 이득)이라고 부를 수 있다.
\[U_{\mathrm{oracle}} = S_{\mathrm{oracle}(A,B)} - \max(S_A,S_B).\]이 oracle은 고정된 후보 집합 안에서 두 모델이 서로 다른 정답 사건을 제공하는지 보여 준다. 이득이 작으면 해당 선택기의 여지는 좁지만, 모든 혼합 방식이 제한된다는 뜻은 아니다. 이득이 크면 선택기나 보정을 시험할 이유가 생긴다. 그래도 학습한 모델이 oracle의 선택을 재현할 수 있는지는 별도 문제다.
따라서 OOF 이후의 모델 혼합 실험은 다음 최적화가 되어야 한다.
\[(\alpha^*,\theta^*) = \arg\max_{\alpha,\theta} S_{\mathrm{OOF}} \left( g_\alpha(f_A,f_B), \theta \right),\]단, \((\alpha,\theta)\)를 고른 자료와 최종 성능을 평가하는 자료를 다시 분리해야 한다.
8. 무엇이 확인됐고 무엇이 아직 가설인가
8.1 확인된 사실
- 현재 기준 보정 주변의 한 축 파라미터 탐색은 큰 Public 점수 상승을 만들지 못했다.
- 400ep all-train 모델은 300ep보다 표본 내 간선 오류 구조가 좋다.
- 시험한 좁은 Center 확인 규칙은 광범위한 거부 규칙보다 Public 점수가 높았다. 독립적인 자료에서 신뢰성을 추정한 결과는 아니다.
- 시험한 고정 TTA와 독립 시드 혼합은 기존 anchor를 넘지 못했다.
- 공식 점수에는 노드 수, 간선, 분열 연결 성분의 효과가 함께 반영된다.
8.2 다음 실험을 위한 가설
- 단일 임계값 탐색 다음으로 새로운 그래프 판단 규칙을 시험할 이유가 생겼다. 어느 쪽의 성공 가능성이 더 높은지는 아직 비교하지 못했다.
- 분열 사건 단위 복원이나 보수적인 간선 교체는 현재 파이프라인과 상보적일 수 있다.
- 이미 시험한 전역 평균의 대안으로, 불확실한 사건을 가려내는 선택기에 보조 모델의 출력을 넣어 볼 수 있다.
- 후처리까지 함께 보정한 모델 혼합은 아직 기각되지 않았다.
8.3 엄격한 OOF가 끝나야 답할 수 있는 질문
- 기준 그래프와 동등한 후처리를 재실행한 미사용 영상 점수는 얼마인가?
- 분열 FN은 어떤 구조적 유형에 집중되어 있는가?
- 간선 교체 순위 모델이 두 배아 계열에서 모두 순이득을 내는가?
- Center는 그래프와 운동 특징을 조건으로 둔 뒤에도 추가 정보를 주는가?
- 독립 시드에는 oracle gain이 있는가?
- 100ep 폴드 모델은 오류 유형을 안정적으로 보여 줄 만큼 충분히 학습됐는가?
이 세 범주를 섞지 않는 것이 중요하다. “가능성이 높다”는 문장을 “검증됐다”로 바꾸는 순간, 다음 실험은 다시 리더보드 추측이 된다.
9. OOF 정책의 승격 조건
OOF에서 점수가 조금 올랐다는 이유만으로 바로 제출하지 않는다. 그래프 수정 정책은 다음 조건을 모두 통과해야 한다.
- 공식 구현으로 계산한 결합 점수 \(\Delta S\)가 양수다.
- 두 배아 계열 중 어느 쪽도 합산 점수가 내려가지 않는다.
- 개선이 한두 영상이 아니라 여러 영상에 분포한다.
- 노드 수 보정이 큰 보정 전 간선 Jaccard 손실을 가리고 있지 않다.
- 수정한 노드와 간선의 절대 수 및 비율이 제한되어 있다.
- 특징 생성과 제출 실행 코드의 좌표계, 물리 단위, 후보 조건이 같다.
- 학습 시점 선택, 정책 학습, 임계값 보정, 최종 평가는 서로 필요한 만큼 분리되어 있다.
영상 단위 재표본화는 이 평가 묶음 안에서의 안정성을 보는 보조 진단이다. 아래 코드는 영상별 변화량의 단순 평균을 재표본화한다. 공식 점수의 신뢰구간을 구하려면 매번 간선 분모, 노드 보정, 전체 분열 TP·FP·FN을 다시 집계해야 한다. 어느 방식도 배아가 둘뿐이라는 한계나 같은 자료로 후보를 거듭 선택한 편향을 없애 주지는 않는다.
코드: 공식 집계와 구분한 영상 평균 진단
1
2
3
4
5
6
7
8
9
10
11
12
13
import numpy as np

def paired_bootstrap(delta_by_video, repeats=5000, seed=2026):
    values = np.asarray(delta_by_video, dtype=float)
    rng = np.random.default_rng(seed)
    samples = rng.choice(values, size=(repeats, len(values)), replace=True)
    means = samples.mean(axis=1)
    return {
        "mean": float(values.mean()),
        "fraction_positive_draws": float((means > 0).mean()),
        "q025": float(np.quantile(means, 0.025)),
        "q975": float(np.quantile(means, 0.975)),
    }
10. 7월 14일의 실행 상태와 이후 계획
7월 14일 당시 OOF 학습은 다음 조건으로 진행 중이었다.
1
2
3
4
5
6
방법: 2폴드 TemporalUNet3D + 연결 Transformer
난수 시드: 271828
분할: 배아 계열을 분리한 2폴드
첫 진단 시점: 100ep로 사전 고정
OOF 가중치: checkpoint_last.pth@100
외부 검증 폴드의 최고점 checkpoint: 사용하지 않음
수집 코드와 분석 코드는 학습 도중에 보강했지만, 학습 자료, 분할, 난수 시드, 손실함수, 최적화 방법, 데이터 증강, 목표 학습 횟수는 바꾸지 않았다. 변경된 부분은 학습 이후의 고정 시점 검증과 예측 수집이다. 따라서 당시 진행 중이던 학습은 유지하고, 이후 예측 수집 단계부터 변경한 규칙을 적용하기로 했다.
두 폴드가 끝나면 다음 순서로 진행한다.
1
2
3
4
5
6
7
8
1. 폴드별 고정 시점 checkpoint 검증
2. 검증 폴드 대상 범위와 가중치 해시 검증
3. 원시 OOF 예측 수집
4. 공식 간선·분열 오류 구조 계산
5. 기준 노트북의 결정론적 그래프 처리 단계 재실행
6. 간선 교체와 분열 복원 후보 평가
7. 배아·영상별 안정성 검증
8. 통과한 정책만 all-train 400ep anchor에 이식
100ep 폴드 모델은 오류를 분석하고 정책 후보를 추리는 용도였으며, 최종 예측에는 all-train 모델을 쓸 계획이었다. 그 사이의 이식도 검증해야 했다. 가중치가 바뀌면 로짓, 선택되는 노드, 복원 후보가 함께 달라질 수 있다.
\[\text{OOF models} \rightarrow \text{policy selection},\] \[\text{all-train model} \rightarrow \text{final prediction}.\]마무리
동점이 반복되면서 더 시험할 설정의 범위는 좁아졌다. 다음에는 고정 epoch의 폴드 예측을 만들어 그래프 전체를 비교해야 했다. 오류 유형과 comparator를 분명히 정하고, 학습·보정·평가에 쓰는 자료를 나누면 제안한 복원 중 무엇을 이어 갈 만한지 판단할 수 있을 것이다.
시리즈: