BioHub Cell Tracking 작업 기록 3: OOF에 기반한 판단들
시리즈 안내와 참고 링크
관련 공개 노트북
시리즈 소개. BioHub는 3D 현미경 영상에서 세포의 lineage graph를 복원하는 대회다. 라벨이 있는 학습 자료는 두 배아에서 촬영한 영상 199편이며, hidden test의 29%는 Public, 나머지 71%는 Private 점수에 반영된다. hidden test는 학습에 쓰이지 않은 배아에서 나온다. 각 편은 해당 기간의 기록을 따라가며, 나중에 확인한 사실과 회고는 따로 표시했다.
나중에 확인한 내용 — 2026-09-23. 여기서 적용한 ±0.002 Public 동점 기준은 9월 5–6일에 정했다. backbone은 배아별로 나눴지만 일부 정책 폴드는 같은 배아 안에서 영상만 나눴다는 문제도 이후 점검에서 따로 짚었다. 7월의 판단 당시에는 이 차이가 충분히 정리되지 않았다.
7월 15–31일에는 2편에서 계획한 OOF 절차가 결과를 내기 시작했다. 예측을 만들고 그래프 처리 단계를 replay한 뒤, 미리 정한 게이트로 후보를 판단하는 과정이었다. 기존 처리 단계를 재현하자 모델이 직접 만든 그래프보다 \(+0.052187\) 좋아졌지만, 새 수정안 대부분은 게이트를 넘지 못했다. 보정에 쓴 후보와 실제 적용 후보가 다르고, 구성 요소의 정확도가 올라가도 그래프는 나빠지며, 서로 다른 기준 그래프에서 이득을 재는 문제가 반복됐다.
네 정책이 로컬 게이트를 통과했지만 비교 기준은 제각각이었다. 분열 ensemble과 단일 시드 대조군은 둘 다 Public에서 \(+0.004\)였고, 노드 삽입 후보는 일곱 번 제출해도 점수가 나오지 않았다. 구체적인 그래프 변경은 시험할 수 있게 됐지만, 기준 그래프 일곱 개에서 따로 잰 이득으로 후보의 순위를 매길 수는 없었다.
0. 첫 결과 전에 적어 둔 통과 기준
7월 15일, 첫 결과가 나오기 전에 후보 채택 기준과 제출 예산을 적었다. 먼저 폴드별 예측에서 복원 가능한 오류를 찾고, 작은 그래프 수정 하나를 시험하기로 했다. 최종 그래프가 전체적으로 좋아지고 두 배아 모두에서 나빠지지 않으며, 폴드별 성능과 수정 개수 조건까지 만족하면 전체 자료로 다시 학습해 제출하는 순서였다. 제출은 3+2 순서였다. 기준점·후보·ablation을 먼저 내고, 그 결과에 따라 후속 비교를 최대 두 번 더 한다. 결과가 좋다는 이유로 채택 기준까지 바꾸지 않으려는 장치였다.
공식 점수는 adjusted edge Jaccard에 division Jaccard의 10분의 1을 더한 값이다. adjusted edge Jaccard는 예측 노드 수가 영상의 추정 세포 수보다 많으면 감점하고, 두 항 모두 annotator가 라벨을 단 곳에서만 센다. operator \(R\)는 다음 조건을 모두 만족할 때만 승격했다.
\[\Delta S(R)>\delta_{0} \;\wedge\; \min_{p\in\{A,B\}}\Delta S_{p}(R)\ge 0 \;\wedge\; \min_{k}\Delta S^{(k)}(R)\ge 0 \;\wedge\; |R|\le n_{\max},\]| \(\Delta S\)는 결정론적 파이프라인 전체를 replay한 뒤 잰 공식 합산 점수의 정확한 변화, \(p\)는 두 배아 prefix(영상 ID의 prefix가 배아를 가리킨다), \(k\)는 outer cross-fit 폴드, $$ | R | $$은 수정 개수다. 조건마다 결과를 따로 기록해서 기각마다 걸린 조건이 남았고, 기각은 대부분 뒤의 세 조건에서 나왔다. |
2026-07-18에 주최 측이 분열 평가지표의 허점(exploit)을 고쳤고(리더보드 전체 재채점 공지 2026-07-23), 2편에서 설명한 분열 조건은 더 엄격하고 국소적으로 바뀌었다. 부모 쪽 노드가 정답 노드와 매칭되고, 그 자리에서 실제로 분기가 일어나고, 두 딸 가지가 곧바로 다시 합쳐지지 않아야 하며, 예측한 분기와 정답 분열이 일대일로 대응되어야 한다. 리더보드 최상위 점수가 대략 \(0.028\) 내려갔으니, 2편에서 따졌던 격차의 일부는 예전 평가지표에서 나온 것이었다. 변경 전후로 모두 채점된 내 제출은 없다. 파이프라인 구조로 보아 허점을 이용하지 않았다고 판단했고, 당시에는 7월 점수를 같은 척도로 읽었다. 다만 동일한 제출을 재채점한 기록이 없어 척도가 바뀌지 않았다고 확인할 수는 없다.
1. 첫 번째 시험: 기존 그래프 처리 단계는 처음 보는 영상에서 얼마의 가치가 있나
2편은 손으로 만든 그래프 처리 단계가 방법의 일부인지, 리더보드에 맞춰진 보정인지를 남겨 두었다. 07-17에 이 단계들(ILP selection, motion reassignment, short-component pruning, one-frame gap recovery, safe division repair)을 제출한 그대로 epoch \(100\) 2-fold OOF 예측 위에서 replay했다. ILP는 최적화기다. 후보 노드와 간선 가운데 어떤 것으로 그래프를 구성할지 고르는 정수 선형 계획(integer linear program)이다.
| 항목 | 모델 원본 그래프 | replay 후 | 변화 |
|---|---|---|---|
| 공식 점수 | 0.647453 | 0.699640 | +0.052187 |
| 노드 재현율 | 0.916820 | 0.911433 | -0.005387 |
| 개선된 영상 | — | 199편 중 183편 | — |
이 held-out 예측에서는 처리 단계를 더한 점수가 약 \(+0.052\) 높았다. 이를 기준 파이프라인으로 유지할 근거는 됐지만, 검출기나 그래프가 바뀌어도 효과가 같거나 더 개선할 여지가 없다는 뜻은 아니다. 노드 재현율은 줄면서 최종 점수는 올랐다는 점도 눈여겨볼 만했다.
남은 간선 거짓 음성(FN) 약 \(25{,}150\)개 가운데 \(11{,}020\)개는 양 끝 노드가 모두 매칭되지 않은 경우였다.
1
2
3
4
양 끝 노드가 매칭된 간선 FN은 association 오류다.
양 끝 노드가 모두 매칭되지 않은 간선 FN은 association 오류처럼 보이는 검출 오류다.
기존 매칭 노드에 한정된 ranker로는 두 번째 종류를 회수할 수 없다.
검출점이나 좌표를 바꾸거나 새 노드를 제안해야 한다.
양 끝 노드가 없는 간선이 많다는 사실은 검출 범위를 다시 살필 이유가 됐다. 하지만 당시 replay는 저장해 둔 검출 결과를 사용했기 때문에 노드를 다시 만드는 변경은 시험할 수 없었다. 고정 노드 위의 수정은 2절에서, 검출 변경은 이 기능이 없던 동안 어떻게 시험했는지 3절에서 다룬다.
같은 리포트의 short-track rescue는 1편부터 갖고 있던 생각을 시험했다. 빠진 노드를 되살리면 참 간선도 복원할 수 있으리라는 생각이다. 노드 재현율은 진단 지표이지 공식 점수의 별도 항은 아니다. 노드 \(14{,}917\)개를 되살리자 노드 재현율은 \(+0.00186\) 올랐지만 공식 점수는 \(0.000735\) 떨어졌고, 영상 199편 중 \(156\)편이 나빠졌다. 참 간선 복원 없이 노드만 늘면 노드 수 보정에서 손해를 볼 수 있다. 잘못된 간선까지 추가되면 그 비용도 생긴다.
2. 정책 학습·보정·평가를 나눠 내린 첫 판단
edge-replacement 순위 모델은 가장 작은 주장을 시험했다. OOF로 학습한 순위 모델이 파이프라인의 간선 중 바꿔야 할 것을 가려낼 수 있다면, 그 교체는 처음 보는 영상에서, 두 배아 모두에서 도움이 되어야 한다. 07-19에 고정된 \(200\) epoch capture 위에서 nested 5-fold cross-fit을 마쳤다. 정책 학습, 임계값 보정, 최종 평가를 서로 겹치지 않는 영상 집합에서 했고, 임계값을 폴드별 중앙값으로 고정해서 test 영상에 폴드 구분이 필요 없다. 결과는 교체 \(1{,}447\)건으로 \(+0.0002706\)이었고, 두 배아 prefix 모두 양수였다. 정책 단계의 학습·보정·평가 영상을 분리한 초기 판단이었고, 로컬 근거로 승격했다. 이 정도의 작은 이득으로는 뚜렷한 Public 변화를 기대하기 어려웠다.
3. 검출 변경을 로컬에서 평가하지 못하던 시기
7월 셋째 주에 마련돼 있던 로컬 replay는 저장된 검출 결과 위에서 연결만 바꿀 수 있었다. 노드를 다시 추출하는 기능을 만들기 전까지는 검출맵 변경을 Public 제출로 시험했다(5절).
3.1 두 번째 시드는 association에서 도움이 되는가
2편은 독립된 시드로 학습한 두 번째 모델이, 두 모델을 함께 보정한 혼합에서 쓸 만한 정보를 더하느냐는 질문도 남겼다. 07-20부터 07-23까지 제출 17번으로 association 경로의 혼합 규칙을 바꿔 봤다. 로짓 혼합, margin-adaptive 혼합, consensus 조건, basin search 모두 제출 기록상 \(0.905\)에서 \(0.908\) 사이였다(내 작업 로그에는 그중 하나가 \(0.909\)로 적혀 있다). 내 로그에서 가장 강한 single-seed 그래프는 07-19/20 무렵 약 \(0.909\)였고, 이 시리즈에 나중의 동점 기준을 적용하면 이보다 나은 변형은 없었다. 가장 약한 것은 \(0.003\)–\(0.004\) 낮았다. 고정된 점 집합 위의 간선 가중치 조정은 \(10^{-4}\) 단위까지 재는 OOF 검증에 맡겼다. 2편이 끝난 \(0.902\)–\(0.903\) 구간에서 이 \(0.909\)까지 오른 약 \(+0.006\)은 이 기간의 어느 실험 덕분인지 특정할 수 없다.
3.2 두 모델의 검출맵을 섞으면 달라질까
07-24에 질문을 간선에서 점으로 옮겼다. 후보 하나는 정렬한 두 모델의 검출 logit 맵을 peak 추출 전에 평균했고, ablation과 양쪽 bracket을 같은 날 함께 제출해 리더보드의 답이 어느 변경에서 왔는지 가를 수 있게 했다.
| 후보 | 변경 | Public |
|---|---|---|
| peak 추출 전 검출 맵 평균 | 균형 잡힌 검출 맵, dual-seed association 유지 | 0.911 |
| 균형 검출 맵, primary만 쓰는 association | ablation | 0.910 |
| primary 가중 검출 맵 | primary 시드 쪽으로 기운 가중치 | 0.909 |
| secondary 가중 검출 맵 | 두 번째 시드 쪽으로 기운 가중치 | 0.907 |
dual-seed association을 빼도 균형 검출 맵은 나중의 동점 기준으로 같은 점수였다. 이 비교에서는 association의 기여를 구분하지 못했다. 앞선 탐색과 함께 검출 맵을 더 시험할 이유는 됐지만, 작은 association 효과나 다른 조합에서의 가능성까지 제외하지는 못했다.
07-25에는 primary 쪽으로 조금 기운 검출 맵(secondary detection 가중치 \(0.5\) 대신 \(0.475\), 임계값은 동일)이 \(0.912\)로 균형 검출 맵과 같은 점수를 받았고, 이후 OOF replay 대부분의 고정 기준이 되었다. detection 임계값을 양쪽으로 움직인 probe도 양쪽 점수가 같아서, 해당 탐색은 멈췄다. 표시된 점수가 같다는 사실이 실제 반응도 정확히 평평하다는 뜻은 아니다.
3.3 리더보드를 이렇게 쓰면서 제출 예산은 어떻게 되었나
07-15의 예산은 OOF 검증이 승격한 것만 리더보드에 올린다는 전제였다. 검출 맵을 잴 로컬 수단이 없어서 리더보드가 그 역할을 했다. 게이트는 operator마다 확인했지만 예산은 챙기지 않아서, 고쳐 쓰지도 않은 채 흐지부지되었다. 그달 채점된 제출은 \(109\)건이었다.
4. 메커니즘 검증: 네 번의 기각과 각각 틀린 지점
아홉 번의 기각 중 네 번은 패턴이 같았다. 후보의 구성 요소 지표는 좋아졌는데, 그래프는 좋아지지 않았다.
4.1 라벨이 있는 곳에서 보정한 선택 모델이 라벨이 없는 곳에서 작동했다
주장. 누수 없는 선택 모델이 라벨이 달린 사례에서 두 번째 시드의 부모가 더 나은 경우를 학습한다면, 선택 모델이 작동하는 곳마다 도움이 되어야 한다. 이 dual-seed association 선택 모델은 모델 단계에서 엄격하게 out-of-fold였고, 그 위에서 다시 cross-fit했으며, 라벨이 달린 group(세포 하나의 부모 후보 묶음) 가운데 이로운 \(177\)개와 해로운 \(43\)개로 보정했다. leakage audit에서도 문제가 없었다.
replay 결과. 선택 모델은 라벨이 있는 곳에서 보정했지만, 배포하면 대부분 라벨이 없는 곳에서 작동한다.
\[\pi_{\mathrm{cal}} =\frac{249}{122{,}007} =0.204\%, \qquad \pi_{\mathrm{dep}} =\frac{15{,}062}{276{,}077} =5.456\%, \qquad \frac{\pi_{\mathrm{dep}}}{\pi_{\mathrm{cal}}} \approx 26.7 .\]정확한 replay에서 점수는 \(0.000068190\) 줄었고, 영상 199편 중 \(112\)편이 나빠졌다. 사후에 고른 폴드 부분집합 중 기준선을 넘는 것은 없었고, test 영상에는 폴드 구분이 없어서 어느 것도 배포할 수 없었다. 공식 간선 집계를 참 양성(TP) \(+16\), 거짓 양성(FP) \(+26\), FN \(-16\)만큼 움직이려고 선택 모델은 노드 \(3{,}001\)개와 원본 간선 \(3{,}450\)개를 바꿨다. 채점 대상인 정답 주석 골격은 선택 모델이 다시 쓰는 그래프의 얇은 단면이다.
확인한 것. 이 선택 모델의 점검에서는 학습 자료 중복이 발견되지 않았지만, 보정에 쓴 후보와 실제 수정한 후보의 분포가 크게 달랐다. 작동 비율의 차이는 그 불일치를 조사할 단서였다. 비율이 몇 배 다르면 어떤 규칙이든 기각해야 한다는 보편적 기준은 아니다. 여기서 C3가 나왔다. 규칙을 보정할 때 실제 적용할 후보 집단을 반영한다.
4.2 부모를 더 자주 맞혀도 그래프는 좋아지지 않았다
주장. held-out 영상에서 올바른 부모를 더 자주 고르는 모델은 더 좋은 그래프를 복원해야 한다. 나흘 사이에 두 모델로 이를 시험했다.
| 모델 | 구성 요소 지표 | 정확한 그래프 replay |
|---|---|---|
| temporal-flow 게이트 (motion 모델이 고른 부모로 바꿔 줌) | parent top-1 0.867186 → 0.879198 (+0.012012), outer 폴드 5개 모두 0 이상 | -0.0007833, 개선 63편 / 악화 132편 |
| higher-order parent matcher (부모 후보들을 함께 비교) | parent top-1 0.867589 → 0.883202 (+0.015613) | +0.000482, outer 폴드 하나 -0.000788, prefix 하나 -0.000280 |
replay 결과. temporal-flow 게이트는 부호가 뒤집혔다. parent top-1은 모든 폴드에서 좋아졌는데, 최종 그래프는 영상 세 편 중 두 편에서 나빠졌다. higher-order matcher는 합산 점수가 양수였지만 한 폴드와 한 배아의 게이트를 넘지 못했다. 부모를 더 잘 고르는 것만으로 그래프 성능 조건까지 충족되지는 않았다.
메커니즘. 노드의 부모가 바뀌면 연결된 component도 달라진다. 그에 따라 short-component pruning으로 지우는 부분과 gap recovery로 잇는 부분이 바뀐다. 부모 하나를 올바르게 바꾼 뒤에도, 올바른 간선 여러 개를 담은 component가 잘릴 수 있다. parent top-1에는 이 후속 효과가 반영되지 않는다. temporal-flow 게이트는 노드 재현율을 \(+0.001145\) 올리면서 최종 점수를 낮췄다. short-track rescue에서도 본 현상이었다.
기각 검증. higher-order matcher는 폴드 게이트와 prefix 게이트를 통과하지 못해 승격하지 않았다. 근거가 엇갈려서(합산은 양수, 폴드 하나와 prefix 하나는 음수) 변형 세 개를 이 기각의 sanity check(로컬 판단을 처음 보는 배아에서 확인하는 Public 제출)로 제출했다. 넓게 적용한 두 변형은 6절에서 다룰 \(0.916\) 분열 설정보다 \(0.004\) 낮았고, 기각과 방향이 같았다.
두 모델에서 C4가 나왔다. 구성 요소는 자체 정확도가 아니라, 파이프라인을 그대로 replay해 만든 그래프로 평가한다.
4.3 분류를 더 잘하는 모델이 더 나쁜 노드를 넣었다
주장. candidate-proposal 모델은 검출기가 놓친 세포를 제안한다. 이 모델의 두 버전 가운데 분류를 더 잘하는 쪽이 더 좋은 노드를 넣어야 한다. 미리 정해 둔 ensemble은 내가 가진 오프라인 지표 모두에서 single 모델보다 나았다. known-label AP가 \(0.9999984\) 대 \(0.9999973\), 고정 그래프가 놓친 노드의 회수율이 \(0.53075\) 대 \(0.52633\)이었다.
replay 결과. 완성된 그래프에 끼워 넣으면 single 모델이 더 나았다. single 모델은 수정 \(842\)건으로 \(+0.0000506\), ensemble은 \(845\)건으로 \(+0.0000435\)였다. 둘 다 승격하지 않았다. 실행 한 번에 차이가 \(7\times10^{-6}\)이므로 이 순서는 법칙이 아니라 경고다. 분류 품질과 개입 효용은 서로 다른 목표이고, C4를 다른 쪽에서 확인한 결과다.
양쪽 모두 기존 조각과 이어지는 자리에만 노드를 넣는 two-sided bridge 수정은 후보 triple \(1{,}354\)개에서 한 건도 나오지 않았다. 여러 프레임에 걸친 검출 누락은 한 가지 설명이었다. 후보 생성이나 통과 조건이 엄격해서 아무 수정도 선택되지 않았을 가능성도 남았다.
5. 남은 점수가 어디 있는지에 대한 네 가지 주장과 기각
다음 네 후보는 놓친 점수가 다른 곳에 있다고 보았다. 배아별 detection 가중치, 분열 precision, 최적화기의 목적함수, 여러 그래프 가설을 함께 유지하는 방식이다. 아홉 번째 기각인 세 번째 분열 시드는 6절에서 다룬다.
배아별 검출기 설정은 폴드가 바뀌면 유지되지 않았다. 가중치마다 점을 다시 추출하는 전체 OOF detection grid에서, secondary detection 가중치를 낮출수록 한 배아는 좋아지고 다른 배아는 나빠졌다. 배아별로 설정을 달리하는 router가 유망해 보였다. 배아마다 그 안에서 nested cross-fit을 하자 \(-0.0003550114\)로 기각되었고(reciprocal cross-fit \(-0.0003884963\)), 배아별 변화도 둘 다 음수였다. development 폴드는 한 배아에서 \(0.40\)을 두 번, baseline을 두 번 골랐고, 다른 배아에서는 정반대 양 끝값인 \(0.25\)와 \(0.70\)을 골랐다. 모델의 두 폴드가 두 배아 prefix와 그대로 겹쳐서, 배아의 차이와 폴드의 차이를 구분할 수 없다. subgroup 효과는 현상으로는 있었지만 규칙으로 삼을 만큼 안정적이지 않았다.
분기를 많이 만든다고 분열 점수를 받지는 않는다. 고정된 OOF 그래프에는 두 갈래 분기가 이미 \(12{,}794\)개 있었고, 학습 데이터 전체에 주석된 분열은 \(151\)개다. 그런데 분열 TP는 \(4\)개, FP는 \(720\)개였다. 모자란 것은 분기가 아니라 매칭된 부모에서 깨끗하게 갈라지는 분기였다. 순위가 낮은 분기에서 약한 쪽 딸 간선을 잘라 내는 cross-fit validator는 분열 FP를 \(720\)에서 \(317\)로 줄이고 \(+0.000328\)을 얻었지만, 간선 TP \(197\)개를 잃었고 outer 폴드 네 개 중 두 개가 음수였다. 가중치 1인 간선 재현율을 내주고 가중치 10분의 1인 분열 precision을 샀다.
최적화기가 고른 분기는 늘었지만 채점 결과는 같았다. ILP에 hyperedge 변수를 추가했다. 이 변수는 두 딸 간선이 모두 선택될 때만 켜지도록 제약을 걸고, OOF 분열 rank score만큼 보상을 주었다. 보상을 \(1.00\)에서 \(2.00\)으로 올리자 최적화기가 고른 완전한 분기 사건은 \(7\)개에서 최대 \(43\)개까지 늘었지만, 수정된 평가지표의 분열 집계는 모든 보상에서 정확히 TP \(5\) / FP \(507\) / FN \(146\)이었다.
1
2
3
solver는 분기를 더 많이 골랐다.
그 뒤의 그래프 필터가 그 분기를 하나도 남기지 않았다.
이 파이프라인에서 무엇이 분열로 남는지는 solver 다음 단계에서 정해진다.
solver가 더 고른 분기가 후속 필터를 통과하지 못했으므로, 이 hyperedge 구성을 중단했다.
후보를 합친 구성은 정해 둔 예산을 넘었다. 07-28의 내 조사(6절)는 이 아이디어를 1순위로 꼽았다. 그래프 가설 여러 개를 함께 살려 두고 joint optimizer가 판정하게 하는 방식이다. 이틀 뒤 미리 적어 둔 게이트가 이를 멈췄다. 고정 그래프, 다른 detection blend 다섯 개, proposal 모델을 합친 union은 노드 재현율을 \(0.943001\)에서 \(0.965008\)로 올렸지만, 고정 그래프가 놓친 노드 가운데 \(38.61\%\)만 회수해 게이트 \(40\%\)에 못 미쳤고, 프레임당 새 점이 \(25.98\)개 필요해 게이트 \(6\)개를 크게 넘었다.
union으로 회수할 수 있는 정답 간선은 \(1{,}704\)개였지만, 고정 그래프 밖 후보 \(649{,}702\)개 사이에 섞여 있었다. 정답과 노드 매칭을 고정하면 올바른 간선 하나를 더할 때 TP는 1 늘고 FN은 1 줄므로 Jaccard 분모는 바뀌지 않는다. 거짓 간선은 FP와 분모를 1씩 늘린다. 후보들이 서로 간섭하지 않는다고 가정하면 추가 후보의 precision \(p\)가 \(J/(1+J)\)를 넘어야 기대 이득이 생긴다. 당시 \(J=0.731046\)에서 손익분기 precision은 \(0.422315\)였다. 한 제안 출처 조합은 두 배아와 네 폴드에서 모두 이 값을 넘어 \(0.526814\)를 기록했다. 다만 노드 수와 후속 그래프 효과가 빠진 대용 지표이므로 전체 replay가 필요했다. 새 tracklet을 넣는 고정 규칙 세 개는 희소 간선 대용 지표에서 양수였고 노드 재현율도 올렸지만, 공식 점수는 각각 \(-0.003536\), \(-0.002364\), \(-0.006235\)였다. 서로 다른 수정에서 대용 지표와 최종 그래프의 부호가 갈리는 패턴이 반복됐다.
6. 오류 예산을 따라 분열 쪽으로, 그리고 리더보드에서 확인하기
후보 대부분이 기각된 07-28, 점수를 더 올릴 여지를 조사하면서 영상 \(199\)편 전체에 대해 고정 그래프의 오류 예산을 계산했다.
| 항목 | 값 |
|---|---|
| 공식 점수 | 0.725553 |
| 간선 TP / FP / FN | 109,363 / 20,715 / 19,520 |
| 노드 재현율 | 0.9477 |
| 분열 TP / FP / FN | 4 / 720 / 147 |
간선 FN 가운데 \(5{,}455\)개(\(27.9\%\))는 여전히 양 끝이 모두 매칭되지 않았다. 분열 항이 점수에 보태는 값은 다음과 같다.
\[0.1\cdot J_{\mathrm{div}} =0.1\cdot\frac{4}{4+720+147} =0.00046\]평가지표가 분열 항에 배정한 가중치 \(0.1\) 가운데 이만큼만 쓰이고 있었다. 계산 자원은 대부분 간선 항에 들어가고 있었으므로, 분열 쪽으로 방향을 돌렸다.
같은 날 strict-division rank ensemble이 모든 게이트를 통과했다. 주장은 이렇다. 서로 다른 시드로 학습한 분열 사건 모델 두 개는 순위를 매길 때 부분적으로 다른 실수를 하므로, 두 순위를 합치면 어느 한쪽만 쓸 때보다 진짜 분열이 더 위로 올라와야 한다. 두 모델은 같은 가중치의 고정 percentile 규칙으로 합쳤고, 순위 상위의 작은 비율(action fraction)만 고정 그래프 뒤에 추가했다.
| 구성 | outer cross-fit 변화 | 폴드 |
|---|---|---|
| 시드 A 단독 (single-seed 대조군) | +0.000661 | — |
| 시드 B 단독 | +0.000834 | — |
| 2-seed percentile ensemble | +0.000949 | 네 폴드 모두 양수, 모든 폴드에서 같은 action fraction(0.016) |
| 3-seed ensemble | +0.000697 | action fraction 0.064 / 0.032 / 0.032 / 0.024 |
이 ensemble은 edge Jaccard를 조금 잃는 대신 분열 TP 9개를 되찾았다.
Public 확인. 분열 ensemble과 단일 시드 대조군을 함께 제출했다. 둘 다 \(0.916\)으로, 이전 \(0.912\) 구성보다 \(0.004\) 높았다. 분열 단계 변경은 나중에 정한 동점 범위를 넘는 차이를 냈지만 두 모델을 섞은 효과는 구분되지 않았다. 로컬 이득은 \(0.001\) 미만이었고, 비슷한 크기의 로컬 이득을 낸 간선 수정은 Public 표시 점수를 바꾸지 못했다(7절). 분열 실험을 더 해 볼 단서는 됐지만, 이 한 쌍으로 로컬 이득의 전달률을 구할 수는 없었다. 데이터 분포와 그래프 상호작용, 간선 항 변화의 영향도 분리하지 못했다.
세 번째 시드는 다양성이 있었고(승격된 두 모델과의 OOF 점수 상관 약 \(0.69\), \(0.84\)) 단독으로도 양수였지만, 3-seed ensemble은 2-seed보다 낮았다. 폴드마다 action fraction을 세 가지로 다르게 골랐고, 그 폭은 거의 세 배였다. 이는 선택한 규칙의 안정성을 점검할 이유였다.
7. 수정을 어디에 적용하느냐: 최적화기 앞인가 뒤인가
4절과 5절에서는 수정 뒤의 후처리가 결과를 뒤집는 사례가 있었다. 최적화기 앞에 넣은 첫 temporal-flow 정책은 adjusted-edge에서 \(+0.000365\)를 얻었지만, 참 분열 하나가 거짓 분열로 바뀌었다. 가중치를 적용한 분열 손실 \(-0.000153\)이 간선 이득의 \(42\%\)를 상쇄했다. 그래서 수정 효과가 파이프라인의 적용 위치에 따라 달라지는지 시험했다. 최적화기를 \(\Pi\)라고 쓰면 다음과 같다.
\[\Delta S\!\left(\Pi\circ R\right) \ne \Delta S\!\left(R\circ \Pi\right).\]candidate-proposal 모델의 같은 가중치에서 나온 제안을 두 위치에 넣었다. 완성된 그래프에 넣으면 \(+0.0000506\), 최적화기 전에 점 집합에 추가하면 프레임당 \(0.50\)개 예산에서 \(+0.0006748\)로 약 \(13\)배였다. 다만 두 구성의 예산이 달라 위치만의 인과 효과는 아니다. 예산을 0으로 두었을 때 기준 그래프가 재현되고 간선 확률의 최대 차이가 \(5.96\times10^{-8}\)였다는 점은 구현의 일관성을 확인한다. 예산 차이까지 통제해 주지는 않는다.
예산을 늘리자 합산 이득은 커졌지만, 모든 폴드가 함께 좋아지지는 않았다.
| 예산(프레임당 노드) | 변화 | 폴드 |
|---|---|---|
| 0.10 | +0.0000776 | 두 개 음수 |
| 0.25 | +0.0002702 | 한 개 음수 |
| 0.50 | +0.0006748 | 네 개 모두 양수 (승격) |
| 0.75 | +0.0011047 | 네 개 모두 0 이상 |
| 1.00 | +0.0012498 | 한 폴드가 -0.0006285 |
합산 결과는 예산이 커질수록 단조롭게 늘지만, 폴드별로 보면 그렇지 않다. 세 번째 분열 시드와 같은 모습이다.
다른 적용 위치 비교에서는 기준 그래프도 달랐다. track-fragment matcher는 최적화기 뒤에서 간선 교체 \(3{,}224\)건으로 \(+0.0006325\)를 얻어 모든 게이트를 통과했고, hidden test에서 안전하게 돌도록 만든 버전의 sanity check는 matcher를 더하기 전 설정과 같은 \(0.912\)였다. 동점이고, 실패는 보이지 않았다. 같은 matcher를 최적화기 앞으로 옮기자 outer cross-fit은 \(+0.0000178\)로 0과 구분되지 않았다(두 수치는 노드 재현율이 약 6포인트 다른 기준 그래프에서 잰 것이라 비율로 비교할 수 없다). 5절의 분열 hyperedge는 앞으로 옮겨도 효과가 없었다.
최적화기 전에 노드를 넣으면 최적화기가 고를 수 있는 후보가 늘어난다. 이 점이 해당 구성을 시험한 이유였다. 그러나 간선과 분열 실험은 기준 그래프·예산·후속 필터가 서로 달랐으므로, 어느 적용 위치가 보편적으로 낫다고 정리할 수는 없다.
8. 구조적 승인을 hidden test에서 확인하기: 점수 없는 제출 일곱 번
pre-solver activation(최적화기가 돌기 전에 제안된 점을 추가하는 것)은 7절의 로컬 구성 평가를 통과했다. 다음 질문은 어느 예산이 처음 보는 배아에서도 살아남느냐였다. 후보 다섯 개가 모두 점수를 받지 못했다. 처음 두 개는 hidden test 데이터에서 처리되지 않은 오류로 실패했고, 나머지 세 개는 실행은 끝났지만 점수가 나오지 않았다.
점검해 보니 hidden test 데이터에서만 터질 수 있는 결정론적 실패 경로가 다섯 개 있었다. 처음 보는 배아 prefix에서 나는 key error부터, 마지막으로 검출된 노드로 영상 길이를 추정하는 코드까지였고, 학습 영상의 사본인 공개 예시 영상에서는 하나도 드러나지 않았다. 다섯 개를 모두 고치고 예산 두 개를 다시 제출했지만 둘 다 이번에도 실행만 끝나고 점수는 나오지 않았다. 7월 말까지 점수 없는 제출이 일곱 번이었다.
고친 버전의 출력은 내가 볼 수 있는 모든 영상에서 유효했으므로, 실행 시간을 남은 가설로 보았다. 공개 예시 영상 4편만 돌려도 약 \(65\)분이 걸렸고, 그중 약 \(30\)분이 4-fold proposal 추론이었다. 이 비용은 hidden test 영상 수가 늘수록 커진다(산술로 한 추정이고, 따로 떼어 잰 값은 아니다). 다음 배포에서는 proposal 추론을 영상당 모델 하나로 줄일 계획이다.
1
2
3
4
OOF 검증이 묻는 것: 이 정책이 held-out 데이터에서 더 나은가?
hidden test가 함께 묻는 것: 처음 보는 배아에서 나온, 몇 편인지 모르는 영상을
12시간 안에 끝까지 처리할 수 있는가?
두 번째 질문에는 거부권이 있다.
여기서 C6가 나왔다. 후보는 hidden test에서 제한 시간 안에 실행을 마쳐야 한다.
9. 승인을 비교하기 전에: 각각 무엇을 기준으로 잰 값인가
승인 네 개의 순위를 매기려면 공통 기준이 필요하다. 7월 말에는 영상 \(199\)편으로 만든 로컬 기준 그래프 일곱 개를 한 번도 서로 맞춰 보지 않은 채 동시에 쓰고 있었다. \(0.6006730\), \(0.6529429\), \(0.6996400\), \(0.7255533\), \(0.7347169\), \(0.7395609\), \(0.7405959\)이고, 노드 재현율은 대략 \(0.880\)에서 \(0.948\)까지 퍼져 있다. 이만큼 떨어진 그래프에서는 같은 수정이라도 분모가 다르다. 또 약한 그래프일수록 고칠 망가진 구조가 많아서, 그 위에서 잰 수정이 더 유리할 수 있다. 그러나 모든 수정에 그런 방향이 보장되는 것은 아니다.
| 승격한 정책 | 측정한 변화 | 측정에 쓴 기준 그래프 |
|---|---|---|
| edge replacement, nested 5-fold | +0.0002706 | 0.6529429 |
| track-fragment matcher, 최적화기 뒤 | +0.0006325 | 0.6006730 |
| strict-division rank ensemble | +0.000949 | 0.7255533 |
| pre-solver candidate activation, 프레임당 0.50 | +0.0006748 | 0.7405959 |
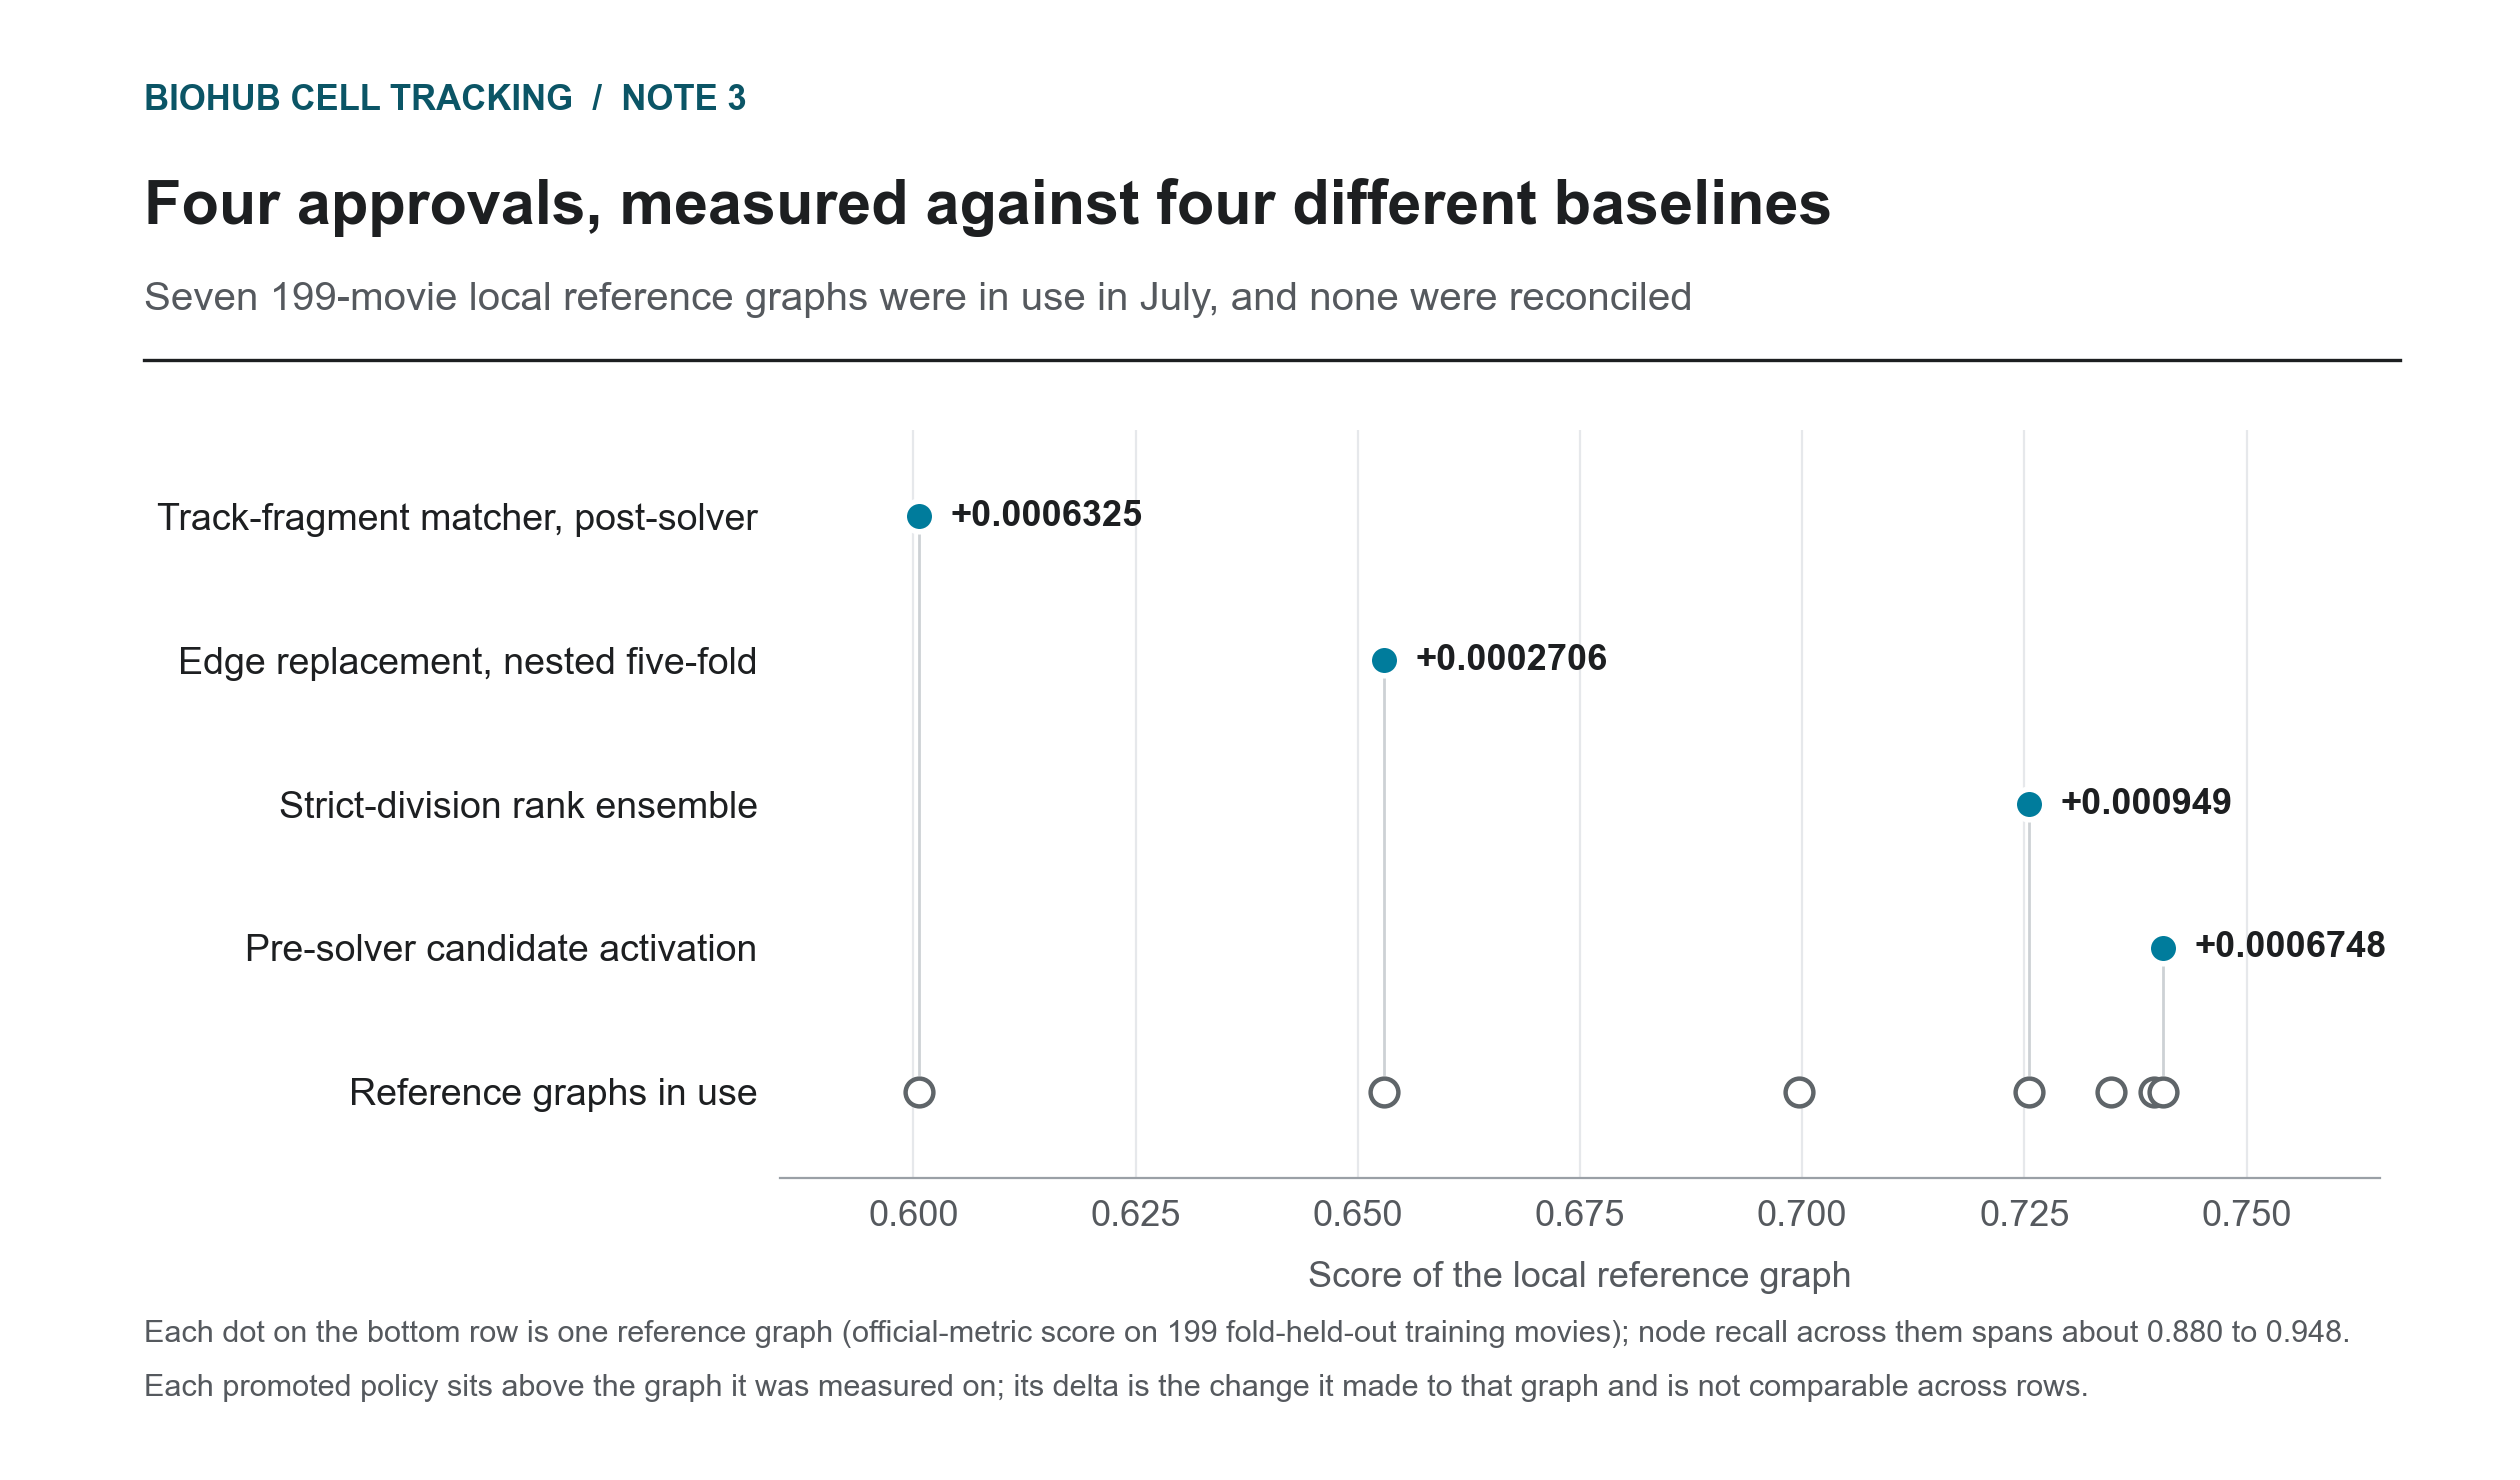 그림 1. 7월에 승격한 정책은 저마다 다른 영상 199편 로컬 기준 그래프에서 측정했다. 변화량은 각자의 기준 그래프에 대한 값이므로 네 정책을 서로 순위 매길 수 없다.
fragment matcher의 수치만 가장 약한 그래프에서 쟀고, 데이터로는 정책 품질과 기준 그래프 선택의 효과를 가를 수 없다. 여기서 C5가 나왔다. 절대 점수뿐 아니라 변화량에도 대조군을 붙여야 한다. 기준 그래프와 개입이 다른 변화량으로 정책의 우열을 매길 수는 없다.
backbone 예측은 두 배아를 나눠 만들었다. 반면 위 정책들의 평가는 영상 단위로 나눴고, 각 폴드에 두 배아의 영상이 모두 들어 있었다. 실행 시간 기록도 부족해서 다음 비교에 필요한 시간을 잡기 어려웠다.
마무리
7월에 얻은 것은 구체적인 실패 원인이었다. 학습 자료를 나눈 selector도 보정에 쓴 후보와 다른 집단에 적용되면 실패할 수 있었다. 부모를 더 잘 골라도 pruning과 recovery를 거치며 점수가 내려갔다. 최종 제출과 다른 기준 그래프에서 측정한 이득은 그 기준에 의존했다.
가장 큰 비교 문제는 아직 하나로 맞추지 못한 기준 그래프 일곱 개였다. Public에서는 분열 변경을 제한적으로 확인했지만, 점수가 없는 일곱 제출로는 노드 삽입 후보의 hidden test 성능을 알 수 없었다. 다음 배포에서는 proposal 추론을 영상당 모델 하나로 줄일 계획이었다. 로컬 이득끼리 비교하려면 공통 replay 기준도 필요했다.
판단 기록·기준의 변화·남은 질문
아래 표는 당시의 결정이며, 선택 기준은 이후 검토까지 반영해 정리했다. 각 결론의 범위는 시험한 구성에 한정된다. 구성 하나의 실패로 모델 계열 전체를 기각하지는 않는다.
10. 판단 기록
후보는 07-15에 적은 규칙으로 판정했다. 정확한 점수 변화가 기준선을 넘을 것, 두 배아와 모든 outer 폴드에서 음수가 아닐 것, 수정 개수가 제한 안에 있을 것, 학습·보정·평가를 서로 겹치지 않는 영상에서 할 것. 채점된 제출 \(109\)건에서 리더보드는 OOF 검증이 아직 물을 수 없던 질문, 무엇보다 어떤 점이 존재하느냐에 답했고, 로컬 판정의 sanity check 역할도 했다.
| 판단 | 당시의 이유 | 결과 | 바뀐 것 |
|---|---|---|---|
| 07-15: 결과가 나오기 전에 게이트와 예산을 적어 둠 | 결과를 본 뒤 기준을 정하면 그 결과에 맞추기 쉽다 | 미리 정한 근거로 아홉 번 기각, 예산은 관리되지 않음 | C2 |
| 07-17: 그래프 처리 단계를 OOF에서 그대로 replay | 무엇이든 바꾸기 전에 held-out 가치부터 알아야 한다 | +0.052187, 양 끝이 모두 매칭되지 않은 간선 FN 11,020개 | 계획의 방향을 어떤 점이 존재하느냐로 돌림 |
| 07-20~07-25: 2-seed와 검출 맵 질문을 리더보드에 물음 | OOF 검증은 점 집합을 고정해 둠, 2편에서 2-seed 질문이 남아 있었음 | 혼합 0.905–0.909, 검출 맵 평균 0.911, ablation 0.910 | 검출 맵은 당분간 리더보드로, 간선 가중치 조정은 OOF 검증으로 |
| 선택 모델, flow 조건, parent matcher, proposal ensemble 기각 | 실행 전에 적어 둔 게이트 | 작동 비율 26.7×, 부호 반전, parent 지표 개선과 그래프 성능의 불일치, probe 0.004 낮음 | C3, C4 |
| 07-28: 분열 ensemble을 single-seed 대조군과 함께 제출 | 분열 쪽 첫 승인(+0.000949, 폴드 4/4), sanity check | 둘 다 0.916, +0.004 | 관찰: 이 분열 구성의 Public 변화가 로컬 변화보다 컸음 |
| 07-30/31: pre-solver activation을 여러 예산으로 제출 | 가장 강한 구조적 결과, sanity check | 제출 일곱 번, 점수 없음 | C6 |
| 변화량마다 기준 그래프를 함께 기록 | 변화량은 바꾸는 그래프에 따라 달라진다 | 기준 그래프 일곱 개, 승인 간 순위 불가 | C5 |
이 기간이 끝났을 때의 선택 기준
| 조항 | 내용 | 도입 |
|---|---|---|
| C1 | 학습·보정·평가의 의존 관계를 분리하고 그래프 전체를 채점한다. 영상 분리만으로 배아 독립성이 보장되지는 않는다 | 2편 |
| C2 (신규) | 게이트는 결과를 보기 전에 정해 둔다 | 3편(07-15) |
| C3 (신규) | 규칙은 실제로 적용될 모집단에서 보정한다 | 3편 |
| C4 (신규) | 구성 요소는 자체 정확도가 아니라, 파이프라인을 그대로 재현해 만든 그래프로 평가한다 | 3편 |
| C5 (신규) | 점수와 변화량에 대조군을 함께 기록한다. 다른 replay의 변화량으로 우열을 매기지 않는다 | 3편 |
| C6 (신규) | 후보는 hidden test에서 제한 시간 안에 실행을 마쳐야 한다 | 3편 |
11. 이 기간에 확인된 것
확인된 사실
- 결정론적 그래프 처리 단계를 held-out 예측 위에서 그대로 replay하면 모델 원본 그래프보다 \(+0.052187\) 높다.
- 간선 FN 잔여 오류의 상당 부분은 association으로는 닿을 수 없다. 약 \(25{,}150\)개 가운데 \(11{,}020\)개는 양 끝이 모두 매칭되지 않았다.
- 엄격하게 out-of-fold인 선택 모델도 모집단 때문에 실패할 수 있다. 작동 비율이 보정 모집단에서는 \(0.204\%\), 배포 모집단에서는 \(5.456\%\)였다.
- 구성 요소 지표와 그래프 점수는 다를 수 있다. parent top-1 개선 뒤에 한 번은 그래프 점수가 내려갔고, 다른 한 번은 전체 이득이 있어도 한 폴드와 한 배아가 손실이었다.
- 시험한 노드 복원 구성 세 개는 노드 재현율을 올리면서 공식 점수를 낮췄다.
- 시험한 hyperedge 구성에서는 최적화기가 선택한 분기가 늘어도 후속 필터를 거친 분열 집계는 바뀌지 않았다.
- 분열 항은 거의 쓰이지 않고 있다. 가중치 \(0.1\) 가운데 \(0.00046\)만 채웠고, 그래프에는 주석된 분열 \(151\)개에 비해 분기가 \(12{,}794\)개나 있었다.
- 시험한 최적화기 전 구성은 후 구성보다 약 \(13\)배 큰 이득을 냈지만, 예산도 달라 적용 위치만의 효과로 볼 수 없다.
- 게이트를 모두 통과한 정책도 리더보드에서 아무것도 돌려받지 못할 수 있다. 제출 일곱 번에 점수가 한 번도 나오지 않았다.
근거는 있지만 아직 확정하지 못한 판단
- 이 기간에는 검출 맵이 다음 탐색 대상으로 더 유망해 보였다.
- 리더보드는 분열 쪽 변화를 잡았지만, 로컬에서 비슷한 크기로 승격한 간선 쪽 변경은 잡지 못했다. ensemble과 대조군이 둘 다 \(0.916\)이었고, fragment matcher(\(+0.0006325\))는 바탕 설정과 같은 점수였다.
- 분류 품질과 개입 효용은 다르다. 근거는 실행 한 번과 \(7\times10^{-6}\)의 차이다.
- 평균 변화량과 함께 폴드별 설정의 안정성을 살펴볼 수 있다. 어느 선택 기준이 더 우수한지는 이 기간에 검증하지 못했다.
- 매칭을 고정한 간선 추가 계산의 손익분기 precision은 \(p^{*}=0.422315\)였다. 노드와 그래프 구조까지 바꾸는 수정에는 추가 효과를 반영해야 한다.
열린 질문
- 모델 학습과 정책 학습·보정에서 평가 배아를 모두 제외해도 이득이 남는가?
- 로컬 기준 그래프 일곱 개를 하나의 replay 환경으로 맞출 수 있는가?
- 로컬 변화량과 리더보드 변화량은 경로별로 어떤 관계인가? 점 하나가 아니라 여러 개로 확인할 수 있는가?
- 양 끝이 모두 매칭되지 않은 잔여 오류는 검출기를 바꿔서 줄일 수 있기는 한가?
- 정책을 제안하기 전에 그 정책의 추론 예산을 숫자로 말할 수 있는가?
시리즈: