BioHub Cell Tracking 작업 기록 4: 로컬 검증에서 발견한 세 가지 빈틈
시리즈 안내와 참고 링크
관련 공개 노트북
시리즈 소개. BioHub는 3D 현미경 영상에서 세포의 lineage graph를 복원하는 대회다. 라벨이 있는 학습 자료는 두 배아에서 촬영한 영상 199편이며, hidden test의 29%는 Public, 나머지 71%는 Private 점수에 반영된다. hidden test는 학습에 쓰이지 않은 배아에서 나온다. 각 편은 해당 기간의 기록을 따라가며, 나중에 확인한 사실과 회고는 따로 표시했다.
나중에 확인한 내용 — 2026-09-23. +0.0144와 +0.0313이 두 배아가 섞인 정책 폴드에서 나왔음을 명시한 것은 9월 2일 점검이다. 3절은 그 결과를 바탕으로 폴드 구성과 8월의 규약 변경을 설명한다. Public은 9월 5–6일의 기준을 적용해 ±0.002 이내를 동점으로, 약 0.003 이상의 차이를 조사할 신호로 읽었다.
7월에는 기준 그래프 일곱 개를 하나로 정리하지 못했다. 8월의 기록에는 로컬 검증의 빈틈 세 가지가 남았다. 역방향 association 제출은 예상 \(0.918\)에 못 미친 \(0.913\)이었고, 별도 조합은 두 배아가 섞인 폴드를 썼으며, 검출 진단은 제출 모델이 이미 학습한 영상에서 쟀다. 폴드 구성과 해당 결과의 관계를 확인한 시점은 위 상자에 적었다. 혼합 폴드와 hold-in 진단 어느 쪽도 첫 Public 결과를 설명해 주지는 못했다.
이 경험은 근거에 묻는 질문을 바꿨다. 완성된 파이프라인끼리 조건을 맞춰 비교하고, 테스트에서 달라질 배아를 통째로 제외하며, 진단에 사용한 모델이 어떤 자료로 학습되었는지 거슬러 확인해야 했다. 이 글에는 Public 사용 원칙이 엄격해지기 전, 8월 초에 낸 28건의 제출도 그대로 남겼다.
0. 로컬 수치가 재는 것과 Public을 읽는 방법
이 글의 로컬 수치는 거의 모두 research replay에서 나온다. 학습 영상 199편을 각각 다른 배아로 학습한 폴드 모델로 예측하고, 그래프 구성 과정 전체를 다시 돌린 다음, 7월에 수정된 공식 평가지표로 채점한다. 검출·association backbone의 학습은 배아별로 나눴으며, 여기서는 이 분할을 embryo-out이라고 부른다. 3절에서는 그 분할과 후속 정책 폴드·gating 모델의 학습을 구분한다. movie-out은 영상만 나누므로 같은 배아의 다른 영상이 학습에 들어간다.
replay의 기준 점수는 \(0.74\) 부근이고, 199편 전체로 학습한 제출 파이프라인은 Public에서 \(0.9\) 부근이다. 3편의 기준 그래프 일곱 개(\(0.60\)~\(0.74\))도 아직 하나로 정리되지 않았으므로, 비교는 한 환경 안의 변화량으로만 하고 환경이 다른 점수끼리 수준을 비교하지 않는다.
연결 점수 맵은 연속한 두 프레임의 세포 사이에 놓일 수 있는 후보 간선마다 점수를 매긴다. 분기(fork)는 다음 프레임의 후속 노드가 두 개인 예측 세포이고, 채점기는 추가적인 매칭·구조 조건을 적용해 참 분열 또는 거짓 분열로 셀지를 정한다. 분열 단계(division stage)는 track이 어디서 두 딸세포로 갈라지는지 정하는 학습 모델로, 점수에서 가중치 \(0.1\)을 받는 분열 항에 반영된다. action budget은 이 단계가 추가할 수 있는 분열의 수나 비율을 제한한다. 아래의 소수 값은 비율로 정한 action budget이다.
08-01 시점의 기준 제출본은 정방향 association graph에 학습된 분열 단계를 붙인 버전이었고, Public 점수는 \(0.916\)이었다. Public은 소수 셋째 자리까지 표시한다. 이 회고에서는 9월에 도입한 판단 규칙을 적용해 \(\pm 0.002\) 이내를 동점으로 읽는다. 이 범위는 표시 반올림보다 넓으며, 통계적 동등성을 뜻하지 않는다.
1. Public을 분열 단계에 먼저 쓴 이유
7월의 분열 ensemble은 로컬에서 \(+0.000949\), Public에서 \(+0.004\)였다. 이를 근거로 분열 단계의 비교를 더 해 보기로 했다. 다만 로컬 이득을 Public 이득으로 환산할 수 있는 결과는 아니었다. 8월 초에는 분열 적용량과 두 모델의 가중치, 구성 방식을 바꿔 제출했다. 아래의 대조군 비교는 그 제출들이 무엇을 구분할 수 있었는지 보여 준다.
8월 첫 닷새 동안 제출은 28건이었다. 08-01(KST)에 낸 3건은 점수 없이 돌아왔고(6.1절), 25건은 포트폴리오 다섯 개로 나눠 냈다. 넷은 분열 단계를 살폈고, 08-03의 하나는 처음부터 sanity check(로컬 판단을 처음 보는 배아에서 확인하는 Public 제출)로 설계한 실험이었다(2절). 남은 11일 동안은 2건만 냈다.
| 날짜(UTC) | 포트폴리오 | Public |
|---|---|---|
| 08-01, 08-02 | 분열 단계 주변 변형, 구성 10개 | 0.910 ~ 0.916 |
| 08-03 | 연결 점수 맵 대 분열 단계, 구성 5개 | 0.917 / 0.913 / 0.912 / 0.919 / 0.920 |
| 08-04 | 분열 수정 개수 상한, 구성 5개 | 0.920 / 0.919 / 0.910 / 0.919 / 0.919 |
| 08-05 | 분열 순위 점수의 가중치와 구조 변경 구성 3개 | 0.921 / 0.918 / 0.920 / 0.919 / 0.919 |
08-01과 08-02의 구성 중 기준 제출본보다 높게 나온 것은 없었고, 셋은 0.005~0.006 낮았다. 08-04에는 적용량을 가장 작게 잡은 구성이 \(0.910\)으로 떨어졌고, 나머지는 동점이었다. 08-05는 다섯 개 모두 동점이었다. 그중 두 분열 모델의 가중치를 조정한 \(0.921\) 구성이, 미리 적어 둔 sweep에서 로컬 점수가 근소하게 앞서 새 기준 제출본이 됐다.
조건을 맞춘 비교에서는 분열 단계를 더했을 때의 변화가 주변 설정을 바꿨을 때보다 컸다. 08-10에는 C9을 정했다. 후보는 fold-pure OOF 근거로 고르고, Public에서는 조건을 맞춘 후보를 미리 적어 둔 기대치와 비교한다. 당시 규약의 표현대로, Public은 target-domain feedback이지 parameter optimizer가 아니었다.
2. 역방향 association 제출은 기대치에 못 미쳤다
2.1 시간 역방향의 연결 점수도 함께 쓰기
association 모델은 후보 간선마다 한 세포에서 다음 프레임의 후속 세포 쪽으로 정방향 점수를 매긴다. 같은 네트워크로 역방향 점수도 낼 수 있다. 가설은 그래프를 만들기 전에 두 방향의 점수를 조화 평균으로 합치면 한쪽 방향에서만 지지받는 간선이 불이익을 받는다는 것이었다. 199편 exact replay 전에 합성 방식 후보 네 개를 정해 뒀고, 네 개 모두 점수를 올렸다(\(+0.0033659\)~\(+0.0073273\)). 아래 표는 라벨이 있는 영상에서 고른 네 후보 중 최고값이다. 역방향 가중치 \(0.20\)의 조화 평균 합성으로, 16편 probe에서도 가장 강했다. 비교 대상은 학습된 분열 단계가 없는 정방향 파이프라인이다.
| 항목 | 정방향 기준 | 조화 평균 역방향 합성 | 변화량 |
|---|---|---|---|
| 공식 점수(수정판) | 0.7401015 | 0.7474288 | +0.0073273 |
| adjusted edge Jaccard | — | — | +0.0073683 |
| 노드 재현율 | — | — | +0.0172533 |
| division Jaccard | — | — | -0.0004099 |
영상 119편이 좋아지고 80편이 나빠졌다. 두 배아 모두 올랐고, 71편짜리 배아는 \(+0.0194505\), 128편짜리 배아는 \(+0.0057244\)였다.
이 연결 점수 맵을 단독으로 승격하지는 않았다. 잘못된 분기가 \(24\)개 늘었고(\(563 \to 587\)) 진짜 분열은 하나도 늘지 않았다. 분기가 자유롭게 생기는 그래프 구성기에서는 연결 점수 맵이 좋아지면 분열도 덩달아 만들어진다. 사후 보호 장치는 통하지 않았다. 완성된 역방향 그래프의 분기를 사후에 걸러 내자 division Jaccard가 0이 됐다. 분열 수정 후보는 그래프에 종속되므로, 저장해 둔 \(999\)개 중 새 그래프에서도 유효한 것은 \(29\)개였다. 후속 실험에서는 모든 분기를 가장 좋은 연속 경로 하나로 접고, 두 번째 딸세포를 다시 넣을 권한은 3편의 분열 이벤트 모델에만 줬다. 분열 거짓 양성이 \(587\)개에서 \(67\)개로 줄었고 간선 이득은 \(99.30\%\)가 유지됐다. 이 조합은 정방향 기준보다 \(+0.0106431\) 높아 승격됐다. 연결 점수 맵이 \(+0.0073273\), 단순히 더하는 방식의 분열 단계가 \(+0.0010142\), 더 큰 수정 개수 상한에서 분기 대체 방식이 약 \(+0.0023\)을 보탰다.
2.2 08-03의 sanity check
08-03 포트폴리오는 연결 점수 맵의 로컬 이득이 처음 보는 배아에서도 유지되는지 물었고, 두 연결 점수 맵 각각에 분열 단계를 붙이거나 뺀 구성을 뒀다. 세 구성에는 기대치를 미리 적어 뒀다. 역방향 연결 점수 맵 단독의 기대치는 \(0.918\)(구간 \(0.914\)~\(0.921\))이었고, 결과가 이 구간보다 낮으면 고정한 배포 구성은 기각하되 이 계열에 대한 replay 근거는 기각하지 않기로 했다.
| 구성 | 연결 점수 맵 | 학습된 분열 단계 | 기대치 | Public |
|---|---|---|---|---|
| 정방향 대조군(7월) | 정방향 | 없음 | — | 0.912 |
| 기준 제출본 | 정방향 | 추가 방식 | — | 0.916 |
| 역방향 연결 점수 맵 단독 | 역방향, 조화 평균 | 없음 | 0.918 | 0.913 |
| 선형 합성 단독 | 역방향, 선형 | 없음 | 0.917 | 0.912 |
| 역방향 연결 점수 맵 + 분열 단계 | 역방향, 조화 평균 | 추가 방식, 적용량 0.012 | 0.920 | 0.917 |
| 분기 접기 | 역방향, 조화 평균 | 분기 대체 방식, 적용량 0.024 | — | 0.919 |
| 분기 접기, 작은 적용량 | 역방향, 조화 평균 | 분기 대체 방식, 적용량 0.012 | — | 0.920 |
세 기대치 모두 0.003~0.005만큼 낮게 빗나갔다. 역방향 연결 점수 맵은 단독으로 약 0.006을 더할 것으로 예상했지만, 어느 파이프라인에서든 0.001을 더했다. 분열 단계는 어느 연결 점수 맵에서든 0.004를 더했고, replay는 그 효과를 0.001 정도로 봤었다. 같은 \(0.012\) 적용량에서 분열 단계를 분기 대체 방식으로 바꾸자 \(0.917\)이 \(0.920\)이 됐는데, 나중에 정한 Public 조사 기준선에 걸친 차이다. 적용량을 두 배로 늘리면 \(0.919\)로 동점이었다.
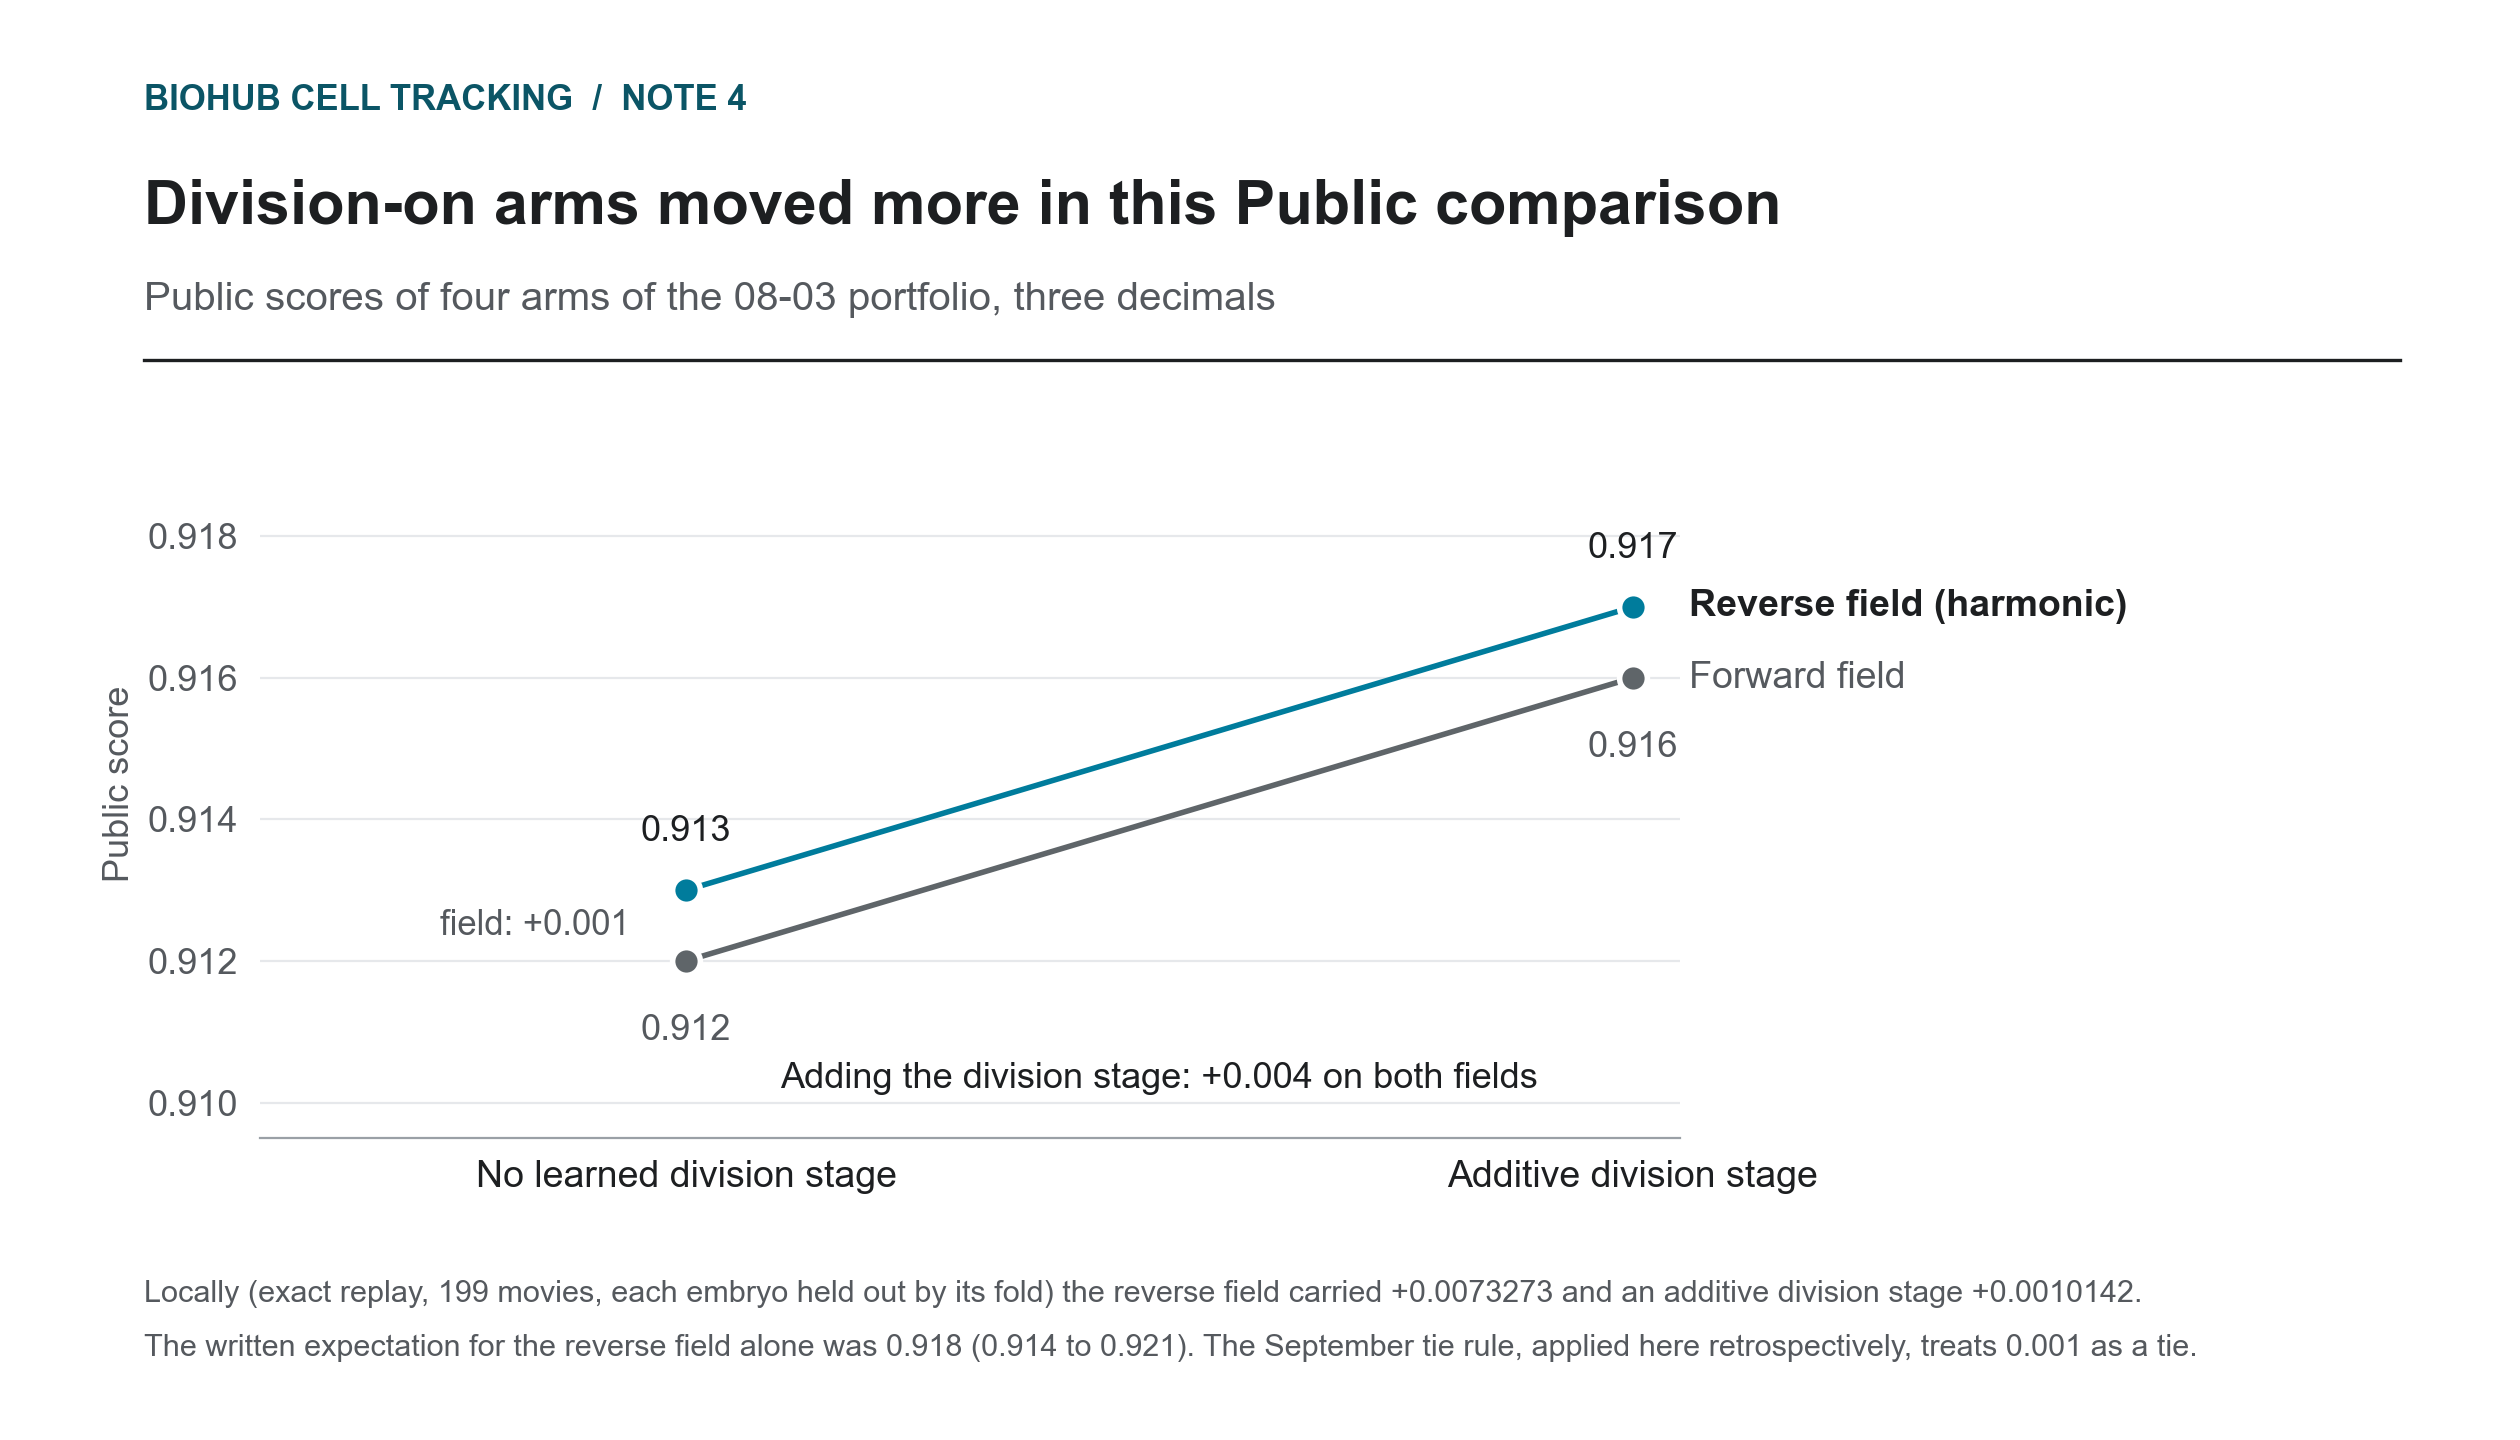 그림 1. 08-03 포트폴리오 구성 네 개의 Public 점수. 분열 단계를 붙이면 두 연결 점수 맵 모두 \(0.004\) 올랐고, 역방향 연결 점수 맵으로 바꾸면 어느 파이프라인이든 \(0.001\) 움직여 9월의 해석 규칙을 소급해 읽으면 동점이다. 로컬에서는 이득 대부분이 연결 점수 맵에서 나왔었다.
2.3 비교에서 확인한 것
이 비교에서는 역방향 association으로 바꾸는 것보다 분열 단계를 더했을 때의 패키지 효과가 컸다. Public 점수에는 간선과 분열 항이 함께 들어가므로, 어느 항에서 그 차이가 생겼는지는 구분할 수 없었다.
로컬 association 이득은 노드 재현율이 약 \(0.90\)인 폴드 모델의 그래프에 의존했을 가능성이 있다. 두 배아를 모두 학습한 제출 모델에는 같은 종류의 오류가 적어, 고칠 여지도 작았을 수 있다. 당시에는 가설로 남았다. 다음 절의 혼합 폴드 문제는 이 비교와 다른 조합에서 나온 결과다.
2.4 합산 점수보다 간선 이득의 보존율을 우선한 기준
08-04에는 joint association 모델 위에 분기 대체 방식 분열 단계를 얹은 비슷한 조합이 199편에서 \(+0.010205\)를 기록했다. 돌리기 전에 적어 둔 게이트가 이를 기각했다. 분기를 접으면 간선이 지워지므로, 합친 그래프는 association 단계의 adjusted-edge 이득을 \(95\%\) 이상 유지해야 했는데 \(91.82\%\)만 유지했다. 이 게이트는 점수가 아니라 한 항의 몫을 지켰고, 그래서 합계가 양수인 결과를 막았다. 3편에서 구성 요소에 대해 세운 조항 C4가 내가 만든 게이트에도 적용된 경우다.
3. 별도 조합의 큰 수치는 두 배아가 섞인 폴드에서 나왔다
이 2주 동안 가장 컸던 로컬 수치는 다른 replay에서 나왔고, Public까지 가지 않았다. 이 수치가 무엇을 쟀는지는 각 폴드에 어떤 배아가 들어 있었느냐에 달려 있다.
3.1 08-05의 첫 경고
08-05의 오류 해부(4.1절)에서, 라벨 없이 영상의 node 수를 예측하는 회귀 모델은 영상 단위 random 5-fold CV에서 \(R^2 = 0.471\)이었고, 배아 하나를 통째로 빼자 \(R^2\)가 \(0.125\)와 \(-0.269\)였다. 점검 기록은 이 차이를 within-embryo leakage라고 부르고 이렇게 결론지었다.
1
이 대회에서 영상 단위로 섞은 random fold는 쓸 수 있는 검증 방식이 아니다.
3.2 이 기간의 가장 큰 로컬 수치
08-06에는 여러 계열을 섞은 조합이 199편 exact replay를 마쳤다. 2-seed association anchor에 joint lineage-action 모델, 보조 center 검출기, appearance 특징을 섞고, 보조 모델들이 얼마나 개입할지는 authority weight \(a\) 하나로 조절하는 구성이다. \(a = 0.20\)에서 association 단계는 기준선 \(0.7405959\)보다 \(+0.014446\) 높았다. 위에 분기 대체 방식 분열 단계를 얹고 sweep하면, 코드에서 막아 둔 최댓값인 \(a = 0.50\)에서 \(+0.031335\), opt-in 플래그를 켠 \(a = 1.00\)에서는 \(+0.034692\)까지 올라갔다. 모든 조합이 모든 게이트를 통과했고, outer 폴드 네 개와 두 배아가 전부 양수였다. \(a = 0.20\)에서 71편짜리 배아는 \(+0.018084\), 128편짜리 배아는 \(+0.013709\) 올랐다.
이전 계열들에서 약한 쪽이던 71편짜리 배아가 이번에는 더 강한 쪽이었고, 08-06에는 이를 믿을 만한 근거로 보고 이렇게 적었다. “학습 데이터와 테스트 데이터는 배아가 겹치지 않으므로, 한 배아에 기대지 않게 된 계열은 일반화의 근거로서 더 나쁜 게 아니라 더 좋다.” 나흘 뒤 계획 문서는 이 조합을 측정된 이득으로 인용했고, 그 크기만큼 association 목표치를 잡았다.
3.3 실제 폴드의 구성
두 배아의 모든 영상을 각각 \(D_A\), \(D_B\)라고 하자. 2폴드 embryo-out은 \(D_A\)로 학습해 \(D_B\)를 평가한 뒤 두 역할을 바꾼다. 일반적으로는 각 폴드에서 학습과 평가에 등장하는 배아 집합이 겹치지 않아야 한다.
\[\operatorname{embryos}(D_{\mathrm{train},k}) \cap \operatorname{embryos}(D_{\mathrm{eval},k})=\varnothing.\]평가 폴드가 한 배아의 일부 영상만 담는 것으로는 부족하다. 같은 배아의 다른 영상이 학습에 남아 있으면 처음 보는 배아를 평가하는 조건이 아니다. 아래 식에서 \(D^{(p)}\)는 배아 \(p\)의 전체 영상을 뜻한다.
\(+0.0144\)와 \(+0.0313\)은 다음처럼 prefix별 균형을 맞춘 정책 폴드에서 나온 결과다.
\[D=\bigsqcup_k D_k, \qquad \forall k,\,p:\quad \left|D_k\cap D^{(p)}\right|\approx\frac{\left|D^{(p)}\right|}{4}.\]모든 폴드에 두 배아의 영상이 다 들어 있었다. movie-out이고, 이런 폴드로는 처음 보는 배아에서의 성능을 추정할 수 없다.
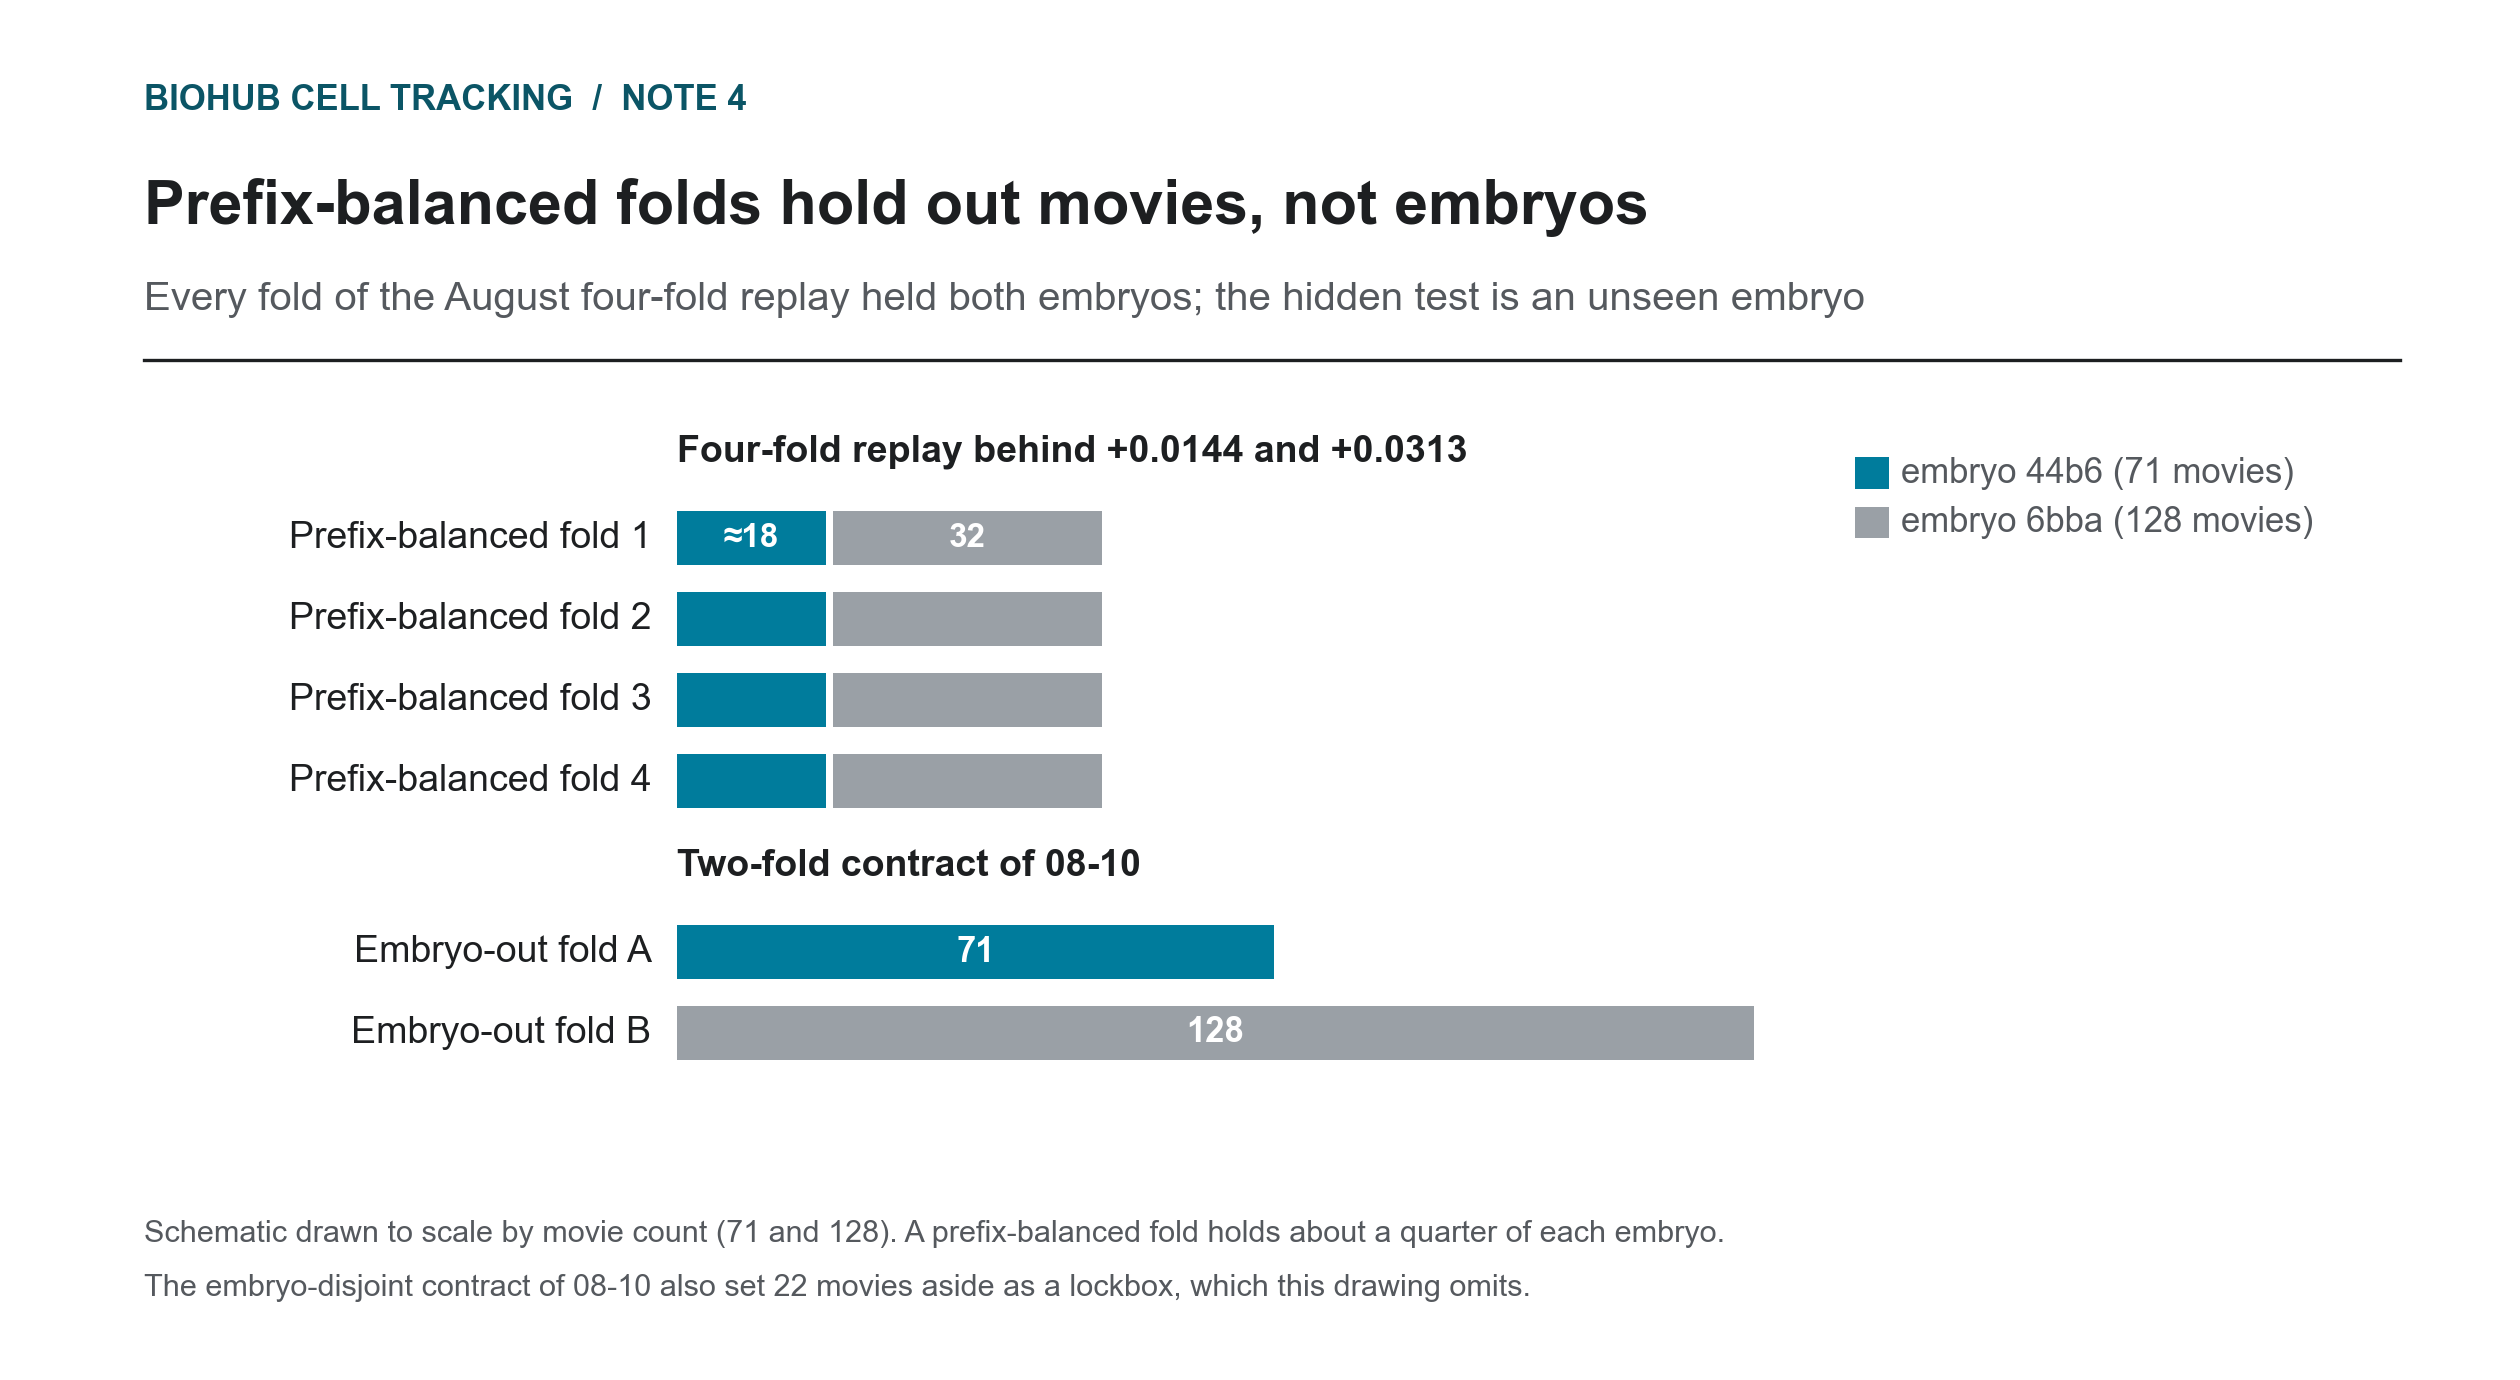 그림 2. 이 기간의 가장 큰 수치가 나온 4-fold replay는 폴드마다 두 배아를 고르게 나눠 담았다. 08-10에 고정한 평가 규약은 폴드마다 배아 하나를 통째로 뺀다.
각 정책 폴드는 평가할 배아의 다른 영상으로 학습했다. 두 prefix의 비율을 맞춰도 처음 보는 배아에 대한 평가가 되지는 않는다. 8월 6일의 설명은 backbone의 embryo-out 조건을 정책 분할까지 확인하지 않은 채 전체 조합에 적용한 셈이었다.
3.4 08-10 점검과 거기서 찾은 누수
08-10에는 평가 프로토콜 전체를 점검했다. OOF라는 성질은 임계값, 게이트, 적용량 설정까지 포함한 조합 전체가 갖춰야 한다는 원칙에서 출발했다. 점검에서 누수이 나왔다. 배포에 쓰던 gating 모델은 199편을 영상 단위 5-fold로 다시 나눠, 평가 배아의 다른 영상으로 학습했다. pre-solver activation의 임계값과 적용량 설정은 두 배아의 라벨을 모두 보면서 골랐다. lockbox는 문서에만 있었다. 이 점검으로 embryo-disjoint 2-fold 평가 규약을 고정했다. 개발용 영상 177편과, 한 번만 여는 lockbox 22편이다.
4-fold 결과는 새 규약 아래에서 격하했다. 당시 문구는 “해당 실험의 기록으로는 유효하지만, 이 규약 아래에서는 근거가 아니다”였다. 8월 12일에는 과거 4-fold checkpoint에 배아 prefix가 섞였다고 기록했다.
3.5 embryo-disjoint 규약으로 다시 돌린 결과
08-12에는 multi-frame parent-or-null 계열을 새 규약 아래에서 다시 학습하고 replay했다. 다섯 프레임 안에서 각 세포의 부모를 고르거나 부모가 없다고 판단하는 모델이고, 비교 기준은 177편 anchor(\(0.7428367161\))였다. 이 계열은 prefix별 균형 4-fold에서 \(+0.0133995\)를 냈고, 모든 폴드와 두 배아에서 양수였다. parent top-1은 올바른 부모를 받은 세포의 비율이다.
| 구성 (embryo-disjoint 규약) | adjusted-edge 변화량 | 구성 요소 지표 |
|---|---|---|
| multi-frame parent-or-null | +0.0001347503 | parent top-1 +0.0101 |
| 2단계: parent-or-null을 먼저 판단한 뒤 부모 선택 | +0.0004766233 | parent top-1 -0.156 |
숫자는 100분의 1 정도로 줄었지만, 재실행에서 바뀐 것은 폴드만이 아니었다. 분열 guard를 켜고 돌려 분열 변화량이 정확히 0이었고, \(+0.0133995\)는 guard 없이 나온 값으로 간선을 얻는 대신 분열에서 \(-0.0046489\)를 잃었다. 예전 폴드에서도 exact topology guard를 켜자 영상 11편에서 guard 없이 \(+0.0163060\)이던 값이 \(-0.0004684\)로 바뀌었다. 가망이 없어 중간에 멈춘 부분 실행이었다. 영상 수가 199편에서 177편으로 줄고 시드와 anchor도 달라졌으니, 이 두 결과로는 폴드 때문에 얼마나 부풀었는지 잴 수 없다. 폴드가 문제라는 판단은 폴드의 구성에 근거한다. 두 구성 모두 게이트를 통과하지 못해 이 구성의 후속 작업을 멈췄다.
\(+0.0144\)와 \(+0.0313\) 조합은 새 규약으로 다시 평가하지 않았다. 따라서 두 배아가 섞인 폴드에서 얻은 과거 측정값으로만 남겨야 한다. 배아를 통째로 제외했을 때의 효과는 아직 알 수 없었다.
3.6 누수이 있는 폴드의 숫자가 남기는 문제
문제는 이득을 크게 읽는 데서 그치지 않았다. 검증 조건이 정리되지 않은 수치를 “측정된 값”으로 부르고 다음 목표로 삼으면서, 그 숫자가 탐색 방향을 정했다. C7은 빠진 조건을 명시했다. 평가할 배아는 모든 학습 단계에서 제외해야 한다.
4. 검출 진단에 학습한 예시 영상을 사용했다
다음에 무엇을 시험할지는 점수가 어디에 묶여 있느냐에 달려 있다. 검출기가 찾지 못한 세포일 수도 있고, 찾은 세포들 사이의 연결일 수도 있다. 한 주 사이에 서로 다른 영상에서 잰 두 측정이 정반대 방향을 가리켰다.
4.1 embryo-out replay에서 놓친 세포는 어디에 있었나
08-05에 199편 replay baseline을 대상으로 한 오류 해부에서 노드 재현율은 \(0.8983\)이었다. 라벨이 달린 세포 \(133{,}318\)개 중 \(119{,}759\)개가 \(7\,\mu\mathrm{m}\) 게이트 안에서 예측 노드와 매칭됐다. 게이트는 채점기가 예측과 정답을 짝짓는 반경이다. 놓친 \(13{,}559\)개는 이렇게 나뉜다.
| 구분 | 개수 | 비율 |
|---|---|---|
| 게이트 안에 예측 노드가 하나도 없음 | 13,457 | 99.25% |
| 게이트 안에 노드가 있지만 할당 경쟁에서 밀림 | 102 | 0.75% |
거리 분석은 단순한 매칭 문제라는 설명을 약화했다. 찾은 세포는 자기 노드에서 중앙값 \(2.24\,\mu\mathrm{m}\) 떨어져 있지만, 놓친 세포에서 가장 가까운 예측 노드까지는 중앙값 \(9.60\,\mu\mathrm{m}\)다. 세포 간격의 중앙값은 \(24.99\,\mu\mathrm{m}\)였다. 이 중앙값들만으로 가까운 노드가 다른 세포인지, 놓친 세포를 멀리 검출한 것인지는 알 수 없다. 개별 매칭을 살펴야 한다.
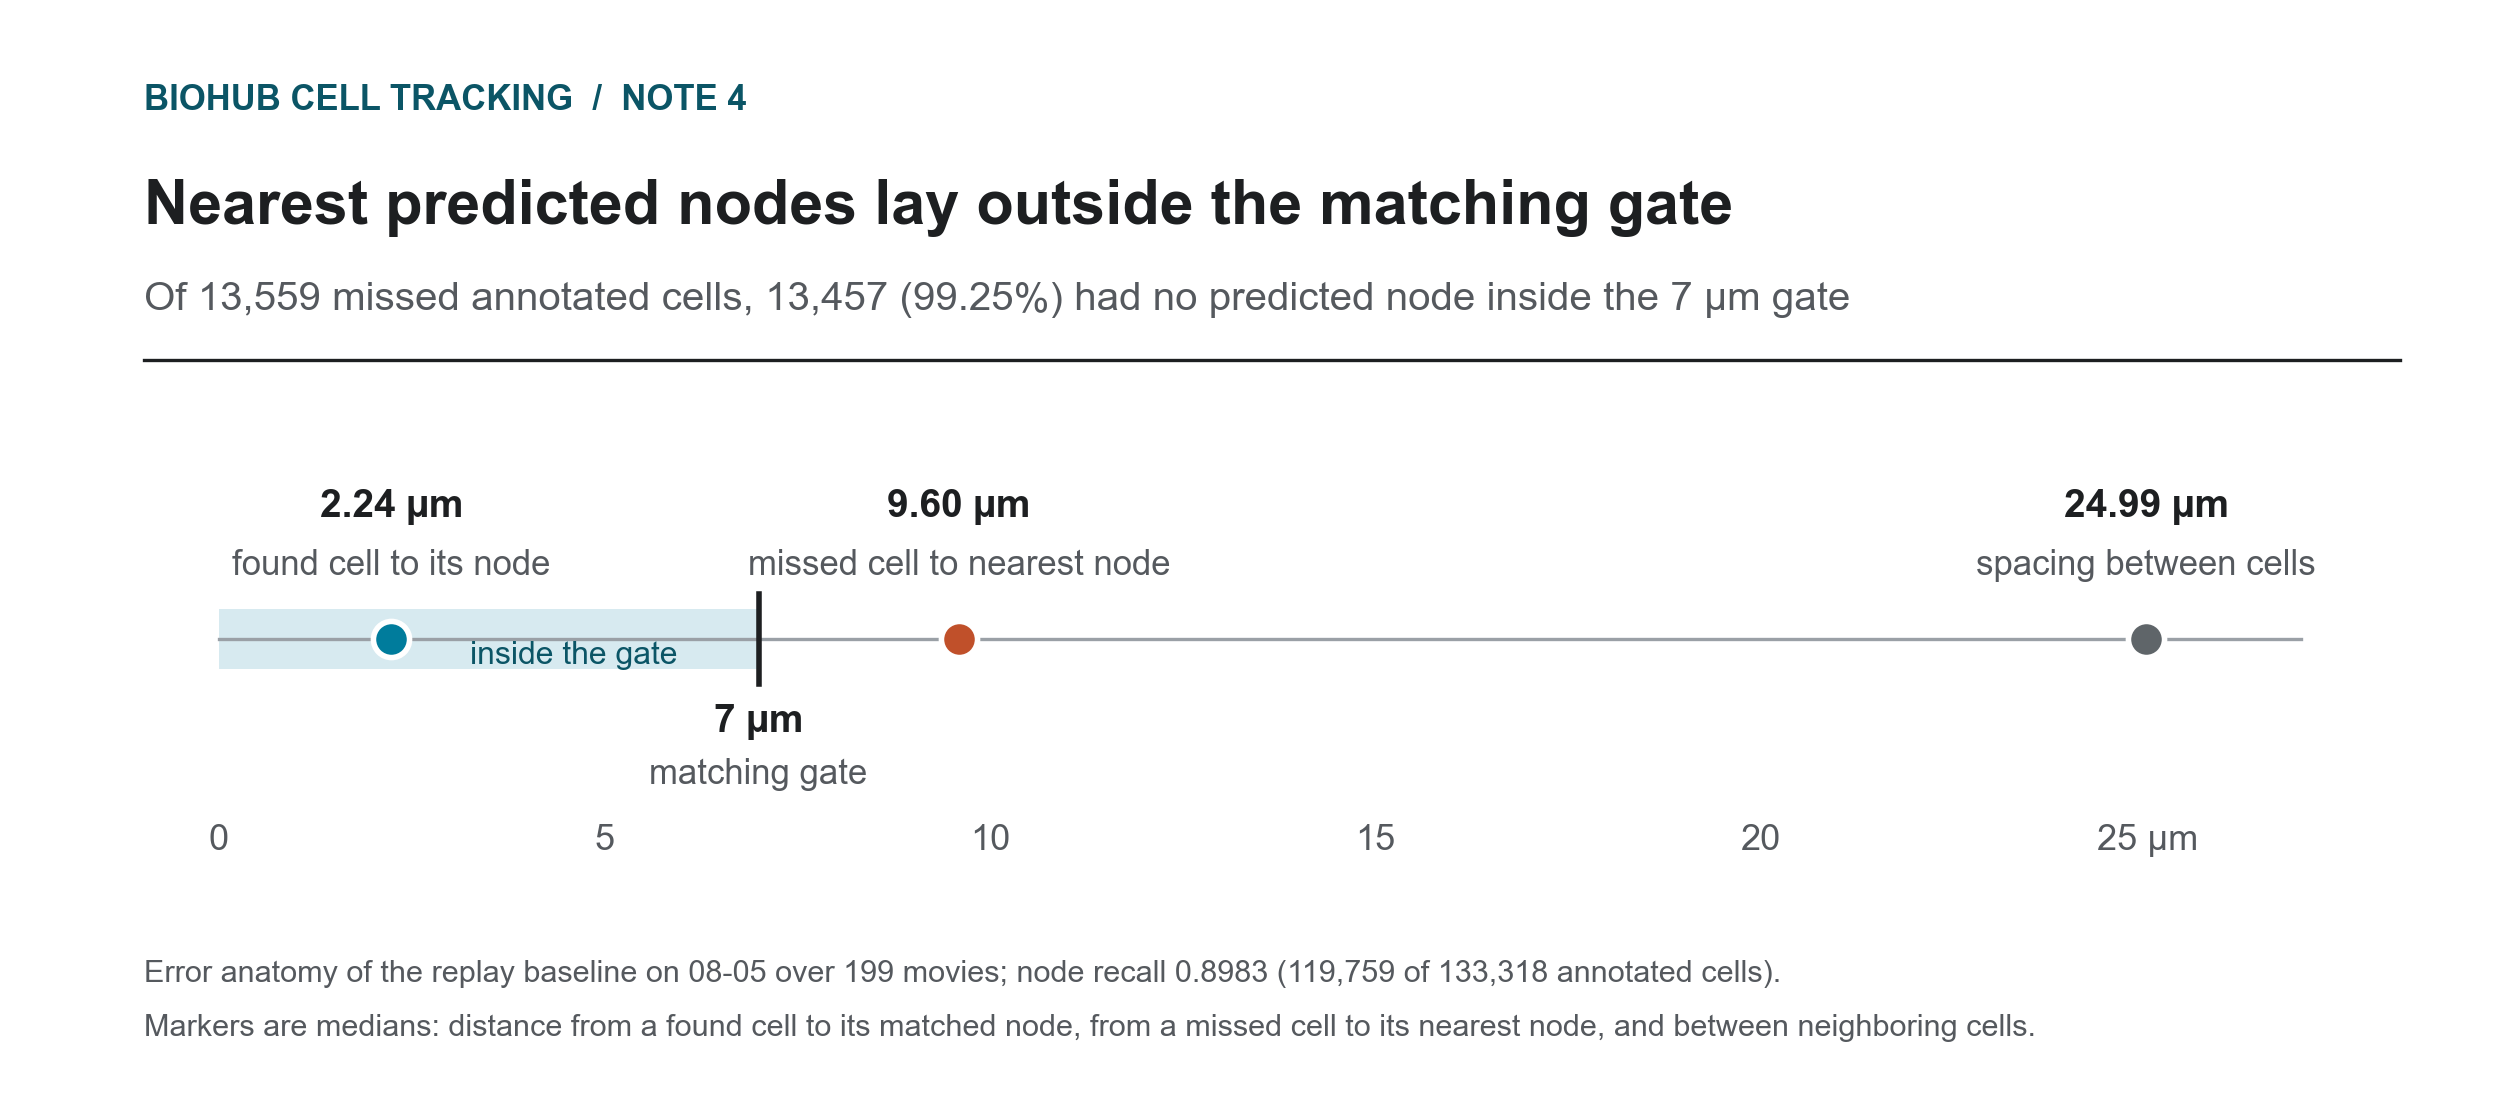 그림 3. 08-05 replay baseline 오류 해부에서 나온 중앙값. 놓친 세포에서 가장 가까운 예측 노드는 \(7\,\mu\mathrm{m}\) 게이트 밖, 중앙값 \(9.60\,\mu\mathrm{m}\) 거리에 있다. 거리만으로 그 노드가 어느 세포인지는 확정할 수 없다.
또 다른 설명은 세포가 빽빽한 곳에서 주로 놓친다는 것이었다. 간격이 가장 좁은 구간은 놓치는 비율이 \(23.0\%\)지만, 거기서 놓친 세포는 \(339\)개로 전체의 \(2.5\%\)에 그친다. 대부분의 놓친 세포에는 매칭 반경 안의 예측점이 없었다. 간선만 다시 배정해서는 없는 매칭 끝점을 만들 수 없다. 3편의 ‘어떤 점이 존재하는가’라는 질문에 숫자가 붙었다.
4.2 “검출은 병목이 아니다”와 그 철회
08-07에는 제출 파이프라인 점수 중 얼마가 검출에 막혀 있는지 association oracle로 쟀다. 예측 노드는 그대로 두고, 간선만 공식 매처로 투영한 정답 topology로 바꿔 다시 채점한다. 그래도 놓을 수 없는 간선은 끝점 하나가 검출되지 않은 간선이다. 대회에서 함께 배포한 라벨 있는 예시 영상 네 편에서 배포 그래프의 노드 재현율은 \(0.983\), 도달할 수 없는 정답 간선은 \(0.89\%\)였다. 검출은 병목이 아니고 검출기 재학습은 계산 자원을 쓸 가치가 없어 보였으며, 이에 따라 일정을 바꿨다.
08-08에 이 영상들을 확인해 보니 배포 모델의 학습에 쓰인 영상의 사본이었다. \(0.89\%\)는 모델이 이미 fit한 데이터에서 잰 hold-in 수치다. 같은 검출 계열의 embryo-out 가중치를 쓴 research replay에서도 이 진단을 했다.
| 조건 | 영상 수 | 도달할 수 없는 정답 간선 |
|---|---|---|
| 배포 그래프, hold-in | 4 | 0.89% |
| research replay, embryo-out | 같은 4편 | 8.79% |
| research replay, embryo-out | 199 | 12.10% |
embryo-out 199편에서 association이 완벽하면 replay 점수는 \(0.7346\)에서 \(0.9380\)으로 오른다. 이 고정 노드 집합에서 정답을 이용한 간선 교체로 약 \(+0.20\)을 얻었고, 정답 간선 여덟 개 중 하나 정도는 매칭된 끝점이 없었다. 실제로 학습할 수 있는 association 모델이 그 이득을 달성했다는 뜻은 아니다. 앞의 주장은 철회했고 일정 변경도 되돌렸다. 해석은 “association이 가장 큰 레버이고, 리더보드 상위권 근처에서는 아마 검출이 병목”으로 고쳤다. 그렇다면 Public이 채점하는 점수의 일부는 association 이득으로는 더할 수 없는 점들에 달려 있다. 2.3절과 마찬가지로 이것도 추론이다.
같은 네 편을 쓴 첫 두 행에서도 두 조건이 함께 바뀌었다. hold-in과 embryo-out이라는 학습 조건뿐 아니라, 배포 파이프라인과 research replay도 달랐다. 이 기간에는 두 효과를 분리할 비교를 하지 못했다. 배포 노트북을 측정한 것은 맞았지만, 학습한 예시 영상을 일반화의 근거로 쓸 수는 없었다(C8).
4.3 ablation 결과를 요약한 두 문장
08-08의 같은 검토에서, 3절 조합을 영상 34편에서 특징 계열별로 ablation한 결과의 헤드라인 두 개도 철회했다. temporal 계열을 빼면 “이득의 \(1.2\%\)만 남는다”는 문장과, 보조 center 검출기만 쓰면 “\(-17.2\%\)로 없느니만 못하다”는 문장이다. 둘 다 분열 항이 만든 착시였다. 대조군의 분열 참 양성이 \(TP = 2\), 거짓 양성이 89개인 상황에서는 분열 사건 하나가 가중치 \(0.1\)이 붙는 pooled division Jaccard \(TP/(TP+FP+FN)\)를 절반이나 움직여 간선 쪽 차이를 덮었다. 간선만 보면 두 수치는 \(13.0\%\)와 \(-4.6\%\)이고, 순위는 그대로였다.
5. 구성 요소가 아니라 그래프로 채점한다
공개된 pretrained cell-tracking representation을 parent 순위 모델로 바꾸고 embryo-out으로 측정했다. 한 배아에서 fit하고 다른 배아에서 평가하는 routing 정책이 세포마다 새 순위 모델과 기존 consensus 중 어느 쪽을 믿을지 정했다. parent top-1은 \(+0.008366\)(\(0.874241 \to 0.882607\)) 올랐고 held-out 배아 두 개에서 모두 양수였다. 177편 exact graph replay는 \(-0.002687\)이었고, 좋아진 영상이 \(69\)편, 나빠진 영상이 \(107\)편이었다.
완성된 그래프는 부모 결정이 아니라 \(\hat G = R_{\mathrm{gap}} \circ R_{\mathrm{prune}} \circ \Pi_{\mathrm{parent}}\)이고, short-component filter \(R_{\mathrm{prune}}\)은 \(\Pi_{\mathrm{parent}}\)가 만든 연결 구조 위에서 동작한다. 부모를 바꾸자 잘려 나갈 만큼 짧은 component가 살아남았고, gap recovery가 이를 더 길게 이어 붙였다. 그래프에 예측 노드가 \(9{,}357\)개 늘었고, 그중 정답 세포와 매칭된 것은 \(184\)개였다.
희소한 정답 parent label이 있는 교체 행에서 새 ranker는 기존 consensus보다 899건을 더 맞혔다. 부모 선택은 더 정확해졌지만, 후처리까지 거친 그래프 점수는 낮아졌다.
8월 10일, 이 graph replay를 근거로 해당 적용 방식을 중단했다. parent 선택을 바꾸자 pruning과 gap recovery가 반응해 노드 구성이 달라졌다는 경로를 확인한 것이다. pretrained representation의 모든 활용법을 기각한 결과는 아니었다. 구성 요소의 정확도는 최종 그래프에서 다시 확인해야 한다는 C4가 여기서도 적용됐다.
6. 후보를 끝까지 돌리는 일과 확인 절차의 크기
6.1 후보는 끝까지 돌아야 한다
3편은 점수 없이 돌아온 pre-solver 제출 일곱 건으로 끝났다. 실행 시간을 남은 원인 후보로 보고, proposal 추론을 영상당 모델 하나로 줄이는 계획을 세워 뒀다. 08-01에 후보 세 개가 activation 예산을 세 가지로 달리해 이 계획을 시험했다. 셋 다 예시 영상 네 편에서는 문제없이 돌았지만, hidden test의 실행 시간 제한을 넘겨 점수가 나오지 않았다. 제안된 점을 끼워 넣으면 모든 영상에 association 모델을 한 번 더 통째로 돌려야 했다.
08-06에는 3편에서 필요하다고 했던 실행 시간 모델을 세웠다. 배포 구성은 \(F + m\,k \le 43{,}200\) s를 만족해야 한다. \(F\)는 고정 준비 시간, \(m\)은 예시 영상 네 편에서의 작업량, \(k\)는 이를 hidden test 규모로 늘리는 배율이다. 예시 영상에는 평균적인 학습 영상보다 세포가 \(42\%\) 많아서 \(k\)는 범위로만 정할 수 있었고, 배포 파이프라인에 남은 여유는 \(0\%\)에서 \(+17.6\%\) 사이였다. 가장 비관적인 쪽으로 계산해도 시간 안에 들어오는 후보에만 제출 슬롯을 쓰기로 했다. 08-08에 pre-solver 계열은 로컬 신호가 여전히 양수였지만 이 기록에 따라 배포 계획에서 빠졌다(C6).
6.2 노트북 실행 네 번, 실패 이유도 네 가지
08-07과 08-08에 런타임 probe를 Kaggle 노트북에서 네 번 연달아 돌렸지만 측정값은 한 번도 나오지 않았다. 실패 이유는 매번 로컬 산출물만 봐도 진단할 수 있는 것이었다. 패키지가 잘못 첨부된 dataset에서 로드됐고, 배포 이미지에 mount 경로가 빠져 있었고, state-dict key가 틀렸고, Python 3.12는 거부하고 로컬의 3.11은 받아 주는 구문이 있었다. 매번 로컬 점검은 더 쉬운 환경이어서 통과했다. 첫 번째 실행은 필요한 출력을 모두 만들었지만, 실패 사실은 이후 단계 어디에서도 읽지 않는 필드에 적었다. 프로세스가 끝났다고 측정이 끝나지는 않는다.
6.3 확인 비용이 질문보다 커질 때
08-10과 08-11에는 남은 몇 주를 위한 계획을 썼다. 결과 목표는 Public \(0.970\)(그날 점수는 \(0.921\))이었고, GPU는 단계적으로 늘려 \(480\)시간을 쓰는 계획이었다. 목표를 Public 점수로 잡으면 Public 점수가 나올 때마다 진행 보고처럼 읽히고, 같은 계획의 C9과 부딪친다. 이 계획은 실행 승인 시스템도 들여왔다. exit code가 과학적 판단이 아니라는 6.2절의 발견에서 출발한 것으로, 실행할 때마다 선언 여덟 가지와 서로 독립적인 근거 확인 네 가지를 거치고 launch 기록에 해시를 남겼다.
| 날짜 | 이후 벌어진 일 |
|---|---|
| 08-13 | 측정 실행이 계획한 204 pass를 모두 마쳤는데, 고정해 둔 3.5시간 제한을 0.6166초 넘겼다는 이유로 런타임 실패로 분류됐다 |
| 08-15 | capture 체인이 다섯 번 연속 실패했다. 마지막 실패는 범용 all-finite validator가, producer가 “매칭 없음”으로 정의해 둔 NaN을 거부해서였다(1,379.575초 과금) |
| 08-16 | 커밋 하나로 실험 관리용 파일 1,193개, 646,428줄이 추가됐다 |
이 사례들에는 피할 수 있었던 지연과 재작업이 드러난다. 해당 확인 절차를 단순화할 이유는 충분했다. 다만 절차 전체의 비용과 그 절차가 막은 오류의 가치를 합산해 비교한 기록은 아니다.
마무리
역방향 단독 구성은 예상 \(0.918\)에 못 미친 \(0.913\)이었다. 8월 8일에는 연구 일정을 정하는 데 쓴 hold-in 검출 진단을 철회했다. 8월 10일 점검에서는 영상 단위 정책 폴드를 배아 단위 규약으로 바꿨지만, \(+0.0144\)와 \(+0.0313\) 조합은 새 규약으로 다시 평가하지 못했다.
새 규약으로 비교 조건은 더 분명해졌지만, 독립적인 배아는 여전히 두 개뿐이었다. 다음 글에서는 로컬 comparator를 고정한 뒤 무엇을 시험할 수 있었고, 무엇이 그 비교에서 빠졌는지 살펴본다.
판단 기록·기준의 변화·남은 질문
아래 표는 당시의 결정과 그 근거를 정리한 것이다. 각 조항은 근거가 뒷받침하는 범위로 읽으며, 앞선 모든 실험이 해당 조건을 충족했다는 뜻은 아니다.
7. 판단 기록
처음 닷새 동안은 분열 단계의 임계값과 적용량을 바꾸는 데 Public을 많이 썼다. 08-03 포트폴리오는 가장 큰 로컬 association 이득을 확인하는 sanity check였다. 08-10 규약은 Public을 target-domain feedback으로 한정하고, 기대치를 미리 적어 둔 대조 실험에만 쓰도록 했다(C9).
| 결정 | 당시의 이유 | 돌아온 결과 | 바뀐 것 |
|---|---|---|---|
| 08-01: pre-solver 실행 3건, 영상당 proposal 모델 하나 | 7월에 실행 시간을 원인으로 본 판단을 시험 | 어느 예산에서도 점수 없음 | 실행 시간 모델 수립, 이 계열은 배포에서 제외(C6) |
| 08-01~08-05: 분열 단계 포트폴리오 | 앞선 분열 구성에서 Public 변화량이 로컬보다 컸음 | 이웃한 설정은 동점, 한 번 무너짐 | Public은 조건을 맞춘 sanity check에만 사용(C9) |
| 08-03: 연결 점수 맵 대 분열 단계, 기대치를 미리 적어 둠 | 무엇이 전이되는지 가려내기 | 연결 점수 맵은 자기 대조군과 동점, 분열 단계는 +0.004 | 시험한 분열 구성이 Public에서 상승 |
| 08-04: 간선 이득 95% 유지 게이트 | association 이득 보호 | +0.010205가 91.82%에서 기각 | C4는 게이트에도 적용된다 |
| 08-06: prefix 균형 4-fold에서 authority sweep | 층화했고, 모든 폴드와 두 배아가 양수 | movie-out 폴드였음. 한 계열을 guard를 켜고 embryo-out으로 다시 돌리자 약 100분의 1만 남음 | C7, 4-fold 수치 격하 |
| 08-07: 배포 그래프에서 검출 상한 측정 | 실제로 제출하는 파이프라인을 잰다 | hold-in 0.89%, embryo-out 8.79% | 08-08 철회, C8 |
| pretrained parent 순위 모델을 그래프로 평가 | embryo-out parent top-1 +0.008366 | 그래프 -0.002687 | 08-10 중단, 메커니즘까지 확인한 C4 |
| 08-11: 실행 승인 시스템 | exit code는 과학적 판단이 아니다 | 완료된 실행이 0.6166초 때문에 실패로 분류 | 확인 절차는 질문 크기에 맞아야 한다(미해결) |
이 기간이 끝났을 때의 선택 기준
| 조항 | 내용 | 도입 |
|---|---|---|
| C1 | 학습·보정·평가의 의존 관계를 분리하고 그래프 전체를 채점한다. 영상 분리만으로 배아 독립성이 보장되지는 않는다 | 2편 |
| C2 | 게이트는 결과를 보기 전에 정해 둔다 | 3편(07-15) |
| C3 | 규칙은 실제로 적용될 모집단에서 보정한다 | 3편 |
| C4 | 구성 요소는 자체 정확도가 아니라, 파이프라인을 그대로 재현해 만든 그래프로 평가한다 | 3편 |
| C5 | 점수와 변화량에 대조군을 함께 기록한다. 다른 replay의 변화량으로 우열을 매기지 않는다 | 3편 |
| C6 | 후보는 hidden test에서 제한 시간 안에 실행을 마쳐야 한다 | 3편 |
| C7 (신규) | 폴드는 배아 단위로 나눈다(embryo-out) | 4편 |
| C8 (신규) | 제출 모델이 학습한 영상에서 잰 수치(hold-in)는 일반화의 근거로 쓰지 않는다 | 4편 |
| C9 (신규) | Public은 기대치를 미리 적어 둔 sanity check에만 쓰고, 인접한 설정 중 하나를 고르는 데는 쓰지 않는다 | 4편(08-10) |
8. 이 기간에 확인된 것
확인된 사실
- 조화 평균 reverse-time association은 embryo-out 199편 replay를 \(+0.0073273\) 올렸고, 두 배아 모두 양수였다. 미리 정한 후보 네 개 중 최고값이며, 네 후보 모두 양수였다.
- Public에서 연결 점수 맵 단독은 미리 적어 둔 기대치 \(0.918\)에 대해 \(0.913\)으로 정방향 대조군(\(0.912\))과 동점이었고, 분열 단계가 붙은 경우에도 동점이었다(\(0.916 \to 0.917\)).
- 분기 대체 방식 분열 단계 아래 모든 분기를 접자 분열 거짓 양성이 \(587\)개에서 \(67\)개로 줄었고, 간선 이득의 \(99.30\%\)를 유지하며 \(+0.0106431\)에 도달했다(Public에서는 같은 \(0.012\) 예산 기준 \(0.920\) 대 \(0.917\)로, 9월에 정한 조사 기준을 소급해 적용하면 기준선에 걸쳤고, 예산을 두 배로 하면 \(0.919\)로 동점).
- 분열 단계는 어느 연결 점수 맵에서든 Public을 0.004 움직였고, replay는 그 효과를 \(+0.0010142\)로 봤다. 반올림된 두 쌍에서 읽은 방향이고, 비율은 아니다.
- 분열 단계의 이웃한 임계값과 적용량 설정은 Public에서 구분되지 않는다. 08-04에는 동점 넷과 한 번의 붕괴, 08-05에는 동점 다섯이었다.
- replay baseline에서 놓친 정답 세포 \(13{,}559\)개 중 \(99.25\%\)는 \(7\,\mu\mathrm{m}\) 게이트 안에 예측 노드가 없었다.
- 배포 그래프의 hold-in 검출 진단에서 도달 불가능한 정답 간선은 \(0.89\%\)였다. 같은 네 편의 embryo-out research replay에서는 \(8.79\%\), 199편에서는 \(12.10\%\)였다. 학습 조건과 파이프라인이 함께 바뀐 비교였으며, 원래 주장은 철회했다.
- ablation 결과를 요약한 두 문장은 참 양성이 \(2\)개인 분열 항이 만든 착시였고, 간선 기준으로는 순위가 그대로였다.
- \(+0.014446\)과 \(+0.031335\)가 나온 outer 폴드 네 개는 배아 prefix별로 균형을 맞춘 movie-out 폴드였고, embryo-out이 아니었다.
- multi-frame 계열은 그 폴드에서 guard 없이 \(+0.0133995\), embryo-out에서 분열 guard를 켜고 \(+0.0001347503\)이었다.
- held-out parent top-1이 \(+0.008366\) 좋아진 parent 순위 모델이 177편 그래프를 \(-0.002687\) 나쁘게 만들었다(노드 \(9{,}357\)개 추가, \(184\)개 매칭).
근거는 있지만 아직 확정하지 못한 판단
- \(+0.0144\)와 \(+0.0313\)은 배아를 완전히 분리하면 줄어들 수 있다. 혼합 폴드로 일반화를 주장할 수는 없지만, 그 때문에 변화량이 얼마나 달라질지나 어느 방향일지 측정한 것은 아니다.
- 연구용 그래프와 배포 그래프의 오류 분포 차이가 역방향 연결 점수 맵의 작은 Public 효과를 설명할 가능성이 있다.
- hold-in의 \(0.89\%\)를 hidden test 배아에도 가정할 수는 없다. 그렇다고 현재 비교로 hidden test 배아의 비율이 두 관측값 사이 어디에 놓일지 알 수 있는 것도 아니다.
열린 질문
- 배포 파이프라인의 검출 상한을 embryo-out으로 재면 얼마인가?
- \(+0.0144\)와 \(+0.0313\) 조합은 embryo-disjoint 규약에서도 남는가, 남는다면 크기는 얼마인가?
- 이 규약 아래에서 Public이 보여 줄 수 있을 만큼 큰 association 이득이 하나라도 남는가? 이 기간에 이 규약으로 잰 association 후보는 모두 \(+0.0005\) 미만이었다.
- 로컬 이득과 Public 사이에 안정적인 비율이 있기는 한가? 남은 기간의 계획에는 \(0.14\times\)~\(0.9\times\)라고 적혀 있지만, 이 글의 포트폴리오는 어느 한 구간에도 맞지 않는다.
- 파이프라인 어딘가에 아직 배아 경계를 넘어 fit된 association head가 남아 있지는 않은가?
시리즈:
- 1편: Lineage Graph 학습과 평가지표에 맞춘 후처리
- 2편: Public 점수가 멈췄을 때 — OOF 기반 오류 분석
- 3편: OOF에 기반한 판단들
- 4편: 로컬 검증에서 발견한 세 가지 빈틈