Gemma 4 Developer Agent 2편: 채점 환경이 바뀔 때 에이전트 성능을 비교하는 법
한 달 동안 코딩 에이전트를 실험하며 확인한 도구 호출의 반복, 평가 환경의 변화, 로컬 결과와 호스트 점수의 차이, 그리고 12시간 제한의 위험을 정리한다.
1편에서는 에이전트가 이슈를 받고, 코드를 찾아 고친 뒤, 패치를 검증받기까지의 과정을 살펴봤다. 그 뒤 한 달 동안 실험을 이어 가며 각 단계에서 실제로 어떤 문제가 생기는지 확인했다. 그런데 실험을 할수록 수정안을 만드는 일 못지않게 결과를 해석하는 일이 어려웠다. 점수가 올랐다면 에이전트가 좋아진 것일까? 무엇을 확인해야 그렇게 말할 수 있을까?
이번 글에서는 이 질문을 네 가지 관찰에서부터 풀어 보려 한다.
- 같은 도구 호출을 반복하기 시작하면 좀처럼 빠져나오지 못했다. 공개 과제 22개를 비교한 실험에서, thinking을 끈 에이전트가 직전 호출을 반복할 확률은 연속 길이가 1일 때 0.056이었다. 이미 같은 호출이 세 번 이상 이어진 구간에서는 0.97이었다. 모든 호출에 같은 반복 확률을 적용해서는 이 차이를 설명하기 어렵다. 다만 이 곡선만으로 반복의 원인까지 알아낸 것은 아니다.
- context 한도에 걸린 이유는 토큰 수로 확인할 수 있었다. 한 실행에서는 같은 호출이 55번 나온 뒤 다음 요청이 거부됐다. 첫 호출을 한 번으로 세고 이후의 반복을 계산하면, 54번을 더 할 수 있다는 계산이 실제 기록과 맞았다.
- 같은 패키지를 제출해도 호스트 점수가 달랐다. 파일이 바이트 단위로 같은 패키지가, 같은 호스트 epoch로 분류된 두 제출에서 0.10과 0.15를 받았다. 실제로 확인한 점수 차이다. 하지만 두 결과만으로 일반적인 점수 변동 폭이나 구별할 수 있는 최소 개선량을 추정할 수는 없다.
- 과제를 잘 푸는 것과 제한 시간 안에 끝내는 것을 함께 봐야 했다. 12시간을 넘기면 제출 전체가 오류로 끝난다. 느린 에이전트가 개별 과제를 더 잘 풀더라도, 전체 실행을 끝내 점수를 받을 가능성은 낮아질 수 있다. 로컬 실행 시간으로 이런 위험을 살펴볼 수는 있지만 비공개 채점 서버에 시간이 얼마나 남을지는 알 수 없다.
현재 비교 기준인 E0052는 공개된 Budget-Fit single-agent 패키지다. 원저자를 밝히고 원본 그대로 사용한다. 1편의 채점받지 않은 실습 예제나, 초기 도구 오류를 진단할 때 사용한 recovery 패키지와는 구분해야 한다. 지금까지 기록한 최고 Public 점수는 0.18이다. 비교한 변형 중 이 점수를 넘은 것은 아직 없다. 그렇다고 이 결과를 에이전트의 한계 하나로 설명할 수는 없다. 과제 구성, 실행마다 생기는 변동, runtime의 영향이 각각 얼마나 큰지는 여전히 알지 못한다.
아래 내용은 2026년 10월 23일(KST)에 프로젝트 기록을 다시 확인해 정리했다. 날짜를 붙인 리더보드 스냅샷과 과거 비교는 당시 조건에 따른 결과다. 10월 23일 09:01 KST에 낸 E4B 제출은 확인한 기록에서 아직 대기 중이며 성능 결과는 없다. 본 대회 마감은 12월 2일 23:59 UTC(한국 시간 12월 3일 08:59)다.
지금 위치
10월 22일 06:15 UTC의 Public 리더보드 스냅샷에는 점수가 있는 팀이 3,428개였다. 네 팀이 최고 점수인 0.24를 기록했고, 우리 팀은 0.18로 398위였다. 관찰한 최고 점수는 10월 2일 이후 0.24로 유지됐다. 그동안 같은 팀들이 계속 선두였다는 뜻은 아니다.
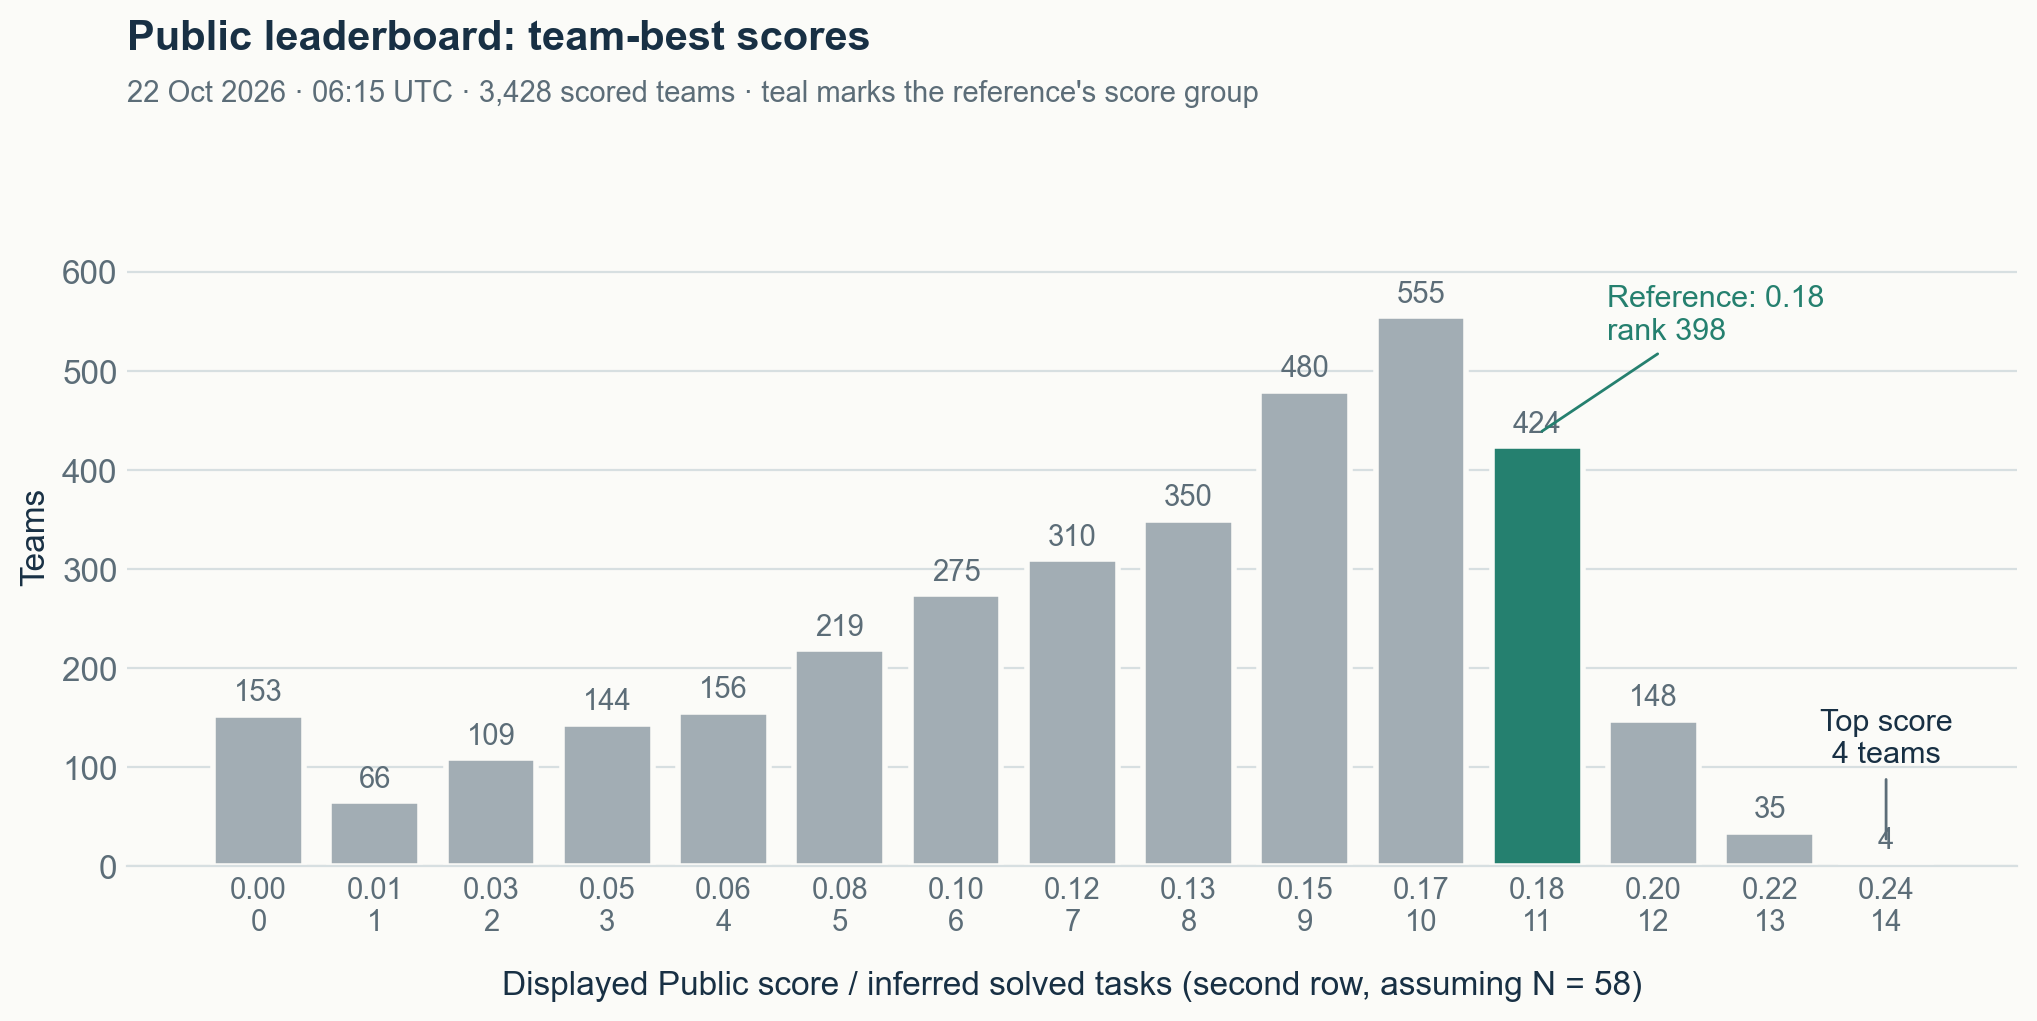 그림 1. 10월 22일 06:15 UTC 스냅샷에서 팀별 최고 Public 점수를 집계했다. 두 번째 줄은 Public 과제가 58개이고 소수점 둘째 자리 아래를 버린다고 가정했을 때의 해결 과제 수다. 이 해석의 근거와 한계는 7절에서 다룬다. 주최 측이 정확한 과제 수를 공개한 것은 아니다. 청록색은 우리 팀이 속한 점수 구간이며, 그림 2의 Budget-Fit 기준 번들과 색을 맞췄다.
이 해석에 따르면 0.18은 11개, 0.24는 14개를 해결한 값이다. 9개, 10개, 11개 해결에 해당하는 세 점수에 1,459개 팀이 몰려 있다. 세 과제만 더 풀면 최고 점수에 닿는 것처럼 보인다. 하지만 이것은 리더보드에 기록된 팀별 최고 점수의 차이다. 같은 조건에서 반복해서 실행했을 때의 기대 해결 수도 세 과제만큼 차이 난다고 확인한 것은 아니다. 이 구분이 이후 비교에서 중요해진다.
1. 바뀌는 채점 환경을 어떻게 구분했나
점수를 비교하려면 먼저 무엇이 같은 조건이었는지 알아야 한다. 1편은 9월 25일에 확인한 명세를 바탕으로 썼고 이후 조건이 바뀔 수 있다고 설명했다. 실제로 그 뒤 주최 측은 평가용 wheelhouse를 열 번 더 올렸고, 데이터를 다시 배포했으며, 당시 답변을 기다리던 질문에도 답했다. 주요 변화는 다음과 같다.
표 1. 실험 결과를 비교할 때 고려해야 할 평가 환경과 규칙의 변화.
| 9월 25일 | 10월 23일 |
|---|---|
평가 패키지 swegemma 0.2.7, adk-submission 0.2.11, vLLM 0.19.1을 사용했다. | swegemma 0.2.11, adk-submission 0.2.13을 사용한다. vLLM은 여전히 0.19.1로 표시되지만, 같은 버전 번호로 두 번 다시 빌드됐다. |
| 그래프와 embedding 파일의 절반이 비어 있었다. | 9월 25일에 수정됐다. 그래프에는 여전히 async 함수가 빠져 있으나, 주최 측은 비공개 과제 중 여기에 의존하는 것은 없다고 밝혔다. |
| 에이전트가 기존 테스트를 고친 내용이 채점 때 남을 수 있었다. | 10월 8일 v29부터는 보호 대상인 테스트·설정 파일의 변경을 에이전트 패치에서 제거한 뒤 적용한다. Git이 추적하는 테스트 파일도 원래 상태로 되돌린다. |
| 선언하지 않은 도구를 호출하거나 도구가 실패하면 과제가 종료되고 작업 결과를 잃었다. | 10월 8일부터는 도구 오류를 모델에 알려 주고 세션을 이어 간다. |
include_thoughts: false이면 thinking이 꺼지고 thinking_budget은 무시됐다. | 현재 확인한 bridge에서는 thinking budget이 양수이면 thinking을 켜고 한도를 전달한다. include_thoughts: false는 이전 thought를 대화 기록에 남길지 결정한다. thinking을 켜는 설정과는 별개다. |
| 도구 결과가 JSON으로 두 번 인코딩되어 전달됐고, 도구 호출 사이에 thought가 버려졌다. | 두 문제 모두 9월 30일에 수정됐다. |
| LoRA adapter가 로드돼도 효과가 없다는 제보가 있었다. | 9월 27일에 수정됐다. 주최 측은 rank 64 이하 adapter로 점수가 나온 사례가 있다고 밝혔다. |
| 31B 모델만 쓸 수 있었다. | 31B, 12B, E4B, E2B의 QAT 버전을 쓸 수 있다. 제출 하나에는 base model 하나만 사용한다. 10월 20일에는 E2B·E4B 제출을 대상으로 USD 10,000 보너스가 추가됐다. |
| 다른 모델을 이용한 distillation은 답변을 기다리고 있었다. | 원본 모델의 라이선스 범위 안에서 허용된다. 다른 open model의 trajectory도 사용할 수 있다. |
| 12시간을 넘기면 제출 전체가 오류로 끝났다. | 그대로다. 주최 측은 끝내지 못한 과제만 0점으로 처리하는 방식을 검토했으나 기존 규칙을 유지한다고 밝혔다. |
| 비공개 과제가 약 120개라고 안내했다. | 운영진은 비공개 저장소에서 가져온 Public 약 60개, Private 약 60개라고 설명한다. 공개 runner는 두 split을 한 번의 평가에서 처리한다. 강한 상용 모델이 해결했거나 assertion 하나만 통과하지 못한 과제를 남겼다고 한다. 풀 수 있는 문제인지 확인한 기준이며, 그 모델에도 모두 어려운 문제라는 뜻은 아니다. |
한 팀이 동시에 대기시킬 수 있는 제출은 하나뿐이다. 채점이 시작되기까지 대략 14–33시간을 기다린 경우도 있었다. 그 사이 환경이 바뀌면, 제출 당시 공개된 파일이 실제 채점에도 쓰였는지 단정하기 어렵다.
일부 변경은 패키지를 그대로 다시 제출해도 점수에 영향을 줄 수 있다. 반면 문서나 파일 공개 방식만 바뀐 경우도 있다. 그래서 점수마다 번들 $b$뿐 아니라 관찰한 호스트 epoch $e$를 붙여 $S_e(b)$로 기록한다. 여기서 epoch는 공개 산출물의 변경을 기준으로 나눈 기간이다. 같은 epoch의 점수인지 먼저 확인하되, 이것만으로 비공개 서버의 실행 조건까지 같았다고 보지는 않는다.
제출 시각부터 점수를 처음 확인한 시각까지를 $[t_s, t_c]$, epoch $k$의 시작으로 삼은 산출물이 공개된 시각을 $b_k$라고 하자. 채점 서버에 적용된 실제 시각은 알 수 없으므로, 공개 뒤 6시간의 여유 $\delta$를 두고 다음 조건을 만족하는 점수만 epoch $k$에 배정했다.
\[b_k + \delta \le t_s \quad\text{and}\quad t_c < b_{k+1}.\]배포가 반드시 6시간 안에 끝난다는 측정 결과는 없다. 점수를 보수적으로 분류하기 위해 정한 규칙이다. 이 조건에 맞지 않는 점수도 보관하지만 번들 간 직접 비교에는 사용하지 않는다.
이렇게 나누면 9월 23일부터 10월 13일까지 11개 epoch가 된다. 비공개 채점기가 실제로 열한 번 달라졌다고 확인한 것은 아니다. 마지막 경계도 파일의 timestamp가 새로 만들어진 것을 보고 설정했다. 이후 비교에서는 bulk 파일 507개가 바이트 단위로 같았고 새 과제 내용도 없었다. 앞서 공개된 README는 우리가 보관하던 이전 사본과 달랐다.
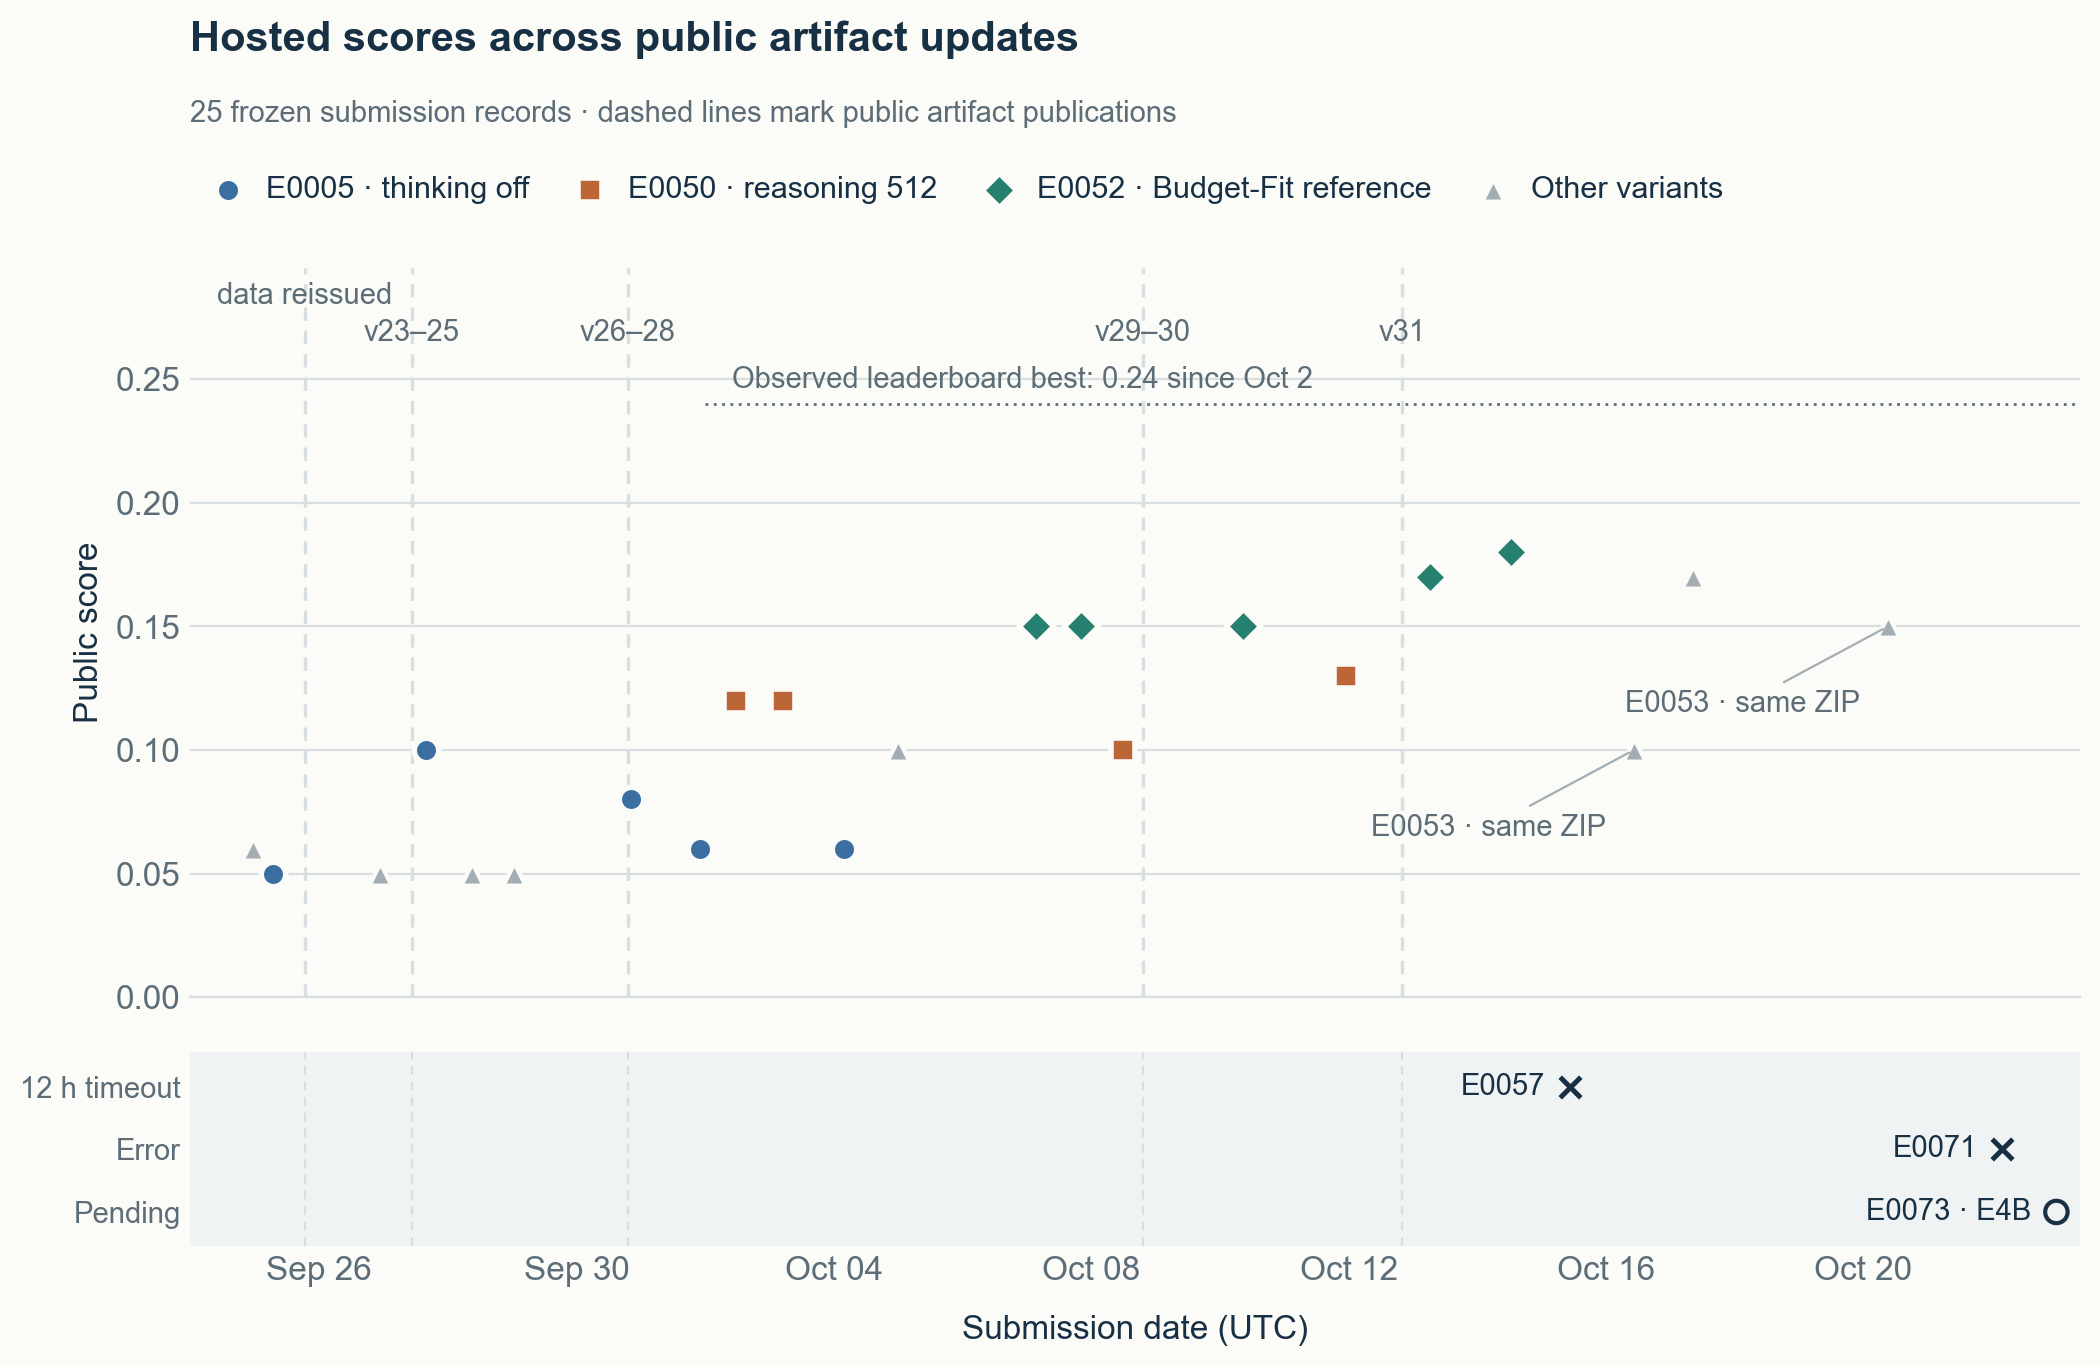 그림 2. 10월 23일까지의 제출 기록 25개를 제출 시각(UTC) 순서로 표시했다. 22개는 완료됐고, 2개는 오류로 끝났으며, 1개는 대기 중이다. 오류와 대기 상태는 점수 패널 아래의 별도 영역에 표시했다. 점선은 일부 공개 산출물의 업데이트 시각이며 비공개 서버에 적용된 시각은 아니다. v29와 v30은 선 하나로 표시했다. E0053의 두 점은 동일한 ZIP의 결과다. E4B 제출은 아직 대기 중이다. 초기 recovery 패키지는 수정 없이 여러 기간에 걸쳐 제출했다. 그 점수들을 같은 환경에서 반복한 결과로 합쳐서는 안 된다.
버전 번호만 기록해서도 부족하다. 주최 측은 10월 12일 swegemma 0.2.11과 vLLM 0.19.1을 버전 번호를 바꾸지 않고 다시 빌드했다. 따라서 로컬 평가 환경은 파일 hash로 식별한다. 결과마다 서버 명령, 패키지 digest, compaction 설정, 데이터 버전도 fingerprint로 함께 남긴다.
2. 패치를 남기는 것과 문제를 해결하는 것
실행 조건을 구분했다면, 다음으로는 어떤 단계에서 실패했는지 나눠 봐야 한다. 과제 $N$개의 실제 해결 비율을 $S$라고 하자. 과제 $i$에서 실행·수집 오류로 작업 결과를 잃지 않고 작업 디렉터리의 패치를 검증 단계에 전달하는 사건을 $E_i$라고 하자. 검증 결과는 $Y_i\in{0,1}$로 둔다. 패치를 전달하지 못한 경우에는 해결로 인정되지 않는다는 조건에서, 기대 해결률은 다음과 같다.
\[\mathbb{E}[S]=\frac{1}{N}\sum_{i=1}^{N}\Pr(E_i)\,\Pr(Y_i=1\mid E_i).\]앞은 패치를 전달할 확률, 뒤는 전달한 패치가 문제를 해결할 확률이다. 도구를 제대로 쓰지 못해 편집 결과를 잃는 것과, 편집은 마쳤지만 요구사항을 충족하지 못하는 것은 최종 점수로는 구분되지 않는다. 하지만 어느 쪽인지 알아야 적절한 변경을 시도할 수 있다.
그렇다고 오류가 기록된 모든 실행을 패치 전달 실패로 세면 안 된다. 초기에 확인한 runtime에서는 바깥쪽 예외 처리로 빠질 때 패치 수집을 건너뛸 수 있었다. 현재 v31 코드는 일반 실행 오류를 기록한 뒤에도 fallback으로 diff 수집을 시도한다. 따라서 agent error가 있어도 verifier가 resolved로 판정할 수 있다. timeout이나 context 오류로 작업을 멈췄더라도, 그전에 만든 유효한 패치까지 자동으로 버려지는 것은 아니다. 실제로 수집한 패치와 verifier 결과를 각각 확인해야 한다.
초기에는 코드 수정의 질을 따지기 전에 해결해야 할 문제가 많았다. Kaggle의 L4 GPU 네 장에서 공개 과제 세 개를 돌린 첫 실행은 한 과제를 해결했다. 다른 한 과제에서는 같은 잘못된 호출이 55번 나온 뒤 context 오류가 났다. 나머지 한 과제에서는 분석을 맡은 보조 에이전트가 잘못된 셸 pipeline을 약 4분 동안 반복하다 노트북 전체의 제한 시간에 걸렸다. 두 실패 모두 유효한 소스 수정을 하기 전이었다. 이때는 더 나은 수정안을 요구하기에 앞서, 왜 도구 실행과 작업 흐름에서 막혔는지 살펴봐야 했다.
3. 도구 호출은 어디서 잘못됐나
첫 번째 문제는 호출 형식이었다. Gemma 4가 출력하는 도구 호출은 JSON이 아니다. 서버의 parser는 문자열의 시작과 끝을 특수 토큰으로 구분하는 형식을 읽는다. 아래에서 <|"|>로 표시한 것이 그 토큰이다.
1
2
intended: read_file{filepath:<|"|>fastapi/openapi/utils.py<|"|>,start_line:400,end_line:568}
emitted:  read_file{filepath:<|"|>fastapi/openapi/utils.py\",start_line\":400<|"|>,end_line:568}
두 번째 줄은 원래 출력 토큰이 남아 있지 않아 기록된 인자로 복원한 것이다. parser는 다음 구분 토큰이 나올 때까지를 문자열로 읽는다. 모델이 경로를 일반 따옴표나 escape된 따옴표, backtick으로 닫으면 뒤의 ",start_line":400까지 파일 경로에 들어간다. 도구는 그 이름의 파일이 없다는 오류를 반환한다. 오류 메시지만 보면 파일을 잘못 찾은 것처럼 보이지만, 실제 문제는 문자열을 닫는 방식에 있다.
5절에서 다룰 과제 22개 비교에서 thinking을 끈 번들은 이런 잘못된 호출을 223번 냈다. 인자가 빠졌다는 이유로 거부된 호출도 80번 있었다. 예를 들어 edit_file에서 new_string을 backtick으로 닫으면, parser가 old_string까지 앞 문자열의 일부로 읽어 버릴 수 있다. 모델이 수정할 내용을 생각했더라도 도구에는 필요한 인자가 전달되지 않는 것이다.
4. 한 번 시작된 반복은 오래 이어졌다
호출 형식이 잘못된 것보다 더 큰 문제는 같은 실패를 계속 반복했다는 점이다. 오류를 받았으면 호출을 고쳐야 하는데, 같은 호출을 다시 보내는 경우가 많았다. 매번 일정한 확률로 반복한 것일까? 아니면 이미 반복 중일 때 같은 호출을 내기 더 쉬웠던 것일까? 현재까지 같은 호출이 이어진 횟수를 $k$라 하고 다음을 정의하자.
\[h(k) = \Pr(\text{next call identical} \mid \text{current streak } k).\]여기서 같은 호출은 도구 이름과 파싱된 인자 값이 모두 같은 호출이다. 인자의 key 순서만 다른 경우는 같게 처리했다. 이전 이력과 무관하게 매번 같은 확률로 반복한다면 모든 $k$에서 $h(k)=q$다. 하지만 thinking 없이 실행한 과제 22개의 trace, 호출 1,404개에서 얻은 곡선은 이와 달랐다.
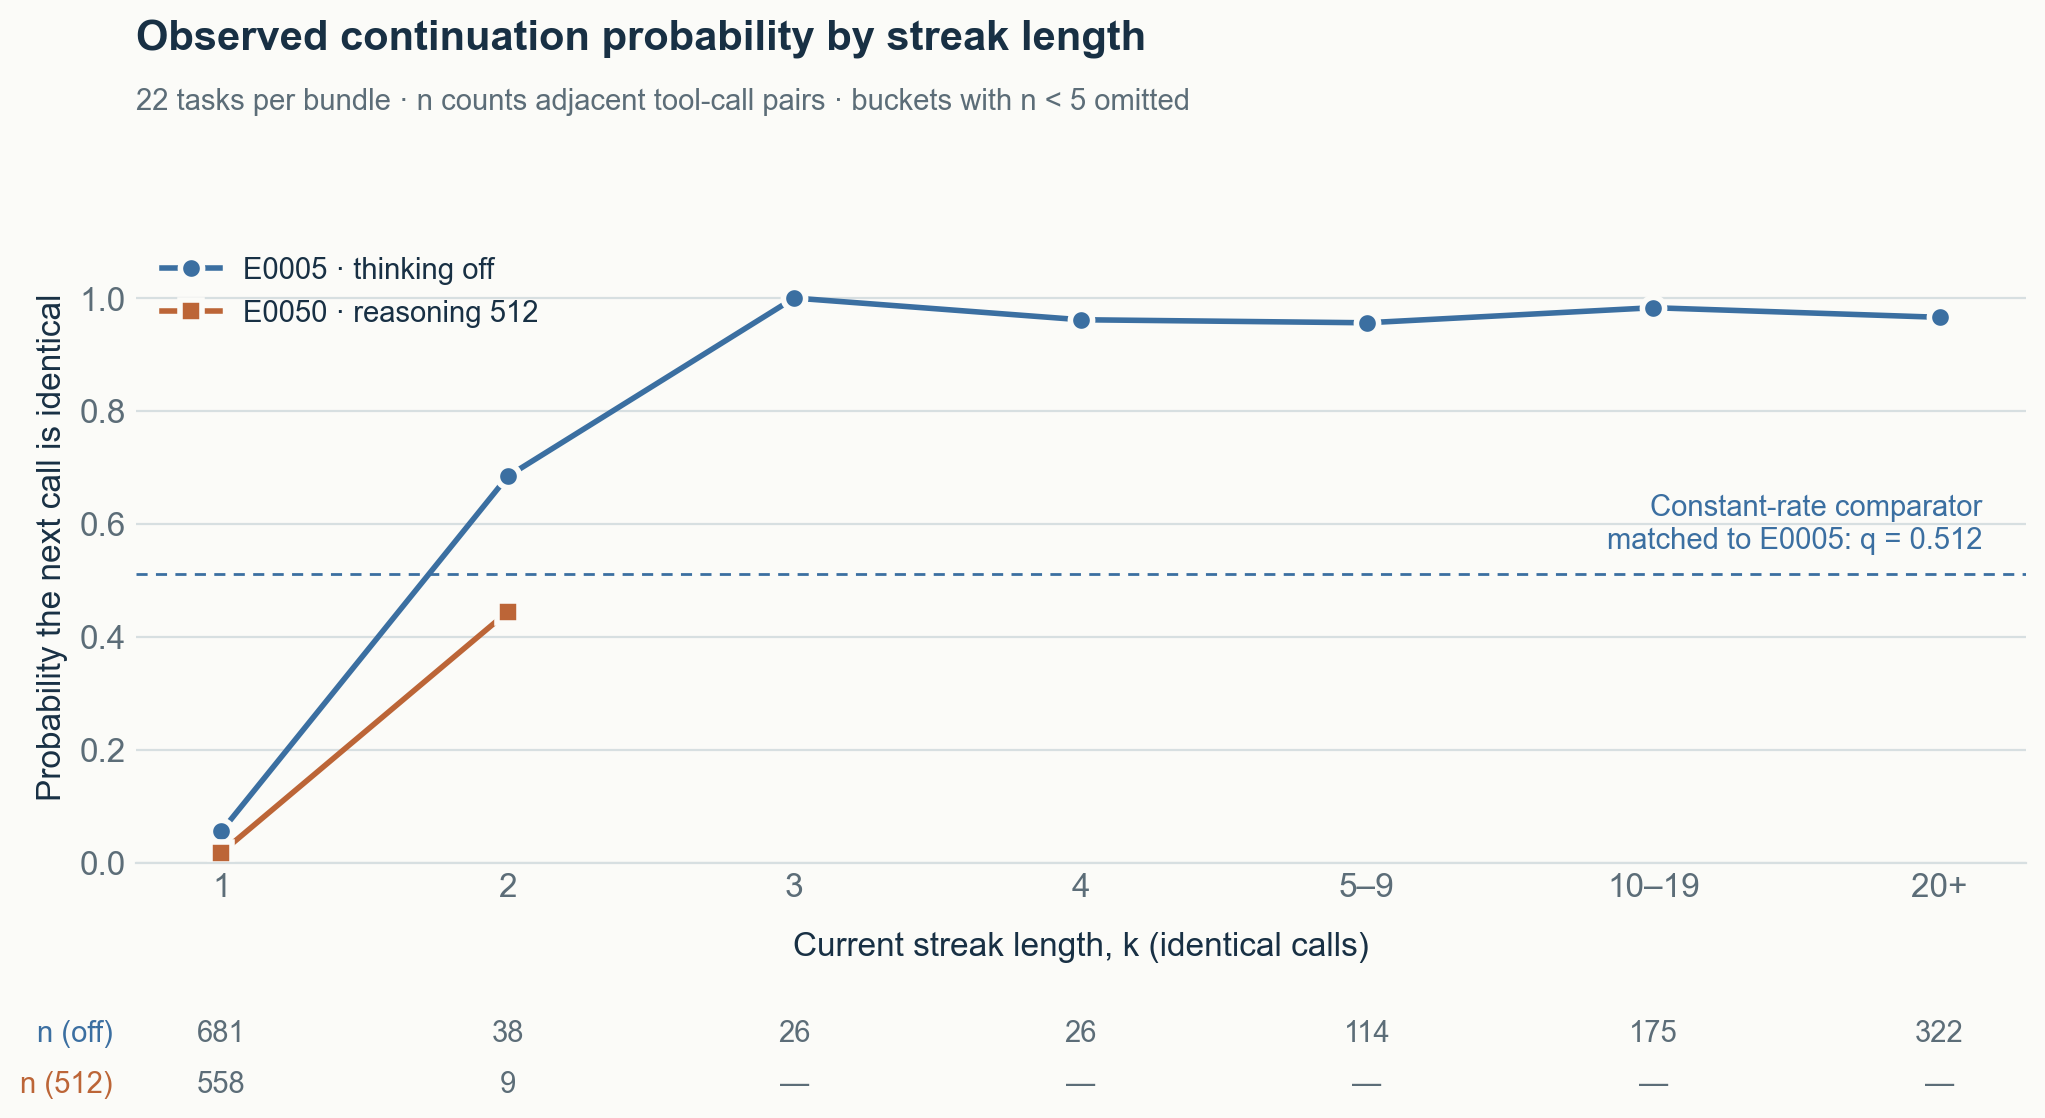 그림 3. 같은 공개 과제 22개에서 thinking을 끈 경우(파란색)와 호출당 512토큰으로 제한해 켠 경우(주황색)의 경험적 $h(k)$. 관측이 5개 미만인 구간은 제외했다. 점선은 파란색 전체의 평균 반복률을 모든 호출에 적용한 값이다. 표시한 관측 수는 연속된 호출 쌍의 수다.
연속 길이가 1일 때는 $h(1)=0.056$이다. 그런데 같은 호출이 세 번 이어진 뒤에는 $h(k)$가 0.96–1.00이고, $k\ge3$인 구간을 합치면 $643/663=0.97$이다. 반복을 시작할 확률은 낮지만, 일단 길게 반복하기 시작하면 빠져나오는 경우가 드물었다.
전체 연속 호출 쌍의 평균 반복률은 $\hat q=0.512$다. 모든 호출이 이 확률로 반복한다고 가정해 보자. 각 실행 길이에 맞춰 같은 호출이 20번 이상 이어질 확률을 정확히 계산한 뒤 더하면, 22개 실행 중 그런 실행의 기대 개수는 $1.5\times10^{-3}$이다. 실제로는 11개였다. 평균 반복률 하나로는 긴 반복을 제대로 설명하기 어렵다. 그래서 여기서는 두 확률로 나눠 정리한다.
- 진입 확률 $\alpha=h(1)$
- 지속 확률 $\beta\approx h(k)$, $k\ge3$
지속 구간에서 매번 확률 $\beta$로 반복한다고 가정하면, 이후 추가 반복 횟수의 기대값은 $\beta/(1-\beta)$다. $\beta=0.97$이면 약 32번이다. 실제 원인을 설명하는 두 상태 모형을 추정한 것은 아니다. 과제마다 반복 성향이 다를 수도 있고, 뒤쪽 구간에는 오래 반복한 실행만 남는다. 실행 한도에 걸려 trace가 끝나는 것도 여러 실행을 합친 곡선에 영향을 준다.
가능한 설명 중 하나는 모델이 context에 쌓인 앞선 호출을 그대로 따라 한다는 것이다. 조사한 반복 구간에서는 이전의 같은 호출과 바뀌지 않은 도구 결과가 대화 기록에 남았고, 그 사이에 reasoning text가 없었다. 이런 입력이 반복을 강화했을 가능성은 있지만, 곡선만으로 원인을 확정할 수는 없다.
반복은 context 한도에도 영향을 준다. 같은 호출이라도 요청과 결과가 추가될 때마다 context가 늘어난다. 서버가 다음 요청을 받아들이려면 아래 조건을 만족해야 한다.
\[C_{\mathrm{prompt}} + M_{\mathrm{requested}} \le 32{,}768,\]$M_{\mathrm{requested}}$는 실제 응답 길이가 아니라 설정에서 요청한 출력 허용량이다. 첫 호출은 $C_0$토큰의 프롬프트로 한도 안에서 요청할 수 있다고 가정하자. 반복 중 compaction이 없고, 호출이 끝날 때마다 다음 프롬프트가 $c$토큰씩 늘어난다면 첫 호출까지 포함한 총 허용 호출 수는 다음과 같다.
\[n_{\max} = 1 + \left\lfloor \frac{32{,}768 - M_{\mathrm{requested}} - C_0}{c} \right\rfloor.\]첫 진단 실행에서는 $M_{\mathrm{requested}}=8{,}192$, $C_0=18{,}033$, $c=119$였다. 내림 연산으로 얻는 값은 54다. 첫 호출 뒤에 54번을 더 할 수 있으므로 $n_{\max}=55$다. 실제로 같은 호출이 55번 나온 뒤, 프롬프트가 24,578토큰이 된 56번째 요청이 거부됐다. 나중에 $M_{\mathrm{requested}}=4{,}096$으로 실행했을 때도 거부된 요청의 프롬프트는 28,673토큰이었다. 허용치 28,672보다 정확히 하나 많았다.
$\beta=0.97$인 가상의 반복 과정이 앞으로도 55번 계속 이어질 확률은 $0.97^{55}\approx0.19$다. 이것을 실제 과제의 실패 확률로 읽어서는 안 된다. 다만 반복이 무한히 이어지지 않더라도, 제한된 context를 모두 써 버릴 만큼 길어질 수는 있음을 보여 준다.
5. thinking을 켜면 반복은 줄지만 시간은 더 든다
그렇다면 모델이 다음 호출을 내기 전에 reasoning을 하도록 하면 달라질까? 초기 recovery 번들 E0005를 9월 말 wheelhouse에서 thinking을 끄고 실행했을 때는 reasoning token이 하나도 생성되지 않았다. 비교 번들 E0050에서는 이 설정만 바꿔 thinking을 켜고 모델 호출당 512토큰으로 제한했다. 프롬프트, 도구, 실행 한도, runtime, sampling은 그대로 두고 같은 공개 과제 22개를 실행했다.
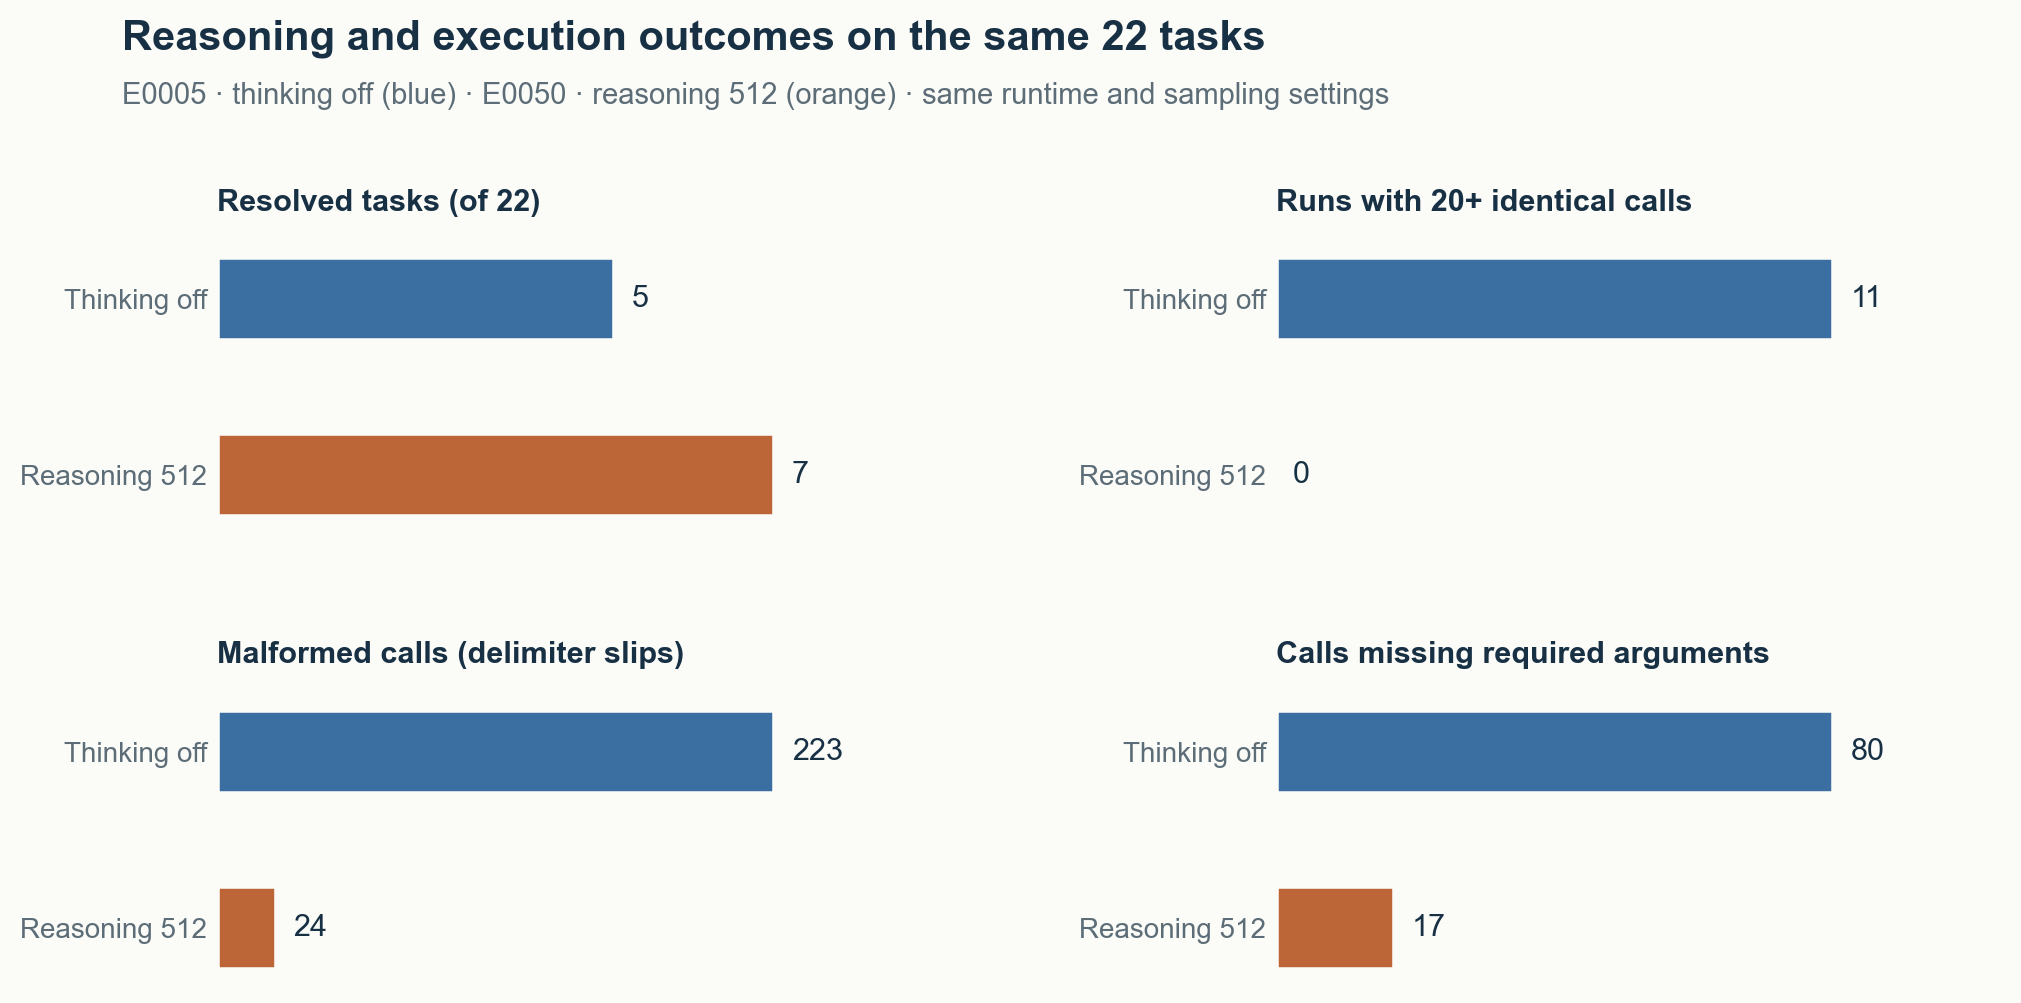 그림 4. 같은 공개 과제 22개를 같은 runtime과 sampling 설정에서 비교했다. 두 번들의 차이는 thinking 설정 하나다.
해결한 과제는 5개에서 7개로 늘었다. 결과가 갈린 과제는 둘이고 둘 다 thinking을 켠 쪽이 해결했다. 해결 수만 보면 근거는 약하다. 정확한 양측 검정에서 $p=0.5$다. 하지만 반복 행동과 패치 수집에는 더 큰 차이가 있었다.
표 2. 같은 공개 과제 22개에서 비교한 반복 호출과 패치 수집 결과.
| 지표 | Thinking off | Reasoning 512 |
|---|---|---|
| 진입 확률 $\alpha=h(1)$ | 0.056 | 0.018 |
| 지속 확률 $\beta$ ($k\ge2$ 구간 합산) | 0.95 | 0.47 |
| 같은 호출이 두 번 이어진 뒤 추가 반복 횟수의 기대값 $\beta/(1-\beta)$ | 21 | 0.9 |
| 같은 호출이 20번 이상 이어진 실행 | 11 | 0 |
| 패치를 수집한 실행 | 9 | 15 |
thinking을 켠 쪽에서는 $k=1$ 이후에 관측한 호출 쌍이 17개뿐이어서, 지속 확률은 $k\ge2$를 합쳐 계산했다. 켠 쪽은 $\beta=8/17$, 끈 쪽은 $669/701$이다. 이 비교에서 진입 확률은 약 3분의 1로 낮아졌고 지속 확률도 크게 낮아졌다. 표의 기대 반복 횟수는 반복에 진입한 뒤에도 같은 확률로 반복한다고 가정한 4절의 계산을 적용했다. 같은 실행 안의 호출 쌍을 여러 번 센 결과이므로, 서로 독립인 과제 표본처럼 다룰 수는 없다.
대신 시간은 더 들었다. 로컬 장비에서 모델 요청 한 번에 걸린 시간은 thinking을 켰을 때 7.2초, 껐을 때 3.3초였다. 세션 길이가 $T_{\mathrm{session}}$라면 요청 수는 대략 다음과 같다.
\[K_{\mathrm{calls}} \approx \frac{T_{\mathrm{session}}}{t_{\mathrm{request}}},\]모델 요청 시간만 보면 같은 세션에서 할 수 있는 요청이 거의 절반으로 줄어든다. 실제로는 도구 실행 시간도 필요하다. 그렇다면 줄어든 호출이 모두 문제 해결에 필요했던 호출인지 살펴볼 필요가 있다.
thinking을 끈 trace에서는 연속 호출 쌍 1,382개 중 707개가 반복이었다. 켠 쪽은 575개 중 18개였다. 각 실행의 첫 호출을 포함하고 직전 호출과 같은 것을 빼면 697개 대 579개가 남는다. 전체 호출은 57% 줄었지만 연속 중복을 제외한 호출은 약 17%만 줄었다. 중복이 없다고 반드시 유용한 호출은 아니다. 그래도 전체 호출 수만 볼 때와 달리, 줄어든 호출 중 상당수가 반복이었다는 사실을 알 수 있다.
그렇다고 thinking을 무작정 늘려도 되는 것은 아니었다. 사실상 길이를 제한하지 않은 변형은 5분 세션에서 22개 중 15개 과제가 시간 초과로 끝났고 호스트 점수는 0.05였다. 길이를 제한한 버전은 0.12를 두 번 받았으며, 같은 epoch에서 수정하지 않은 recovery 번들은 0.06을 받았다. 초기 recovery 계열에서 로컬과 호스트의 우열이 일치했던 사례다. 현재 E0052의 설정이나 이후 runtime에서의 최적값을 정한 실험은 아니다.
6. 로컬 평가도 먼저 검증해야 한다
여기까지의 비교는 로컬 결과를 믿을 수 있다는 전제가 있어야 의미가 있다. 그러나 벤치마크에도 오류가 생긴다. 초기에는 에이전트의 특성으로 보였던 결과가 평가 도구의 문제로 밝혀진 경우도 있었다.
표 3. 에이전트의 특성처럼 보였지만 benchmark나 verifier를 확인하다 찾은 문제.
| 처음에 본 결과 | 조사해서 확인한 원인 |
|---|---|
| 초기 로컬 배치에서 그래프 도구가 전혀 도움이 되지 않았다. | 그래프 파일을 과제 이름으로 배포했지만, 공식 resolver는 저장소와 커밋 이름으로 된 파일을 읽었다. 해당 실행에서 그래프 도구는 데이터를 받지 못했다. |
| 일부 실행이 190–600초 동안 멈췄다. | 빌린 GPU에서 vLLM의 요청 허용 조건 때문에 캐시된 prefix가 없는 긴 프롬프트가 계속 대기했다. 서버 옵션 하나로 해결했고, 얼마 뒤 주최 측도 같은 옵션을 기본값으로 바꿨다. |
| 한 저장소에서는 빈 패치로도 모든 과제가 해결됐다고 나왔다. | 테스트가 작업 디렉터리 대신 설치된 패키지를 import했다. 공식 sandbox 준비 절차를 실행하도록 고쳐 해결했다. |
| 과제 목록이 비었는데도 실행이 성공했다고 나왔다. | 0개 중 0개를 처리한 실행을 완료로 계산했다. |
| resolved이면 지정한 필수 테스트가 모두 정확히 실행됐다고 보았다. | 현재 verifier를 재현해 보니 prefix·이름 매칭 때문에 다른 테스트로도 필수 항목을 충족한 것으로 처리될 수 있었다. resolved는 해당 verifier의 결과이며, 별도의 정답 판정은 아니다. |
기본 확인은 수정 전 저장소가 실패하고 reference patch를 적용하면 통과하는지 보는 것이다. 환경 준비와 채점의 중요한 오류를 찾을 수 있지만 이것만으로 충분하지는 않다. 필수 테스트 이름을 잘못 매칭하는 오류는 두 대조군이 예상대로 나오더라도 남을 수 있다. 그런 오류에는 해당 동작을 겨냥한 negative control이 필요하다. GPU 실행 묶음에 앞서, 정해진 응답을 내는 가짜 모델로 전체 경로를 실행해 한 과제는 해결, 다른 과제는 미해결로 나오는지도 확인한다.
패치를 수집한 뒤 Docker에서 다시 채점하면 subprocess와 다른 경로에서도 같은 결과가 나오는지 볼 수 있다. v28의 한 로컬 조건에서는 검증을 마친 replay 137건이 모두 원래 subprocess 판정과 같았다. 실행은 했으나 검증을 마치지 못한 replay 28건은 별도로 남겼다.
이 일치를 모든 runtime에 적용할 수는 없었다. v29에서 변경된 패치를 후속 조사했을 때는 계획한 35건 중 34건을 실행했고, 28건은 검증을 마쳤다. 이 28건 중 두 이슈에 해당하는 6번의 시도는 원래 판정과 달랐다. 보호 대상 테스트·설정 변경을 걸러 내는 동작은 이 차이와 부합했다. 다만 이 조사에서 전체 과제를 다시 채점한 것은 아니다. 어느 조건에서 일치했는지를 기록해야, 그 조건이 바뀐 뒤에도 과거의 검증 결과를 그대로 믿는 일을 피할 수 있다.
표 4. 로컬 평가 구성과 실행 전 확인 사항.
| 구성 요소 | 현재 방식 |
|---|---|
| 장비 | 빌린 RTX 6000 Ada(48 GB) 한 장에서 tensor parallelism 1로 공식 wheelhouse 사본을 서빙한다. Kaggle의 L4 네 장과 compute capability는 같지만, Kaggle의 주간 할당량으로 반복 실험을 이어 가기에는 부족했다. |
| 실행 전 확인 | 위의 가짜 모델 경로 검사와 과제별 대조군 확인을 실행 묶음마다 통과해야 한다. |
| 실행 조건 기록 | 모든 결과에 1절의 fingerprint를 남긴다. |
| 결과 해석 | checkpoint마다 관찰한 사실과 잠정 해석을 남기고, 이후 근거가 나오면 수정한다. |
현재 verifier에서는 필수 테스트 매칭의 경계 사례도 재현됐다. 이와 별개로 로컬 subprocess backend가 일부 셸 문자열 리터럴 안의 작업 경로까지 치환하는 동작도 확인했다. 재현 기록에는 해당 runtime과 적용 범위를 함께 남긴다. 이런 문제를 찾았다고 지금까지의 판정이 모두 틀렸다고 할 수는 없다. 로컬의 경로 치환 문제가 비공개 Docker sandbox에서도 발생한다고 볼 근거도 없다.
접근 권한의 한계도 있다. 로컬 sandbox에서 에이전트는 평가기와 같은 사용자로 실행되므로 셸을 통해 reference 자료를 읽을 가능성이 있다. 점검한 trace에서는 그런 기록을 찾지 못했다. 하지만 trace는 이벤트 로그이지 모든 파일 접근을 감시한 기록은 아니다. 어떤 자료를 사용했는지 기록하는 것과 실제 접근을 막는 것도 다르다.
접근 권한 문제와는 별개로, 개발 과정에서 같은 과제를 반복해서 보는 데 따른 영향도 관리해야 한다. 공개 과제 25개는 기록된 모델 실행에서 제외하고, 나머지 과제는 설계·분석·학습 중 어디에 사용했는지 관리한다. 평가에 쓸 과제를 남겨 두기 위한 조치다. 모델의 사전 학습에 포함되지 않았다고 보장하거나 모든 간접 파일 읽기를 배제하는 것은 아니다.
7. 호스트 점수로 어디까지 알 수 있을까
로컬 평가의 조건을 확인했더라도 마지막 판단은 호스트 점수와 연결해야 한다. 그런데 그 점수 자체가 얼마나 많은 정보를 주는지도 살펴봐야 한다. 우선 리더보드에 표시된 점수는 다음 식과 맞는다.
\[\mathrm{displayed}(k) = \frac{\lfloor 100k/58 \rfloor}{100}, \qquad k = 0, 1, \ldots, 14.\]이 식에서는 6개 해결이 0.10, 9개가 0.15, 11개가 0.18, 14개가 0.24에 해당한다. 주최 측은 Public 과제가 약 60개라고 안내했다. 대회 metadata에서는 소수점 둘째 자리 아래를 버려 표시한다는 것을 확인했지만, 정확한 Public 과제 수는 공개하지 않았다. 58개라는 해석은 스냅샷과 일치할 뿐 실제 과제 목록으로 확인한 값은 아니다. 아래의 과제 수 환산도 이 해석을 전제로 한다.
같은 조건으로 분류한 두 제출에서도 점수는 달랐다. 기준 번들에서 예산 안내만 지운 변형 E0053의 동일한 ZIP이, HE-11에 배정된 두 제출에서 0.10과 0.15를 받았다. 파일은 바이트 단위로 같았고 관찰한 공개 호스트 fingerprint도 같았다. 하지만 비공개 과제별 결과, 서빙 로그, 실제 배포 기록은 없다. 따라서 차이가 무작위 실행 변동 때문이라고 단정할 수는 없다. 이 두 제출에서 같은 파일이 같은 합산 점수를 내지 않았다는 사실까지는 확인했다.
실행마다 생기는 변동을 모형으로 생각해 보자. 과제 $i$를 해결할 확률을 $\pi_i$, 해결한 과제 수를 $K_{\mathrm{solves}}=\sum_iY_i$라고 하면 일반적으로 다음과 같다.
\[\operatorname{Var}(K_{\mathrm{solves}})=\sum_i\pi_i(1-\pi_i)+2\sum_{i<j}\operatorname{Cov}(Y_i,Y_j).\]각 과제의 결과가 서로 독립이라고 가정하면 공분산 항을 뺄 수 있다. 서버 상태나 남은 시간처럼 여러 과제에 함께 영향을 주는 요인이 있으면 이 가정이 깨질 수 있다. 합산 점수 두 개로는 각 $\pi_i$나 공분산을 알아낼 수 없고, 일반적으로 쓸 만한 표준편차도 추정할 수 없다. 특히 이 점수 차이를 호스트에 과제 두 개 정도의 노이즈가 있다는 측정 결과로 읽어서는 안 된다.
변동이 어느 정도라면 비교가 얼마나 어려워질까? 두 번들의 실행 결과가 서로 독립이고, 같은 표준편차 $\sigma$를 가지며 그 값을 안다고 가정하자. 오차를 정규분포로 근사할 수 있다면, 기대 해결 수가 $\Delta$만큼 다른 두 번들을 한 번씩 실행해 우열을 올바르게 판단할 확률은 다음과 같다.
\[\Pr(\text{correct order})\approx\Phi\!\left(\frac{\Delta}{\sigma\sqrt{2}}\right).\]표 5. 변동 폭을 가정했을 때 두 번들의 우열을 올바르게 판단할 확률.
| 가정한 기대 해결 수의 차이 $\Delta$ | $\sigma=1$일 때 | $\sigma=1.5$일 때 | $\sigma=2$일 때 |
|---|---|---|---|
| 과제 1개 | 0.76 | 0.68 | 0.64 |
| 과제 2개 | 0.92 | 0.83 | 0.76 |
| 과제 3개 | 0.98 | 0.92 | 0.86 |
여기서 $\Phi$는 표준정규분포의 CDF다. 표의 표준편차는 우리 제출에서 추정한 값이 아니라 계산을 위해 가정한 값이다. 이 정도 변동이 있다면 작은 개선은 점수에 가려질 수 있음을 보여 준다. 반대로 차이를 발견하지 못했다고 두 번들의 성능이 같다고 할 수도 없다. 그래서 최고 점수, 관찰한 점수 차이, 유의하지 않은 검정만으로 기대 순위를 정하지 않고 각 제출의 결과를 그대로 남긴다.
Public과 Private의 차이는 다른 문제다. 같은 Public 과제에서 실행 결과가 달라지는 것과, 아예 다른 과제로 평가받는 것은 구분해야 한다. 과제를 독립적으로 뽑고 해결률이 $p$, Public이 58개, Private이 60개라고 가정하면 두 해결률 차이의 표준편차는 다음과 같다.
\[\operatorname{SD}(\hat p_{\mathrm{Public}}-\hat p_{\mathrm{Private}}) \approx\sqrt{p(1-p)\left(\frac{1}{58}+\frac{1}{60}\right)}\approx0.072 \quad (p=0.19).\]이는 서로 다른 과제 표본에서 생기는 차이를 계산한 것이다. 같은 과제에 여러 번 제출했을 때의 변동을 계산한 값이 아니다. 실제 split 구성 방식과 과제 간 의존성을 모르므로, 0.072를 이 대회의 변동 예측이나 신뢰구간으로 사용할 수는 없다.
8. 같은 과제로 비교해도 주의할 점이 있다
로컬에서는 두 번들에 같은 과제를 주고 seed를 기록하며 실행 순서를 번갈아 가며 비교한다. 이렇게 조건을 맞추면 어느 과제에서 결과가 달라졌는지 볼 수 있다. 다만 같은 과제를 seed 두 개로 실행한다고 독립된 과제가 두 개 생기는 것은 아니다.
두 번들이 모두 성공하거나 모두 실패한 과제는 어느 쪽이 나은지 구분해 주지 않는다. 차이를 보여 주는 것은 한쪽만 해결한 과제다. 각 비교 쌍이 서로 독립이고, 결과가 갈린 쌍이 $d$개, 그중 후보가 이긴 쌍이 $g$개라면 정확한 양측 부호검정은 다음과 같다.
\[p=\min\!\left(1,\;2\sum_{j=\max(g,\,d-g)}^{d}\binom{d}{j}2^{-d}\right).\]2승 0패면 $p=0.5$, 6승 1패면 $p=0.125$다. 다만 같은 이슈에서의 승리가 반복해서 포함됐다면 뒤의 값을 과제 단위 검정으로 곧바로 적용할 수 없다. 아래 표는 해결한 시도 수를 보고한 것이다. 과제별로 무엇이 달라졌는지는 따로 살펴봐야 한다.
현재 기준 번들은 도구 호출 28번, 세션당 8분, thinking 4,096토큰을 허용하며 프롬프트에 짧은 예산 안내가 들어 있다. 같은 파일로 0.15, 0.15, 0.15, 0.17, 0.18을 받았지만 여러 호스트 epoch에 걸친 결과다. 어느 epoch인지 모호한 구간도 포함된다. 이 가운데 명확한 HE-11 기준 제출은 한 번뿐이다. 같은 환경에서 다섯 번 반복한 결과로 볼 수 없다.
표 6. Budget-Fit 기준 번들에서 바꿔 본 설정들. 해결한 시도 수를 보고했으며, 행마다 비교 조건이 다르다.
| 기준에서 바꾼 내용 | 로컬 해결 시도 수: 기준 → 변형 | 호스트 결과 |
|---|---|---|
| 701바이트의 예산 안내 삭제 | 17/44 → 22/44. 과제 22개, seed 2개. 기준만 해결 1회, 변형만 해결 6회 | 같은 후보 ZIP이 HE-11에서 0.10, 0.15를 받음 |
| 이전 thought를 대화 기록에서 제거 | 17/44 → 17/44. 과제 22개, seed 2개 | kernel run timeout으로 점수 없음 |
| 도구 호출을 28번에서 36번으로 늘림 | 17/44 → 14/44. 과제 22개, seed 2개 | 제출하지 않음 |
| greedy decoding(temperature 0) | 14/44 → 16/44. 기준도 새로 실행. 과제 22개, seed 2개 | 제출하지 않음 |
| 원저자 페이지의 최고 표시 점수가 0.22인 더 긴 공개 프롬프트 사용 | 17/40 → 16/40. 외부 과제 40개, seed 1개 | 우리가 제출한 패키지는 0.17. 원저자의 최고 점수는 조건을 맞춘 대조군이 아님 |
| 같은 설정에서 12B 사용 | 17/44 → 11/44. 과제 22개, seed 2개 | 제출하지 않음 |
각 행은 별도의 비교이며, 하나의 공통 실험에서 얻은 결과가 아니다. 40개 과제에서 얻은 값은 잠정 결과로만 보고하며, 확증 실험을 마친 결과로는 사용하지 않는다. 앞선 비교 중에는 runtime 조건이 다른 것도 있다. 중단하거나 다음 단계로 넘어갈 규칙을 미리 정한 경우도 있지만, 예산 안내 변형의 판단 기준은 이미 세 실행 묶음의 결과를 본 뒤 제안했다. 이를 사전 등록한 검정으로 소개할 수는 없다.
10월 17일 검토 시점까지 후보 설계 7개에 약 51시간의 pod 사용 시간을 측정했으나 기준 번들을 대체할 후보를 고르지 못했다. 여기에는 paired comparison뿐 아니라 초기 선별과 소규모 canary도 포함된다. 그 시점까지의 투자 결과를 정리한 수치이며, 동일 조건의 7개 arm 검정이나 현재까지의 누적 비용이 아니다.
로컬의 개선은 호스트에서도 유지됐을까? 기준 번들은 기록된 공개 패널에서 시도의 약 36%를 해결했다. 외부 과제의 원래 두 seed 비교에서는 Pallets 계열 저장소 6곳에서 고른 과제 40개를 80번 시도해 31번, 즉 38.75%를 해결했다. 이 외부 과제 40개를 X40 패널이라고 부른다. 명확한 HE-11 호스트 기준 결과는 0.18이다. Public 과제가 58개라는 해석을 적용하면 11/58, 약 19%다.
로컬 해결률이 호스트의 두 배쯤 된다고 해서 다음 변경의 효과도 일정 비율로 옮겨 간다고 볼 수는 없다. 과제 모집단, 사용·노출 이력, 장비, 실험 절차가 모두 다르다. 주최 측도 강한 모델로 풀 수 있는지 확인해 비공개 과제를 골랐다고 했지, 그 모델에게 어렵도록 골랐다고 하지는 않았다. 두 해결률을 나눈 값은 아직 효과를 환산할 계수가 아니다.
예산 안내를 지운 변형에서도 이 한계가 드러난다. 한 비교에서는 22/44를 해결했지만 나중의 로컬 실행에서는 13/44였다. runtime과 seed가 모두 바뀌었고, 뒤의 실행에는 조건을 맞춘 E0052 대조군도 없었다. 이 차이만으로 runtime이 성능을 떨어뜨렸다고 말할 수는 없다. 호스트 점수 0.10과 0.15도 이 변형이 더 낫거나 같다는 것을 입증하지 못한다. 현재로서는 로컬에서 본 개선이 호스트에서도 유지된다고 확인하지 못했으므로 수정하지 않은 기준 번들을 계속 사용한다.
9. 12시간 제한에서는 해결률과 완주 가능성을 함께 봐야 한다
앞의 비교에는 해결 수 외에 고려해야 할 실패가 하나 더 있다. 개별 과제를 몇 개 더 해결하더라도 전체 실행이 시간 안에 끝나지 않으면 점수를 받지 못한다.
1편에서는 전체 패치 생성 시간을 공통 부대 시간과 과제별 준비·작업 시간으로 나눴다. Public과 Private을 합친 전체 과제 수를 $N_{\mathrm{all}}$이라고 하면 $T=h+\sum_{i=1}^{N_{\mathrm{all}}}(s_i+a_i)$다. $s_i$는 과제 준비와 한도에 포함되는 기타 부대 시간, $a_i$는 에이전트 작업 시간, $h$는 공통 부대 시간이다. 12시간을 넘기면 완료한 부분만 채점하는 대신 제출 전체가 오류로 끝난다.
2절에서는 한 과제에서 패치를 전달하고 해결하는 확률을 나눴다. 여기서는 제출 전체가 시간 안에 끝나는지를 한 단계 더 고려한다. 아래 예시에서는 Public의 실제 해결 비율을 $S_{\mathrm{Public}}$이라고 하자. 계획용 지표 $U$는 전체 실행을 마치면 이 비율을 쓰고, 시간 제한으로 실패하면 0으로 계산한다. 완주 여부는 두 split 전체를 대상으로 판단하고, 이 예시의 성능은 Public 과제만으로 계산하는 것이다. 이 0은 계획을 위해 정한 값이다. Kaggle이 오류 난 제출에 0점을 준다는 뜻은 아니다. 그러면 다음과 같다.
\[\mathbb{E}[U]=\Pr(T\le H)\,\mathbb{E}[S_{\mathrm{Public}}\mid T\le H], \qquad H=720\text{ minutes}.\]예시로 과제별 총시간 $s_i+a_i$가 서로 독립이고, 평균 $\mu$와 표준편차 $\sigma$가 같다고 가정하자. 정규 근사를 적용하면 다음과 같다.
\[\Pr(T\le H)\approx\Phi\!\left(\frac{H-h-N_{\mathrm{all}}\mu}{\sigma\sqrt{N_{\mathrm{all}}}}\right).\]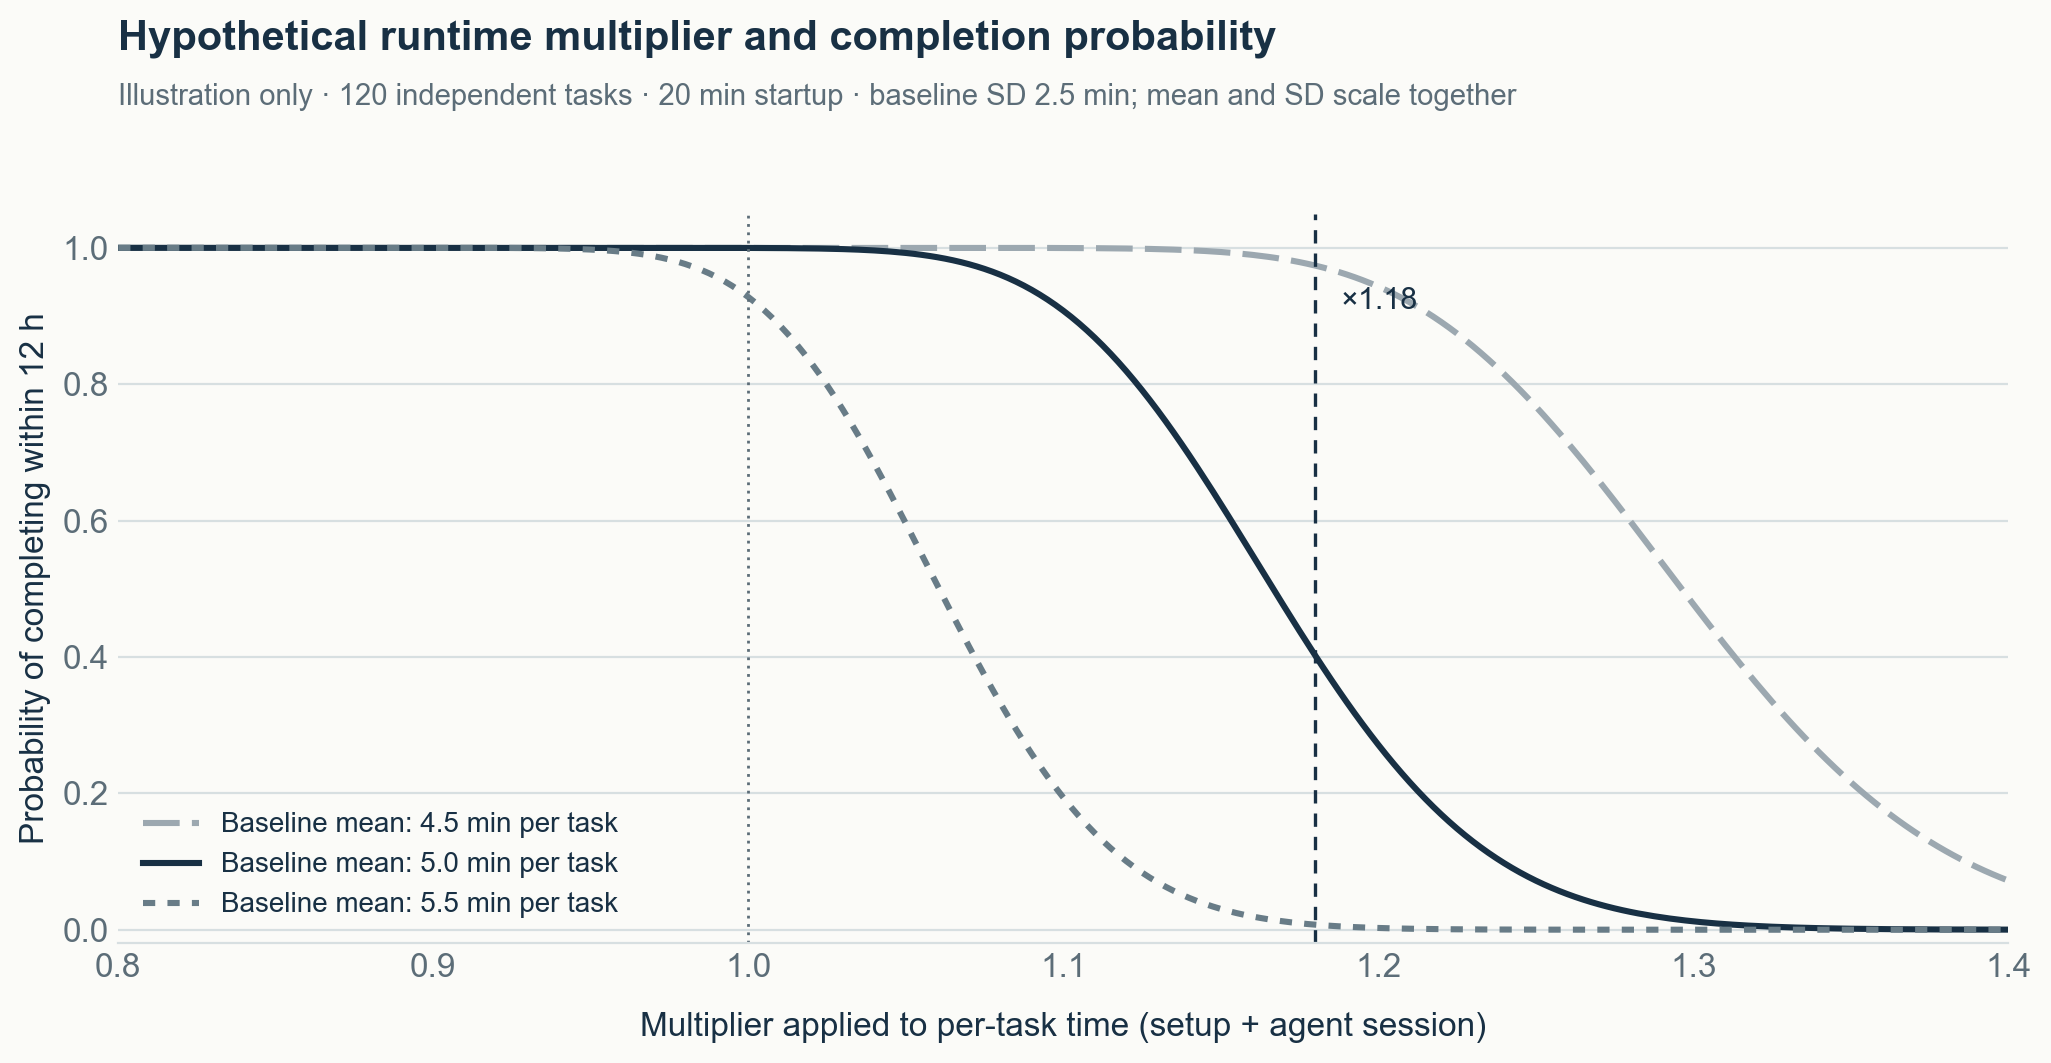 그림 5. 호스트를 측정한 값이 아니라 가정에 따른 시간 모형이다. 서로 독립인 과제 120개, 기준 표준편차 2.5분, 공통 시작 시간 20분을 사용했다. 과제별 시간을 늘릴 때는 평균과 표준편차를 함께 같은 비율로 늘린다. 세 곡선의 기준 평균은 각각 4.5분, 5.0분, 5.5분이다.
기준 평균이 5.0분일 때 모든 과제 시간을 1.18배로 늘리면, 이 모형의 완주 확률은 거의 1에서 약 0.40으로 떨어진다. 완주했을 때의 Public 해결률은 11/58에서 12/58로 좋아졌다고 해 보자. 표시 점수가 아닌 실제 비율로 통일해 계산하면 $U$의 기대값은 약 $0.40\times(12/58)\approx0.083$이다. 거의 항상 완주하는 기준의 $11/58\approx0.190$보다 작다. 원래 기대값을 유지하려면 완주 확률이 $11/12\approx0.917$ 이상이어야 한다. 소수점 아래를 버린 표시 점수와 실제 비율을 섞으면 이 기준도 잘못 계산하게 된다.
과제별 시간에 상관이 있다면 총시간의 분산에 공분산 항이 들어가고 곡선도 달라진다. 호스트의 과제별 시간과 공통 부대 시간을 모르므로 이 그림으로 안전한 지연 비율을 정할 수는 없다.
실험 기록에는 주의할 만한 사례가 있다. 이전 thought를 지운 변형은 로컬에서 기준과 같은 17/44를 해결했지만, 측정한 에이전트 세션 시간은 약 18% 늘었다. 이후 호스트 실행은 시간 초과로 끝났다. 시간 초과 위험을 의심할 만한 사례지만, 로컬의 세션 시간 증가가 호스트 시간 초과의 원인이었다고 확인한 것은 아니다. TP1 Ada에서 얻은 세션 시간 비율을 TP4 호스트의 모든 과제 시간에 그대로 적용할 수 없고, 환경 준비 시간을 측정한 것도 아니다. 특히 1.05배나 1.10배 미만이면 안전하다는 기준을 검증한 적은 없다.
기준 번들의 8분 상한도 완주를 보장하지 않는다. 환경 준비를 빼고도 $120\times8=960$분까지 가능하다. 성공한 제출이 있었다는 것은 모든 과제에서 상한을 다 쓰지는 않았다는 뜻이다. 실제로 시간이 얼마나 남았는지는 여전히 모른다.
10. 에이전트가 스스로 검사해도 남는 문제
thinking과 새로운 도구 오류 처리 덕분에 초기 실패 중 일부는 줄었다. 그다음에는 패치를 만들고도 문제를 해결하지 못하는 경우를 살펴봤다. 외부 과제 40개에서 기준 번들을 140번 시도했을 때, 오류가 다섯 호출 이상 이어진 경우는 5번이었고 모두 미해결이었다. 이 140번에는 서로 다른 세 실험 묶음의 결과와 정식 최종 비교로 인정한 범위 밖의 시도가 포함돼 있다. 새로운 평가 표본으로 볼 수는 없다.
에이전트가 검사한 동작을 $C$, 평가기의 테스트가 요구하는 동작을 $R$이라고 하자. $C$를 확인했다고 $R$까지 확인한 것은 아니다. 자체 검사 하나가 모든 비공개 assertion을 논리적으로 보장해야 한다는 뜻은 아니다. 그래도 관련 요구사항을 확인하는 검사여야 하고, 검사한 코드가 실제 최종 코드와 같아야 한다.
우선 무엇을 고쳤는지 분류했다. 검증에 실패한 시도 69번 중 52번은 reference fix가 고친 파일을 하나 이상 수정했다. 과제로는 19개에 걸쳐 있다. 가장 큰 묶음이지만, 이 수만으로 실패 원인을 알 수는 없다. 그중 33번에서는 수정 이후 Python·pytest 계열 명령의 도구 응답이 오류가 아닌 것으로 분류됐다. 하지만 관련 assertion을 실행했는지, 실제 종료 코드가 무엇이었는지, 최종 패치를 검사했는지, 에이전트가 결과를 어떻게 받아들였는지는 확인되지 않았다. 따라서 이 33번을 “자체 테스트는 통과했지만 비공개 테스트는 실패한 경우”로 확정해서는 안 된다. 같은 파일을 고쳤다고 원인을 정확히 찾았다고 할 수도 없다. 다른 파일을 고치는 유효한 해결법도 있을 수 있다.
Rich의 한 사례에서는 검사의 차이를 직접 볼 수 있었다. 너비가 0인 문자와 관련된 이슈에서 에이전트는 함수가 종료하는지 확인했다. 반면 평가기는 단독 variation selector의 정확한 span 값을 검사했다. 저장소의 기존 테스트에는 관련 출력 형식 정보가 있었지만, 찾아본 trace에는 그 부분을 읽은 기록이 없었다. 놓쳤을 수 있는 정보가 있었다는 사례다. 읽기만 했으면 문제를 해결했을 것이라고 확인한 것은 아니다.
문제 설명이 얼마나 자세한지도 살펴봤다. 공개 과제 22개를 네 번 실행한 결과, 설명이 120자 이하인 과제는 32번 중 7번, 더 긴 과제는 56번 중 24번 해결했다. 이를 odds ratio로 정리하면 다음과 같다.
\[\mathrm{OR}=\frac{7/25}{24/32}\approx0.37.\]여기서 $7/25$와 $24/32$는 각각 해결한 시도 수를 실패한 시도 수로 나눈 odds다. 두 해결률을 직접 나눈 값이 아니다. 독립된 과제도 설명이 짧은 8개와 더 긴 14개이지, 88개의 독립된 과제를 비교한 것은 아니다. 설명 길이는 모델이 얻을 수 있는 정보량의 간접 지표에 가깝고, 저장소와 변경 유형도 함께 다르다. 따라서 설명 길이의 인과적 효과나 $p$값을 주장하지 않는다.
요구사항과 검사가 어긋나는 문제를 줄이려는 시도도 했다. 수정 전에 실패하는 검사를 정하고 수정 뒤 그대로 다시 실행하게 했지만, 이 절차를 적용할 수 있었던 8번의 시도 중 끝까지 수행한 것은 1번뿐이었다. 이슈에서 관련 정보를 뽑는 helper도 16번 중 7번은 사용하지 않았다. 앞선 일부 trace에서는 긴 절차보다 짧은 명령 예시를 더 잘 따라 했다. 다음 가설을 세우는 데 참고할 수는 있지만, 예시가 언제나 효과가 있다거나 검사를 하나 더 강제하면 좋아진다는 증거는 아니다.
그렇다면 어떤 예시를 추가해야 할까? GPU를 새로 실행하기 전에 기존 기록에서 구체적인 단서를 찾아봤다. 선정한 8개 사례를 검토했지만, 모델이 볼 수 있었던 정보와 모델의 판단 사이에서 짧은 지시 하나로 바로잡을 만큼 분명한 모순은 찾지 못했다. 6개 사례에서는 평가기가 요구한 세부 사항이 문제 설명에 없었다. 저장소의 다른 맥락에서 알아낼 수 있었을 가능성은 남아 있다. 약한 아이디어 두 개도 남겼다.
하지만 이 검토만으로 새 변경안을 실행할 근거는 부족했다. 그래서 이슈의 시나리오에 더 맞는 검사를 하게 하려던 변경안은 보류했다. reference 파일과 겹친 실패가 52번 있었다는 사실이, 곧바로 고칠 수 있는 실패 52번을 뜻하지는 않기 때문이다.
11. adapter와 작은 모델: 실행 준비와 성능 검증은 별개다
프롬프트만으로 해결하기 어려운 행동이라면 학습을 검토할 수 있다. 다만 adapter를 학습할 수 있는지, 서버가 실제로 적용하는지, 제한 시간 안에 실행되는지, 코드 수정 성능이 좋아지는지는 각각 확인해야 한다.
주최 측은 9월 27일 LoRA 문제를 수정했다고 알렸고, 이후 rank 64 이하 adapter로 점수가 나온 사례도 있다고 밝혔다. 해당 환경에서 실행 가능한 경로가 있다는 근거다. 모든 adapter가 자원에 맞거나 코드 수정 성능을 높인다는 보장은 아니다. 다른 참가자들이 보고한 서빙 비용 증가와 KV 용량 감소도 참고할 만하지만, 우리 패키지에서 측정한 값은 아니다.
데이터 상황은 초기 trajectory 조사 때와 달라졌다. 10월 22일에는 공개 과제 37개에서 해결에 성공한 기준 번들의 trajectory 65개로 학습 데이터 S1을 만들었다. 데이터에는 호출별 sample 1,239개, target token 259,576개, forward token 10,938,513개가 있다. forward token에는 학습할 때 처리하는 context도 포함된다. 정답 출력으로 supervision을 주는 토큰 수와는 다르다.
호출별로 나눈 이유는 모델이 실제로 받은 입력에 맞추기 위해서다. 다음 요청을 만들 때 이전 대화가 다시 렌더링되므로, 기록된 출력을 그대로 이어 붙인 형태와 실제 다음 prompt가 일치하지 않는다. 원시 출력을 긴 chain 하나로 합치면 모델이 받은 적 없는 context를 학습시킬 수 있다. S1은 sample마다 실제로 전달한 prompt와 출력의 token ID를 보존하고, 출력에만 supervision을 적용한다.
tokenizer로 token ID를 다시 풀어 입력 형식을 확인하는 작업과, 31B 모델에 LoRA를 적용해 실제로 학습하는 단계는 아직 남아 있다. 실험에 이미 사용한 과제 중 학습에 쓰기로 한 범위는 이제 학습용으로 배정했다. X40과 모델을 실행하지 않은 25개 과제 holdout은 제외했다. S1 안에서 loss를 확인하기 위해 나눈 6개 과제는 코드 수정 성능을 평가할 holdout과 별개다.
호스트에서 끝까지 실행되는지부터 확인하려고 기준 번들에 모든 값이 0인 rank-16 adapter를 붙여 제출했다. 제출 후 약 25분 만에 오류가 났고 이 시간에는 대기도 포함된다. 원인은 모른다. 새로 확인한 운영진 답변은 같은 시기의 플랫폼 장애를 인정하고 영향받은 제출을 다시 실행하겠다고 했다. 하지만 우리 실패가 그 장애 때문이라고 연결해 줄 로그는 없다. 완주 여부, adapter 활성화, 학습 처리량, 수정 성능은 별개의 질문이다. 학습한 adapter의 성능 비교는 아직 하지 않았으며 큰 규모의 학습 투자도 계속 보류하고 있다.
작은 모델도 검토했다. 같은 기준 설정에서 12B는 11/44, 31B는 17/44를 해결했다. 이 설정에서의 결과이지 모든 조건에 적용할 모델 순위는 아니다. USD 10,000의 E2B/E4B 보너스는 별도 기회다. 다만 보너스 대상이 되려면 팀의 최종 제출 두 개 중 하나로 선택해야 한다.
10월 23일 09:01 KST, 기준 번들의 모델을 E4B로 바꾸고 출처와 변경 사항을 밝힌 버전을 제출했다. 확인한 기록은 PENDING이다. 날짜가 명시된 작은 모델 순위 스냅샷에서는 최고 Public 점수가 0.06이었다. 새 제출은 아직 점수가 없으며, 최종 제출로 선택하기로 한 것도 아니다.
12. 1편의 세 가지 시나리오를 다시 보면
- 모델보다 도구 사용과 작업 순서가 문제인 경우. 초기의 반복, 잘못된 호출, context 오류가 이 경우에 해당할 수 있다. 길이를 제한한 thinking과 주최 측 수정이 특정 비교에서는 도움이 됐다. 다만 전체 이력에서 각각 얼마나 기여했는지 분리해 측정하지는 못했다.
- 작업 절차는 동작하지만 수정 오류가 반복되는 경우. 실패한 패치 중 reference fix와 같은 파일을 건드린 것이 많았다. 그렇다고 원인 위치를 잘못 찾은 것인지, 요구사항을 놓쳤는지, 모델의 능력이나 시간이 부족했는지 구분되지는 않는다. 한정된 사례에서 작은 변경으로 해결할 단서를 찾아봤지만 바로 적용할 방안은 얻지 못했다.
- 로컬의 개선이 낯선 과제에서는 유지되지 않는 경우. 과제 모집단과 절차가 다르고, 로컬과 호스트에서 관찰한 우열이 달라진 경우도 있다. 같은 파일의 호스트 점수도 변했다. 로컬 개선을 주장할 때 조건을 함께 밝혀야 하는 이유다. 로컬에서 더 푼 수를 비공개 과제의 해결 수로 환산할 관계를 구한 것은 아니다.
13. 다음에 판단할 것들
현재는 수정하지 않은 기준 번들을 계속 사용한다. 최근 기록 검토에서는 새 프롬프트나 탐색 방식을 시도할 구체적인 근거를 찾지 못했다. 해당 아이디어들은 검토한 범위에 따라 보류하거나, 필요한 근거가 생기면 다시 검토하기로 했다. 다음에 어디에 투자할지 정한 것이지 더 개선할 수 없다고 결론 내린 것은 아니다.
다음 판단에는 무엇이 더 필요한지 정리하면 아래와 같다.
표 7. 다음 판단에 필요한 근거와 현재 상태.
| 질문 | 판단에 필요한 근거 | 현재 상태 |
|---|---|---|
| E4B에 더 투자할 만한가? | 대기 중인 패키지의 완료 여부와 점수. 날짜가 명시된 작은 모델 순위와 비교 | 제출 한 번이 대기 중이다. 우위나 최종 제출 선택은 아직 판단하지 않음 |
| adapter 작업을 재개할까? | 서빙 동작 확인, adapter와 base model의 호환성 검증, 처리량 측정, 비용을 산정한 성능 비교 | S1은 만들었다. zero-adapter 확인은 원인 불명 오류로 끝났으며 학습은 계속 보류 |
| 새 수정 방식을 시도할 근거가 있는가? | 모델이 볼 수 있는 실패 사례와 그것을 다룰 작은 변경안. 예상 비용과 실패할 경우도 확인 | 이슈에 맞는 검사, 수정 후 재검사 시점, 코드 탐색을 살펴본 한정된 조사에서는 필요한 근거를 확보하지 못함 |
| 로컬 시간으로 제출 위험을 가늠할 수 있는가? | 실제 채점과 같은 GPU 구성에서 환경 준비와 전체 과제를 포함한 시간 측정 | 로컬 비율은 경고 신호다. 보편적으로 안전한 비율은 모름 |
| 이 기록으로 연구 글을 쓸 수 있을까? | 관찰, 제외, 해석 변경의 정확한 시간순 기록과 재현 가능한 공개 자료 | 범위를 좁힌 사례 연구를 준비 중이다. 새 에이전트 방법의 효과를 검증한 것은 아님 |
선택 사항인 Paper Track 마감은 11월 12일 23:59 UTC(한국 시간 11월 13일 08:59)다. 현재 근거를 갖춰 쓸 수 있는 것은 실제 측정에 기반한 사례 연구다. 채점 환경이 바뀌고, 로컬 과제는 반복해서 사용하며, 호스트 피드백은 드문 상황에서 에이전트의 변경을 어떻게 비교했는지 다루려 한다. 설득력 있는 글이 되려면 받아들인 결론뿐 아니라, 그럴듯했지만 근거가 부족해 받아들이지 않은 결론도 보여 줘야 한다.
출처
- 대회 개요, 평가 방식, 규칙 · 데이터와 harness 안내 · 공식 평가 wheelhouse
- 주최 측 설명: 순차 채점과 12시간 제한 · distillation · 숨겨진 과제 수 · 다른 open model의 trajectory · 추가 모델 크기 · 채점과 과제 선별 · LoRA 제출 · 12시간 규칙 유지 · 작은 모델 보너스 · 같은 시기의 플랫폼 장애
- Wilmer E. Henao의 Budget-Fit single-agent 번들. Apache 2.0이며 수정 없이 기준으로 사용했다.