RSNA Knee, Part 5: 모델을 쌓는 동안 달라진 대회
그림은 눌러서 확대할 수 있습니다. 좁은 화면에서는 넓은 표와 수식을 좌우로 움직여 보세요.
이번 글에서는
혼자 참가한 이번 대회를 6,425팀 중 560위, Bronze Medal로 마쳤다. 이 글에서는 최종 리더보드와 Public·Private 점수가 모두 나온 제출 154건을 비교한다. 어떤 모델과 학습 라벨이 Private에서도 성능을 높였는지, 막판에는 왜 더 나아가지 못했는지를 살펴본다. 공개 H는 내가 완성한 clean 조합보다 Private에서도 강했다. 내 예측을 섞어 최종 점수를 조금 높이기는 했지만, 자체 시스템이 그보다 약했다는 사실은 남는다. 이 결과를 바탕으로 OOF에 들인 시간과 supervision의 역할, 공개 자료가 바꾼 경쟁의 양상, 그리고 이 과정에서 느낀 허탈함을 돌아본다.
최종 결과
최종 Private AUC는 0.943이었다. 최종 선택한 두 제출 가운데 H의 비중이 큰 rank blend v229가 이 점수를 냈다. Clean S6F의 비중을 높인 자체 조합 v236은 0.941이었다. 다른 제출의 Private까지 공개된 뒤 확인해 보니, 내가 제출한 모든 후보 가운데 표시 점수가 가장 높은 것도 v229였다.
| 후보 | Public | Private |
|---|---|---|
| H 단독, v219 · Public 최고 | 0.958 | 0.942 |
| H + 자체 rank block 25%, v229 · 최종 선택 | 0.957 | 0.943 |
| K-W2, v236 · 최종 선택 | 0.953 | 0.941 |
내 순위는 Public 1,785위에서 Private 560위로 1,225계단 올랐다. 다만 이 순위 변동과 v229의 점수 변화인 0.957 → 0.943은 서로 다른 비교다. 내 Public 최고 점수는 H의 0.958이었고, 최종 Private 점수는 v229에서 나왔다. 팀 리더보드의 Public과 Private가 반드시 같은 제출을 평가한 결과는 아닌 것이다. 아래의 개별 제출 분석에서는 이 차이를 피하기 위해 정확히 같은 제출의 두 점수를 짝지었다.
10월 23일 공식 리더보드와 내 제출 이력을 조회했다. 제출 시도는 177건, 양쪽 점수가 모두 나온 제출은 154건이었다. 그중 한 건은 benchmark 파일을 잘못 제출해 두 점수가 모두 0.500이 된 실행 오류였다. 모델 성능을 해석할 때는 이 건을 나머지 153건과 구분했다. 다른 23건에는 비교할 수 있는 점수 쌍이 없었다. 이 글에서는 Kaggle이 표시한 소수 셋째 자리까지의 값을 그대로 쓴다. 표시 점수가 같다고 예측값이나 실제 AUC까지 정확히 같다는 뜻은 아니다.
Public–Private 순위 변동
상당수 팀에서 Private 점수가 Public보다 낮았다. 전체 6,425팀의 점수를 짝지어 계산한 Private − Public의 중앙값은 −0.016, 중간 절반의 범위는 −0.018에서 −0.015였다. 내 점수 차이 −0.015도 이 분포의 중앙 부근이었다. 점수가 이만큼 떨어진 것 자체는 드문 일이 아니었다.
그렇다고 Public 상위권의 순서가 전부 뒤집힌 것은 아니었다. Public 1위 Barry는 0.970에서 0.957로 내려가 최종 7위가 됐다. Private 1위 Team Kangaroo는 Public 4위, 0.969에서 최종 1위, 0.960으로 마쳤다. Public 상위 열 팀 중 일곱 팀은 Private에서도 상위 열 팀 안에 남았다.
| Public에서의 범위 | Private에서도 같은 범위에 남은 팀 |
|---|---|
| 상위 10팀 | 10팀 중 7팀 |
| 상위 100팀 | 100팀 중 84팀 |
| 상위 500팀 | 500팀 중 418팀 |
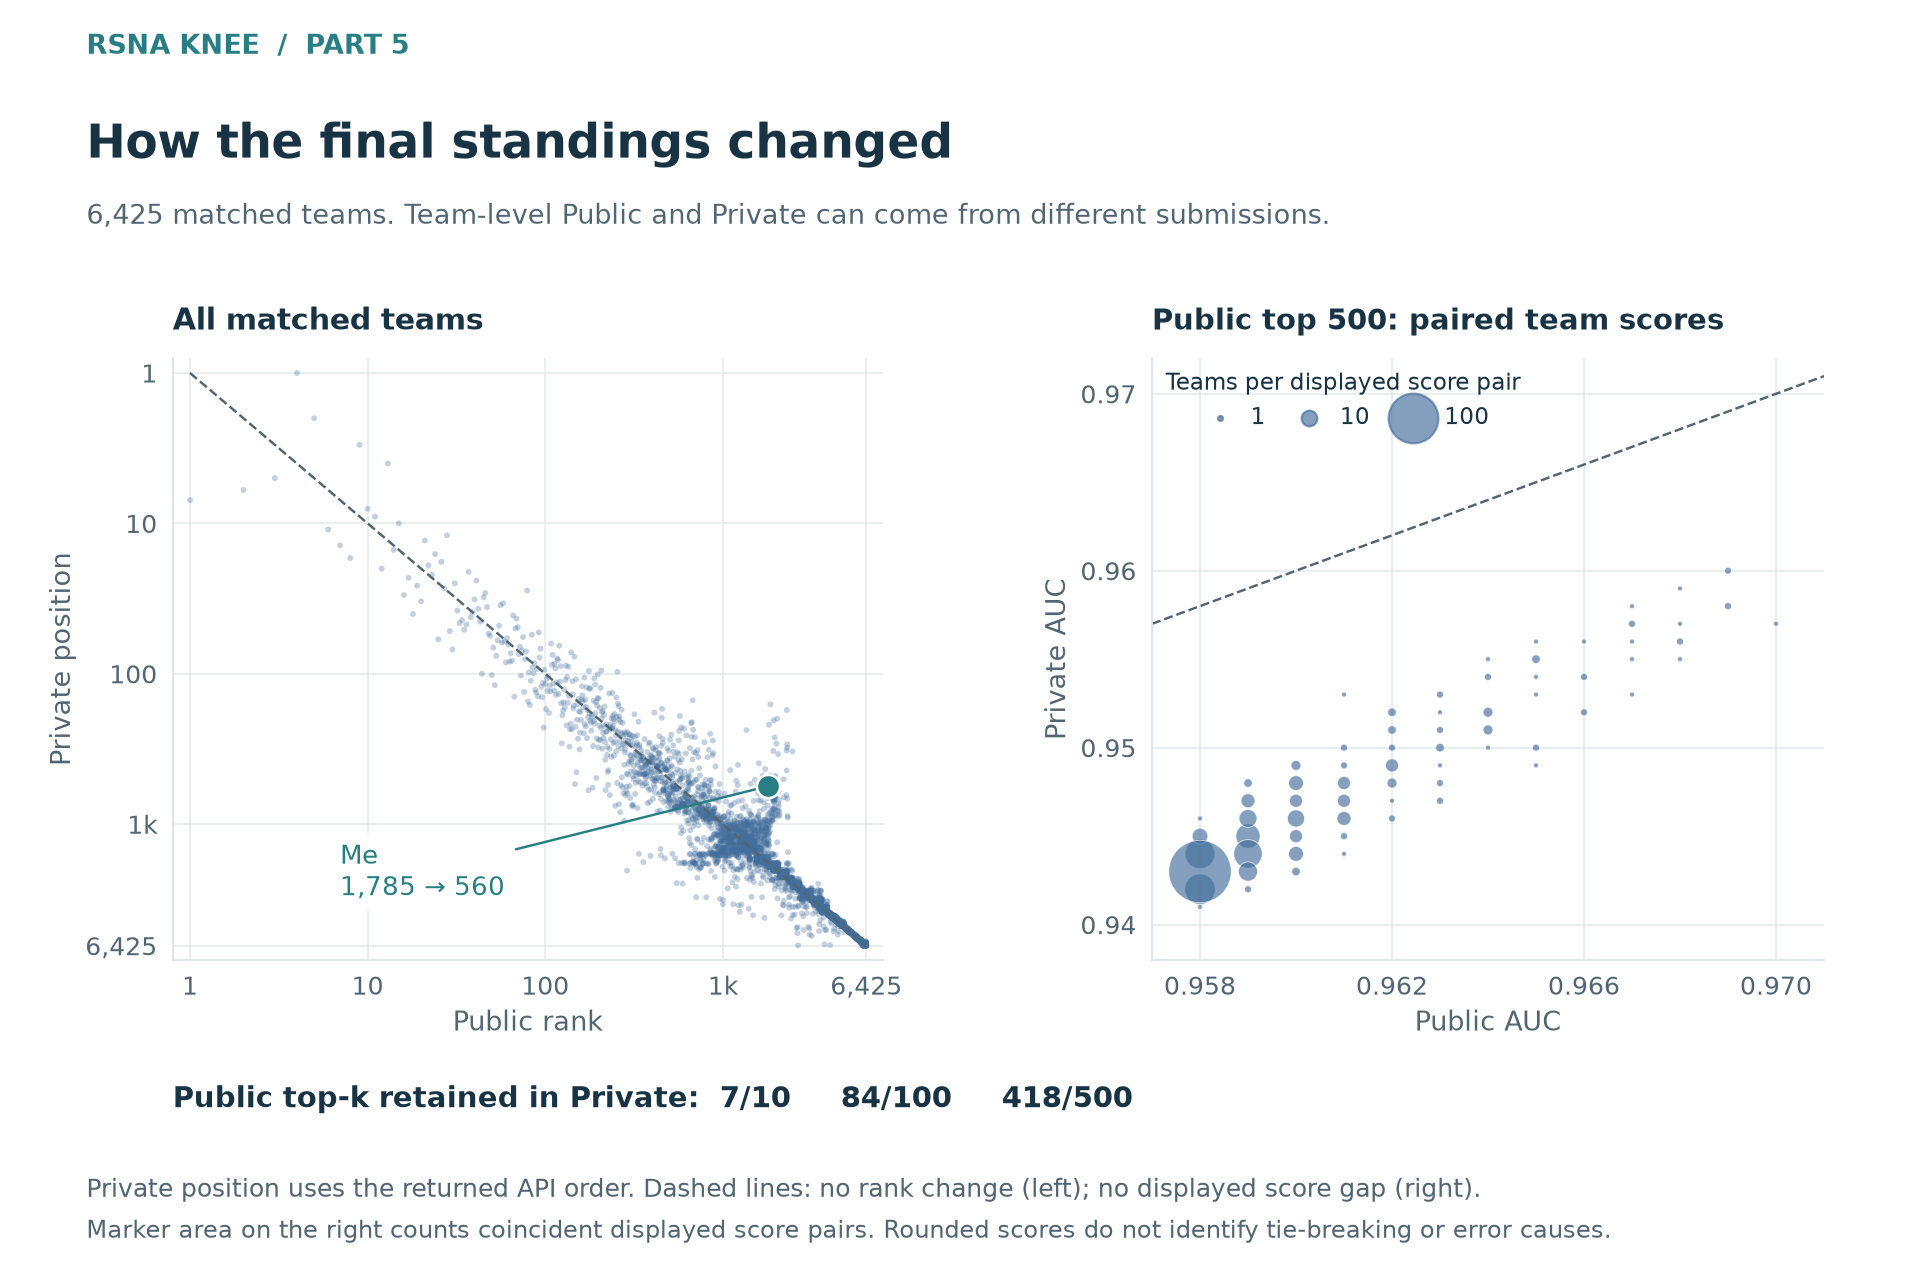
그림 1. Team ID를 기준으로 공식 Public 순위와 전체 Private 리더보드의 순서를 짝지었다. 대각선은 순위나 점수가 변하지 않는 경우를 나타낸다. 점수 패널은 Public 상위 500팀만 다루므로, 이 범위 밖에 있는 내 결과는 순위 패널에만 표시했다. 팀의 Public 최고와 최종 Private 점수는 서로 다른 제출에서 나올 수 있다.
내 결과를 이해하는 데는 Public 0.958 구간도 중요했다. 마지막 snapshot에서 이 점수를 받은 팀은 1,638팀으로, 순위는 257–1,894위에 걸쳐 있었다. 그중 1,239팀의 최종 Private 표시 점수는 0.942였다. 그러나 이 구간 전체의 Private 점수는 0.899에서 0.946, 순위는 150위에서 4,197위까지 퍼졌다. Public 표시 점수가 같다는 사실만으로 최종 예측까지 같다고 볼 수는 없었다.
팀들이 이렇게 몰려 있으면 작은 점수 차이에도 순위가 크게 달라진다. 내 v229는 이 구간에서 가장 흔했던 Private 표시 점수 0.942보다 조금 높은 0.943을 냈다. 이 사실만으로 오른 순위를 모두 설명하거나, 같은 구간의 모든 팀이 notebook을 복사했다고 단정할 수는 없다. 다만 천 계단 넘게 올라왔어도 점수 차이 자체는 작을 수 있다는 점은 분명하다. Public은 성능 차이가 큰 시스템을 구별하는 데는 유용했지만, 점수가 밀집한 후보들 사이의 미세한 우열까지 확실히 알려 주지는 않았다.
개발 과정과 성능 변화
전체 이력을 보면 개선이 Public에만 머문 것은 아니었다. 처음 frozen encoder로 만든 baseline의 Public / Private는 0.711 / 0.680, 최종 선택 제출은 0.957 / 0.943이었다. 각각 0.246과 0.263 올랐다. 개발 과정에서 여러 부분이 함께 바뀌었으므로, 이 차이는 출발점과 최종 결과를 비교한 값이다. 한 가지 기법의 효과를 따로 측정한 것은 아니다.
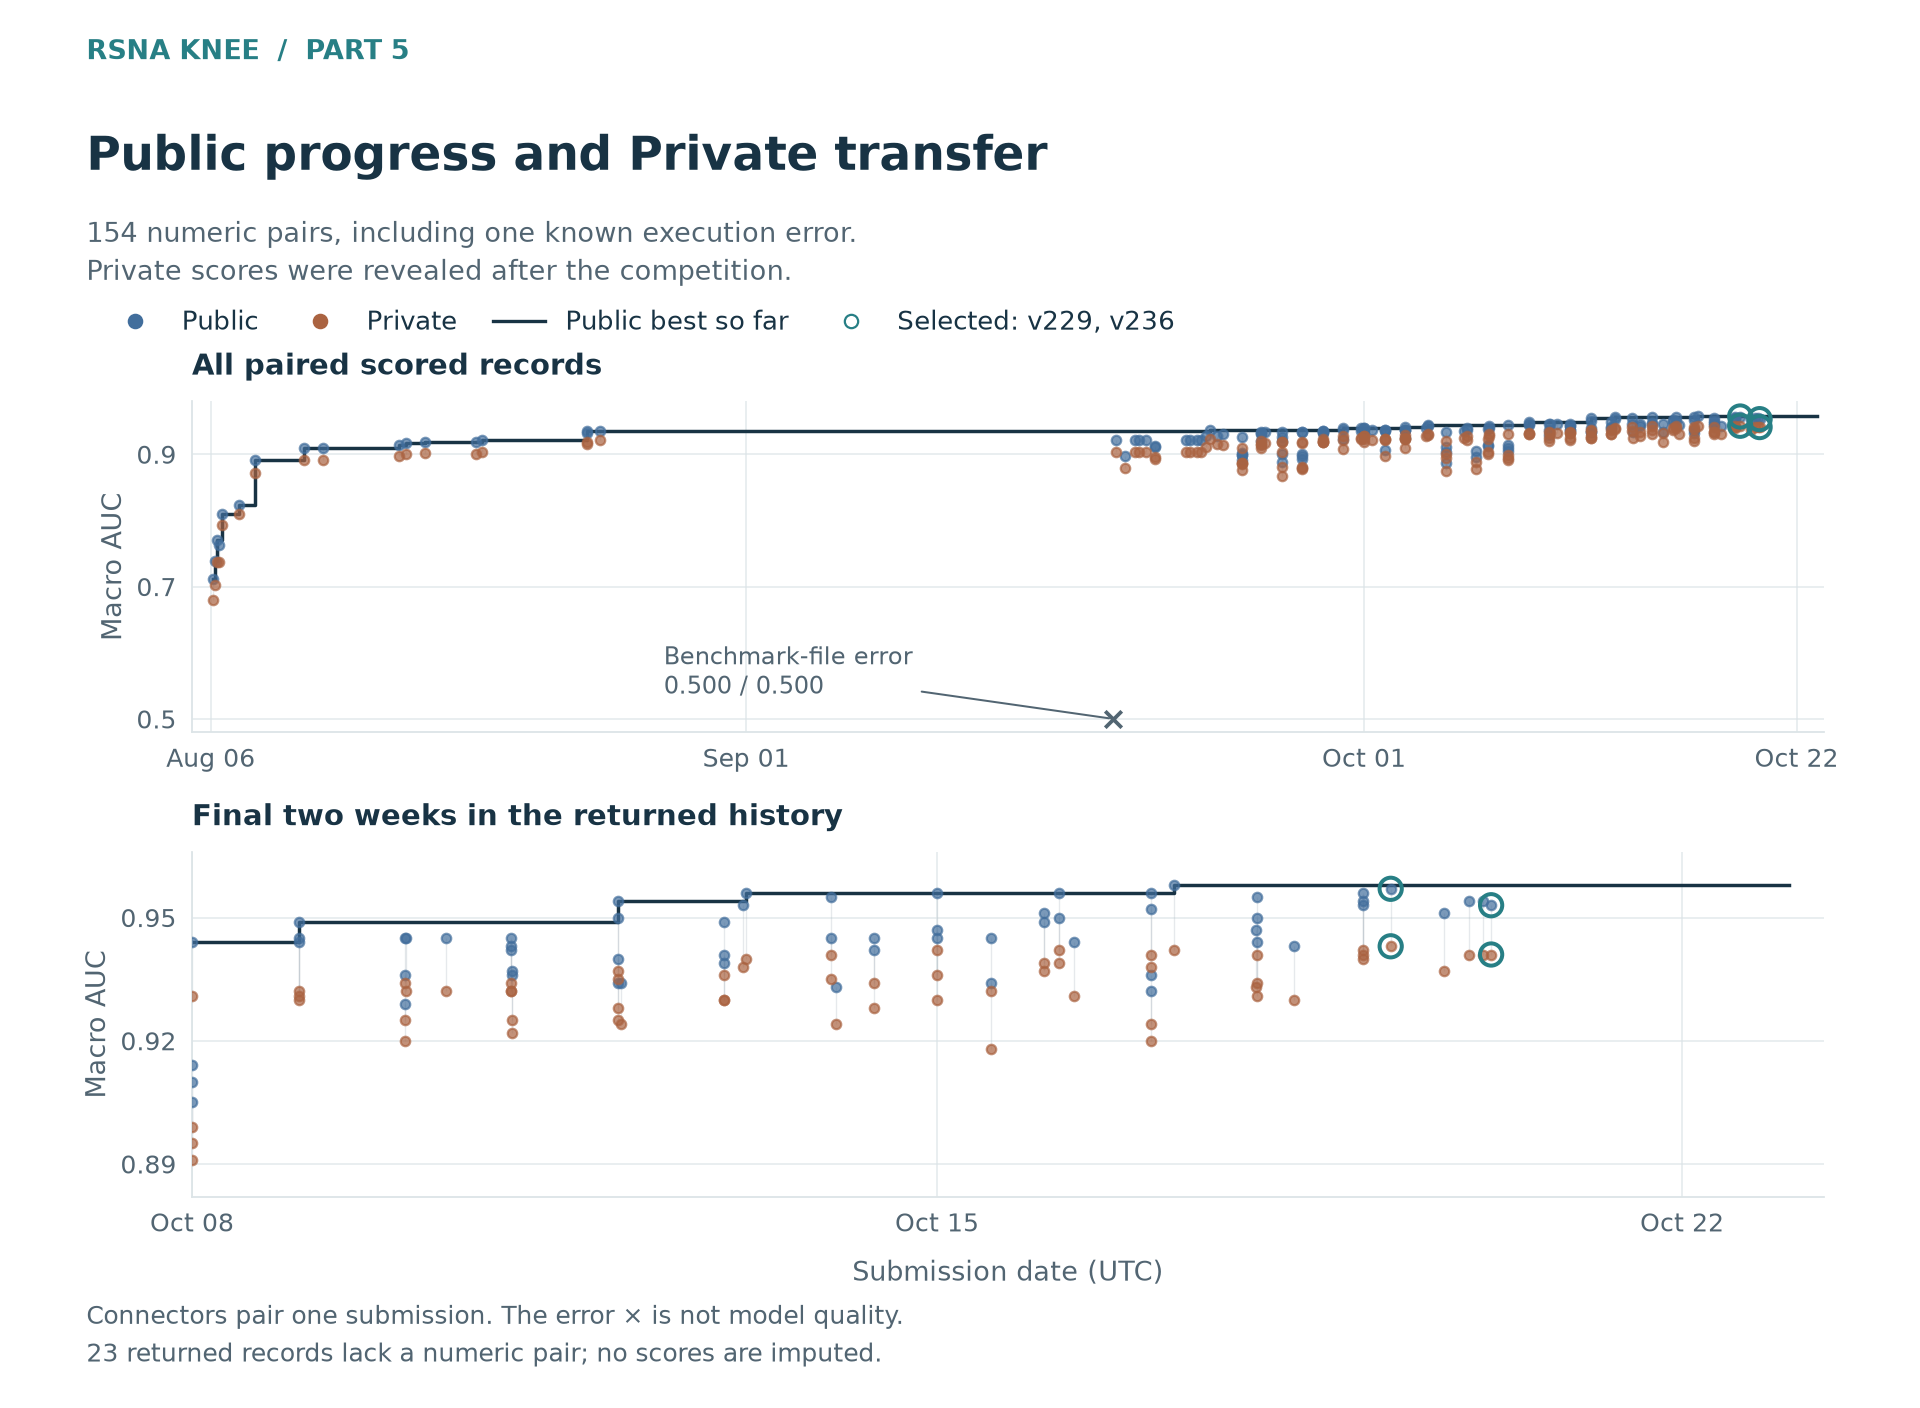
그림 2. 실제 제출 시각을 기준으로 Public과 Private를 표시했다. Private는 마감 후 공개된 값을 나중에 그린 것으로, 당시에는 알 수 없었다. Public 최고 기록을 이은 선도 사후에 Private를 기준으로 고른 결과가 아니다. 점수가 없는 시도를 AUC 0으로 채우지 않았고, 0.500을 기록한 실행 오류는 별도로 표시했다.
| 제출일, UTC | 주요 변경 또는 후보 | Public | Private |
|---|---|---|---|
| 8월 6일 | Frozen DINOv2-S baseline | 0.711 | 0.680 |
| 8월 8일 | Fine-tuned DINOv2-S, 네 seed ensemble | 0.891 | 0.871 |
| 8월 19일 | 자체 package 확장과 보조 모델 | 0.921 | 0.904 |
| 8월 24일 | 공개 CoAtNet과 자체 package 혼합 | 0.935 | 0.921 |
| 9월 30일 | 소형 V3 + DK rank blend, v84 | 0.940 | 0.928 |
| 10월 11일 | 자체 모델군 조합 갱신, v161 | 0.945 | 0.934 |
| 10월 12일 | 공개 R949 + S6 조합, v170 | 0.954 | 0.937 |
| 10월 15일 | Native N, mm12 라벨, v201 | 0.945 | 0.932 |
| 10월 16일 | Native N, T* teacher 라벨, v203 | 0.951 | 0.939 |
| 10월 17일 | Five-fold S6F 재현, v213 | 0.952 | 0.938 |
| 10월 17일 | 공개 H 구성, v219 | 0.958 | 0.942 |
| 10월 19일 | S6F + N + V3, K-W v231 | 0.954 | 0.941 |
| 10월 19일 | H + 자체 rank block 25%, v229 | 0.957 | 0.943 |
| 10월 20일 | 두 번째 S6F seed, K-W2 v236 | 0.953 | 0.941 |
주요 진행 단계와 비교할 만한 후보를 모은 표다. 점수가 계속 오르는 하나의 경로가 아니다. 날짜는 UTC 기준이며, 전체 제출의 점수 쌍은 CSV로 볼 수 있다.
초기의 큰 개선은 영상과 학습 신호를 제대로 활용하면서 나왔다. Encoder를 fine-tuning하고, 입력의 기하 정보를 바로잡고, slice 범위를 넓히고, 학습을 마친 모델군을 합쳤다. 8월 19일에는 Private가 0.904에 도달했다. 이후 자체 모델군의 소형 조합은 0.928, 다시 0.934까지 올라갔다. 공개 시스템이 그보다 높은 test 성능을 제공한 것은 맞지만, 그전까지 자체 개발로 얻은 개선도 Private에서 확인됐다.
반복해서 나오는 모델 이름
- N: 넓은 영역과 국소 view를 함께 읽는 native-field 2.5D ConvNeXt-S 모델.
- V3: 자체 소형 조합에 쓴 80-slice 영상 모델.
- S6F: 공개 S6 recipe를 내 fold에서 다시 학습한 모델. ConvNeXt-S에 소견별 spatial/window attention을 쓴다. 공개 weight를 그대로 쓴 것과는 다르다.
- H: 공개 R949, R224, R6-flip 예측을 합친 구성.
- mm12: 판독문과 선택한 영상을 바탕으로 열두 소견에 대해 만든 학습 target.
- T*: 정의 기반 라벨과 더 강한 teacher 예측을 혼합한 학습값. 이렇게 만든 student는 final-only다.
막판 2주에는 여러 경로를 함께 시험했다. N 단독 모델, teacher student, S6F 재현, 공개 모델 혼합은 서로 다른 가설을 다룬 실험이었다. 고정된 ensemble에 모델을 하나씩 추가해 간 기록으로 보면 흐름을 잘못 이해하기 쉽다. 중요한 것은 모델이 몇 개 늘었느냐가 아니라, 각 모델군의 정보를 어떤 구성으로 써야 실행 비용에 걸맞은 성능을 얻을 수 있느냐였다.
학습 라벨과 Private 성능
학습 라벨의 영향은 learner의 설정을 유지한 비교에서 좀 더 분명하게 볼 수 있다. Native N에서 정의 기반 라벨을 mm12로 바꾸자 Public은 0.942에서 0.945로, Private는 0.928에서 0.932로 올랐다. 반대로 mm12를 blendjev로 바꿨을 때는 두 점수가 모두 0.002 내려갔다. 한 recipe에 잘 맞은 라벨표가 다른 모델에서도 더 좋은 학습 target이 되는 것은 아니었다.
더 강한 teacher target을 썼을 때는 변화가 더 컸다. N-mm12 → N-T의 Private는 0.007, 정의 기반 G25 → G25-T는 0.014 올랐다. 실제 제출한 시스템의 Private에서도 성능 향상을 확인한 셈이다. 다만 T* teacher에 필요한 fold 제외조건이 보장된 것은 아니므로, 이 결과만으로 student를 clean OOF 조합 선택에 넣을 수는 없다. Teacher의 예측 정보를 공유하는 student들을 서로 독립적인 새 정보원으로 셀 수도 없다.
| 제출 비교 | Δ Public | Δ Private |
|---|---|---|
| N: 정의 기반 → mm12 | +0.003 | +0.004 |
| N: mm12 → blendjev | −0.002 | −0.002 |
| N: mm12 → T* teacher 라벨 | +0.006 | +0.007 |
| G25: 정의 기반 → T* | +0.016 | +0.014 |
| R949F → S6F recipe | +0.008 | +0.007 |
라벨 비교는 각각 한 쌍의 학습 결과다. R949F → S6F에서는 서로 맞물린 여러 부분이 함께 바뀌었다. 각 요소의 독립적인 인과효과를 분해한 표는 아니다.
최종 점수와 별개로 supervision의 근본적인 문제도 남는다. 학습 데이터 대부분에는 소견별로 완전하게 정리한 전문의 정답 대신 판독문이 주어졌다. 명시적인 음성, 불확실한 표현, 언급되지 않은 소견은 서로 다른 관측이다. 더 좋은 report reader는 적혀 있는 내용을 더 정확히 해석할 수 있지만, 판독문에서 빠진 영상 소견까지 직접 보는 것은 아니다. 대회 중 판독문과 라벨의 불일치를 다룬 discussion 역시 라벨 정리부터 모델 설계까지 함께 검토할 문제였다.
학습값을 $q\in[0,1]$, 영상을 $X$라고 하자. 함수의 형태에 제한이 없고, 별도 가중치 없는 binary cross-entropy의 population loss를 최소화한다면 최적 예측은 다음과 같다.
\[f_q^*(x)=\mathbb E[q\mid X=x].\]이 값이 내가 예측하려는 영상 소견의 확률과 같다는 보장은 없다. 그렇다고 불완전한 판독문으로는 학습할 수 없다는 뜻도 아니다. 어떤 missingness 구조에서는 필요한 순위가 유지될 수 있다. 핵심은 $q$를 만드는 과정에서 영상 과제에 필요한 구분이 보존되느냐는 것이다. 실제 학습에는 class weighting, sampling, 유한한 model capacity도 영향을 준다. Optimizer를 바꾸기 전에 학습 target이 무엇을 담고 있는지부터 따져야 했다.
학습 라벨을 바꿔 볼 이유도 여기에 있었다. 불완전한 판독문 라벨을 더 정확하게 맞힌다고 원하는 영상 소견의 순위까지 더 잘 매긴다는 보장은 없다. Multimodal target과 강한 visual teacher는 원래 target에 없던 정보를 보탤 수 있다. 다만 N에서는 라벨표에 따라 결과가 엇갈렸다. 정보가 더 많거나 라벨을 만드는 절차가 더 정교하다고 성능까지 좋아지는 것은 아니었다.
S6F에서는 라벨 교체와 다른 경로로 성능이 올랐다. R949F 대비 Private가 0.007 높아졌는데, r949blendjev 라벨표는 유지하고 backbone과 해부학적 입력 구성, attention, 학습 및 집계 방식을 함께 바꾼 결과였다. 재현한 시스템 전체가 더 강했다는 것은 확인할 수 있지만, 각 변경이 얼마씩 기여했는지는 알 수 없다. 기존 pipeline에 layer 하나만 가져와 시험하는 것으로는 이들 사이의 상호작용을 충분히 평가하기 어려웠다.
무엇을 양성 소견으로 볼지, 입력에 어떤 해부학적 구조를 남길지, 판독문에서 얻은 음성을 얼마나 신뢰할지에도 domain knowledge가 필요했다. 외부 라벨과 해부학적 prior는 기존 bank의 조합을 다시 찾는 것만으로는 얻기 어려운 정보를 줄 수 있다. 공개 CoAtNet recipe도 backbone 하나보다 이런 선택들이 맞물린 시스템으로 이해할 필요가 있었다. 다만 위의 R949F → S6F 비교는 라벨표를 유지한 실험이다. 이를 외부 라벨의 효과로 설명해서는 안 된다. 내 라벨 교체 실험에서 확인한 것은 supervision에 따라 실제 제출 결과가 달라졌다는 사실이다. 외부 데이터·라벨과 domain knowledge가 대회 전체의 최고 성능을 얼마나 좌우했는지는 아직 가설이다. 그 영향은 공개된 전체 recipe와 앞으로 나올 write-up을 살펴보며 판단해야 한다. 내 개별 실험의 결과만으로 대회 전체를 설명할 수는 없다.
Ensemble 구성과 비중
S6F 단독의 Private는 0.938, N과 V3를 합친 K-W는 0.941이었다. 세 모델군을 같은 비중으로 쓴 K-eq는 0.940이었고, S6F의 비중을 절반으로 높이자 표시 점수가 0.001 더 올랐다. 최종 최고 후보에 공개 예측이 들어갔다는 사실과 별개로, clean 조합에서도 실제 개선을 얻었다.
반대로 네 모델군을 섞은 D2c는 S6F의 0.938보다 낮은 0.933이었다. 이 결과를 추가한 세 모델 각각의 해로운 영향으로 나눠 설명할 수는 없다. 세 모델을 넣으면서 S6F의 비중도 1에서 4분의 1로 줄었기 때문이다. 관측한 것은 그 구성 전체의 손실이다. 앞선 소형 package를 확장한 R1-C 역시 Private가 0.931에서 0.923으로 내려갔다. 완성한 모델군이 많아지면 선택지는 늘지만, 모델을 더 넣는 모든 조합이 좋아지는 것은 아니었다.
H에서는 Public과 Private가 서로 다른 조합을 더 높게 평가했다. $R$을 소견별 rank 변환, $A_{10}$을 자체 N/V3 모델들의 rank를 합친 block이라고 하면, 시험한 outer blend는 다음과 같았다.
\[C_\alpha=(1-\alpha)R(H)+\alpha R(A_{10}).\]H 단독은 0.958 / 0.942였다. 자체 예측 비중이 0.25인 v229는 0.957 / 0.943, 0.50인 v227은 0.956 / 0.942였다. Public에서는 H 단독이 더 높았지만, Private에서는 시험한 조합 가운데 자체 예측을 4분의 1 넣은 쪽이 표시 점수 기준으로 더 높았다. 내 예측은 가장 좋은 제출에 기여했으나, 그 비중을 더 늘린 조합에서는 추가 개선이 없었다. 자체 구성 요소가 clean이라는 사실과 별개로, H를 포함한 혼합 전체는 final-only다.
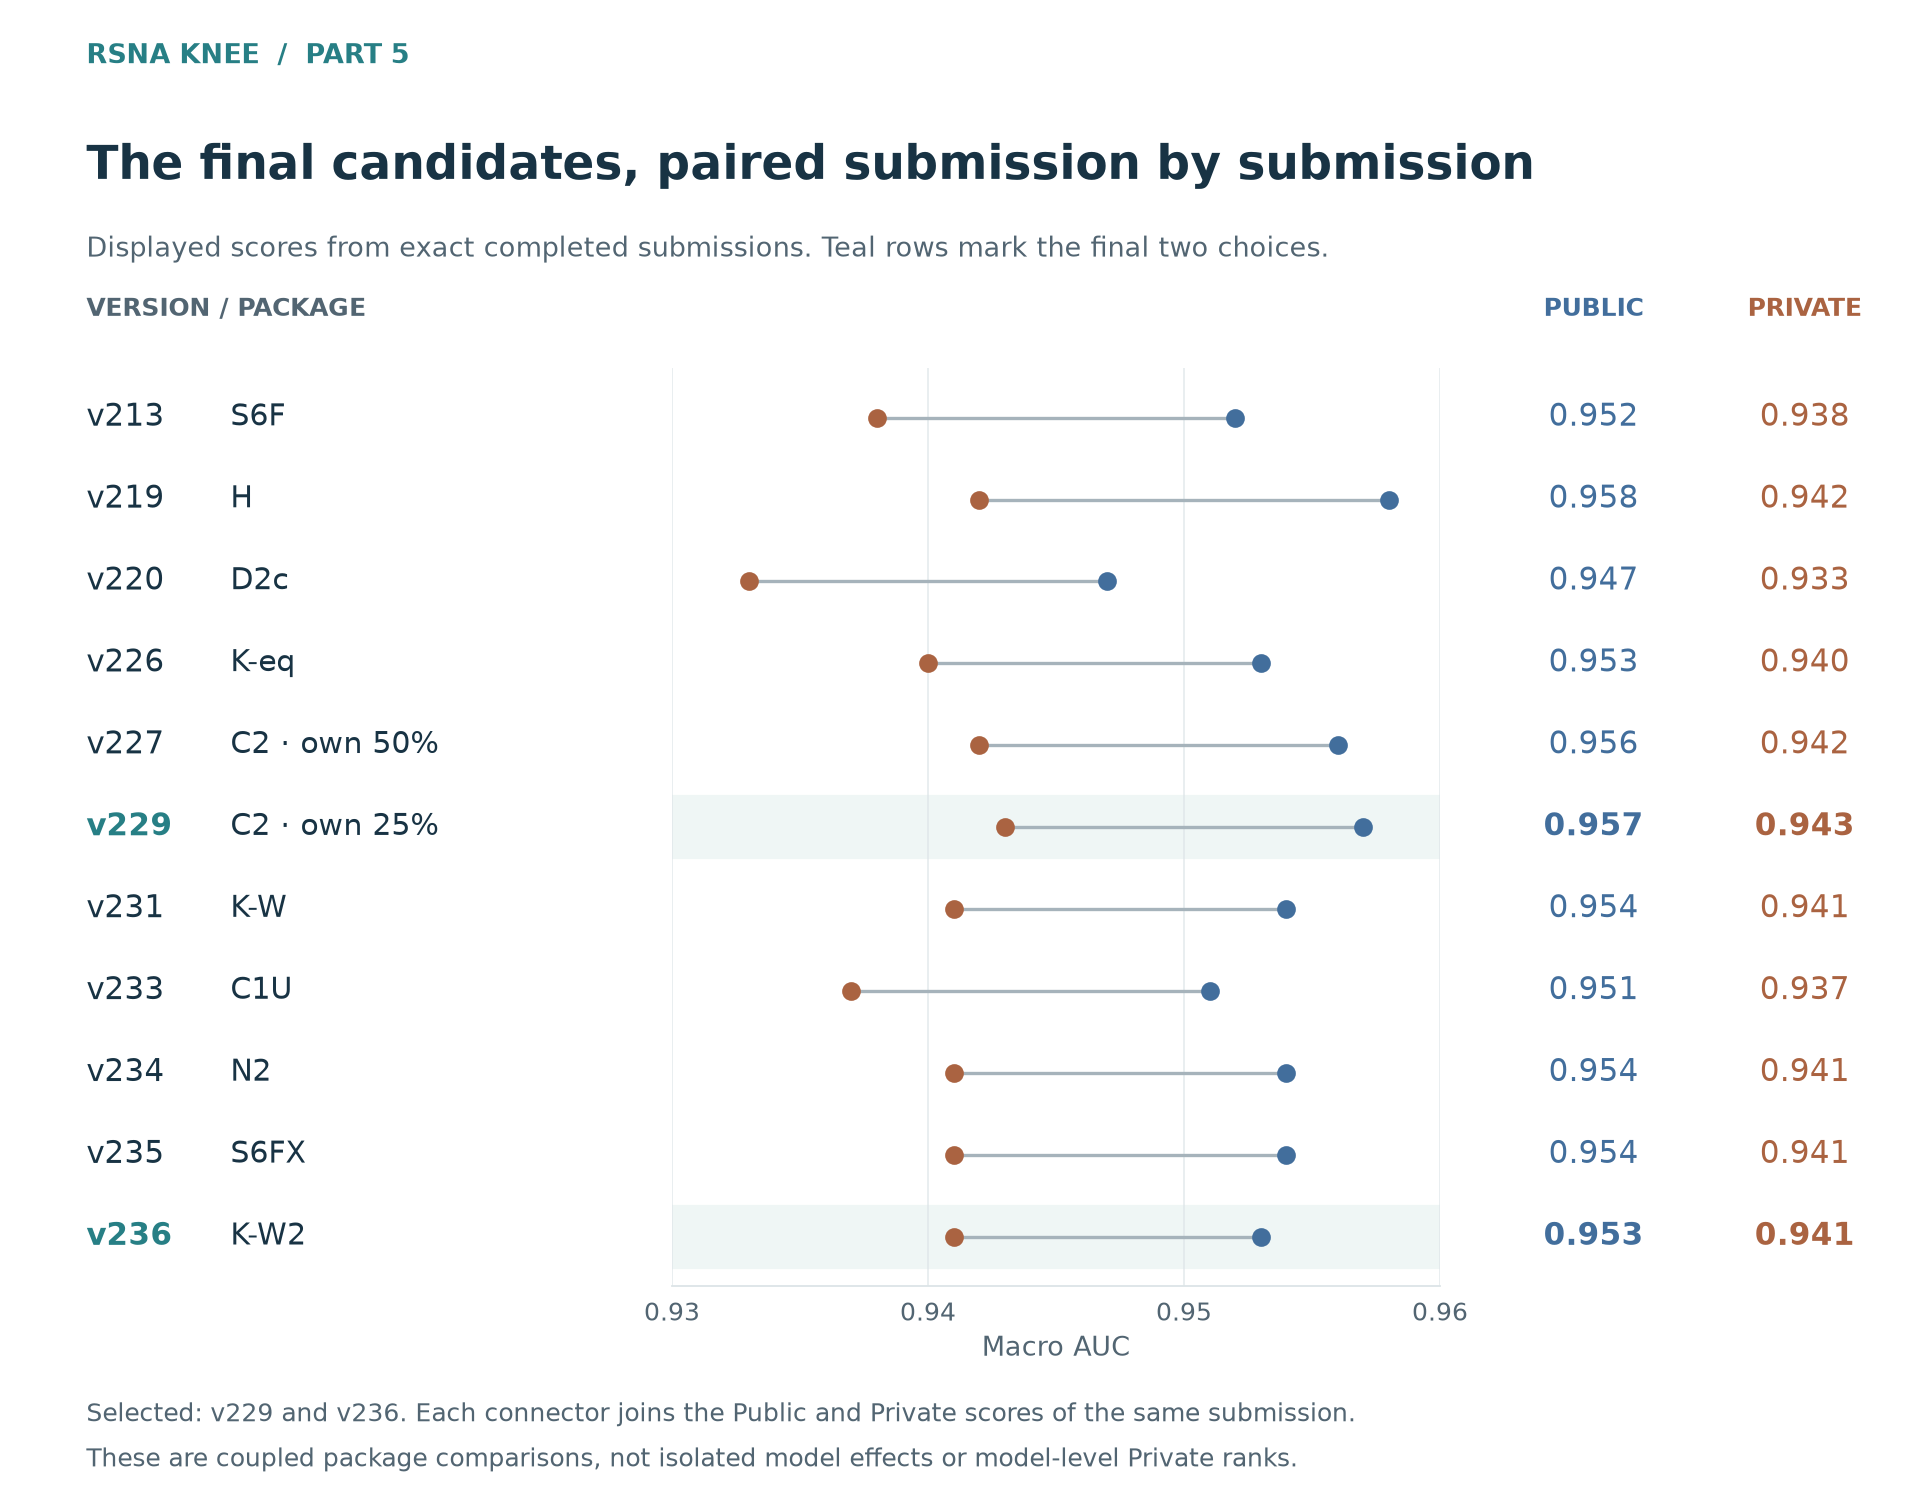
그림 3. 각 행에는 정확히 같은 제출의 Public과 Private를 짝지어 표시했다. 강조한 두 행이 최종 선택이다. 선은 두 관측 AUC를 잇는 것으로, confidence interval이 아니다. 표시 점수가 같다고 예측이 같거나 성능이 통계적으로 동등하다는 뜻도 아니다.
막판 확장 실험
마지막 확장 실험들은 이 결과를 넘지 못했다. 네 번째 모델군을 넣은 C1U에서는 K-W의 Private 0.941에서 0.937로 내려갔다. 기존 모델군의 비중도 함께 바뀐 비교였으므로, 새 모델군의 단독 성능만으로 이 하락을 설명할 수는 없다.
두 번째 N seed를 넣은 N2, full-data S6F checkpoint를 넣은 S6FX, 두 번째 clean S6F seed를 넣은 K-W2는 모두 Private 표시 점수가 0.941로 K-W와 같았다. K-W2는 Public이 0.001 낮았다. 두 번째 seed를 추가할 근거였던 clean OOF의 향상이 이번 test에서는 표시 점수의 개선으로 이어지지 않았다. 이 관측만으로 bagging이 쓸모없다거나 원래 OOF 측정이 틀렸다고 결론 내릴 수는 없다.
9시간 안에 실행하기 어려울 것으로 예상했던 더 큰 후보들은 끝내 점수를 얻지 못했다. K-W3는 첫 제출에서 플랫폼 오류, 재제출에서 시간 초과, 마지막 재제출에서 unhandled error가 났다. 다른 확장 구성도 시간 초과나 실행 오류로 끝난 경우가 있었다. 결과가 없으므로 모델이 약했을 것이라고 단정할 수도, 충분히 강해서 최종 성적을 바꿨을 것이라고 주장할 수도 없다. 분명한 것은 정해 둔 test 추론을 끝내지 못한 모델을 최종 선택에 쓸 수 없었다는 점이다.
양쪽 점수가 나온 154건 중 Private 표시 점수 0.943을 넘는 제출은 없었다. 따라서 마지막 선택 하나를 되짚는 것보다, 점수를 받은 시스템들이 이 수준을 넘지 못한 개발 과정을 살펴보는 편이 중요하다. 실행 실패로 잃은 선택지는 확인할 수 있다. 그 선택지가 성공했다면 얼마의 AUC를 냈을지는 알 수 없다.
Public–Private gap
AUC는 소견별 양성–음성 쌍의 순위로 결정된다. 평가에 포함된 study가 바뀌면 비교하는 쌍도 달라지고, 드문 소견에서는 어떤 어려운 사례가 들어왔는지에 민감할 수 있다. Public 점수를 참고해 반복해서 후보를 고르면 그 split에 더 잘 맞는 후보를 선택할 수도 있다. 팀 리더보드에는 Public 최고 제출과 최종 선택이 다를 수 있다는 점도 더해진다. 이 원인들을 점수 차이 하나로 구분할 수는 없다.
전체적으로는 Public과 Private의 점수 순서가 상당히 비슷했다. 6,425팀의 표시 점수 쌍에서 Spearman correlation은 0.986이었다. 마지막 후보들 사이에서 작은 역전이 있었다는 사실과는 모순되지 않는다. 성능 차이가 큰 시스템까지 모두 포함한 상관이 높더라도, 점수가 비슷한 후보들 사이의 Public 0.001 우위가 믿을 만한 선택 기준이 되는 것은 아니다.
내 실험에서도 개선의 종류를 구분할 필요가 있었다. Supervision을 바꾸거나 더 강한 recipe를 재현했을 때는 두 split이 함께 좋아진 경우가 많았다. 마지막 H의 고정 비중 비교에서는 두 split이 선호한 조합이 달랐고, seed를 추가한 결과는 대체로 표시 점수가 같았다. 이 관측들을 Public이 믿을 만하다거나 아무 의미가 없다는 하나의 평가로 묶기는 어렵다. Aggregate score만으로 개선의 임상적 원인, 모델 오차의 상관, study별 uncertainty interval을 알아낼 수도 없다. 그런 분석에는 해당 test 예측과 정답이 필요하다.
자체 시스템과 H
핵심 비교는 간단하다. 내가 완성한 clean 조합의 표시 점수 최고는 Public 0.954, Private 0.941이었다. H 단독은 0.958 / 0.942였다. 직접 만들고 실행해 제출한 자체 시스템은 양쪽 모두에서 H보다 약했다. 나는 H가 Public에 특히 잘 맞는 구성일 수 있고, Private에서는 clean 근거를 쌓아 온 쪽이 나을 수도 있다고 기대했다. 그러나 결과는 그 기대를 뒷받침하지 않았다. H를 그저 Public에 과적합한 시스템으로 치부할 수는 없었다. Private에서도 내가 완성한 clean 조합보다 강했다. Complete OOF를 더 많이 만들었다는 사실로 이 비교를 대신할 수는 없었다.
자체 block을 더한 최종 조합은 H의 Private를 0.943으로 높였다. 다만 더 강한 예측기를 보완하는 것과, 그보다 강한 예측기를 직접 만드는 것은 다른 성과다. 내가 해낸 것은 전자였다. 이 비교는 완성해서 점수를 받은 조합에 한정된다. Bank에 있는 모든 파일로 만들 수 있는 최적 조합을 확인한 것은 아니다. 그렇더라도 실제로 완성한 자체 시스템이 H보다 약했다는 사실은 받아들여야 했다.
나는 주어진 데이터와 학습 시간, 쌓아 온 근거를 활용하고도 공개된 시스템을 넘어서는 자체 예측기를 만들지 못했다. 부족했던 것은 마지막 모델이나 비중 하나를 고르는 판단만이 아니었다. 일반적인 ML 기법에 학습량을 더하고 bank를 늘리면 풀 수 있는 문제로 접근하면서, 무엇을 어떻게 예측해야 하는지부터 다시 따져 보는 일이 부족했다. 어떤 정보를 더 구할지, target이 무엇을 뜻해야 할지, 어떤 전체 시스템을 재현할지 결정하는 일도 모델링 역량의 일부였다. ML 기법과 계산량을 주된 해법으로 삼은 관점부터 바꿀 필요가 있었다.
물론 소수 셋째 자리까지 공개된 점수 차이만으로 어느 판단이 얼마나 잘못됐는지를 계산할 수는 없다. 공개 notebook들이 등장하지 않은 대회도 관측하지 못했다. 그런 조건이라면 내 OOF bank가 상대적으로 더 높은 순위에 올랐을 수도 있지만, 그 역시 검증되지 않은 가설이다. 실제 대회에는 그 시스템들이 있었고, 나는 그 조건에서 더 좋은 예측을 만들어야 했다.
OOF bank의 목적과 한계
Complete OOF 모델군을 만든 것은 앞선 실험을 다음 선택에 활용하고 싶어서였다. 학습을 마친 모델군은 학습에서 제외한 study의 예측을 남긴다. 다른 모델군과 같은 study에서 비교할 수 있고, 나머지 fold들에서 조합 규칙을 고른 뒤 남겨 둔 fold에서 평가할 수도 있다. 새 모델을 직전 package에 덧붙일지만 묻는 대신, 기존 후보들을 포함해 어떤 조합이 나은지 검토할 수 있었다.
이를 위해서는 checkpoint를 모으는 것 이상이 필요했다. Fold 배정, study key, target 정의와 집계 방식이 서로 맞아야 했다. 유망해 보이는 미완성 run도 complete 모델군을 대신할 수는 없었다. 이 비용을 감수한 이유는 이후의 선택을 더 잘하기 위해서였다. 보관할 파일 자체를 늘리려던 것은 아니었다.
Bank 덕분에 이런 비교는 가능해졌다. 그러나 그 안의 모델들이 충분히 강한지, 중요한 가설들을 시험했는지, 조합을 더 찾으면 기존 예측의 한계를 넘을 수 있는지까지 보장되지는 않았다. 주어진 후보들의 우열을 정확히 가려도 그 후보 모두가 더 강한 시스템에 못 미칠 수 있다. 검증 근거가 잘 갖춰져 있는가와 예측 자체가 강한가는 다른 질문이었다.
막판에 사용한 공개 parent에는 평가 범위의 문제도 있었다. 대회의 전체 학습 study를 쓴 것도 있었고, 내 fold와 호환되는 학습 제외조건을 재구성할 만큼 이력이 공개되지 않은 것도 있었다. 이런 teacher를 쓴 student도 같은 제약을 이어받을 수 있었다. 자체 component의 OOF가 clean이라는 사실은 그대로지만, 그것을 섞는다고 공개 예측을 포함한 혼합 전체가 clean이 되지는 않았다.
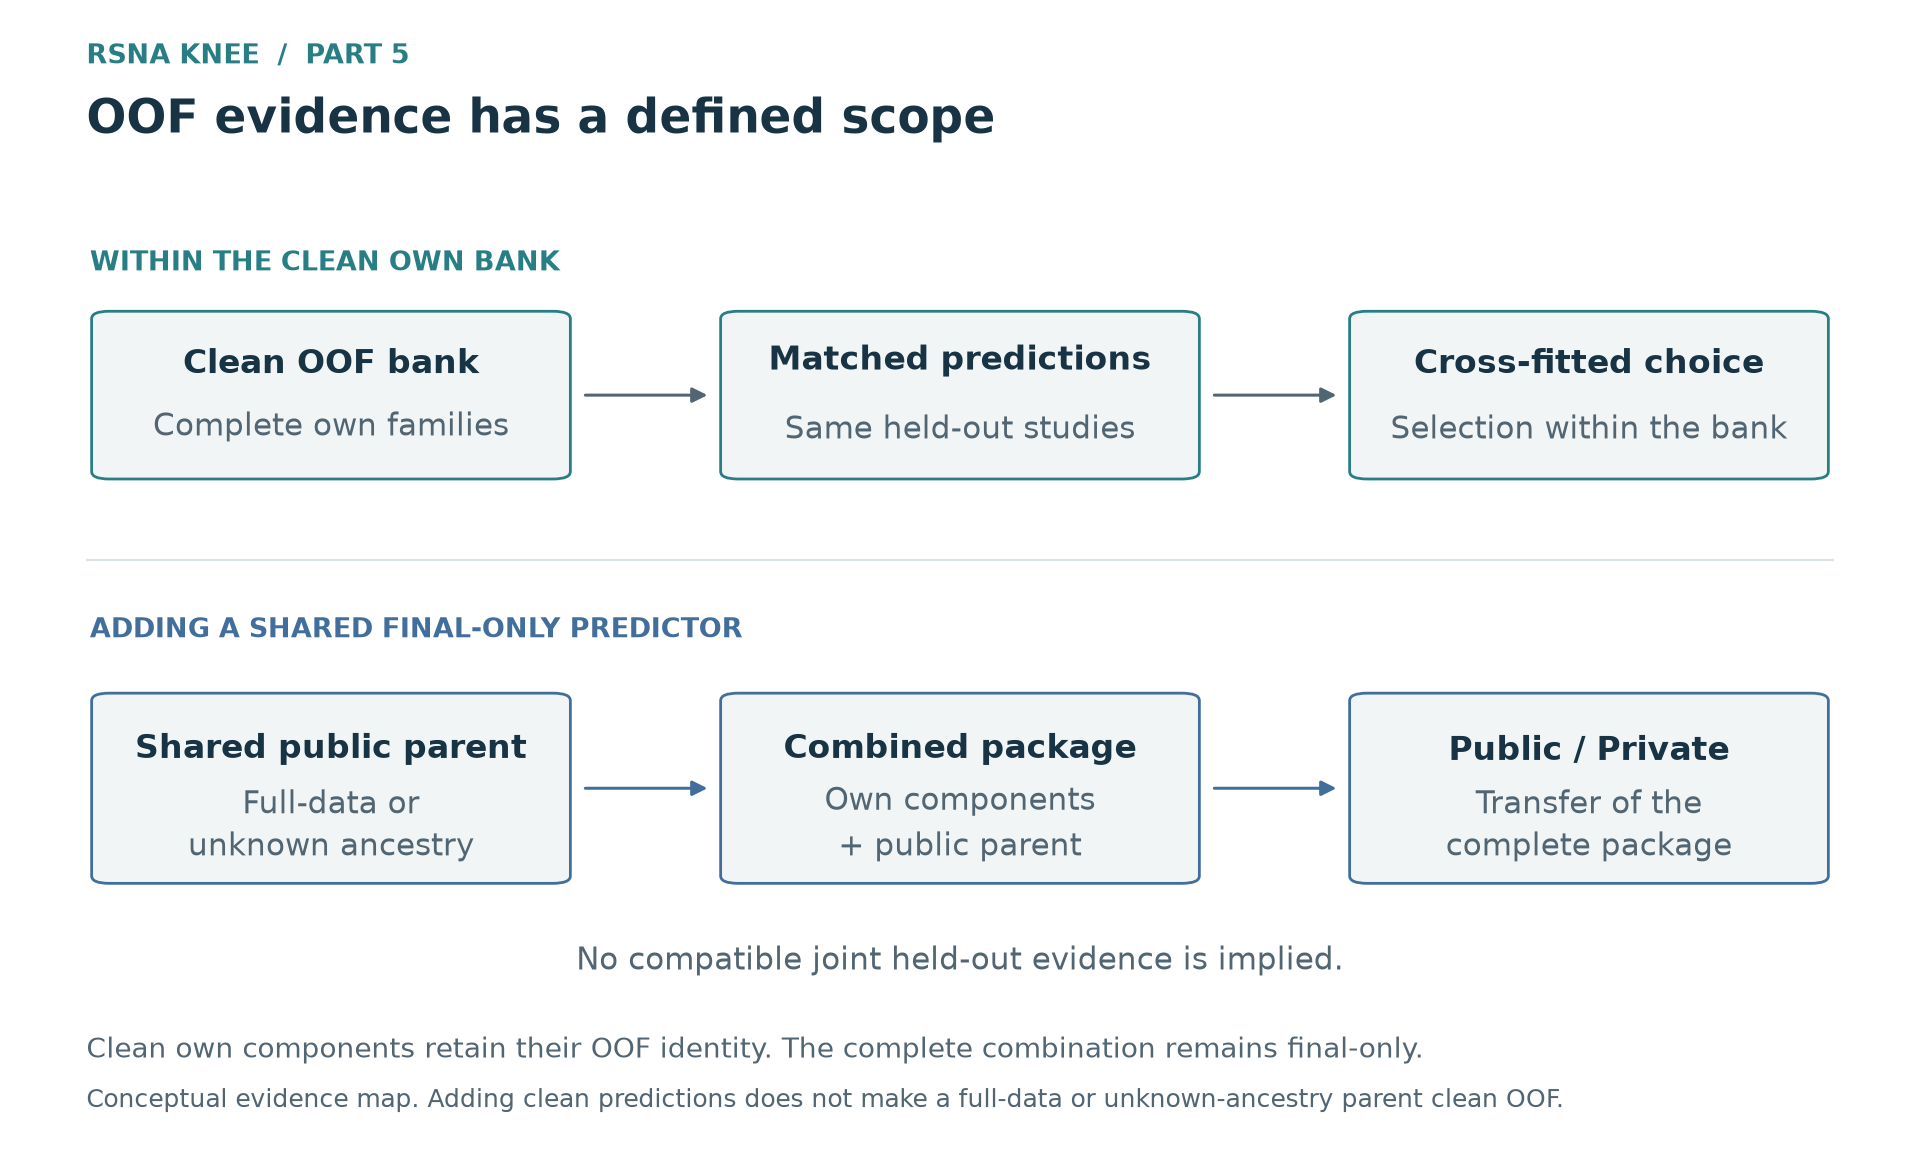 그림 4. OOF 근거를 적용할 수 있는 범위를 구분한 개념도다. 호환되는 자체 bank의 예측으로는 cross-fitted 조합 선택을 할 수 있다. Full-data 또는 학습 이력이 불분명한 parent가 들어간 혼합 전체에는 별도의 평가 근거가 필요하다. 성능 실측치를 나타낸 그림은 아니다.
Bank는 여전히 쓸모가 있었지만, 내가 기대했던 역할과는 거리가 생겼다. 나는 그 자산을 바탕으로 강한 최종 예측기를 고르고 싶었다. 그러나 막판에는 주로 더 강한 공개 시스템을 조금이라도 보완할 방법을 찾는 데 쓰게 됐다. 둘은 내게 같은 성과가 아니었다. 과학적으로 비교하고 재사용할 가치는 남았지만, 막판 경쟁에서 차지하는 상대적 가치는 크게 줄었다.
공통 baseline과 추가 정보
새 notebook이 나왔다고 새로운 예측 정보가 생긴 것은 아니었다. 유용한 학습 시스템이나 다른 weight를 제공한 자료도 있었고, 상당 부분 같은 내용을 다른 reducer로 조합한 자료도 있었다. Notebook의 수를 독립적인 아이디어의 수로 받아들이지 않으려면, 어떤 계통의 코드와 예측을 쓰는지 구분해야 했다.
강한 시스템을 누구나 실행할 수 있게 되면 내 모델의 standalone 성능만으로는 부족하다. 내 예측기를 $u$, 공통 baseline을 $b$, 미리 정한 조합 연산을 $C$라고 하자. 같은 held-out study에서 평가하는 metric을 $M$이라고 하면, 관심을 가져야 할 것은 다음 차이였다.
\[\Delta M=M\!\left(C(u,b)\right)-M(b).\]물론 metric이 같아야 하고 비교 자체도 타당해야 한다. 단독 성능이 좋은 $u$라도 $b$가 놓친 순위를 바로잡는 정보는 거의 없을 수 있다. 다른 architecture와 많은 학습량, complete OOF는 추가 가치를 시험해 볼 이유가 될 뿐, 이득을 보장하지는 않는다. 막판의 실질적인 질문은 강한 공개 예측에 무엇을 더할 수 있느냐였다. H 비교에서는 작은 추가 이득을 실제로 확인했지만, 내 bank가 최종 예측의 중심이 되기를 바랐던 것과는 다른 결과였다.
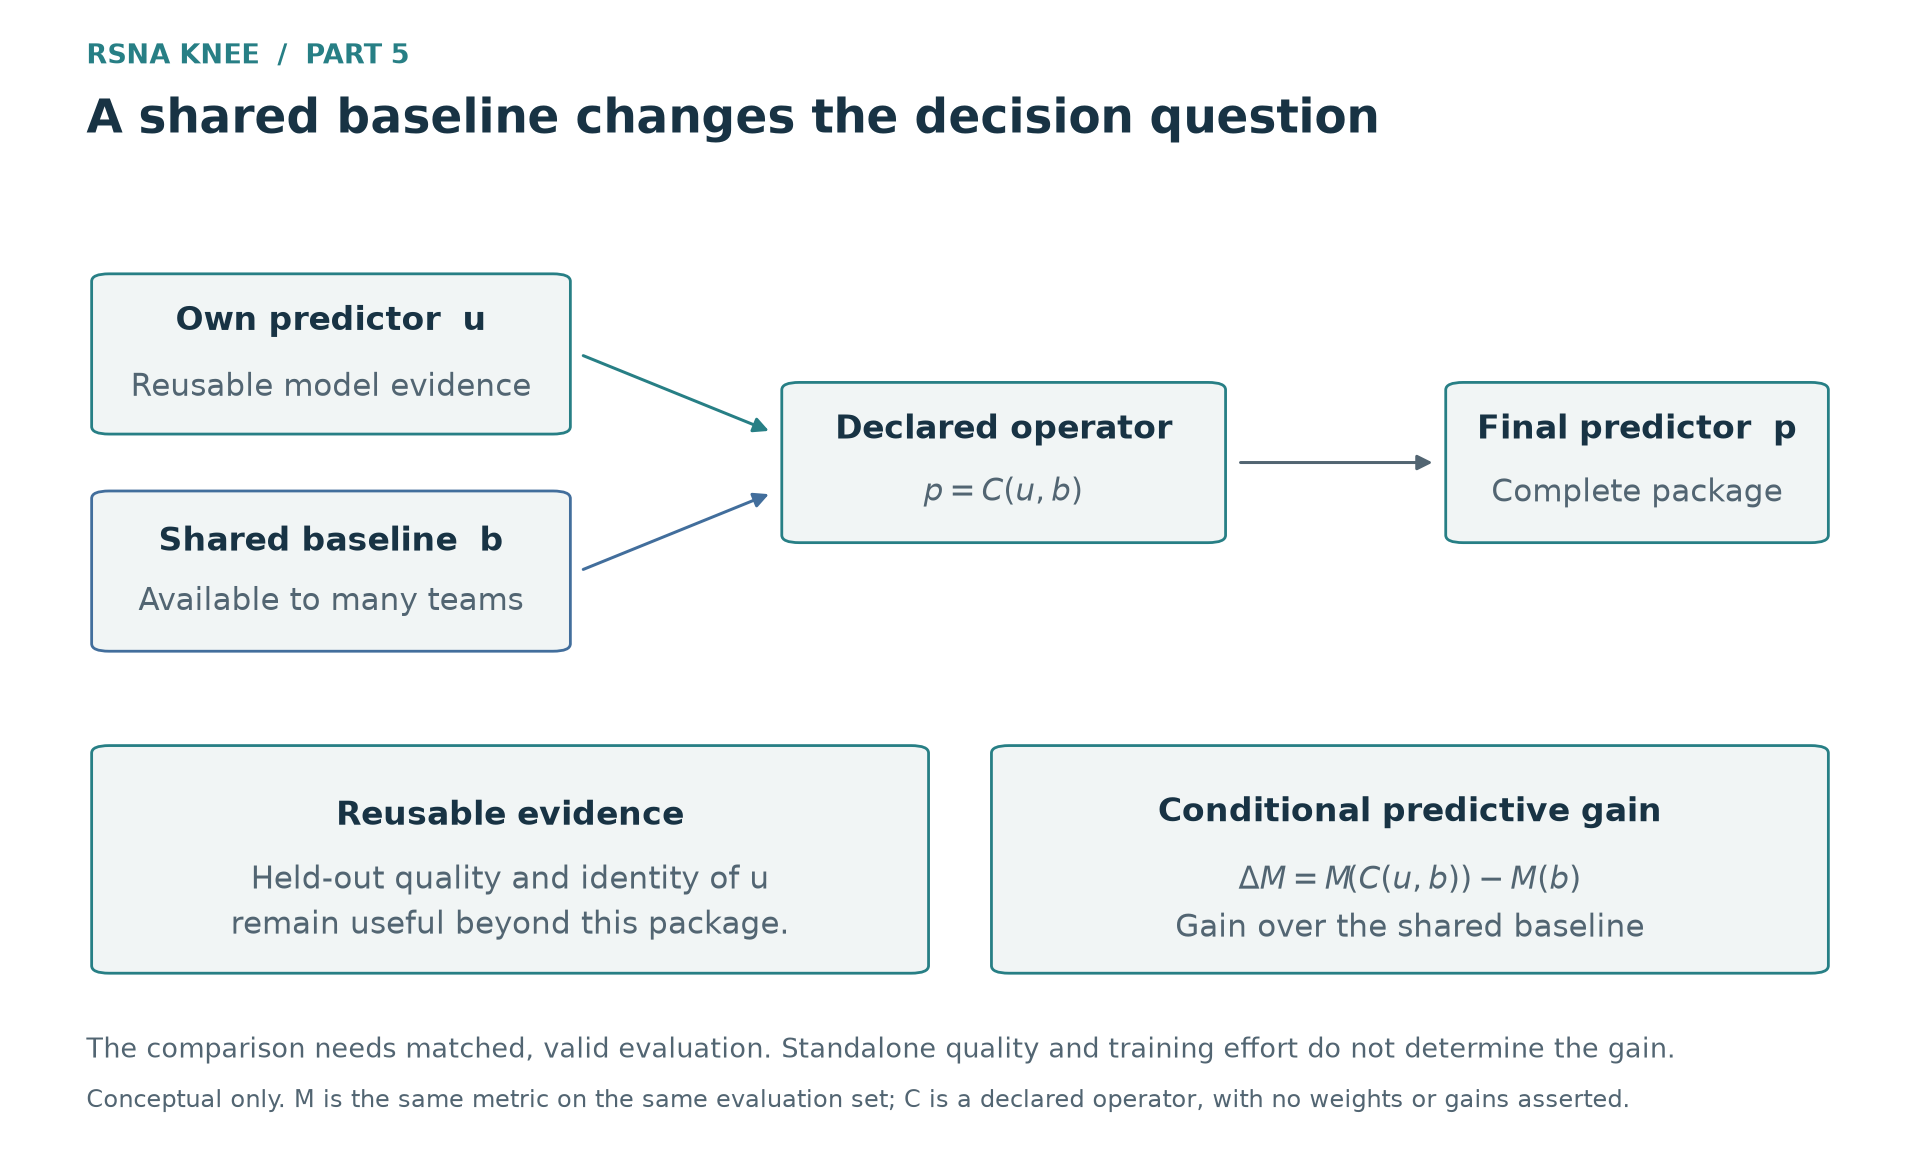 그림 5. 자체 예측의 추가 가치는 어떤 parent에 어떤 연산으로 합치는지에 따라 달라진다. 이 개념도에는 학습으로 정한 비중, 예측 사이의 독립성, 수치적 이득을 가정하지 않았다. 실제 후보들의 결과는 그림 3에서 따로 비교했다.
공개됐다는 이유로 그 시스템을 만든 연구의 가치가 줄어드는 것은 아니다. 나는 공개된 reader와 라벨, 학습 코드, 예측의 도움을 받았다. 리더보드의 반올림된 점수만으로 다른 사람이 들인 노력을 알 수도 없었다. 받아들이기 어려웠던 것은 내 작업이 맡게 된 역할이었다. 최종 예측의 중심이 되기를 기대하며 쌓아 온 작업이, 끝내 넘어서지 못한 시스템을 보완하는 작은 component가 되어 있었다.
연구 우선순위와 실행 비용
유망한 방법을 발견해도 곧바로 성능을 비교할 수는 없었다. 라벨표의 값이 무엇을 뜻하는지 알아야 했고, 외부 데이터는 target 정의가 맞는지 확인한 뒤 학습에 연결해야 했다. Checkpoint를 쓰려면 어떤 입력을 전제로 학습했고 어떻게 추론하는지도 이해해야 했다. 학습과 complete OOF, export, replay, 전체 규모의 실행과 결과 수집까지 마쳐야 최종 선택에 쓸 수 있는 근거가 생겼다.
9시간 한도에서는 실행 비용이 모델 선택에 직접 영향을 줬다. 연구할 가치가 있는 모델이라도 최종 추론에 추가하기에는 너무 비쌀 수 있었다. 개별 성능이 유망한 모델들을 모은 조합보다, 끝까지 실행할 수 있는 작고 일관된 recipe가 더 유용할 수도 있었다. 점수를 얻지 못한 확장 후보들은 이 제약 때문에 실제 선택지가 줄어든 사례다. 시간제한이 없었다면 몇 점을 받았을지는 여전히 알 수 없다.
정확히 비교할 수 있는 실험과 우선해서 해 볼 실험도 같지는 않았다. Engine을 고정하고 라벨표 하나만 바꾸면 그 차이는 비교적 분명하게 해석할 수 있다. 그렇다고 그 질문에 다음 일주일을 써야 하는 것은 아니었다. 개별 효과를 분리하기 어려운 큰 변경이, 익숙한 문제 설정 안에서 변형을 하나 더 만드는 것보다 중요할 수도 있었다.
남은 시간을 낭비하는 방식은 양쪽에 있었다. 왜 강한지 이해하지 못한 채 공개 시스템을 계속 이어 붙일 수도 있었고, 비교 조건을 완벽하게 맞추려다 마감 전에 결과를 얻지 못할 수도 있었다. 어느 쪽이 더 중요한지 판단하고, 유용한 대안을 일찍 준비해 해석할 수 있는 결과까지 완성하는 것 역시 내 책임이었다. 파일과 검사가 계속 늘어난다는 사실만으로 연구가 진전되는 것은 아니었다.
남은 허탈함
완성한 자체 시스템이 부족했다는 사실을 인정해도 허탈함은 남는다. Complete OOF에 투자한 것은 정돈된 archive를 남기기 위해서가 아니었다. 그 작업을 통해 강한 예측기를 만들고 싶었다. 그러나 막판 2주에는 공들여 만든 모델들이 더 강한 시스템에 조금이라도 보탤 정보를 찾기 위한 재료처럼 느껴질 때가 많았다.
노력을 많이 했다고 더 높은 점수를 받을 자격이 생기는 것은 아니다. 하지만 파일을 나중에 재사용할 수 있다는 사실만으로 그 시간을 만족스럽게 썼다고 말할 수도 없었다. 최종 점수가 평가하는 것은 예측이다. 각 실험의 가치와 근거를 만드는 데 든 비용, 내가 이 과정을 다시 하고 싶은지까지 그 점수로 판단할 수는 없다.
Private 결과를 알고 나면 당시에도 선택이 명확했던 것처럼 느끼기 쉽다. 하지만 그때는 결과를 몰랐고, 끝내지 못한 실험의 점수는 지금도 알 수 없다. 부족했던 점을 전보다 구체적으로 설명할 수 있게 됐을 뿐, 그 시간을 보내며 느낀 복잡한 마음까지 정리된 것은 아니다.
Formula 1과 참여 비용
추가 학습 데이터 생성 비용을 다룬 Name That LLM discussion에는 Kaggle을 Formula 1에 빗댄 댓글이 있었다. 실력도 중요하지만, 그 실력을 발휘할 자원도 중요하다는 이야기였다. 자원의 차이는 오래전부터 있었고 적은 비용으로도 좋은 결과를 낼 수 있다는 반론이 뒤따랐다. 이는 참가자들의 의견이며, 대회 결과를 설명하는 공식적인 분석은 아니다. 다만 나는 그 비유에서 이번에 느낀 답답함을 떠올렸다.
어떤 대회에서는 모델 설계뿐 아니라 개발 전반을 수행하는 능력이 점점 더 중요해진다고 느낀다. 유용한 데이터를 구하고, 입력을 준비하고, 필요한 비교를 해 보고, 전체 시스템을 실행해야 한다. F1에서 좋은 차량과 정비가 선수의 기량을 뒷받침하듯, 내 아이디어도 데이터와 장비, 구현이 따라줘야 실제 예측이 됐다. 나는 이 모든 일을 잘해 내는 능력이 대회에서 얼마나 큰 몫을 차지하는지 과소평가했다.
막판의 공개 자료는 부담을 덜어 주면서 새로운 부담을 만들기도 했다. 강한 시스템을 더 많은 사람이 쓸 수 있게 된다는 점에서는 진입 장벽이 낮아졌다. 그러나 이전 후보의 평가가 끝나기도 전에 다음 자료를 준비하고 비교할 일이 생겼다. 자료에 접근하기 쉬워진다고 대회에 참여하는 수고까지 줄어드는 것은 아니었다. 연구를 공개해 준 데 감사하면서도, 무엇을 쓸지 계속 다시 판단하는 일에는 지쳤다.
효율적인 추론, 데이터 준비, 안정적인 실행은 분명 중요한 능력이다. 다만 막판에는 새 자료를 따라가고, 익숙한 비교를 반복하고, 실행을 제시간에 끝내는 데 점점 더 많은 주의를 썼다. 책상 앞에 앉아 있는 시간은 길어졌지만, 그만큼 문제를 깊이 이해하게 됐다는 느낌은 들지 않았다. 배우기보다 소모하고 있다는 생각이 드는 시간이 늘었다.
내 부족함을 인정하는 것과 다음 대회에도 같은 방식으로 참여하고 싶은지는 별개의 문제다. 더 잘 경쟁하는 법을 배울 수는 있겠지만, 그 경쟁에 다시 이만큼 시간을 쓰고 싶은지는 따로 생각해야 했다.
앞으로의 참여
당분간 tabular 대회에는 가볍게만 참여하려 한다. 익숙한 모델의 feature와 hyperparameter, seed를 조정하며 순위를 조금 올리는 데 몇 주씩 쓰기보다는, 대회가 끝난 뒤 공개되는 solution을 읽는 편이 나을 것 같다. 본격적으로 시간을 들인다면 새로운 domain을 공부하거나 까다로운 validation을 직접 설계해 볼 수 있는 대회를 고르고 싶다.