RSNA Knee, Part 2: 9시간 한도의 Ensemble
그림은 눌러서 확대할 수 있습니다. 좁은 화면에서는 넓은 표와 수식을 좌우로 움직여 보세요.
Ensemble은 여러 모델의 예측을 합쳐 새로운 예측을 만드는 계산이다. 어떤 모델을 넣고, 서로 다른 점수 척도를 어떻게 맞추며, 그 결과 검사들의 순서가 어떻게 바뀌는지가 성능을 결정한다. Checkpoint 개수만으로는 이 계산을 설명할 수 없다. 같은 모델들도 집계 방식에 따라 다른 순위를 만들고, 많은 모델을 모은 조합이 잘 고른 일부 모델보다 나쁠 수도 있다.
지금 선택할 수 있는 소형 후보 중 가장 강한 것은 내가 학습한 두 모델 계열의 조합이다. 순위 평균은 Public 0.940, 확률 평균은 0.941을 받았고, 계획상 추론 시간은 207.7분이다. 더 큰 후보들은 훨씬 많은 계산을 하면서도 이 점수를 넘지 못했다. 여기에는 두 가지 문제가 맞물려 있다. 기존 모델에 도움이 되는 예측을 어떻게 학습할 것인지, 로컬 추정치가 높은 조합과 계산 비용이 낮은 조합 중 무엇부터 시험할 것인지다. 입력 표현을 바꾼 실험과 첫 ensemble 비교를 보면, 단독 점수만으로 어느 쪽도 판단하기 어렵다.
예측 행렬과 집계 방식
소견 $t$ 하나의 예측을 비교할 때는 검사들을 행에, 예측을 만든 모델들을 열에 놓아 행렬 $P^{(t)}$로 정리한다. 같은 행은 반드시 같은 검사를 뜻해야 하고, 각 열의 예측을 어떤 평가 절차로 얻었는지도 정해져 있어야 한다. 로컬 비교에서는 설정 하나를 다섯 fold에서 학습해 완전한 OOF를 만든다. 각 검사는 자기 fold를 제외하고 학습한 모델로 예측하므로, 해당 검사를 학습에 사용한 모델의 예측을 섞지 않고 모델들을 비교할 수 있다.
가중 확률 평균과 가중 순위 평균은 이 행렬에 적용하는 서로 다른 함수다.
\[\begin{aligned} s^{\mathrm{prob}}_{it}&=\sum_j w_{jt}P^{(t)}_{ij},\\ s^{\mathrm{rank}}_{it}&=\sum_j w_{jt}R_{jt}\!\left(P^{(t)}_{ij}\right),\\ w_{jt}&\geq 0,\quad \sum_jw_{jt}=1. \end{aligned}\]$R_{jt}$는 모델 하나가 소견 하나에 대해 낸 예측을 평가 검사들 사이의 percentile rank로 바꾸는 함수다. 확률 평균은 점수 사이의 간격을 그대로 사용한다. 순위 평균은 그 간격을 상대적 위치로 바꾼 뒤 합친다. 모델 하나의 순서와 동점을 유지하는 단조변환은 AUC를 보존하지만, 각각 변환한 값을 더하면 최종 예측 순위는 달라질 수 있다.
이 차이를 보면 단독 AUC만으로 ensemble의 가치를 정할 수 없는 이유도 알 수 있다. 양성 검사와 음성 검사 한 쌍에 대해 $d_j=P_j(x^+)-P_j(x^-)$라고 하자. 확률 평균에서는 $\sum_jw_jd_j$의 부호가 그 쌍의 순서를 정한다. 두 번째 모델이 도움이 되려면 잘못된 순서를 충분히 바로잡으면서, 이미 맞았던 순서를 너무 많이 뒤집지 않아야 한다. 단독 AUC가 조금 낮은 모델도 강한 모델을 개선할 수 있다. 반대로 중요한 쌍에서 같은 오류를 내는 두 모델은 단독 점수가 모두 높아도 함께 쓸 이점이 작을 수 있다.
예측 상관은 서로 얼마나 비슷한지를 요약할 뿐, 두 예측이 다를 때 어느 쪽이 맞았는지는 알려 주지 않는다. 상관이 낮은 이유가 서로 보완하는 정보일 수도 있고, 단순히 모델 하나의 성능이 나쁘기 때문일 수도 있다. 대회 점수는 소견 열두 개의 AUC 평균이므로 도움이 되는 차이도 소견마다 다르다. 기여도를 알려면 같은 검사에서 얻은 예측을 실제로 사용할 연산으로 합쳐 봐야 한다. Encoder나 seed가 다르다는 이유만으로 ensemble이 좋아지는 것은 아니다.
이 글에서는 열두 소견 모두에 같은 모델 계열들을 쓰는 방식을 flat 구성, 소견마다 별도 모델 집합을 고르는 방식을 소견별 선택(target-specific selection)이라고 부르겠다. 어떤 모델이 참여할지 정하는 문제이며, 확률 평균과 순위 평균 중 어느 연산을 쓸지와는 별개다.
평균하는 단계, fold 모델, 실제로 참여하는 모델들
두 계열에 모델이 다섯 개씩 있다면, 계열별 평균을 같은 비중으로 합친 확률 평균은 열 모델의 flat mean과 같다. 모델 수가 같고 중간에 다른 변환이 없을 때의 이야기다. 계열마다 모델 수가 다르면 계열별 가중치를 달리해야 전체 모델의 flat mean과 같아진다. 계열별 평균을 다시 rank로 바꾸거나 비선형 변환을 넣으면 일반적으로 계산이 달라지고, 가중치만 조정해 원래 평균을 복원할 수 없다.
OOF와 숨은 테스트에서 사용할 수 있는 예측도 다르다. 학습 검사에는 계열마다 held-out 모델 하나의 예측을 써야 한다. 그 검사에 다섯 fold 모델을 모두 적용해 평균하면 in-sample 예측이 섞인다. 숨은 테스트에서는 다섯 모델을 모두 쓸 수 있다. 로컬 비교는 held-out 조건을 유지하고, 실제 추론에서는 fold 모델들을 어떻게 합칠지 따로 정해야 한다.
한 rehearsal에서는 더 기본적인 불일치가 드러났다. 9월 22일 검사 1,322건을 처리하면서 모델 45개를 불러왔지만, 예전 소견별 목록 때문에 출력 하나에 참여한 모델은 10~25개였다. 새로 추가한 두 설정은 모든 출력에서 빠져 있었다. OOF가 공통으로 있는 검사 4,339건에서 의도한 아홉 설정의 flat 구성은 주 지표 0.8817, 이전 구성은 0.8785였다. 참여 목록부터 고쳐야 의도한 조합을 비교할 수 있었다. 이 로컬 점수 차이를 숨은 테스트의 개선량으로 해석할 수는 없다.
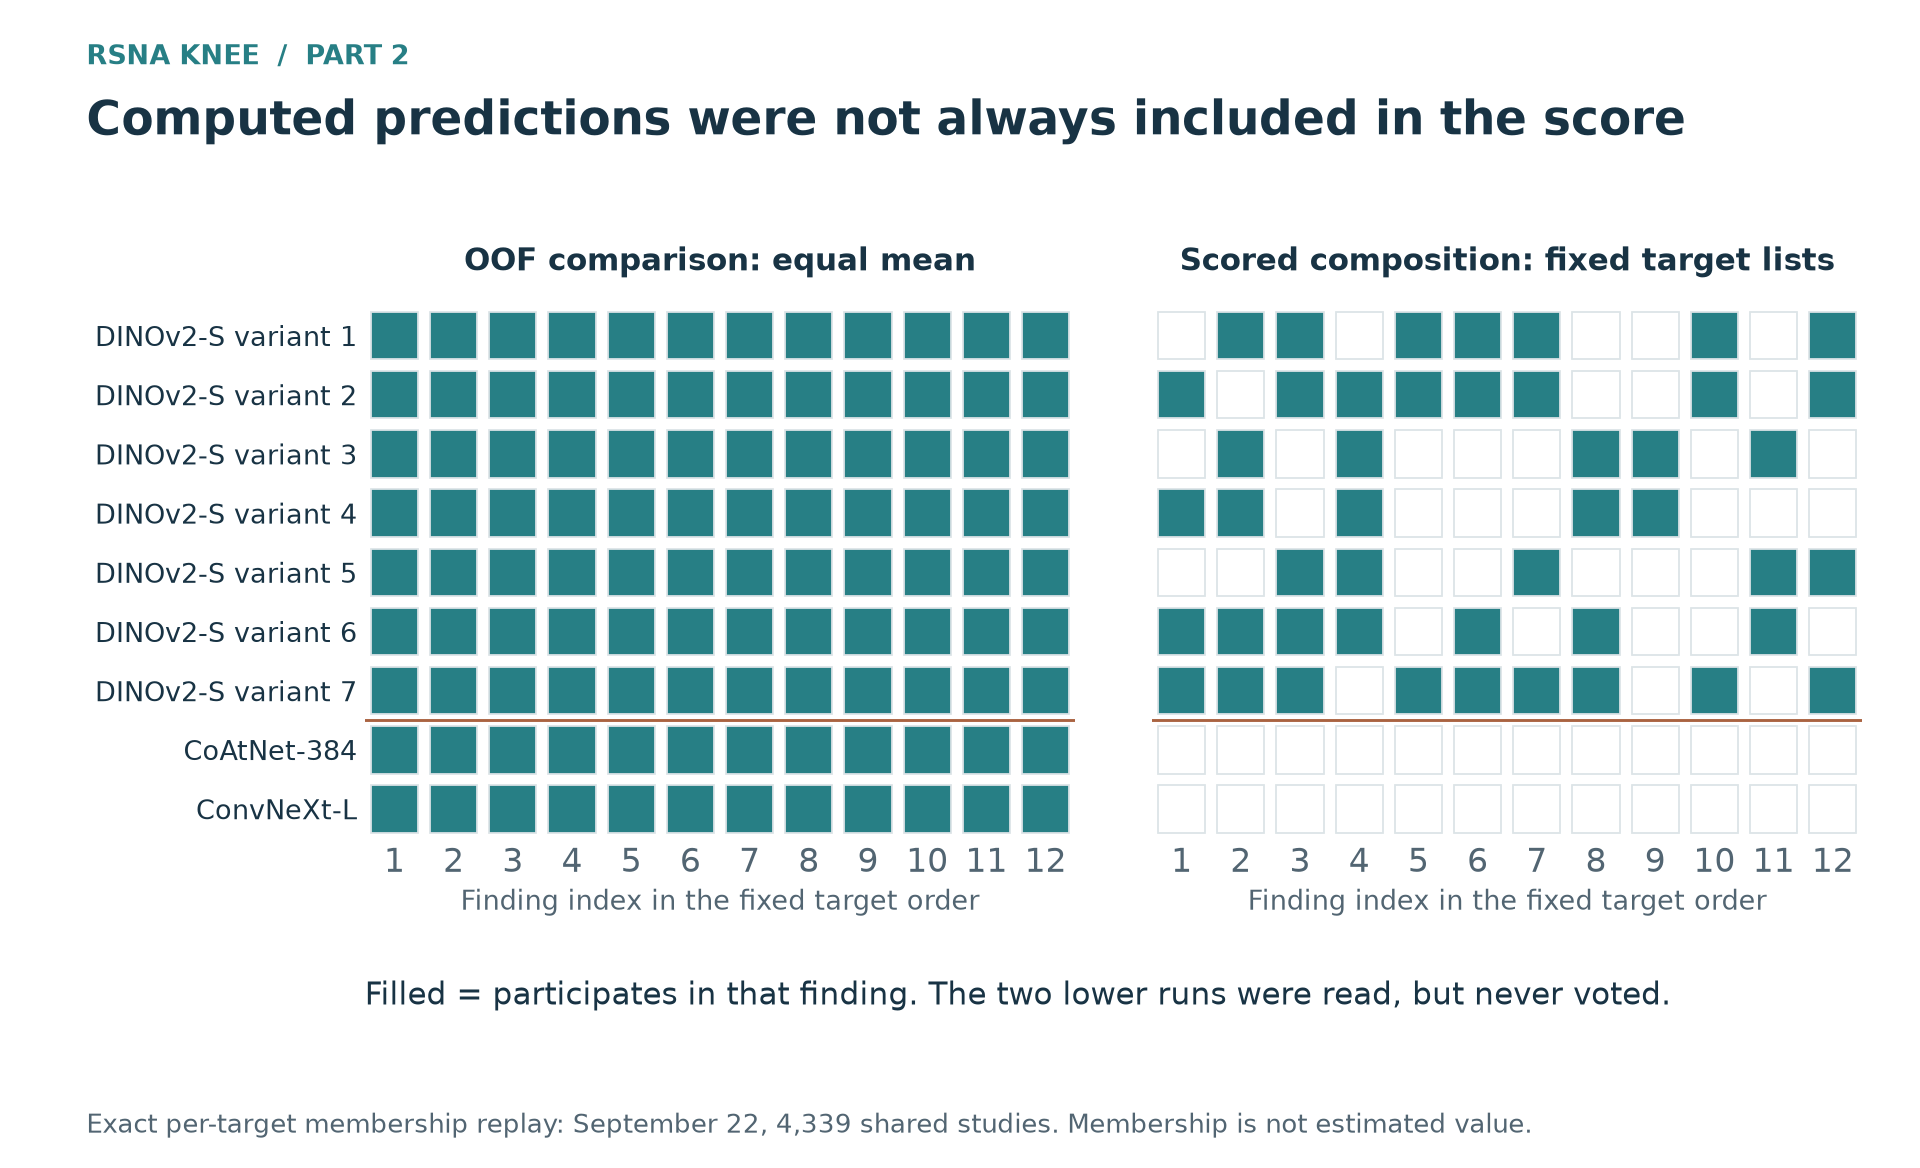 그림 1. 의도한 구성에는 아홉 설정이 열두 소견 모두에 들어간다. 기록된 목록에서는 일곱 설정만 쓰며, 소견별로 45개 중 10~25개 모델이 참여한다. 모델을 불러왔다는 사실만으로 예측에 영향을 주는 것은 아니었다.
같은 rehearsal에서는 내부의 8시간 타이머 때문에 모델 26개가 열 window 대신 아홉 window만 읽었다. 이 동작은 없앴다. 실행 순서나 chunk 크기는 바꿔도 선택한 모델과 window는 유지해야 한다. 그렇지 않으면 로컬에서 평가한 예측과 실제로 제출하는 예측이 달라진다.
조합을 보완하는 모델 학습
새 모델이 조합에 도움이 되는지는 기존 모델과 같은 검사들에서 얻은 예측을 합쳐 봐야 안다. 유망한 첫 fold 점수만으로는 OOF bank 전체와 비교할 수 없다. 학습을 끝낸 모델 계열이 같은 검사들에 대한 held-out 예측을 남겨야 한다. 그보다 앞서 어떤 학습 시스템에 이 작업을 투자할지 고르는 일은 더 어렵다.
공개 Raptor recipe는 그런 후보였다. CoAtNet encoder, 64-slice 입력 표현, window 사이의 attention, 그 입력에 맞춘 학습 설정을 함께 사용했다. 내가 쓸 OOF를 얻으려면 내 fold에서 다시 학습해야 했다. 대회 데이터로 학습한 공개 checkpoint가 내 validation 검사를 제외했을 것처럼 취급할 수는 없었다.
초기에 부품만 옮긴 결과는 좋지 않았다. 기존 classification head를 붙인 CoAtNet은 첫 fold에서 GPT 판독문 기반 기준 라벨로 0.8663이었고, DINOv2-small 대조군의 0.8795보다 낮았다. Head를 유지한 채 공개 recipe의 64-slice 입력을 적용하자 0.8322가 나왔다. 이들은 부품을 옮긴 특정 조합을 평가한 결과였다. 전체 recipe가 어떻게 작동할지는 아직 알 수 없었다.
입력과 head의 상호작용은 구조로 설명할 수 있었다. Encoder는 이미지 window를 feature로 바꾸고, head는 이를 모아 소견별 확률을 만든다. Window가 바뀌면 head가 받는 feature의 분포와 배열도 달라진다. 미리 고른 view 몇 개에 맞춘 head가 긴 영상열을 잘 활용하지 못할 수 있다. 학습한 window-attention head는 각 window가 소견 예측에 기여하는 비중을 다르게 줄 수 있지만, 유용한 근거를 구별할 feature와 충분한 fine-tuning이 필요하다.
그래서 64-slice 표현에 공개 recipe의 attention head를 쓰고 fine-tuning 범위도 넓혀 학습했다. Epoch 16의 첫 fold 점수는 0.8701로, 입력만 옮긴 시험보다 0.0379 높았다. 결합 recipe의 학습을 계속할 근거였다. Fine-tuning도 함께 바뀌었으므로 head 하나의 효과로 돌릴 수는 없었다.
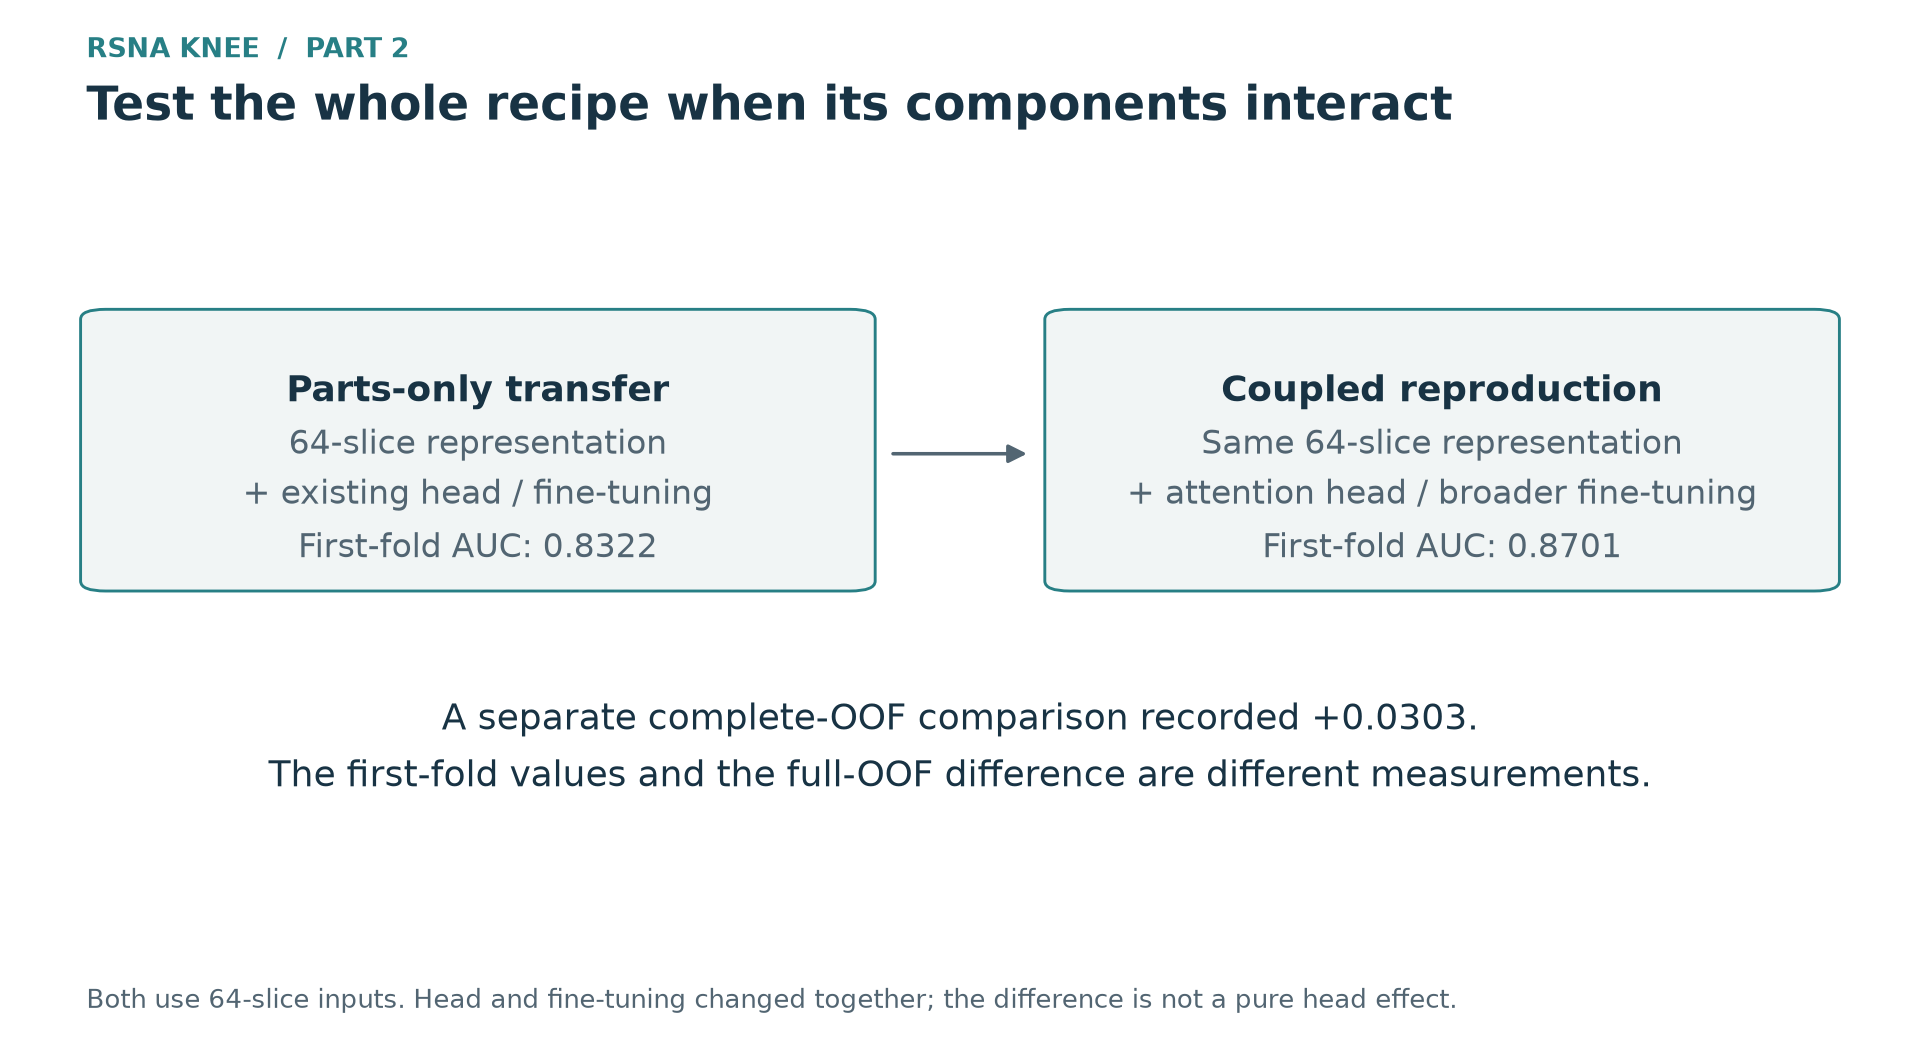 그림 2. 첫 fold 점수 0.8322와 0.8701은 같은 판독문 기반 기준 라벨로 잰 값이다. 둘 다 64-slice 입력을 사용했다. 후자는 head와 fine-tuning 범위를 함께 바꾼 시험의 중간 checkpoint이며, 학습을 마친 전체 OOF 비교와는 별도의 결과다.
다섯 fold의 학습은 9월 23일 끝났다. GPT와 Opus 기준 라벨로 구한 AUC 평균을 주 지표로 삼았을 때, 결합 recipe는 같은 입력에 기존 head를 붙인 모델보다 0.0303 높았다. 단독으로는 여전히 baseline보다 0.0091 낮았다. 그러나 배포 구성과의 예측 상관은 0.789였고, 조합 선택에서는 다섯 outer fold 모두에 들어갔다. 단독 점수는 낮아도 평가한 선택 절차 안에서는 유용하게 보완했다는 근거였다.
이렇게 얻은 held-out 예측으로 결합 recipe를 다른 모델들과 비교할 수 있게 됐다. Architecture 이름이 다르거나 구현에 성공했거나 첫 fold 점수가 높다는 것만으로는 할 수 없는 비교다. 기존 시스템에 부품 하나를 넣어 본 결과로 전체 recipe를 기각하기보다, 함께 작동하도록 설계된 부분들을 묶어서 시험할 이유가 있다.
밀집 입력과 최적화 설정
다른 실험에서는 입력 표현과 학습 recipe의 관계를 추측만으로 풀 수 없었다. 더 밀집한 336픽셀, 30-slice 입력을 쓴 두 모델이 첫 fold에서 크게 낮아졌다. ConvNeXt-large는 약 −0.054, DINOv2-large는 약 −0.125였다. 겉으로는 slice 수만 늘리는 실험처럼 보였다. 실제 recipe에서는 crop, fine-tuning 깊이, 학습률, schedule, 수치 정밀도까지 바뀌었다. 전체 시스템을 바꾼 결과였으므로, 손실이 어느 변경에서 나왔는지는 알 수 없었다.
DINOv2-small로 의심한 상호작용을 분리해 시험했다. 다른 baseline 설정을 유지하면서 backbone 학습률을 $8\times10^{-6}$에서 $2\times10^{-5}$로 올리는 변경과 encoder의 모든 block을 학습하는 변경을 각각 시험한 뒤, 두 변경을 함께 적용했다. 검증 검사 881건에서 저장된 동일 baseline을 기준으로 비교한 결과는 다음과 같았다.
| 학습률 | Fine-tuning 깊이 | 주 지표 AUC |
|---|---|---|
| 원래 값 | 일부 | 0.8760 |
| 높인 값 | 일부 | 0.8374 |
| 원래 값 | 전체 | 0.8714 |
| 높인 값 | 전체 | 0.7288 |
주 지표는 Opus와 GPT 기준 라벨로 구한 AUC의 평균이었다. 학습률만 높여도 상당한 손실이 있었고, 깊이만 늘린 효과는 훨씬 작았다. 그런데 둘을 함께 바꾼 손실은 두 손실을 더한 값보다 훨씬 컸다. 네 점수를 $s_0,s_R,s_D,s_{RD}$로 쓰면 교호항은 다음과 같다.
\[I_{R\times D}=s_{RD}-s_R-s_D+s_0=-0.1040.\]네 조건의 예측을 짝지어 bootstrap한 구간은 [−0.1154, −0.0926]이었다. 검증 검사들을 다시 뽑아 얻은 변동이며, 다른 seed로 학습한 모델 사이의 변동을 담지는 않는다. 그래도 시험한 recipe 안에서는 다음 실험을 바꿀 만큼 큰 차이였다. 손실 전체를 밀집 입력 탓으로 보기 전에 학습률부터 되돌려야 했다.
이 복구도 직접 시험해야 했다. 두 요인 실험은 원래 입력을 사용했지만, 실패한 밀집 구성에는 crop·slice 수·band 범위를 묶어 바꾼 입력 geometry와 schedule, 수치 정밀도도 들어 있었다. 나는 이 설정들과 전체 깊이 학습은 유지하고 backbone 학습률만 원래 값으로 되돌렸다. 의심한 교호작용이 손실의 큰 부분을 설명한다면 학습률 단독 효과보다 훨씬 많이 회복해야 했다.
실제로 그랬다. 같은 저장 baseline에 대한 밀집 구성의 점수 차는 −0.1283에서 −0.0283으로 줄었다. 회복량은 +0.1000 [0.0897, 0.1111]이었다. 남은 결과는 입력 geometry만 바꾼 조건의 −0.0293과 가까웠고, 둘의 차이는 +0.0010 [−0.0041, +0.0063]이었다.
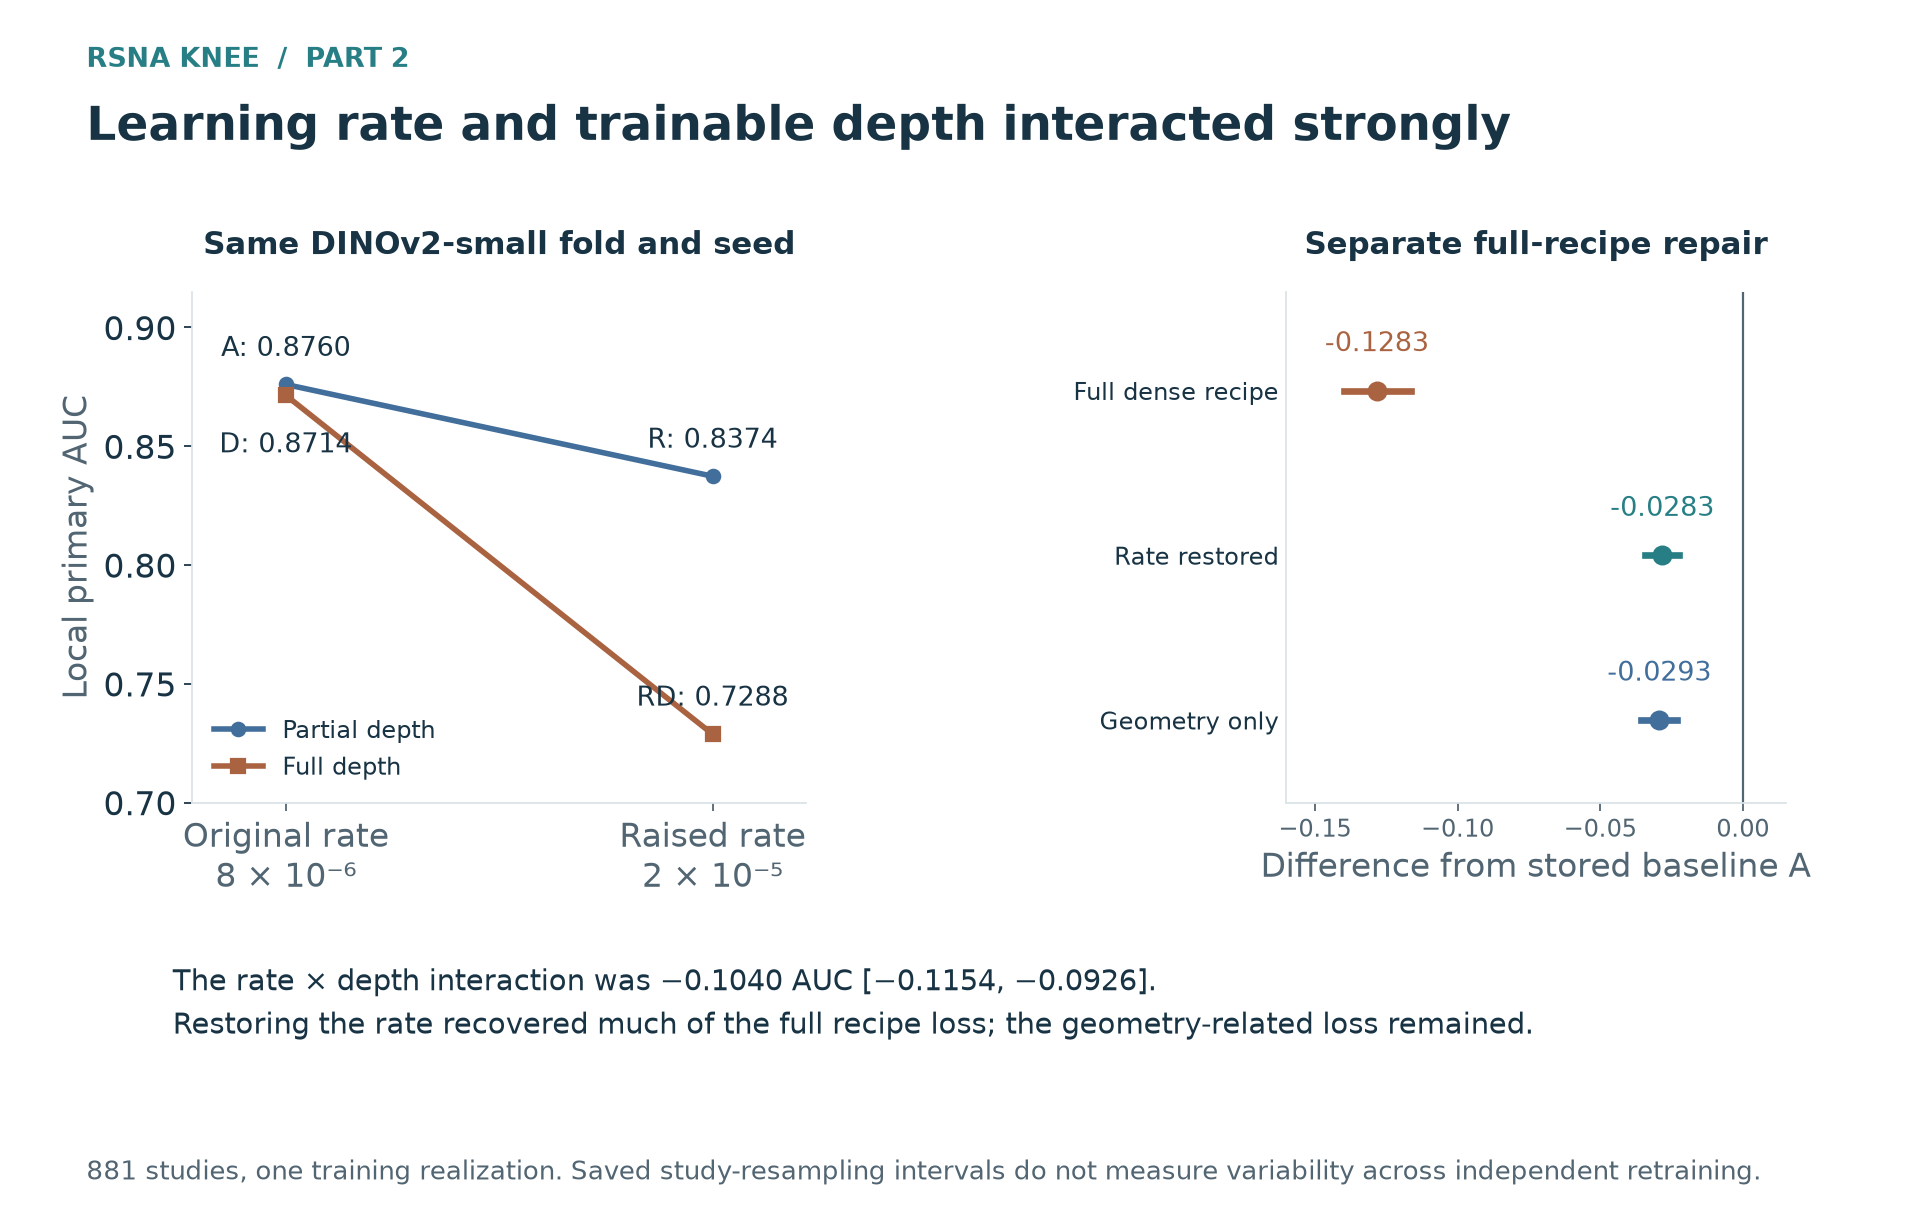 그림 3. 왼쪽의 네 조건은 학습률과 깊이를 함께 바꿀 때 큰 음의 교호작용을 보인다. 오른쪽에서는 전체 밀집 recipe의 학습률만 되돌리자 손실의 상당 부분이 회복됐지만, 입력 geometry 변경의 손실은 남았다. 모두 같은 저장 baseline으로 비교했으며, DINOv2-small의 한 fold·한 seed 결과다.
고친 밀집 recipe는 더 시험해 볼 만하다. 그렇다고 slice를 늘리는 것이 일반적으로 좋다는 뜻은 아니다. 입력 geometry만 바꾼 조건도 이 기준들에서는 약 0.03 낮다. Slice 수와 crop, band 범위를 함께 바꾼 조건이므로 각각의 효과는 아직 구분하지 못했다. 더 큰 encoder에서도 같은 크기의 교호작용이 생긴다고 볼 근거는 없다. 다음 대형 모델 비교에는 그 encoder에서 이미 확인한 최적화 설정을 써야 한다. 원래 시험은 입력과 함께 학습률·fine-tuning 깊이의 좋지 않은 조합까지 바꿨다. 그 결과만으로 밀집 입력 자체의 성능을 판단할 수는 없다.
추론 경로와 비용 제약
조합을 고르는 수학적 문제에는 통계적 목적함수와 자원 제약이 함께 들어간다. $c$가 모델, 집계 방식, 가중치를 정하고, $S_D(c)$가 검사 집합 $D$에서 선언한 기준 라벨로 잰 macro AUC라고 하자. 구하려는 조합은 다음 조건을 만족해야 한다.
\[\begin{aligned} &\underset{c\in\mathcal C}{\operatorname{maximize}}\ S_D(c)\\ &\text{subject to}\quad T_{\mathrm{route}}(c)\leq 540\ \text{minutes}. \end{aligned}\]여기서 목적함수는 특정 기준 라벨에 대한 로컬 평가이지, 숨은 임상 정답을 직접 관측한 값은 아니다. 시간 제약은 T4 두 장에서 실행하는 전체 계산에 적용된다. 기준 라벨이 바뀌면 선호하는 조합도 달라질 수 있고, 추론 경로가 바뀌면 같은 조합이 시간 안에 들어오는지도 달라진다.
각 계열의 추론 시간을 따로 재어 더한다고 전체 시간이 되는 것은 아니다. 입력이 호환되는 모델들은 decoding한 영상을 공유할 수 있다. 기존 입력 그룹에 모델 하나를 더하면 새 crop이나 slice 구성이 필요한 모델을 추가할 때보다 비용이 작을 수 있다. 반대로 작은 network라도 다른 입력 표현을 준비해야 하면 상당한 추가 작업이 생긴다.
단계를 나누어 실행하고 각 시간에 중복이 없도록 계산하면 전체 시간을 다음과 같이 나타낼 수 있다.
\[\begin{aligned} T_{\mathrm{route}}(c)={}&T_{\mathrm{setup}}+T_{\mathrm{decode}}(c)\\ &+T_{\mathrm{two\ GPUs}}(c)+T_{\mathrm{aggregation}}(c). \end{aligned}\]두 GPU에서 걸리는 시간은 작업 배치에도 달려 있다. 서로 다른 모델을 나눠 실행하면 더 느린 GPU가 끝나야 그 단계가 끝난다. GPU별 작업량이 다르고 일부 decoding·집계는 순차적으로 실행되므로, 모델 처리량이 두 배가 돼도 전체 시간이 절반이 되지는 않는다. Decoding한 영상을 메모리에 남기면 반복 작업을 피할 수 있지만 동시에 여러 그룹을 유지하면 peak memory가 늘 수 있다. 모델의 조합과 입력 준비, 작업 배치, 메모리를 함께 계산해야 한다.
전체 실행 전에는 숨은 테스트의 실제 소요 시간 대신 추정치 $\widehat T_{\mathrm{route}}$를 쓴다. 선택 프로그램은 이 값으로 조합을 제안하지만, 추정치가 540분이라고 해서 실제 실행도 끝난다는 보장은 없다. 계획 한도를 넘겨 시험하는 것은 특정 구성이 실제로 완주할 수 있는지 확인하는 일이다. Kaggle의 9시간 허용량이 늘어나는 것은 아니다.
실제 시험에서도 추정치와 소요 시간은 달랐다. 계획상 599.8분인 후보는 시간 제한을 넘겨 실패했다. 567.8분인 다른 후보는 완주해 0.937을 받았다. 제출부터 결과 확인까지는 각각 약 9.18시간과 8.89시간이었고, 플랫폼과 결과 수집의 지연도 포함됐다. 구성과 실행 방식이 다르므로 이 두 결과로 모든 조합에 적용할 runtime 경계를 정할 수는 없다.
선택 절차와 최종 구성의 평가
9월 20일까지 모은 OOF를 봐도, 기존 조합에 모델을 더하는 것 외에 교체할 조합을 비교할 이유가 있었다. 완전한 OOF를 갖춘 76개 설정을 검사 4,339건에서 탐색해 다음 고정 구성을 비교했다.
| 후보 | 설정 수 | 디코딩 그룹 수 | R1 대비 주 지표 AUC 변화 |
|---|---|---|---|
| 당시 R1 | 9 | 3 | — |
| 선택한 상위 여덟 설정 | 8 | 2 | +0.0017 |
| 선택한 상위 아홉 설정 | 9 | 3 | +0.0020 |
| R1에 window-bag 계열 추가 | 10 | 4 | +0.0010 |
| 모든 설정의 동일 가중 조합 | 76 | 13 | −0.0092 |
모델 수를 줄여 고른 조합은 점수가 높고 디코딩 그룹도 적었다. Bag 계열을 추가한 조합도 시험할 만했지만, 기존 모델을 모두 유지한 구성이 가장 좋지는 않았다. 전부 평균한 결과가 나쁘다고 해서 일부를 골라 만든 조합까지 나쁘다고 볼 수도 없다. 완전한 OOF가 있으면 같은 검사들에서 이런 대안들을 직접 비교할 수 있다.
다만 이 표는 조합을 고르는 데 쓴 예측에서 다시 점수를 잰 결과였다. 완전한 OOF 행렬이 있으면 영상 모델을 재학습하지 않고도 수천 개 조합을 비교할 수 있지만, 그 편리함에는 통계적인 문제가 따른다. 많은 후보 중 $S_D(c)$가 가장 큰 것을 고르고 같은 행에서 점수를 보고하면, 우연히 유리했던 부분도 선택에 들어간다. 가중치나 소견별 참여 모델을 자유롭게 고를수록 그 우연에 맞출 방법도 많아진다.
조합 선택 절차에 cross-fitting을 적용했다. Outer fold $k$를 평가할 때는 나머지 네 fold의 OOF로 조합을 고르고, 제외한 fold에서 평가한다.
\[c^{(-k)}=\operatorname{Select}(\mathrm{OOF}_{-k}), \qquad \widehat p_i^{\,\mathrm{cf}}=g_{c^{(-k(i))}}(P_i).\]Outer fold마다 선택한 조합은 달라질 수 있다. 이렇게 얻은 held-out 예측을 모아 macro AUC를 계산하면, 그 모델 집합·목적함수·runtime 계산 아래에서 선택 절차가 어떻게 작동했는지 평가할 수 있다. 이후 OOF 전체로 최종 구성을 고를 수 있다. 이때의 점수는 선택에 쓴 데이터에 특정 구성이 얼마나 잘 맞는지 나타내며, cross-fitting으로 평가한 절차의 점수와는 다른 결과다.
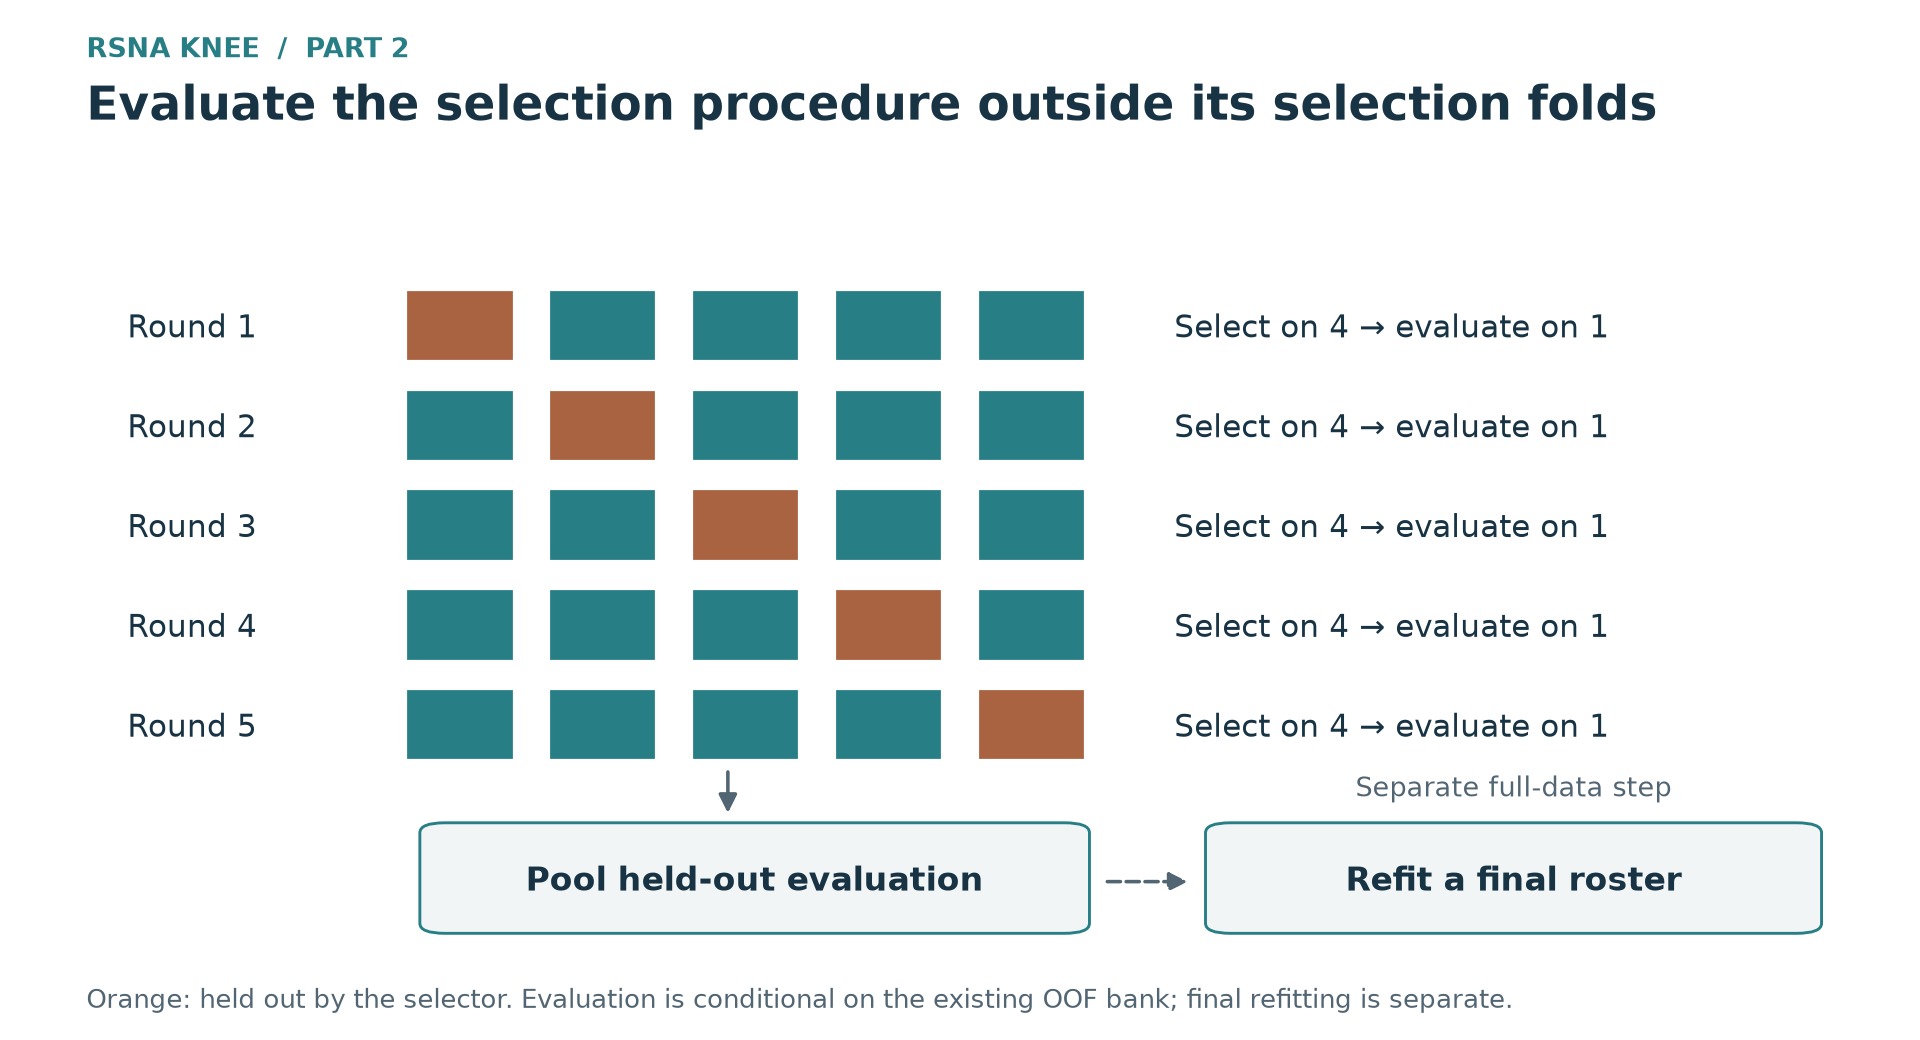 그림 4. 네 fold에서 선택하고 한 fold에서 평가하는 과정을 다섯 번 반복한다. 최종 구성은 별도로 OOF 전체에 fit해 정한다. 기존 예측 행렬에서 조합을 고르는 절차이며, outer fold 안에서 모든 base model을 다시 학습한 것은 아니다.
평가에서 제외한 정보와 고정 구성의 bootstrap 구간
기존 base model은 일반적인 다섯 fold 학습으로 만들었다. 조합 선택기가 outer fold의 평가 라벨을 직접 쓰지 않았더라도, 다른 fold를 예측한 모델은 해당 outer fold의 검사로 학습했을 수 있다. 따라서 이 cross-fitting은 이미 만들어진 예측과 그동안의 모델 개발을 고정한 채 조합 선택 단계를 평가한다. 전체 학습 과정을 fully nested 방식으로 평가한 것은 아니다.
예측을 모아 계산한 macro AUC는 fold별 AUC 다섯 개의 평균과도 다르다. 서로 다른 fold 사이의 positive–negative 쌍을 비교하므로 점수 범위의 차이가 영향을 줄 수 있다. 절차의 평가에는 어느 계산을 썼는지도 포함해야 한다.
선택한 구성을 고정한 paired bootstrap은 그 예측에서 검사들을 다시 뽑는다. 조합을 다시 고르지 않으므로 구성이 달라질 모든 경우를 반영하지는 않는다. 이 구간은 특정 구성과 검증 기준을 고정했을 때의 변동을 나타낸다. 조합을 반복해서 새로 고를 때의 변동이나 Public 잡음을 추정하지는 않는다.
로컬 추정치와 첫 제출 후보
9월 23일에는 후보가 83개 설정으로 늘었다. 실제 채점 실행에서 사용해 본 입력 그룹으로 범위를 제한하고 flat 선택과 소견별 선택을 비교했다. 계획 한도 540분에서 cross-fitted 주 지표 이득은 소견별 선택이 +0.0090으로, flat 선택의 +0.0067보다 높았다. 더 큰 추정 이득을 얻기 위해 훨씬 큰 구성을 먼저 시험할 것인지가 어려운 판단이었다.
계획 시간 한도를 바꾸자 차이가 더 잘 드러났다.
| 계획 시간 한도 | Flat 선택 이득 | 소견별 선택 이득 |
|---|---|---|
| 240분 | +0.0068 | +0.0086 |
| 300분 | +0.0067 | +0.0057 |
| 360분 | +0.0067 | +0.0074 |
| 420분 | +0.0067 | +0.0090 |
| 480분 | +0.0067 | +0.0083 |
| 540분 | +0.0067 | +0.0090 |
이 값들은 같은 기준 라벨과 목적함수로 선택 절차를 평가한 held-out 결과이며, Public 점수 예측이 아니다. Flat 선택의 변화는 작았다. 소견별 선택은 한도가 바뀌면 다른 조합을 골랐고, 300분에서는 outer fold 두 개가 fallback 구성을 사용했다. 시간 한도가 늘면 더 큰 조합도 고를 수 있다. 그렇다고 그 예측의 held-out AUC까지 단조롭게 올라야 하는 것은 아니다. 곡선은 선택 조건에 대한 민감도를 드러냈다. 이를 Public 잡음의 새 추정치나 소견별 선택을 곧바로 기각할 근거로 쓸 수는 없었다.
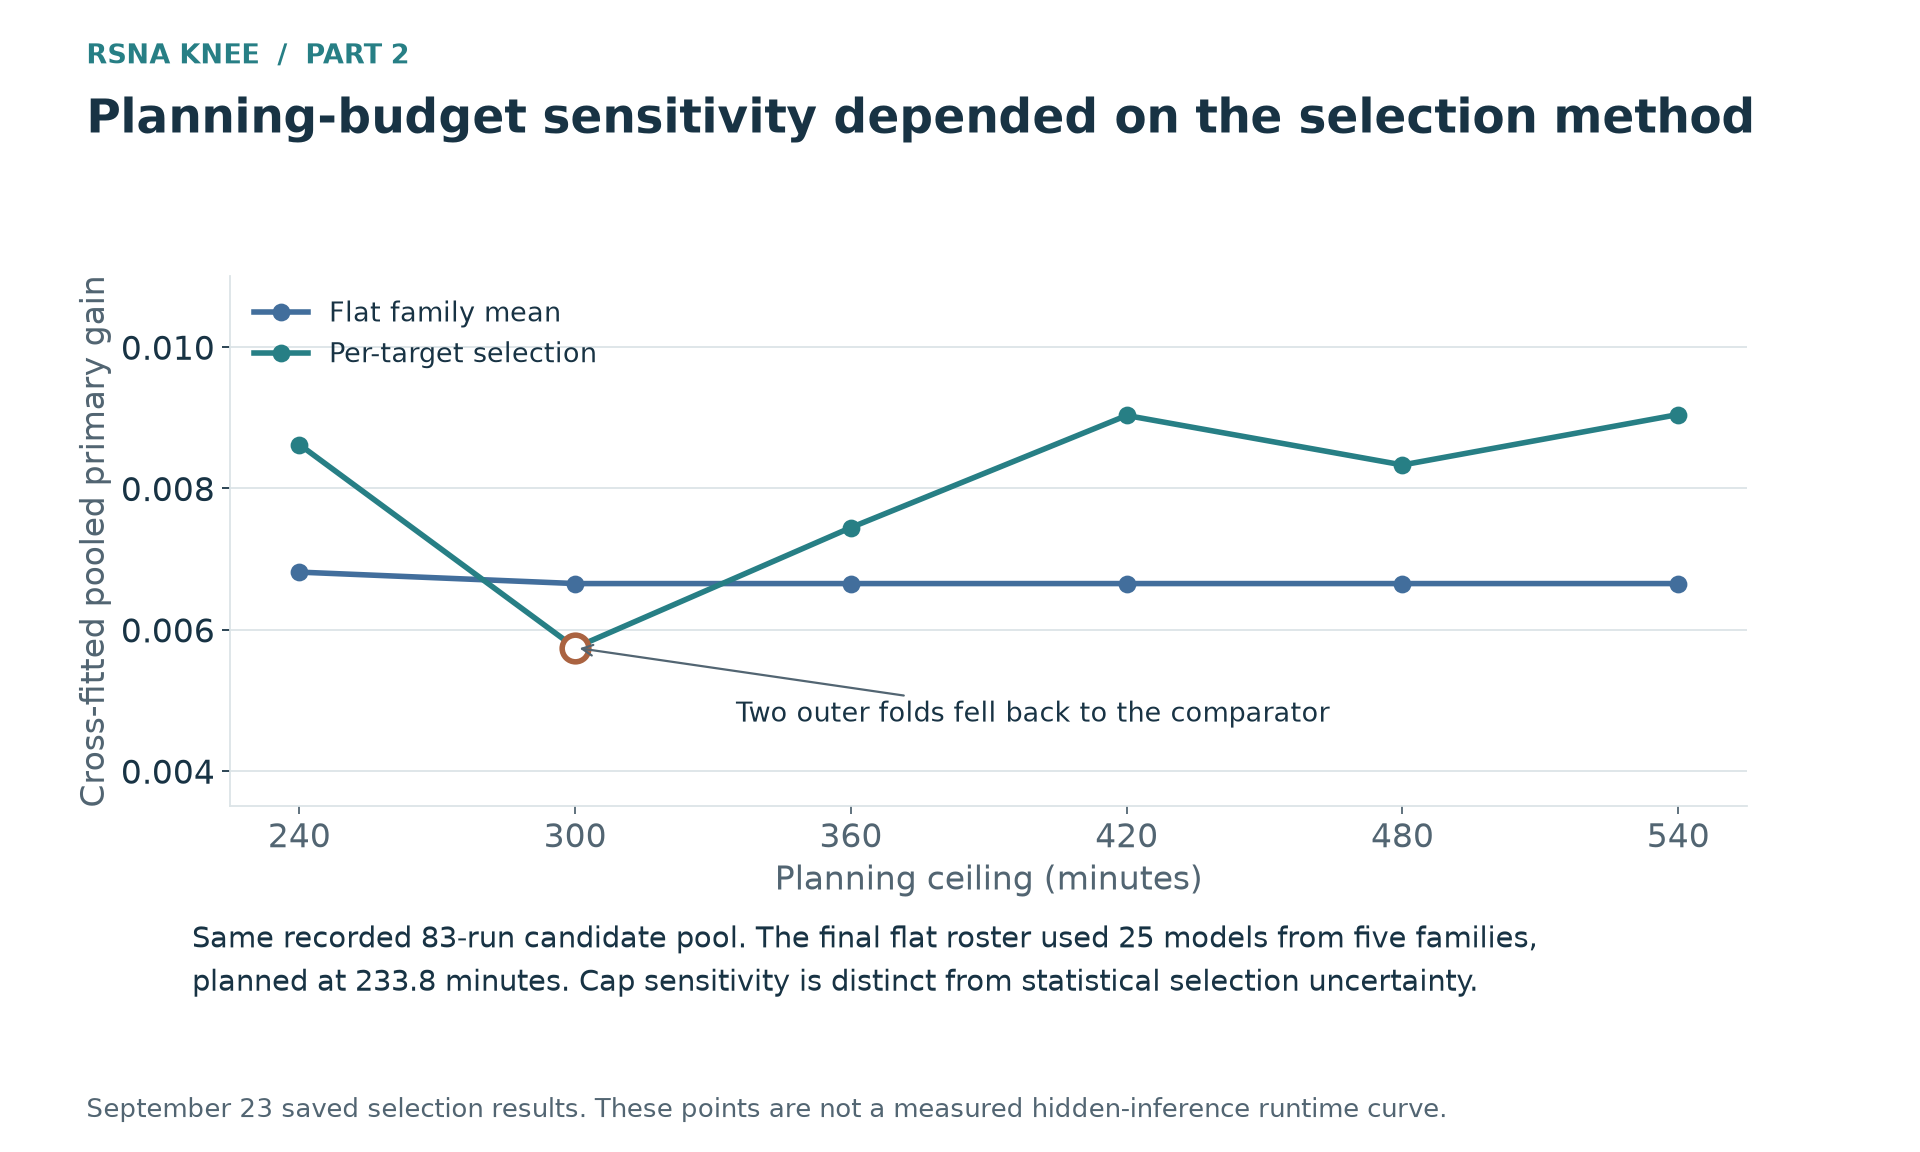 그림 5. 9월 23일 후보 집합에서는 flat 선택의 이득이 거의 안정적이고, 소견별 선택은 시간 한도에 더 민감했다. 300분 점에는 fold 두 개의 fallback이 포함된다. 앞의 76개 설정 표와 이 83개 설정 곡선은 서로 다른 시점의 후보 집합이다.
첫 시험에는 flat 구성을 썼다. 다섯 계열, fold 모델 25개, 입력 그룹 두 개였고 계획 시간은 233.8분이었다. 판독문 라벨로 학습한 DINOv2-small 기준 모델, 그보다 깊게 fine-tuning한 변형, hybrid 라벨 변형, ConvNeXt-large, 64-slice Raptor 결합 계열을 함께 골랐다. 기존 조합에 계열 하나를 덧붙인 것이 아니라, 모아 둔 OOF 전체에서 새로 고른 조합이었다. 계획 한도의 절반도 쓰지 않으면서, 더 큰 소견별 구성을 나중에 비교할 여지를 남겼다.
이 시스템은 9월 23일 Public 0.928을 받아 이전 0.921에서 올랐다. 외부 RadImageNet 성분도 여전히 포함돼 있었다. 나중에 시험한 소견별 구성은 0.931이었다. 조합 비교를 계속할 근거는 됐지만, 로컬 이득을 Public 이득으로 환산할 일반식을 얻은 것은 아니다. 모델 구성과 실행이 함께 바뀌었기 때문이다. 큰 조합이 bank를 가장 잘 활용한다고 가정하지 않고, 두 계열만 쓰는 소형 조합도 시험했다.
두 계열 조합의 비교 결과
가장 강한 소형 조합은 GPT 기반 라벨로 학습한 80-slice gated 모델과 공개 Raptor 라벨로 학습한 64-slice 결합 모델이었다. 둘 다 내 fold에서 완전한 OOF를 갖췄다. 단독 Public 점수는 0.935와 0.932였다. 두 계열의 fold 모델 10개를 flat rank mean으로 합치자 9월 30일 0.940을 받았다. 같은 모델 10개의 확률 평균은 10월 3일 0.941이었다. 어느 쪽에도 외부 checkpoint 성분은 없었다.
계획상 207.7분인 이 조합은 큰 대안들보다 훨씬 저렴했다. 539.8분인 구성은 0.935, 완주한 567.8분 구성은 0.937이었다. 다른 큰 조합들도 두 계열 조합보다 Public 점수가 낮았고, 판독문 기반 기준 라벨은 그중 일부를 로컬에서 더 높게 평가했다.
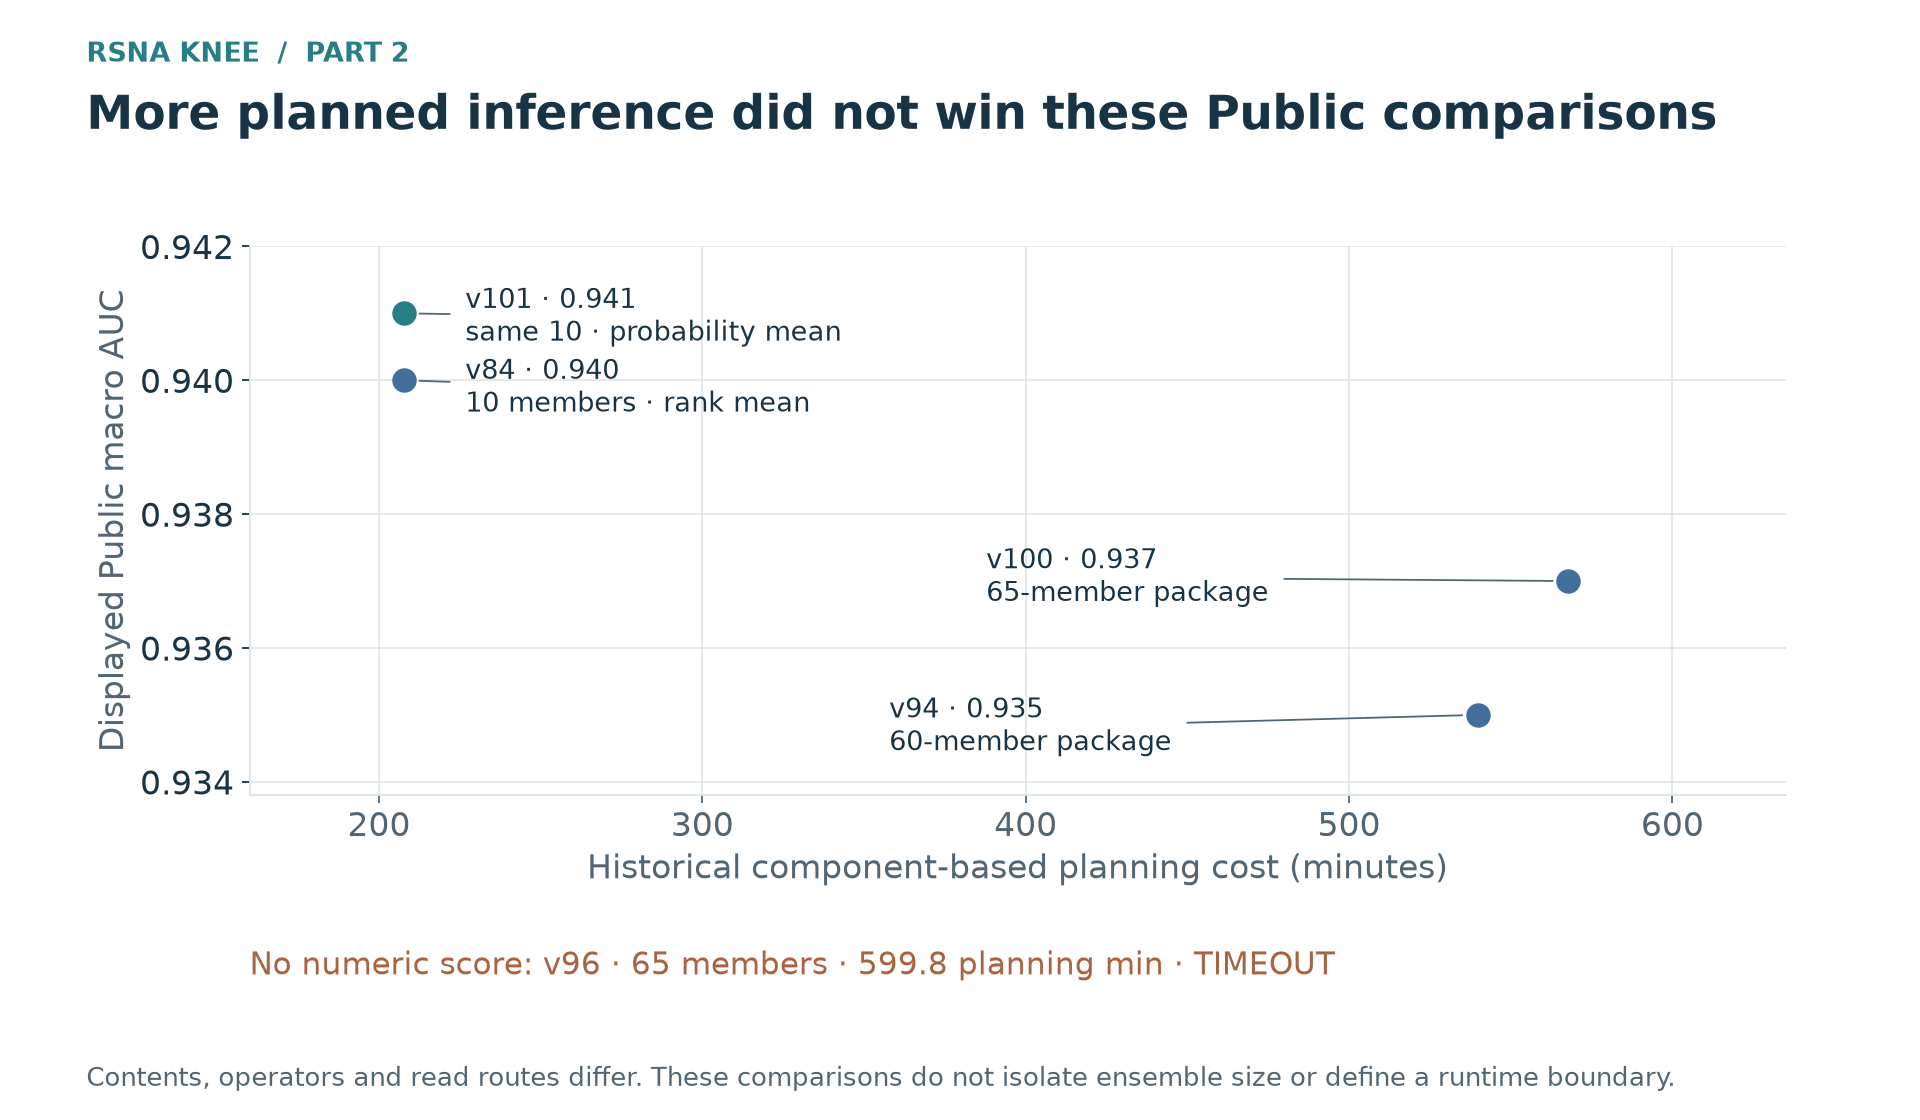 그림 6. 두 계열 조합의 순위 평균과 확률 평균은 같은 계획 시간 207.7분에서 0.940과 0.941을 받았다. 539.8분과 567.8분으로 계획한 큰 후보들은 0.935와 0.937이었다. 599.8분 시험은 timeout으로 AUC가 없었다. 비교마다 구성 내용과 집계 방식이 다르다.
이제 이 소형 조합은 실제로 선택할 수 있는 후보지만, 모델 수가 적을수록 좋다는 일반론은 아니다. 큰 구성에서는 어떤 예측의 비중이 크고 오류들이 어떻게 합쳐지는지도 달라진다. 완전한 OOF는 모두 보존한다. 새 모델이 생기거나 다른 목적함수를 쓸 근거가 생기면 또 다른 부분집합이 나을 수 있다. 기존 조합에 하나씩 더하는 비교만 했다면 이번처럼 여러 계열을 빼고 두 계열만 남기는 구성은 놓쳤을 것이다.
집계 방식 비교는 이 모델 10개에서 확률 평균을 지지한다. 표시 점수가 0.940에서 0.941로 올랐다. 모든 상황에 쓸 최적의 가중치 규칙을 얻었다는 뜻은 아니다. 앞으로도 비교할 질문을 먼저 정하고 Public에서 같은 방향의 개선이 나오는지 확인하려 한다. 작은 점수 차이가 날 때마다 가중치를 다시 맞추는 일은 피해야 한다.
시간 한도별 비교는 첫 제출 후보를 고르는 데 도움이 됐고, 밀집 입력 실험에서는 최적화 실패와 입력 변경의 효과를 구분할 수 있었다. 로컬 목적함수의 문제는 아직 풀리지 않았다. Raptor 라벨 계열은 Public 0.932로 GPT 라벨을 쓴 영상 대조군의 0.920보다 높았지만, 주 지표 기준은 대조군을 선호했다. 큰 ensemble에서도 이런 불일치가 나타난다. 지금은 선택 가능한 두 계열 후보와 다른 모델들의 완전한 OOF가 있다. 다음에는 영상 모델뿐 아니라 학습값과 기준 라벨도 비교해야 한다. 무엇 때문에 로컬과 Public에서 순서가 달라지는지는 아직 모른다.