RSNA Knee, Part 3: 학습 신호와 Public 성능
그림은 눌러서 확대할 수 있습니다. 좁은 화면에서는 넓은 표와 수식을 좌우로 움직여 보세요.
최근 비교 결과를 보면 모델들의 우열을 하나의 로컬 순위로 정하기 어렵다. 10월 초에는 학습 라벨을 바꾸자 로컬 점수가 내려가고 리더보드 점수는 올라가는 현상을 영상 조건을 맞춘 다섯 실험에서 봤다. 목적함수만 바꾼 다른 실험에서는 두 점수가 함께 올랐다. 라벨을 유지하고 영상 모델의 전체 구성을 바꾼 비교에서는 다시 로컬과 Public의 순서가 뒤집혔다. 점수들을 평균내면 이런 차이가 가려진다. 다음에 무엇을 학습할지 정하려면 각 실험에서 바꾼 조건부터 구분해야 한다.
학습용 검사 4,407건 대부분에는 대회 평가에 쓰이는 전문가 라벨 대신 영상의학과 판독문이 있다. 판독문 해석 모델은 이를 소견별 열두 값으로 바꾼다. 성능을 제한할 만한 요소도 여러 곳에 있다. 소견의 정의, 판독문에서 생략한 내용, 영상 모델이 보는 MRI의 범위, aggregation head가 영상들을 합치는 방식이 모두 중요하다. 공개된 상위권 recipe는 이 중 여러 요소를 함께 바꾼다. 어떤 시스템을 통째로 재현할지, 이미 확보한 모델로 어떤 가설부터 확인할지 골라야 한다.
N-mm12의 Public 결과는 아직 모른다. R949F는 첫 fold를 마쳤지만 five-fold 재현과 Public 비교는 끝나지 않았고, S6F는 코드 이식과 데이터 준비 중이다. 앞으로 쓸 학습 시간과 추론 용량을 정하는 데 이 결과들이 중요하다. 지금 이 비교들을 추진하는 이유를 앞선 실험부터 살펴보려 한다.
학습값과 모델의 최적 예측
소견 하나를 생각해 보자. MRI를 $X$, 판독문을 $R$, 알아내고 싶은 전문가 라벨을 $Y$, 판독문에서 추출한 학습값을 $q(R)\in[0,1]$로 쓰겠다. 영상 모델의 예측이 $p_\theta(X)=\sigma(z_\theta(X))$라면 binary cross-entropy는 다음과 같다.
\[\mathcal L(q,p)=-q\log p-(1-q)\log(1-p), \qquad \frac{\partial\mathcal L}{\partial z}=p-q.\]1편에서는 이 기울기로 백분위와 확률이 서로 다른 학습 신호라는 점을 설명했다. 한 사례의 업데이트에서 더 나아가, 모델이 학습을 통해 어떤 함수를 추정하는지도 봐야 한다. 표현력이 충분하고 다른 제약이 없는 이상적인 모델이 가중치 없는 BCE의 기댓값을 최소화하면 다음 값에 접근한다.
\[p^*(x)=\mathbb E[q(R)\mid X=x].\]영상이 주어졌을 때 판독문 기반 학습값의 조건부 기댓값이다. 이 값이 test에서 필요한 전문가 판단의 확률 $\Pr(Y=1\mid X=x)$와 반드시 같지는 않다. 영상에 보이는 가벼운 소견이 판독문에는 없을 수 있다. 어떤 해석 모델은 “가능성 있음”을 소견 존재의 불확실성으로 읽고, 다른 모델은 심한 정도를 나누는 표현으로 읽을 수 있다. 사례가 많아지면 어느 쪽 해석이든 더 잘 재현하게 될 수 있지만, 그 해석과 전문가 판단 사이의 차이가 저절로 해소되지는 않는다. 다만 확률의 calibration만 다르고 순서는 같다면 AUC는 달라지지 않는다. 중요한 것은 두 조건부 값이 검사들의 순서를 다르게 매기는지다.
따라서 학습값의 변환은 학습 문제 자체를 바꾼다. $q$를 문턱값 $\tau$에서 이진화하면 모델이 추정할 값은 $\mathbb E[q\mid X=x]$가 아니라 $\Pr(q>\tau\mid X=x)$가 된다. $q$를 백분위로 바꾸면 원하는 출력이 데이터 전체의 점수 분포에도 의존한다. 완성된 예측에 단조 변환을 해도 AUC가 유지된다는 성질만으로 이런 학습이 동등해지는 것은 아니다.
신뢰도 가중치는 목적함수의 다른 부분을 바꾼다. 음수가 아닌 가중치 $w$의 조건부 평균이 양수일 때, 가중 BCE의 이상적인 해는 다음과 같다.
\[p_w^*(x)=\frac{\mathbb E[wq\mid X=x]}{\mathbb E[w\mid X=x]}.\]가중치는 부정확한 사례의 영향을 줄일 수 있다. 반대로 눈에 잘 띄는 소견이나 전형적인 판독문 표현을 더 강조할 수도 있다. 학습값은 무엇을 배울지, 가중치는 각 사례를 학습에 얼마나 반영할지 정한다. 라벨 내용, 이진화, 신뢰도 가중치를 비슷한 라벨 정리 작업으로 묶지 말고 각각 비교해야 한다.
로컬 primary는 Opus와 GPT로 만든 판독문 기준 라벨표에 대한 AUC의 평균이고, v1은 더 오래된 기준이다. 각 기준의 이진화 규칙은 평가 정의의 일부이며 soft한 학습값과는 별개다. 완전한 five-fold OOF에는 평가 대상 fold를 학습에서 제외한 영상 모델의 예측이 있다. 전문가 라벨이 있는 gold58, 즉 검사 58건도 비교에 쓰지만 이미 여러 결정을 내리며 반복해서 들여다봤다. 어느 하나도 선택 과정과 무관한 독립적 정답으로 test의 순위를 확정해 주지는 못한다.
로컬과 Public 비교의 일치와 역전
먼저 영상 조건을 고정한 비교에서 중요한 결과를 얻었다. 10월 6일까지, 앞서 GPT 라벨로 학습한 다섯 모델 각각을 같은 영상 조건에서 Raptor 라벨표로도 학습했다.
| 영상 구성 | Public, 기존 → 대안 라벨 | Public 차이 | 로컬 primary 차이 |
|---|---|---|---|
| 64-slice fusion | 0.920 → 0.932 | +0.012 | −0.0054 |
| 80-slice gated 모델 | 0.935 → 0.939 | +0.004 | −0.0157 |
| 2D window 모델 | 0.899 → 0.903 | +0.004 | −0.0204 |
| ConvNeXt-B gated 모델 | 0.923 → 0.925 | +0.002 | −0.0222 |
| 80-slice fusion | 0.934 → 0.936 | +0.002 | −0.0181 |
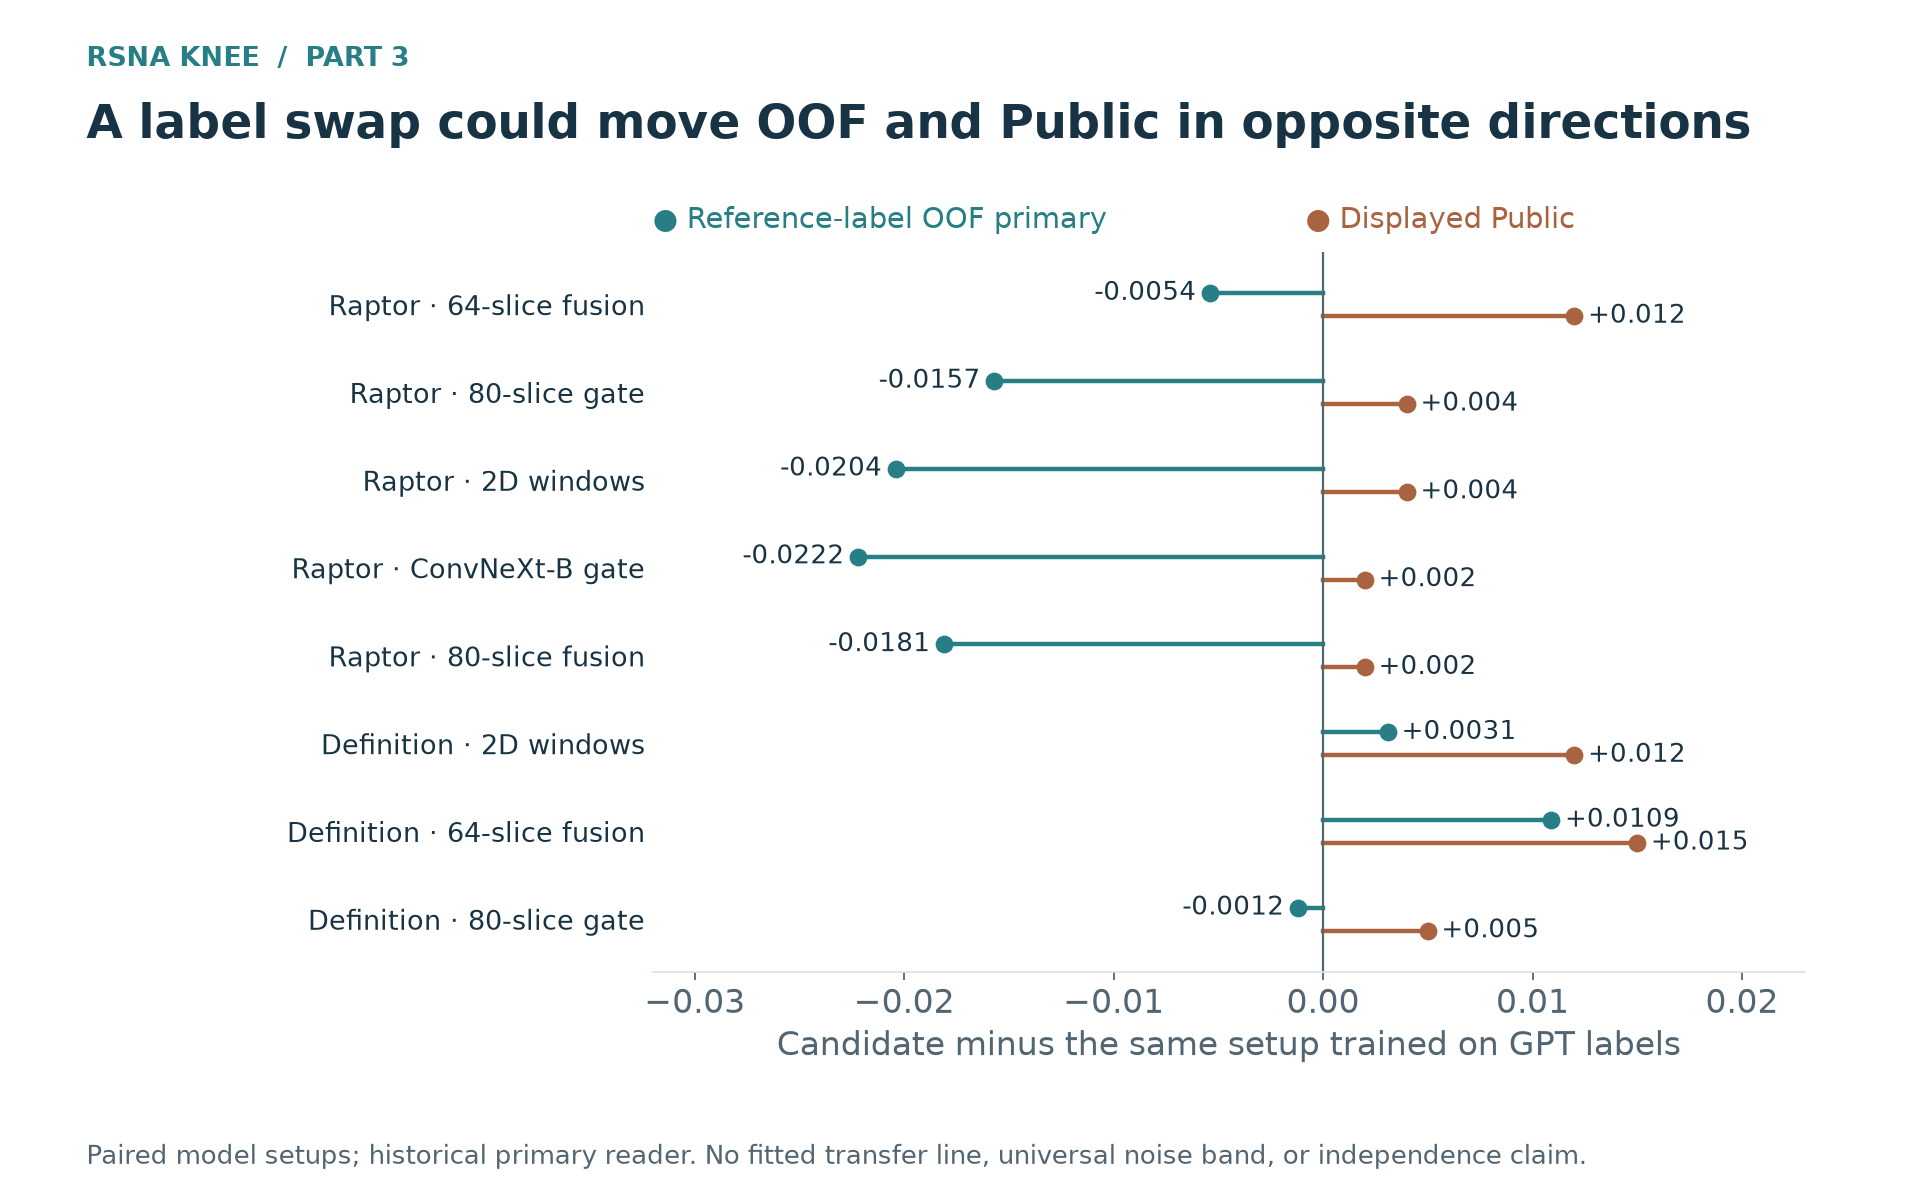 그림 1. 서로 관련된 다섯 영상 구성에서 학습 라벨을 바꾸자 primary는 낮아지고 표시된 Public AUC는 높아졌다. 데이터와 라벨 원천을 공유하는 실험들이므로, 순서가 뒤집힐 확률을 다섯 번 독립적으로 추정한 결과는 아니다.
이런 역전을 보면 primary가 내려갔다는 이유만으로 대안 라벨을 버릴 수 없다. 대조군의 학습 라벨과 로컬 기준이 판독문을 비슷하게 해석한다면 차이의 일부를 설명할 수 있다. 소견의 빈도, 심한 정도를 수치화하는 방식, 최적화 과정도 영향을 줄 수 있다. 지금 확인한 것은 순서가 뒤집혔다는 사실이다. 하나의 원인을 밝혀내거나, 앞으로의 로컬 차이를 Public AUC로 환산할 계수를 얻은 것은 아니다.
판독문 해석 모델에 소견의 정의를 명시했을 때는 양상이 달랐다. 세 영상 구성에서 정의를 반영한 라벨은 Public을 0.012, 0.015, 0.005 높였고, primary는 +0.0031, +0.0109, −0.0012 변했다. 신뢰도 가중치를 제거한 로컬 변화는 약 +0.0009로 작았고 구간에 0이 포함됐다. 정의 기반 학습값을 이진화하면 훨씬 나빴다. Primary가 약 0.0147 떨어졌으며, 모든 fold와 열두 소견 전부에서 차이가 음수였다. 이 학습 구성에서는 연속적인 값이 실제로 도움이 됐다. 다만 그 값이 보존한 유용한 정보가 불확실성인지, 심한 정도인지, regularization 효과인지는 이 결과만으로 구분할 수 없었다.
기준 라벨과 맞지 않는다고 모든 로컬 비교를 무시할 수는 없었다. DINOv2-B의 paired-window 실험이 좋은 반례였다. 두 학습 view의 확률을 $p_1,p_2$, 공통된 검사 단위 학습값을 $q$라고 하자. 대조군은 두 손실을 평균냈고, 대안은 두 확률을 먼저 평균낸 뒤 BCE를 적용했다.
\[\begin{aligned} \mathcal L_{\mathrm{mean}}&=\frac{\mathcal L(q,p_1)+\mathcal L(q,p_2)}2,\\ \mathcal L_{\mathrm{prob}}&=\mathcal L\!\left(q,\frac{p_1+p_2}{2}\right). \end{aligned}\]예측값을 고정하면 BCE가 확률에 대해 볼록하므로 $\mathcal L_{\mathrm{prob}}\leq\mathcal L_{\mathrm{mean}}$이다. 양성 검사 안에도 병변이 없는 window가 있다는 점에서 이 차이가 중요하다. Mean BCE는 각 window가 개별적으로 검사 전체의 학습값을 맞추도록 요구한다. Probability BCE는 두 window를 합친 예측을 평가한다. 후자가 추론에서 사용하는 확률 평균과 더 잘 맞지만, 이 부등식만으로 어느 모델의 학습 후 AUC가 높을지는 알 수 없다.
이 실험에서는 실제 결과도 같은 방향이었다. Backbone, 라벨, 입력, 멤버 다섯 개, 추론 방식을 고정했을 때 probability BCE는 primary를 0.00693 높였고, paired 비교 구간은 [0.00534, 0.00859]이었다. Public도 0.896에서 0.905로 올랐다. 반면 같은 정의 기반 라벨을 학습한 G25 2.5D window 모델은 V3 80-slice gated 구성보다 primary가 0.00942 높았지만, Public은 0.929 대 0.940으로 낮았다.
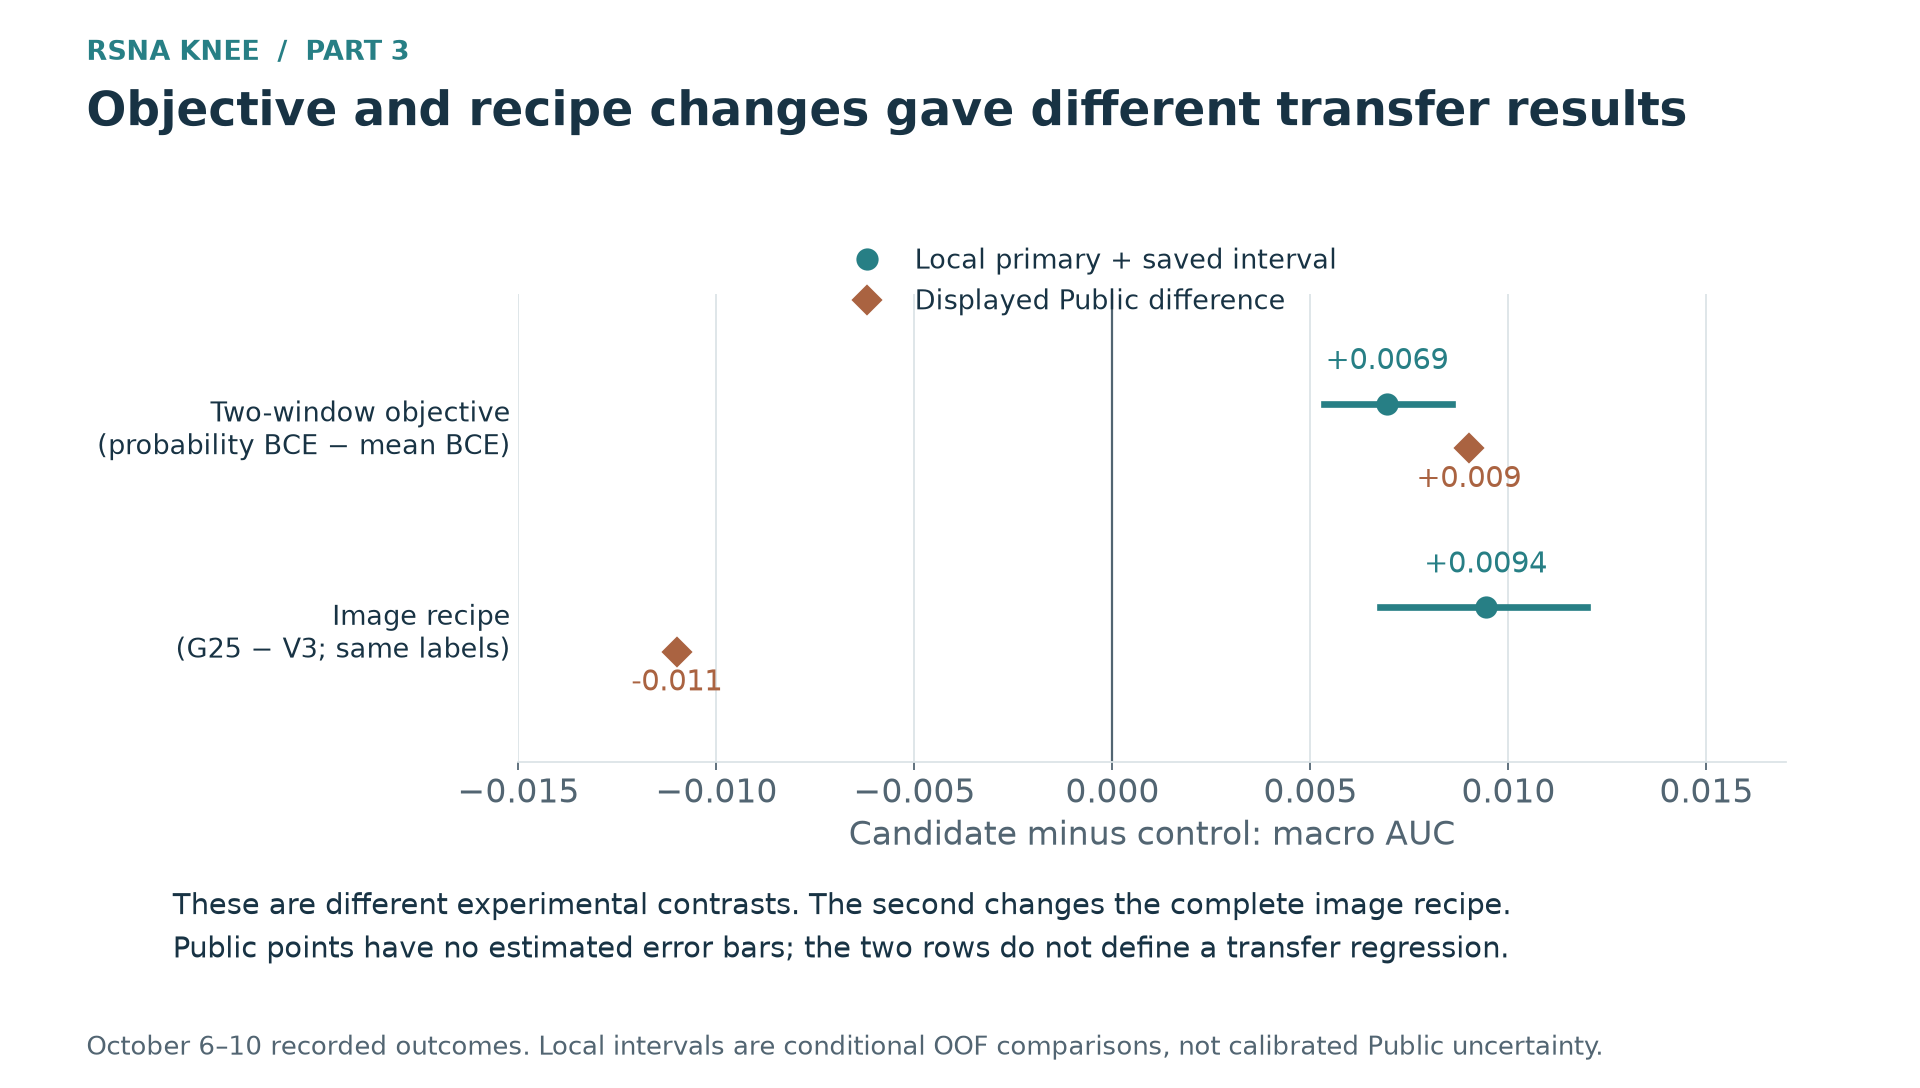 그림 2. 다른 조건을 고정한 목적함수 변경은 로컬의 개선 방향이 Public에서도 유지됐다. 같은 라벨로 영상 전체 구성을 바꾼 비교에서는 유지되지 않았다. 로컬 구간은 고정된 OOF 예측과 기준 라벨로 계산해 저장한 짝지은 비교 구간이다. Public은 별도의 잡음 모형을 가정하지 않은 실제 표시 점수다. 두 비교만으로 일반적인 architecture 효과를 분리할 수는 없다.
학습 라벨이 같다고 로컬 순서가 Public에서도 유지되는 것은 아니다. Architecture를 고정하면 라벨 변경을 해석하기는 쉬워져도 기준 라벨이 학습값의 내용과 독립적이 되지는 않는다. 로컬 결과는 실제로 비교한 조건 안에서 해석하고, 완전한 OOF는 ensemble 분석에 계속 쓴다. Public에서는 시험할 변경을 먼저 정해 몇 차례 비교하면서 test에서도 성능이 나아지는지 확인하려 한다. Architecture가 다르다는 이유로 OOF를 버리면 서로 보완할 수 있는 예측을 놓친다. 반대로 모든 로컬 순위를 test의 순서로 받아들이면 G25에서 했던 잘못된 판단을 되풀이하게 된다.
공개 recipe의 구성 요소와 재현 가설
공개된 상위권 코드를 활용하는 방법은 여러 가지다. 공개 모델의 예측을 final-only로 쓰거나, 그 시스템을 내 fold에서 다시 학습해 새로운 image-held-out 예측을 만들 수 있다. Crop이나 attention head, 라벨만 가져와 더 좁은 비교를 할 수도 있다. 마지막 방법은 다른 시스템 안에서 부품의 효과를 보는 실험이지 원래 recipe의 재현은 아니다. 각각 비용이 다르고, 확인할 수 있는 내용도 다르다.
r949 구성이 이를 잘 보여줬다. 0.949라는 결과에는 CoAtNet encoder, 특정 물리적 crop, 소견별 attention, 판독문 라벨의 혼합, 일부 소견에만 라벨이 있는 외부 무릎 영상, mirror 추론이 함께 들어 있었다. 공개된 점수 향상 과정에서도 여러 요소가 동시에 바뀌었다. 전체 시스템이 강하다는 근거는 있었지만, 어느 한 요소가 얼마를 높였는지는 측정되지 않았다.
입력의 의미조차 구현을 읽어야 정확해졌다. 먼저 중앙의 140 mm 정사각형 영역을 잘라 384픽셀로 바꾸고, 정확도를 우선한 추론 설정에서는 다시 중앙 320픽셀을 잘랐다. 원본 영상이 140 mm 영역을 자를 만큼 충분히 크다면 추론 영역은 약 116.7 mm였다. 학습 때 추론 crop보다 넓은 문맥을 본다는 뜻이지, DICOM 영상 전체를 자르지 않고 쓴다는 뜻이 아니었다. 기존 336픽셀 캐시나 96-slice G96 모델의 head를 그대로 재사용하면 학습을 시작하기도 전에 시험할 구성이 달라졌다.
| 구성 | 입력과 집계 방식 | 재현으로 확인할 질문 |
|---|---|---|
| r949 기반 R949F | 고정된 sequence 슬롯, 세 slice window, 소견별 window attention, mirror 추론 | 원래의 영상 처리·학습·라벨 조합이 정해 둔 fold에서도 성능을 내는가 |
| S6 기반 S6F | 외부 모델이 찾은 무릎 위치, 소견별 spatial attention 뒤 window attention, view·위치 정보 | 위치 추정과 두 단계 선택이 유용한 영상 정보를 더 잘 보존하는가 |
| Native-field N | 넓은 문맥과, 영상 중심 및 물리적 오프셋의 100 mm 국소 view | 같은 위치 추정에 의존하지 않고 문맥과 국소 영상을 함께 쓰면 도움이 되는가 |
무엇을 골라 합치는지도 다르다. Window attention은 영상별 요약이 소견 예측에 기여하는 비중을 정한다. S6는 window를 합치기 전에 각 window 내부의 공간 위치도 고른다. 반월상연골과 관절삼출을 예측할 때 서로 다른 영역을 강조할 수 있다. 위치를 먼저 찾으면 필요한 해부학적 부위에 해상도를 집중할 수 있지만, 위치 추정의 정확도와 처리 가능한 검사 범위에 의존하게 된다. N은 넓은 문맥과 국소 view를 함께 써서 이 의존성을 줄이려는 구성이다. Native reader는 0.4 mm 간격으로 최대 204.8 mm 영역을 읽고, 문맥 영상의 종횡비를 유지한 채 padding한다. Native field가 임의의 해상도로 제한 없이 넓은 영상을 읽는다는 뜻은 아니다.
모델 이름이 같아도 학습 방식에 따라 동작은 달라질 수 있었다. r949 원본은 한 번에 검사 하나를 처리하고 열여섯 검사의 기울기를 누적했다. 검사를 열여섯 개씩 한꺼번에 넣는 batch와는 batch normalization의 동작이 다르다. 외부 OAI 데이터는 무릎 2,399건이며, 소견 세 개에만 학습 라벨이 있었다. Masked BCE의 분모는 관측된 항목 수가 아니라 전체 열두 항목이었다. 따라서 일부 소견만 관측한 외부 검사는 열두 라벨이 있는 검사와 같은 방식으로 정규화되지 않았다. 외부 데이터의 OA·synovitis 정의도 내가 앞서 만든 대응 규칙과 달랐다. OAI를 추가했다는 설명만으로 결과를 재현하거나 개선 원인을 설명하기에는 정보가 부족했다.
학습 라벨의 원천도 서로 얽혀 있었다. Gemini 판독문 라벨표 하나를 $G$, 공개 혼합 라벨표를 $V$, JEV hybrid를 $H$라고 하자. 일반적인 경우에는 $B=(G+V)/2$를 만든 뒤 $Q=(B+H)/2$로 섞었다. JEV 자체는 $H=0.95S+0.05E$였고, $S$는 기존 공개 표에서 소견별 열을 고른 값, $E$는 서로 관련된 판독문 해석 결과의 혼합이었다. 해당 값들이 존재하는 경우 최종식은 다음과 같았다.
\[Q=0.25G+0.25V+0.475S+0.025E.\]$V$에서 소견이 언급되지 않은 경우는 별도 규칙으로 처리했다. 이 식이 중요했던 이유는 새 이름의 라벨표가 상당 부분 기존 라벨을 다시 조합한 것이기 때문이다. 독립적인 새 주석자가 추가된 것은 아니었다. 라벨 원천의 선택과 일부 혼합에는 이미 들여다본 전문가 사례도 쓰였다. 평가 fold의 영상을 제외하고 다시 학습하면 영상에 대한 holdout은 지킬 수 있지만, 재사용한 전문가 사례가 라벨 설계의 독립적인 검증 자료로 바뀌지는 않는다.
부품을 바꿔 본 결과만으로 전체 성능을 추측하지 않고 recipe를 재현하는 쪽으로 진행하고 있다. R949F는 첫 fold와 소규모 입력 재현 비교를 마쳤지만, 나머지 fold와 Public 비교는 아직 끝나지 않았다. S6F는 ImageNet으로 사전학습한 ConvNeXt-S와 SKM-TEA V-Net으로 찾은 위치를 사용하며, 코드 이식과 데이터 준비를 시작했다. 공개 S6 추론은 전체 데이터 모델에서 0.950, folds 1–4 모델에서 0.948을 보고한다. 다만 처리하지 못하는 검사에는 r949 예측을 대신 쓰므로, 이 점수만으로 내가 재학습할 five-fold 모델의 단독 성능을 알 수는 없다.
준비와 실행에 드는 비용도 작지 않다. S6F 계획에서는 캐시 250–310 GB, 코드 이식 10–14시간, five-fold 학습 약 9 GPU-hours를 예상한다. 학습이 오래 걸리면 16시간까지 필요할 수 있다. Stride 1로 읽는 T4×2 추론은 2.9–3.2시간으로 예상한다. 모두 준비 단계의 추정치이며 재현을 끝내고 측정한 값이 아니다. R949의 checkpoint 하나는 window 94개와 mirror를 읽는다. 다섯 fold를 모두 쓰면 검사당 backbone window 940개가 필요하다. 강한 공개 결과가 있으니 투자할 이유는 있지만, 캐시 생성과 완전한 OOF, 추론 용량에 드는 비용은 따로 계산해야 한다.
영상 보조 라벨과 student 비교
판독문에는 영상에 보이는 소견이 빠질 수 있다. Multimodal 해석 모델은 판독문 $R$과 선택한 일부 영상 $I$를 함께 보고 $q(R,I)$를 만들 수 있다. 해석 모델이 얼마나 자신 있게 답하는지는 판단 기준이 아니다. 이 학습값으로 훈련한 영상 student가 검사들의 순위를 더 잘 매기는지 확인해야 한다.
Pilot에는 gold58 이외의 검사 100건을 사용했다. 검사마다 fluid-sensitive sequence의 세 단면에서 slice 네 장씩, 총 열두 장을 넣었다. 판독문과 영상을 함께 준 답을 판독문만 준 답과 비교했다. 25건에서는 같은 입력을 반복하고 다른 검사의 영상으로 바꿔 넣기도 했다. Effusion 확률의 평균 절대 변화는 영상을 추가할 때 0.072, 같은 입력을 반복할 때 0.014, 다른 검사의 영상을 넣을 때 0.094였다. Synovitis에서는 0.038, 0.016, 0.040, contusion에서는 0.016, 0.003, 0.043이었다.
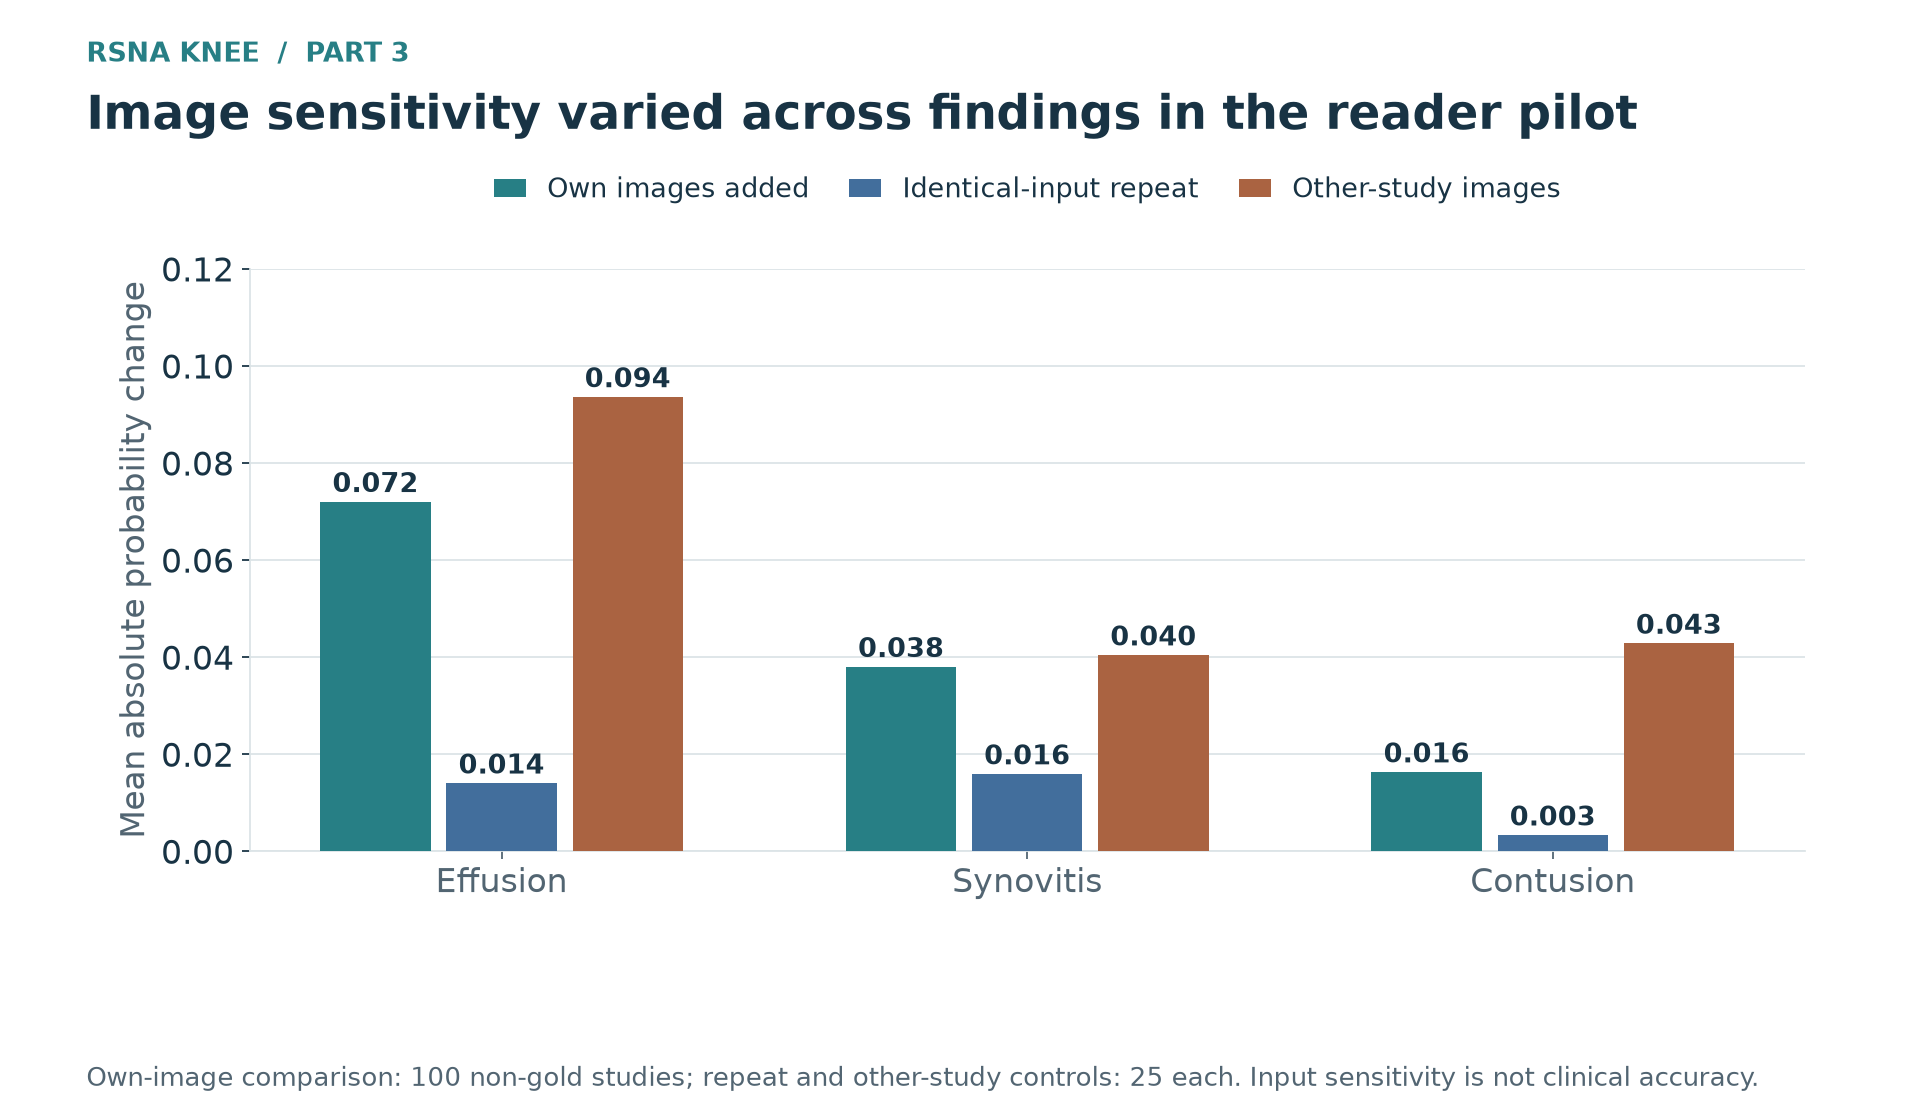 그림 3. Pilot은 영상 내용과 반복 입력에 대한 반응을 측정했다. 임상적 정확도를 측정한 것은 아니다. 영상 추가 비교는 검사 100건, 반복 및 다른 검사 영상 대조는 25건을 사용했다. 제한된 영상 요약에 대한 반응도 소견마다 달랐다.
Effusion의 반응이 커서 effusion만 갱신하는 방안은 타당해 보였다. 다른 가능성도 있었다. 나머지 소견에 걸친 작은 변화들이 pilot에서 가장 눈에 띈 effusion의 변화보다 학습에는 더 도움이 될 수 있었다. 라벨 생성을 확대하기 전에 두 student 비교를 모두 정했다. mmE는 effusion만 바꾸고, mm12는 열두 소견 모두에 영상 보조 라벨을 썼다. 신뢰도 가중치, 학습에 포함할 항목을 정하는 mask, gold 행은 그대로 뒀다. 어떤 사례를 학습에 반영할지 바꾼 것이 아니라 학습값의 내용을 비교한 셈이다. 저장된 사용량으로 계산한 pilot과 전체 라벨 생성의 예상 비용은 약 $94.9였으며, 실제 청구 내역과 대조해 확정한 금액은 아니었다.
| 동일한 소형 2D student | 정의 기반 라벨 대비 primary 차이 | paired 비교 구간 | Public |
|---|---|---|---|
| 정의 기반 대조군 | — | — | 0.911 |
| mmE, effusion만 변경 | +0.0003 | [−0.0029, +0.0036] | 0.912 |
| mm12, 열두 소견 변경 | +0.0063 | [+0.0031, +0.0093] | 0.914 |
이 student에서는 열두 소견을 바꾼 쪽이 더 유용했다. Primary가 가장 크게 오른 소견은 effusion만이 아니라 lateral meniscus, synovitis, fracture였고, 몇몇 소견은 오히려 떨어졌다. 판독문 해석 모델의 effusion 답변이 민감하게 변한다는 사실만으로 어떤 소견의 라벨까지 바꿔야 도움이 될지는 알 수 없었다. 다른 검사 영상을 넣은 대조도 정확성을 보장하지 않았다. 답변이 자연스러워도 무관한 영상에 영향을 받을 수 있고, 열두 slice만으로는 국소 병변을 놓칠 수 있다. Student 실험은 그렇게 만든 라벨의 학습 가치를 확인한 것이며, 바뀐 라벨 하나하나의 임상적 정확도를 입증한 것은 아니었다.
이어 더 강한 영상 모델에서도 같은 이득이 생기는지 확인했다. mm12는 64-slice fusion student의 primary를 약 0.0064, 2.5D window student에서는 0.0037 높였다. Fusion 모델의 전체 개선 중 절반 이상이 한 fold에서 나왔으므로, 합쳐서 계산한 값과 함께 fold별 분포도 봐야 했다. 별도의 80-slice 비교에서 확인한 결과는 아직 첫 fold뿐이다. 완전한 five-fold 결과와 나란히 비교할 수는 없다.
다음에 확인할 중요한 결과는 N의 라벨 비교다. 정의 기반 N은 five-fold를 마쳤고 10월 14일 Public 0.942를 기록했다. 같은 정의 라벨을 쓴 G25는 0.929였다. 이 차이는 영상 구성 전체의 비교이며 field of view 하나의 효과가 아니다. N-mm12는 로컬에서 primary 0.8913 대 0.8885, 저장된 차이 +0.0027, 구간 [+0.0010, +0.0044]를 보였고 다섯 fold 모두 양수다. 각 점수와 차이는 따로 반올림해 표시했다. Public 결과는 아직 모른다. N의 영상 구성을 유지한 비교이므로, 작은 student에서 본 이득을 그대로 일반화하지 않고 강한 모델에서도 새 학습 신호가 도움이 되는지 확인할 수 있다.
Teacher 정보와 사전확률 대조군
Visual teacher는 판독문 표현이 다른 검사들 사이에서도 영상의 유사성을 학습값에 반영할 수 있다. 다만 판독문 라벨을 teacher와 섞으면 내용과 수치 분포가 함께 바뀐다. Distillation 뒤 성능이 좋아졌다는 결과만으로 어느 쪽이 도움을 줬는지는 구분되지 않는다.
첫 teacher 실험에서는 소형 2D student를 고정했다. 정의 기반 학습값을 $q$, teacher 예측을 $t(X)$, 학습 데이터에서 계산한 소견의 빈도를 $\pi$라고 하자. 비교한 값은 다음과 같았다.
\[q^{S_b}=0.5q+0.5t(X), \qquad q^R=0.5q+0.5\pi.\]S-b는 열두 소견 모두에 teacher 혼합을 적용했다. R은 같은 혼합 계수로 학습값을 영상과 무관한 사전확률 쪽으로 당겼다. S-a는 effusion, contusion, fracture, Baker’s cyst 네 소견에만 teacher를 섞었다. 이 네 소견은 gold58을 참고해 고른 것이므로, 이후 같은 전문가 사례로 평가한 결과는 이미 그 선택의 영향을 받은 상태였다.
R과 비교하면 영상에 따라 달라지는 teacher 정보의 효과를, 값을 사전확률 쪽으로 당기는 효과와 일부 구분할 수 있었다. 다만 두 라벨 분포의 entropy까지 맞춘 것은 아니었다. 혼합 계수가 같아도 학습값이 같은 정도로 soft해지지는 않는다. 이 한계를 감안해도 두 결과의 차이는 컸다. 정의 기반 대조군보다 S-b의 primary는 0.0078 높았고 R은 0.0092 낮았다. S-b와 R을 직접 비교한 차이는 +0.0170, 저장된 구간은 [+0.0141, +0.0200]였으며, 다섯 fold와 열두 소견 모두에서 양수였다.
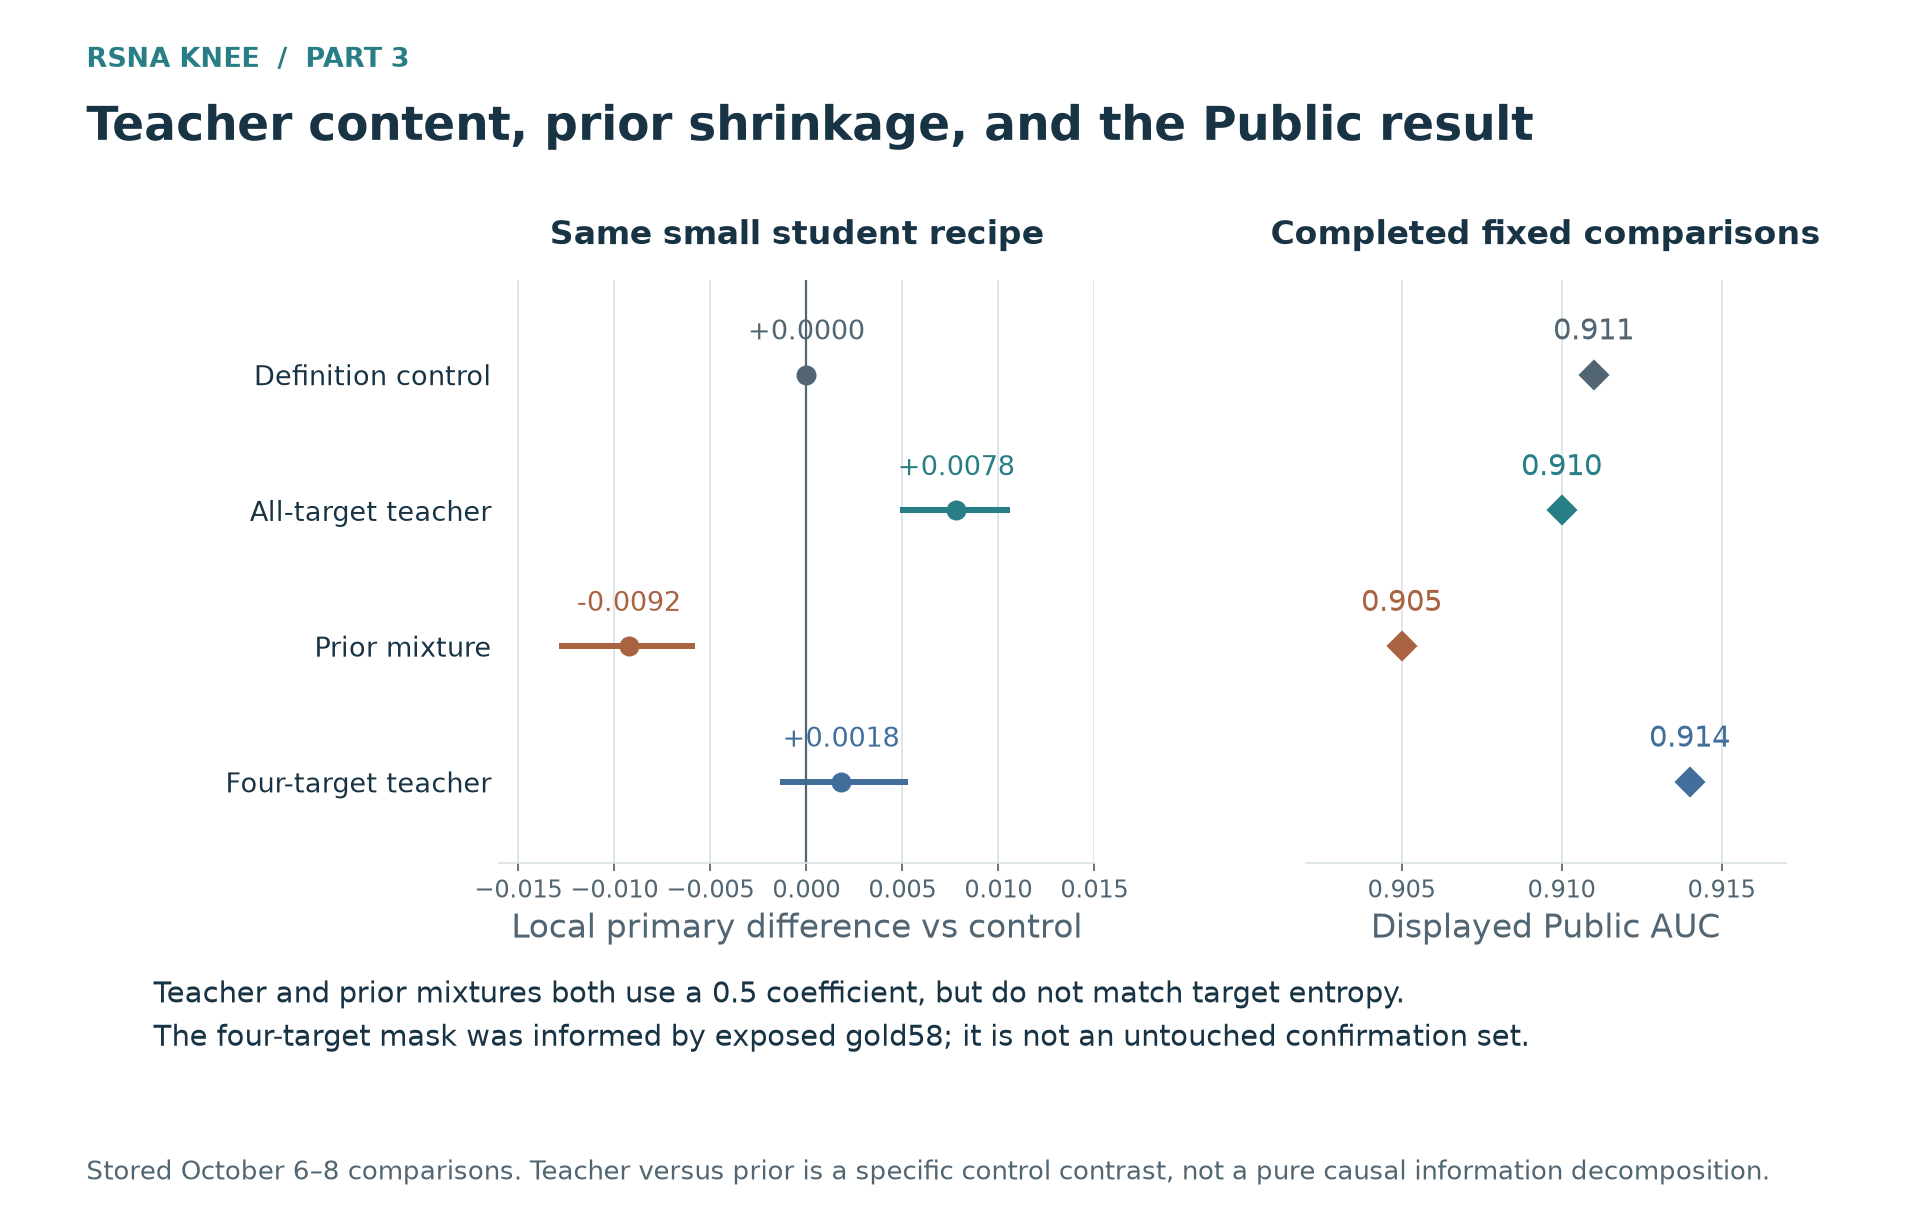 그림 4. 동일한 student를 정의 기반 라벨, 전체 소견 teacher 혼합, 사전확률 혼합, 네 소견 teacher 혼합으로 학습했다. 로컬 구간은 저장된 OOF 예측을 짝지어 비교한 결과다. 네 소견의 선택에는 gold58을 썼다. Public에서는 test에서도 성능이 나아지는지 볼 수 있지만, 그 소견 선택 절차를 독립적으로 검증한 것은 아니다.
Public에서는 해석이 더 복잡해졌다. 대조군 0.911에 대해 S-b는 0.910, R은 0.905, S-a는 0.914였다. Teacher 정보는 primary뿐 아니라 Public에서도 이 사전확률 대조군보다 나았지만, 전체 소견에 teacher를 섞은 모델이 원래 대조군의 표시 점수까지 넘지는 못했다. 로컬에서는 S-b가 가장 좋았고 Public에서는 S-a가 가장 좋았다. 여러 번 사용한 전문가 라벨로 평가하면 사전확률 혼합이 더 높았지만, 그 모델의 Public은 가장 낮았다. 평가 하나를 보편적인 순위 기준으로 삼으면 이 실험의 다른 부분을 놓치게 됐다.
Teacher 방식은 계속 검토하되, 모든 소견에 distillation을 적용하는 편이 항상 낫다고 보지는 않는다. 영상에 따른 teacher 예측이 판독문에서 빠진 정보를 보완할 수는 있지만, teacher의 성능과 예측하는 소견, student와의 상호작용에 따라 결과가 달라진다. 같은 약한 teacher의 변형을 늘리는 대신, 더 강한 teacher를 쓴 비교도 진행했다.
강한 teacher와 평가 fold의 제외 조건
음수가 아니고 합이 1인 가중치에 대해 BCE는 학습값에 선형이다.
\[\mathcal L\!\left(\sum_s\lambda_s q_s,p\right) =\sum_s\lambda_s\mathcal L(q_s,p).\]따라서 학습값의 혼합은 각 원천의 값을 정해진 가중치만큼 학습에 반영한다. 이 항등식이 각각 따로 학습한 student들을 혼합 라벨로 학습한 student 하나와 같게 만들지는 않는다. 대신 더 강한 T* 구성이 어떤 답을 배우도록 요구했는지는 분명해진다.
\[q^{T^*}=0.50\,q^{\mathrm{definition}} +0.25\,p^{\mathrm{ensemble}} +0.25\,p^{\mathrm{public\ S6}}.\]공개 visual teacher는 판독문만으로 구분하지 못한 차이를 학습값에 더할 수 있다. 동시에 teacher의 학습 이력에 따라 평가 문제가 생긴다. Fold $j$를 검증용으로 남긴 student를 생각해 보자. Student의 학습 사례 하나가 fold $k$에 있을 때, $k$만 제외하고 학습한 teacher는 $j$를 이미 봤을 수 있다. Student가 검증 영상을 직접 학습하지 않아도, teacher를 거친 학습값에 검증 라벨의 정보가 들어올 수 있는 것이다.
Student의 검증 결과에 이런 정보가 섞이지 않으려면 teacher 학습에서 $j$를 제외해야 한다. 앞선 통제실험의 B2 구성은 여기에 $k$도 제외했다. Teacher가 예측값을 제공할 student 학습 사례도 teacher 학습에서 제외한 것이다. 현재 확보한 T*의 ensemble 및 공개 예측에는 student의 평가 fold를 제외했다는 보장이 없다. T* student와 후속 모델을 final-only로 분류하는 이유다. Test 예측에는 쓸 수 있지만, clean OOF로 ensemble을 고르는 과정에는 넣지 않는다. Student를 내 환경에서 학습해도 teacher를 통해 들어온 정보가 사라지지는 않는다.
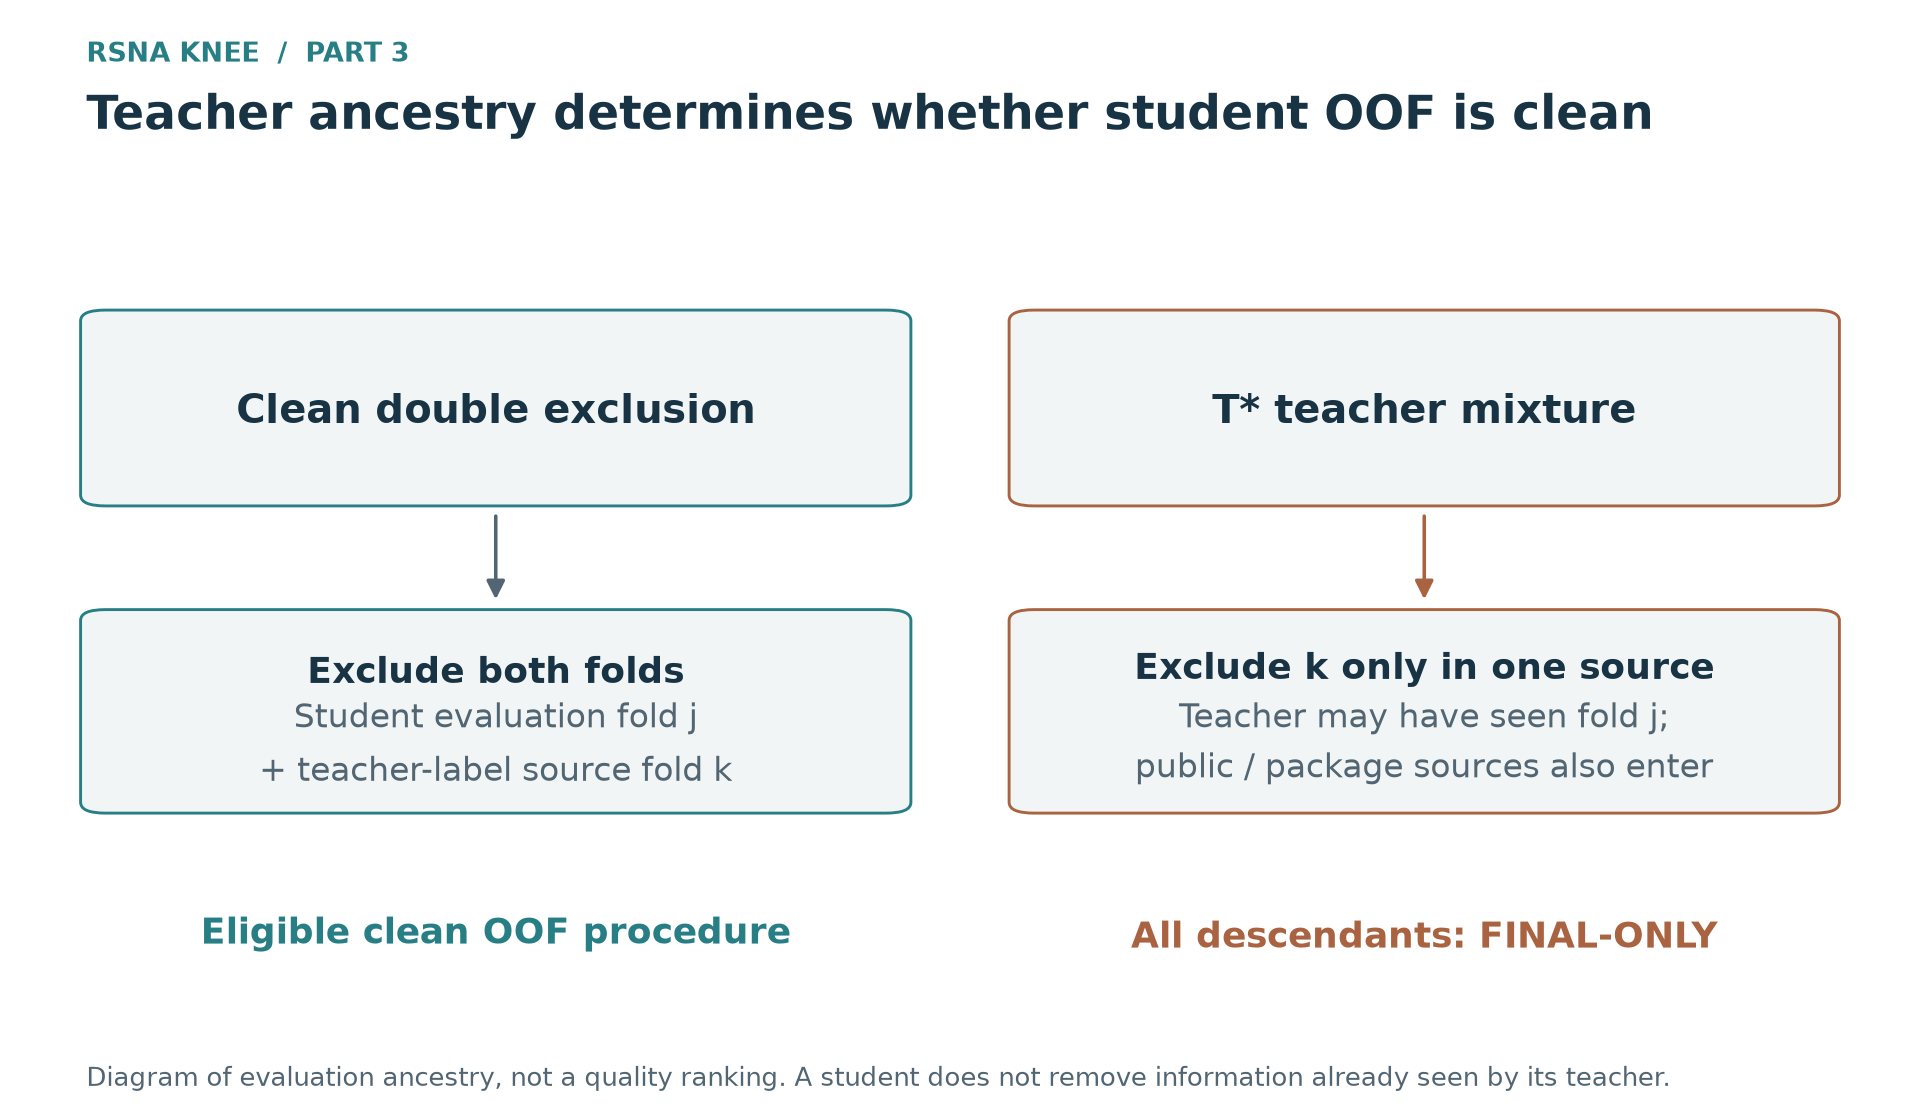 그림 5. B2는 student의 검증 fold와 teacher 예측을 받을 학습 사례의 fold를 모두 제외한다. T*는 그 보장 없이 더 강한 예측을 활용한다. Teacher 학습에서의 이 문제와 판독문 라벨을 설계하며 전문가 사례를 재사용한 문제는 별개다.
10월 14일 G25 T* student가 0.945를 기록했다. 앞선 ensemble-teacher 버전은 0.939, 정의 기반 학습은 0.929였다. 오늘 10월 15일 오전에는 G96 T* student도 0.945를 기록했다. OAI 없이 Raptor 라벨로 학습한 이전 버전은 0.934였다. G96에서는 정의 라벨로 만든 ranking pair와 label-aware batch도 함께 썼으므로, 학습값의 혼합 계수 하나만 바꾼 비교는 아니다. 두 student는 teacher의 출처를 일부 공유한다. 새로운 영상 정보를 서로 독립적으로 두 번 발견한 결과로 볼 수는 없다.
더 강한 영상 기반 학습 신호를 계속 시험할 근거는 있다. 다만 낙관적인 로컬 점수를 clean ensemble 선택에 쓸 수는 없다. B2 teacher와 비교해도 teacher의 내용과 학습 구성이 함께 달라지므로, 누수의 효과만 분리한 실험이 되지는 않는다. 평가 fold를 제외하고 학습한 모델들의 예측은 보존해 ensemble을 분석한다. Final-only student는 teacher의 출처를 기록하고, 미리 정한 외부 비교로 평가하려 한다.
다음 판단에는 세 가지 비교가 필요하다. N-mm12의 로컬 개선이 Public에서도 유지되는지는 아직 모른다. R949F와 S6F는 완전한 재현과 추론 시간 측정이 나와야 준비·추론 비용을 들일 만큼 나아졌는지 판단할 수 있다. 더 강한 teacher로 학습한 student도 영상 모델들과 함께 비교해야 한다. 서로 보완할 수도 있고, 같은 teacher에서 받은 순위를 대부분 되풀이할 수도 있다. 이 결과들을 보고 다음 학습과 추론에 자원을 배분하려 한다. 판독문 해석 모델 하나나 반복해 사용한 전문가 집합, Public 점수 하나로 세 비교를 모두 대신할 수는 없다.