Google Quantum Circuit Compilation 소개
양자 회로의 기본 원리와 invsqrt·DQI·분자 Hamiltonian 과제의 회로 구조, 비용식, 최적화 방법, baseline 검증 결과.
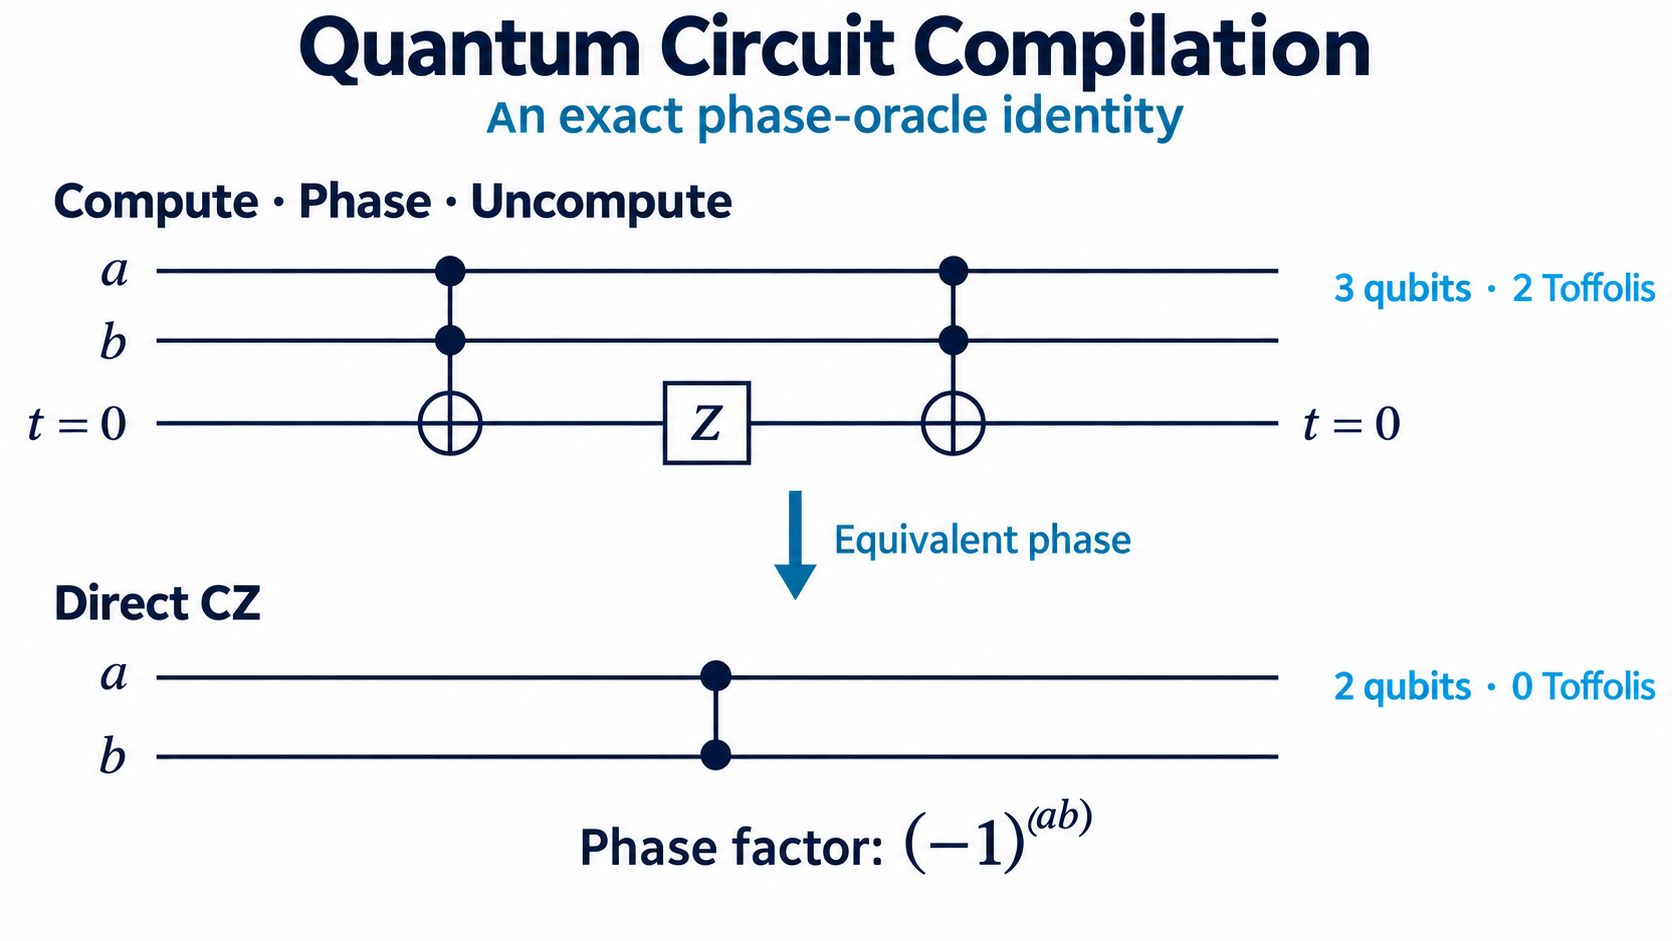
들어가며
양자 알고리즘을 공부하다 보면 Fourier transform, phase estimation, 분자 시뮬레이션 같은 주제를 접하게 된다. 그런데 실제 회로를 만들다 보면 훨씬 기초적인 질문에서부터 막힌다. 정수 두 개를 더하는 데 qubit이 몇 개 필요할까? 표에 있는 값 하나를 읽으려면 gate를 얼마나 써야 할까? 계산 중에 쓴 보조 qubit은 마지막에 어떻게 0으로 돌려놓을까?
Google Quantum AI — Verifiable Quantum Circuit Compilation은 이런 계산을 더 효율적인 양자 회로로 구현하는 대회다. 주최 측이 제시한 세 가지 subroutine에서 같은 결과를 내면서 필요한 qubit 수와 gate 비용을 줄이는 것이 목표다. 고전 프로그램에서 자주 호출하는 함수를 최적화하는 일과 비슷하지만, 양자 회로에서는 입력별 phase와 보조 qubit의 상태까지 맞춰야 한다.
어떤 subroutine을 1,000번 호출하고, 한 번에 비용이 큰 gate 8,000개를 쓴다고 해 보자. 이 부분에만 800만 개가 필요하다. 한 번의 계산을 6,000개로 줄이면 전체는 600만 개가 된다. qubit은 다음 호출에서 재사용할 수 있으므로 gate 수처럼 호출 횟수만큼 더하지 않는다. 대신 계산 중 동시에 필요한 qubit 수를 센다.
| 활용 분야 | 이 대회에서 최적화할 부분 | 전체 알고리즘에서 하는 일 |
|---|---|---|
| Coulomb 상호작용 시뮬레이션 | invsqrt: inverse square root에 비례하는 phase | 입자 사이의 거리에 따른 상호작용을 적용한다. |
| Decoded Quantum Interferometry | dqi: Reed–Solomon decoding과 phase 보정 | 오류 패턴을 복원해 측정 과정에서 생긴 phase를 보정한다. |
| 분자의 전자 구조 시뮬레이션 | dfthcsos: factorization, 각도 조회, 회전 구성 | Hamiltonian을 양자 회로에서 사용할 수 있도록 구현한다. |
세 과제의 활용 분야는 서로 다르지만, 처음 확인할 사항은 같다. 회로에 어떤 입력을 넣는지, 어떤 출력을 내야 하는지, 허용오차는 얼마인지, 비용은 어떻게 계산하는지를 알아야 한다. 각 과제의 물리적·수학적 배경은 공식 배경 설명을 참고하면 된다.
1. qubit, amplitude, phase부터 이해하기
1.1 비트열마다 amplitude를 함께 적는다
고전 비트의 값은 0이나 1이다. qubit을 측정했을 때도 결과는 둘 중 하나로 나온다. 이 두 상태를 |0⟩, |1⟩로 적고, 이를 computational basis로 삼는다. 세로줄과 꺾쇠는 양자 상태를 적는 기호다. 그렇다면 측정하기 전의 qubit은 어떻게 나타낼까? pure state라면 다음과 같이 쓴다.
여기서 α와 β를 amplitude라고 한다. computational basis에서 측정하면 0이 나올 확률은 ∣α∣², 1이 나올 확률은 ∣β∣²다. amplitude를 확률과 혼동하면 안 된다. amplitude는 음수나 복소수일 수 있고, 계산 과정에서 서로 더해지거나 상쇄되기도 한다. 단순히 0과 1 중 하나를 무작위로 뽑는 프로그램으로는 이 동작을 설명할 수 없다.
qubit이 n개라면 computational basis의 각 상태는 n자리 비트열에 대응한다. 예를 들어 qubit 세 개의 basis state 하나를 |101⟩로 적을 수 있다. 일반적인 상태를 나타내려면 비트열 하나만으로는 부족하다. 가능한 비트열과 각 비트열의 amplitude를 함께 적어야 한다.
여러 basis state가 이처럼 함께 나타나는 상태를 superposition이라고 한다. 비트열 2ⁿ개에 각각 amplitude가 있더라도 2ⁿ개의 값을 한꺼번에 읽을 수는 없다. 측정하면 그중 하나만 나온다. 양자 알고리즘에서는 amplitude를 바꿔 가며 원하는 결과가 나올 확률을 높인다. 표기와 기본 연산을 더 공부하고 싶다면 IBM의 양자 정보 강의를 참고하면 된다.
여러 qubit을 묶어서 하나의 값으로 다룰 때는 register라고 부른다. invsqrt의 x register는 qubit 22개로 정수를 나타낸다. 여기서는 little-endian을 사용하므로 q₀이 가장 낮은 자리다. q₀=1, q₁=0, q₂=1이면 값은 1+0×2+1×4=5가 된다. 회로도에 선이 놓인 순서만 보고 자리값을 짐작하지 말고, register의 정의를 확인해야 한다.
1.2 측정 확률이 같아도 같은 상태는 아니다
다음 두 상태를 비교해 보자.
\[\lvert +\rangle=\frac{\lvert 0\rangle+\lvert 1\rangle}{\sqrt{2}}, \qquad \lvert -\rangle=\frac{\lvert 0\rangle-\lvert 1\rangle}{\sqrt{2}}.\]두 상태를 지금 측정하면 0과 1이 각각 절반의 확률로 나온다. 하지만 두 번째 항의 부호가 다르다. |−⟩에서는 그 amplitude에 −1=eⁱπ가 곱해져 있다. 복소평면에서는 반 바퀴 회전한 값이다. 이 relative phase의 차이는 바로 측정할 때는 드러나지 않지만, 다른 gate를 적용한 뒤에는 측정 확률까지 바꿀 수 있다.
Hadamard gate H를 적용해 보면 그 차이를 확인할 수 있다. H의 동작은 다음과 같다.
\[H\lvert 0\rangle=\lvert +\rangle,\quad H\lvert 1\rangle=\lvert -\rangle, \qquad H\lvert +\rangle=\lvert 0\rangle,\quad H\lvert -\rangle=\lvert 1\rangle.\]0에서 시작해 H를 두 번 적용하면 다시 0으로 돌아온다. 두 H 사이에 Z를 넣으면 어떻게 될까? Z가 두 번째 항의 부호를 뒤집으므로, 마지막 H를 통과한 뒤에는 1이 된다. 이렇게 amplitude가 더해지거나 상쇄되는 interference를 이용하면 phase의 차이를 측정 결과로 확인할 수 있다.
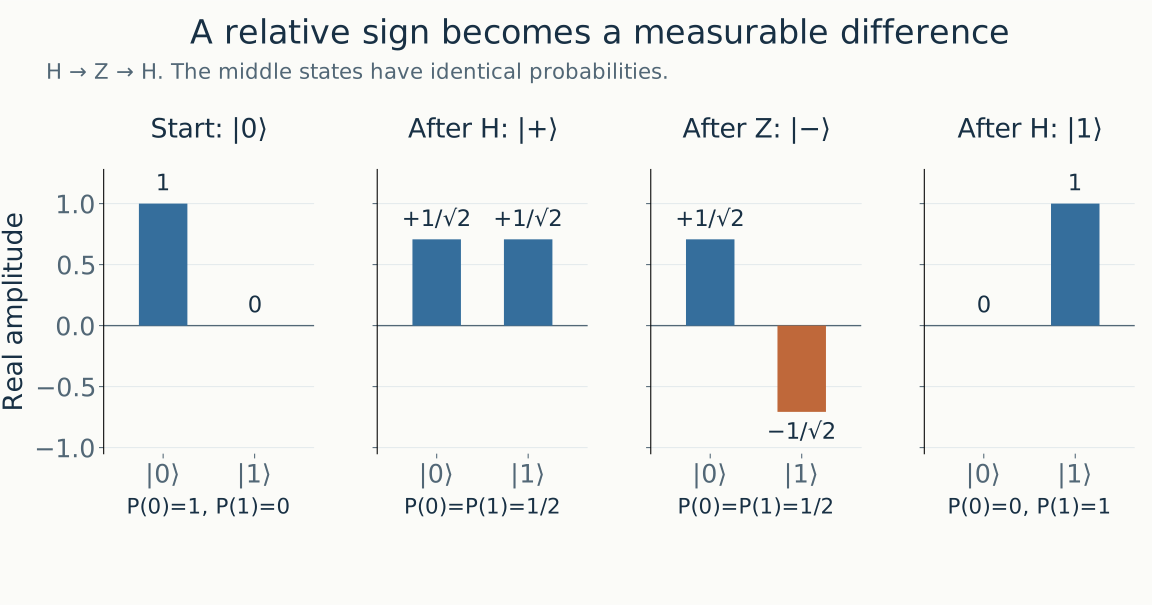
그림 1. 파란색은 양의 실수 amplitude, 주황색은 음의 실수 amplitude다. 첫 H 뒤와 Z 뒤의 측정 확률은 같지만, 마지막 H를 적용하면 결과가 달라진다. kickmix에서는 H를 단독 명령으로 허용하지 않는다.
직접 계산해도 같은 결과가 나온다. 마지막 H 뒤에서 |0⟩의 amplitude는 (1−1)/2=0으로 상쇄되고, |1⟩의 amplitude는 (1+1)/2=1로 더해진다. 따라서 이 회로의 측정 결과도 하나로 정해진다.
상태 전체에 똑같은 eⁱφ를 곱하는 경우는 다르다. 이때는 global phase만 바뀌고, 그 상태를 측정했을 때의 확률은 변하지 않는다. 대회에서 구현해야 하는 phase는 입력 x마다 다르다. superposition의 각 항에 서로 다른 phase를 곱하면 relative phase가 달라지고, 뒤따르는 계산 결과에도 영향을 준다. phase와 interference 예제를 함께 보면 이해하기 쉽다.
1.3 회로도에서는 gate를 왼쪽부터 적용한다
보통 회로도의 가로선 하나가 qubit 하나다. 왼쪽에서 오른쪽으로 읽으면서 gate를 차례로 적용한다. gate는 qubit 하나에만 작용할 수도 있고, 여러 qubit에 함께 작용할 수도 있다. 아래처럼 gate를 행렬로 적으면, 상태 벡터에 그 행렬을 곱해서 적용 후의 상태를 구할 수 있다.
\[X=\begin{pmatrix}0&1\\1&0\end{pmatrix},\quad Z=\begin{pmatrix}1&0\\0&-1\end{pmatrix},\quad H=\frac{1}{\sqrt{2}}\begin{pmatrix}1&1\\1&-1\end{pmatrix}.\]X는 0과 1을 바꾸고, Z는 |1⟩ 항의 amplitude에 −1을 곱한다. H를 적용하면 두 basis state의 amplitude가 섞인다. 회로도에서는 X와 Z가 모두 작은 상자로 보이지만 동작은 다르다. 특히 Z는 비트값을 건드리지 않고 phase만 바꾼다는 점을 기억해 두면 좋다.
| 연산 | computational basis에서 하는 일 | 이 대회에서 필요한 관점 |
|---|---|---|
| X | 0 ↔ 1 | 비트값을 바꾼다. |
| CX 또는 CNOT | b ← b XOR a | 입력을 보존하는 조건부 비트 연산이다. |
| CCX 또는 Toffoli | c ← c XOR (a AND b) | reversible AND와 산술의 기본 연산이다. |
| Z, CZ, CCZ | 조건이 맞는 항의 부호 반전 | 비트값이 같아도 phase는 바뀐다. |
| Z_POW(q,t) | q=1인 항에 exp(iπt)를 곱함 | 숫자를 phase로 바꾸는 데 쓴다. |
| H | 두 basis state의 amplitude를 섞음 | kickmix에서 단독 명령으로 사용할 수 없다. |
Z_POW에서 t의 단위는 반 바퀴다. 한 바퀴를 1로 세는 turns를 그대로 넣으면 2배 차이가 나므로, 뒤에서 phase를 계산할 때 단위를 맞춰야 한다.
2. 계산한 뒤 임시 공간까지 복원해야 한다
2.1 AND 결과만 남기고 입력을 지울 수는 없다
AND 결과가 0이면 원래 입력은 00, 01, 10 중 어느 것이었을까? 결과만으로는 구별할 수 없다. 서로 다른 입력이 같은 출력으로 합쳐졌기 때문이다. 측정이 없는 양자 gate는 원래 상태로 되돌릴 수 있는 reversible 연산이어야 하므로, AND 결과만 남기고 입력 정보를 버릴 수는 없다. 이 조건을 만족하는 양자 gate를 수학적으로는 unitary 행렬로 나타낸다.
이 문제를 해결하는 기본적인 방법은 입력을 보존하고, 별도의 target bit에 결과를 XOR하는 것이다.
\[U_f:\lvert x\rangle\lvert z\rangle\longmapsto\lvert x\rangle\lvert z\oplus f(x)\rangle.\]z가 0인 상태에서 시작하면 target에는 f(x)가 남는다. 같은 XOR을 한 번 더 적용하면 target도 원래 z로 돌아온다. 이때 f(a,b)=a AND b로 정한 연산이 CCX(a,b,c)다.
| a | b | 처음 c | CCX 뒤 c | CCX를 한 번 더 적용한 c |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 0 | 1 | 0 | 0 | 0 |
| 1 | 0 | 0 | 0 | 0 |
| 1 | 1 | 0 | 1 | 0 |
덧셈과 곱셈도 reversible 연산들을 조합해서 만든다. 고전 코드라면 a *= b로 이전 a를 덮어쓰면 되지만, 회로에서는 사라질 정보가 없는지 먼저 따져야 한다. carry, partial product, 비교 결과를 담을 임시 qubit을 마련하고, 계산이 끝난 뒤에는 그 qubit을 어떻게 복원할지도 정한다. 구체적인 구성은 reversible 고전 계산을 만드는 방법을 참고하면 된다.
2.2 scratch를 그대로 두면 원래 계산과 달라진다
계산에 보조로 쓰는 qubit을 ancilla, 임시 작업 공간을 scratch라고 부른다. 보통 계산을 마친 뒤에는 scratch를 다시 0으로 만들어야 한다. 메모리를 재사용하기 위해서만은 아니다. 중간값을 그대로 남겨 두면 계산 결과 자체가 달라질 수 있다.
첫 qubit을 |+⟩로 준비하고, CX로 computational basis의 비트값을 두 번째 보조 qubit에 복사해 보자.
결과는 독립적인 |+⟩ 두 개가 아니다. 따라서 임의의 양자 상태를 그대로 복제한 예는 아니다. 두 qubit 사이에 entanglement가 생겼고, 보조 qubit에도 첫 qubit의 비트값을 구별할 수 있는 정보가 남았다. 이제 보조 qubit을 무시한 채 첫 qubit에 H를 적용해 보자. 처음의 |+⟩에 적용했다면 0만 나왔겠지만, 여기서는 0과 1이 반반씩 나온다. scratch에 남겨 둔 정보 때문에 interference가 달라진 것이다.
입력 하나를 넣고 x가 보존됐는지만 확인해서는 이 문제를 찾을 수 없다. 그래서 검증기는 입력 복원, scratch 초기화, phase를 모두 검사한다. 파일 크기나 gate 수를 줄였더라도 이 검사를 통과하지 못하면 올바른 최적화로 인정할 수 없다.
2.3 compute → phase → uncompute
invsqrt처럼 f(x)에 따라 phase를 바꿔야 한다면, 먼저 f(x)를 계산하고 phase를 적용한 뒤 계산에 쓴 공간을 복원하면 된다.
실제 회로에서는 f(x)를 정해진 비트 수로 근사한다. 마지막의 uncomputation을 마치면 계산에 쓴 register는 원래 상태로 돌아가고, 입력별로 적용한 phase만 남는다. uncomputation을 하려면 gate의 순서를 뒤집는 동시에 각 gate의 역연산을 적용해야 한다. X·CX·CCX는 같은 연산을 다시 적용하면 되지만, 일반적인 회전은 각도의 부호도 바꿔야 한다.
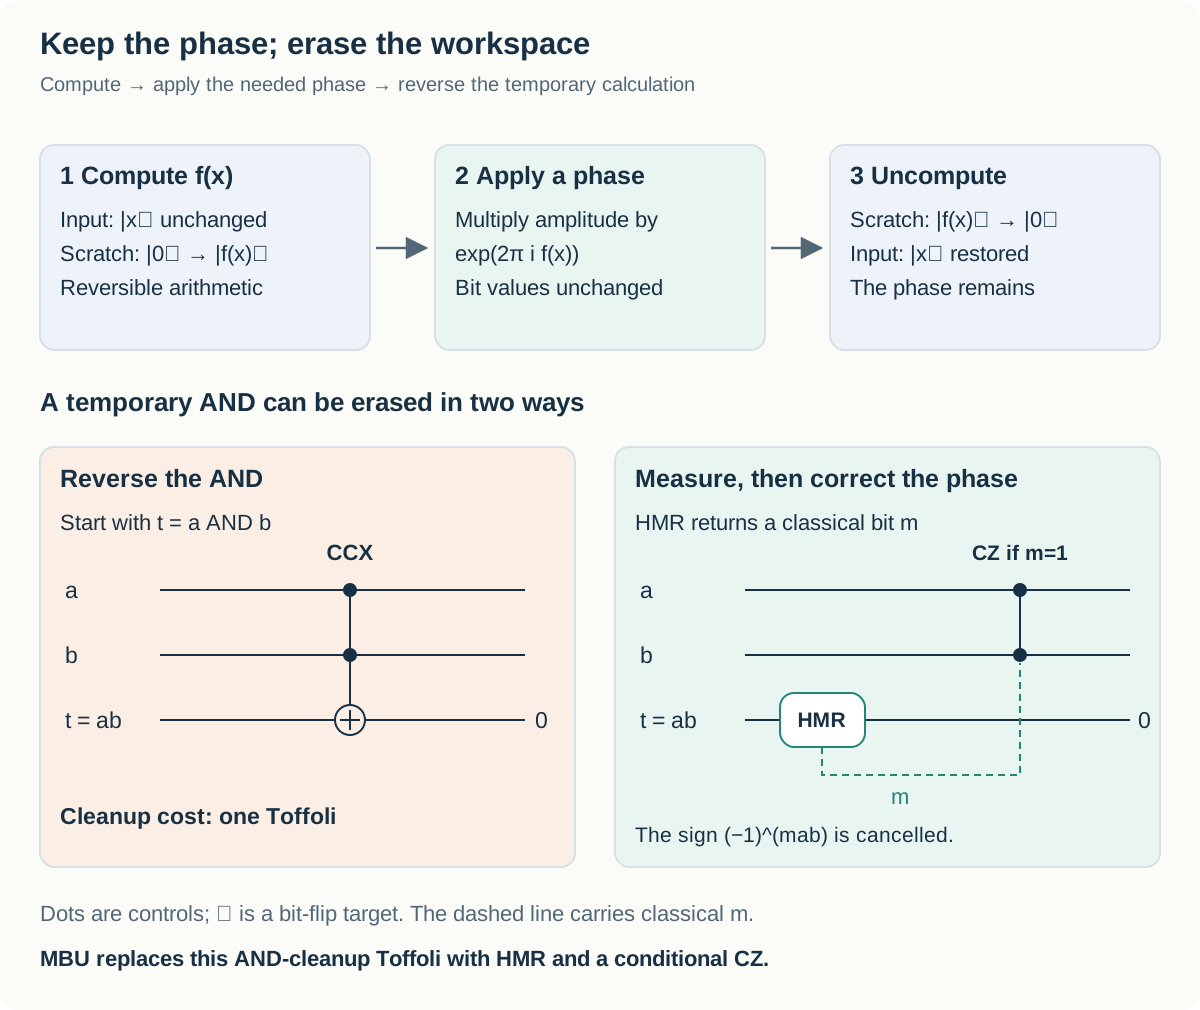
그림 2. 위쪽은 phase를 남기고 scratch를 비우는 일반적인 구조다. 아래쪽은 임시 AND 결과를 지우는 두 가지 방법이다. ●는 control, ⊕는 target bit 반전, 점선은 고전 측정 비트다. HMR을 쓰는 경로에는 측정 결과에 따른 phase 보정이 필요하다.
2.4 측정으로 uncomputation 비용을 줄이는 방법
임시로 계산한 t=a AND b를 CCX로 지우면 Toffoli가 하나 더 필요하다. 대신 t를 X basis에서 측정하고 0으로 돌려놓는 HMR을 쓸 수도 있다. 다만 이것만으로 끝나는 것은 아니다. 측정 결과 m에 따라 아래 부호가 붙는다.
m=0이면 그대로 두면 된다. m=1일 때는 CZ(a,b)를 적용한다. 그러면 $(-1)^{ab}$가 한 번 더 곱해져 측정으로 생긴 부호가 사라진다. 이 대회의 비용 모델에서는 조건부 CZ를 Toffoli로 세지 않으므로, CCX로 지울 때보다 비용을 아낄 수 있다. 이것이 measurement-based uncomputation(MBU)의 간단한 예다.
측정이나 보정을 생략하면 원하는 연산을 구현하지 못한다. 정보가 남아 있는 qubit에 R을 써서 강제로 0으로 지우는 방법도 쓸 수 없다. R은 이미 0으로 복원한 공간을 해제하는 명령이며, 정보를 남겨 둔 채 쓰면 시뮬레이터에서 무작위 phase가 생긴다. 각 명령의 정확한 동작은 kickmix 문서에서 확인할 수 있다.
어떤 값을 언제 지울 것인가? 어떤 중간값은 계산을 되돌리는 것보다 측정 후 보정하는 편이 싸지만, 보정에 오히려 많은 연산이 필요한 경우도 있다. 중간값을 오래 보관하면 qubit이 더 필요하고, 일찍 지웠다가 다시 계산하면 gate가 더 필요할 수 있다. reversible 회로를 최적화할 때는 이 선택을 회로 전체에 걸쳐 따져야 한다.
3. 같은 함수를 계산해도 회로 비용은 다르다
3.1 근사식부터 임시 공간까지 직접 정해야 한다
“1/√x를 계산하라”는 조건을 받았다고 바로 회로를 그릴 수 있는 것은 아니다. 소수점 아래 몇 비트까지 계산할 것인가? 어떤 근사식과 곱셈 회로를 쓸 것인가? 임시값은 언제 지울 것인가? 이런 선택에 따라 같은 함수를 계산하는 회로도 크기와 비용이 크게 달라진다.
| 구현 단계 | invsqrt를 예로 들면 | 정해야 할 것 |
|---|---|---|
| 필요한 기능 | 입력 x의 inverse square root에 비례하는 phase 적용 | 대회의 입출력 조건에 맞춘다. |
| 수치 알고리즘 | normalization·근사식·Newton 보정 | 근사 차수, 구간 수, 보정 횟수 |
| 정수 구현 | fixed-point 곱셈·덧셈·shift | 비트 정밀도, 하위 비트 생략, register 재사용 |
| reversible gate | CX·CCX·phase·MBU | 덧셈 회로, AND uncomputation, scratch 재사용 시점 |
| 실제 하드웨어 | logical gate를 물리 연산으로 구현 | 이 대회에서 직접 실행하거나 최적화하지는 않는다. |
그래서 이 대회의 compilation에는 소스 코드를 기계어로 옮기는 것보다 많은 설계가 포함된다. 수치 알고리즘도 바꿀 수 있고, 그 알고리즘을 구현하는 reversible 회로도 바꿀 수 있다. 어느 쪽이든 허용오차는 지켜야 한다. 또 회로 생성 프로그램이 빨라졌다고 해서 대회 점수가 좋아지는 것은 아니다. 평가하는 대상은 생성된 회로의 자원 비용이다.
3.2 qubit 수와 gate 비용을 함께 따져야 한다
비용식의 Q는 logical qubit 수다. 실제 장비에서 logical qubit 하나를 오류로부터 보호하려면 여러 physical qubit이 필요할 수 있다. 따라서 Q=260이라고 해서 물리 소자가 260개라는 뜻은 아니다. 실제 장비 규모를 계산하려면 물리적 오류율과 quantum error correction 방식도 알아야 한다.
gate도 종류에 따라 비용이 다르다. 이 대회에서는 Toffoli 같은 non-Clifford 연산을 비싸게 센다. invsqrt는 T gate 4개를 Toffoli 하나로 환산하고, 임의 각도 회전에는 필요한 정밀도에 따라 rotation synthesis 비용을 더한다. Clifford는 X·CX·Z·H 등이 속한 gate 집합이며, T와 Toffoli는 여기에 포함되지 않는다. T는 $\lvert 1\rangle$ 항에 $e^{i\pi/4}$를 곱하는 phase gate다. 비용식에서 Clifford를 무료로 센다는 것은 계산상의 약속이지, 실제 장비에서 실행 시간이 전혀 들지 않는다는 뜻은 아니다.
invsqrt의 비용은 logical qubit 수 Q와 gate 환산 비용 C를 곱한 값이다. Q나 C를 줄였더라도 다른 값이 늘었다면 전체 비용은 오히려 커질 수 있다.
예를 들어 qubit을 10% 줄이면서 gate 환산 비용이 5% 늘었다면 전체 비용은 0.9×1.05=0.945, 즉 5.5% 감소한다. 반대로 gate를 10% 줄이는 데 qubit이 20% 더 필요하다면 0.9×1.2=1.08로 오히려 비싸진다. 실제 후보를 비교할 때는 먼저 정확성 검증을 통과했는지 확인해야 한다.
4. 이렇게 큰 회로를 CPU로 검증할 수 있는 이유
4.1 모든 amplitude를 저장하지 않아도 된다
일반적인 n-qubit 상태를 그대로 저장하려면 amplitude가 최대 2ⁿ개 필요하다. 하지만 kickmix에서는 reversible Boolean gate, diagonal phase, MBU 등 정해진 연산만 허용한다. 이 연산들을 basis input 하나에 적용할 때는 비트열 하나와 phase, 측정 기록만 추적하면 된다. CX를 만나면 저장한 비트에 XOR를 적용하고, Z를 만나면 해당 비트값에 따라 phase factor에 −1을 곱하는 식이다.
앞서 쓴 H처럼 basis input 하나를 여러 basis state의 superposition으로 바꾸는 명령은 제출 회로에서 허용하지 않는다. HMR은 측정과 초기화 과정을 어떻게 추적할지까지 정해 둔 별도 명령이다. 이런 제한 덕분에 특정 subroutine을 CPU로 검증할 수 있다. 전체 양자 알고리즘까지 고전 컴퓨터로 손쉽게 계산할 수 있다는 뜻은 아니다.
그렇다면 basis input으로 확인한 동작을 superposition에도 적용할 수 있을까? 측정이 없고 scratch가 모두 0으로 돌아오는 phase 회로부터 생각해 보자. 모든 basis input에 대해 올바르게 동작한다면, 선형성에 따라 superposition에서도 다음 식이 성립한다.
\[\sum_x\alpha_x\lvert x\rangle\lvert 0\rangle \longmapsto \sum_x\alpha_x e^{2\pi i f(x)}\lvert x\rangle\lvert 0\rangle.\]실제 제출 회로에는 근사 오차가 있고, 측정 결과에 따른 분기도 생긴다. 이 경우를 다루는 방법은 동반 논문에 설명되어 있다. 논문은 입력별 가중치와 각 측정 분기의 구조에 관한 가정을 두고, 표본 검사에서 얻은 실패율을 양자 상태의 오차와 연결한다.
4.2 shot마다 무엇을 확인할까
입력을 준비해 회로를 한 번 시뮬레이션한 것을 shot이라고 한다. 검증기는 매 shot에서 다음을 검사한다.
| 검사 | 놓치면 생기는 문제 |
|---|---|
| 입출력 register가 요구 조건을 지키는가 | phase만 맞고 x나 syndrome은 바뀌어 있을 수 있다. |
| scratch가 0으로 돌아왔는가 | 중간값에 정보가 남아 interference가 달라질 수 있다. |
| 누적 phase가 허용오차 이내인가 | 비트값은 맞아도 필요한 phase가 틀릴 수 있다. |
세 과제의 검사 방법은 조금씩 다르다. invsqrt는 모든 x에 대해 64 shots씩 실행하지만, 가능한 측정 결과를 전부 열거하는 것은 아니다. DQI는 공식 분포에서 오류 패턴을 뽑아 검사한다. 화학 과제는 각 주소의 ANGLE 출력과 uncomputation 등을 확인하고, 제출한 수치 자료까지 이용해 전체 비용을 계산한다. 따라서 PASS를 읽을 때도 어느 과제에서 무엇을 검사했는지 함께 봐야 한다.
4.3 salt와 회로 해시가 검증 표본을 정한다
검증에 쓰는 난수열은 제출 내용의 SHA-256과 salt로 정한다. invsqrt에서는 canonical binary 회로의 해시를 쓰고, 화학 과제에서는 factorization과 tree 등의 자료도 반영한다. Kaggle의 Public과 Private은 각각 다른 비공개 salt를 쓴다. 공개된 검사 입력에만 맞춰 회로를 만드는 일을 어렵게 하기 위해서다. 구현은 공식 메트릭에서 확인할 수 있다.
같은 회로를 같은 salt로 다시 실행하면 똑같은 의사난수 표본을 검사한다. 여러 번 실행했다고 독립적인 검증을 추가한 것은 아니다. 반면 회로가 달라지면 해시도 바뀌므로, 같은 salt를 써도 난수열이 달라진다. 측정 결과에 따라 조건부 gate의 실행 횟수나 실패율이 달라지는 회로라면 비용도 영향을 받을 수 있다.
전체 로컬 검증은 정해진 회로·환경·salt로 공식 검사량을 완료한 결과다. Kaggle은 다른 실행 환경과 비공개 salt를 사용한다.
5. invsqrt: inverse square root를 계산하는 회로
5.1 핵융합 시뮬레이션에 inverse square root가 필요한 이유
빠른 하전 입자가 물질 속을 지나가면 주변 전자와 상호작용하면서 운동 에너지를 잃는다. 입자가 단위 거리를 이동할 때 잃는 에너지를 stopping power라고 한다. 핵융합 연료에서는 입자가 어느 지점에 얼마나 에너지를 전달하는지가 중요하다. 이를 계산하려면 뜨겁고 조밀한 물질 속 전자들의 운동을 시뮬레이션해야 한다. 이번 과제는 그 시뮬레이션에서 반복해서 호출하는 산술 회로를 최적화하는 문제다. 자세한 물리적 배경은 Rubin 등의 원 논문을 참고하면 된다.
두 전자의 위치가 $\mathbf r_i,\mathbf r_j$일 때 Coulomb interaction의 크기는 두 전자 사이 거리에 반비례한다. 단위와 물리 상수를 생략하고 쓰면 다음과 같다.
\[V_{ij}\propto \frac{1}{\lVert\mathbf r_i-\mathbf r_j\rVert} =\frac{1}{\sqrt{(x_i-x_j)^2+(y_i-y_j)^2+(z_i-z_j)^2}}.\]거리의 제곱을 정수 $x$로 표현하면 필요한 계산은 $1/\sqrt{x}$다. 시뮬레이션에서는 시간에 따른 변화를 작은 단계로 나누어 계산한다. 한 단계 동안 potential energy가 상태에 미치는 효과는 time evolution operator $e^{-iV\Delta t/\hbar}$로 나타낼 수 있다. 위치에 따라 potential energy가 다르므로 각 항의 phase도 다르게 바뀐다. 대회가 요구하는 회로에는 단위·부호·배율을 별도로 지정해 두었다.
전자 218개로 만들 수 있는 서로 다른 쌍은 $\binom{218}{2}=23{,}653$개다. 매 시간 단계마다 같은 연산을 수만 번 호출한다면, 호출 한 번에서 gate 몇 개만 줄여도 전체 계산량을 상당히 줄일 수 있다. inverse square root처럼 간단해 보이는 함수가 중요한 최적화 대상이 되는 이유다. 공식 Domain Context
5.2 값을 출력하는 대신 phase를 바꾼다
일반적인 프로그램에서는 return 1 / sqrt(x)로 근삿값을 반환하면 된다. 이 회로에서는 입력 숫자를 그대로 유지하면서, 해당 입력의 amplitude에 phase factor를 곱해야 한다. 계산에 쓴 보조 qubit은 마지막에 모두 0으로 되돌려 놓아야 한다.
|x⟩는 정수를 저장한 22개 qubit의 상태다. 입력에 여러 정수가 superposition으로 들어오면 정수마다 다른 phase를 적용한다. 가령 4와 16이 superposition으로 들어오면 phase를 각각 $1/2$바퀴와 $1/4$바퀴 바꾼다.
이 상태를 바로 측정해도 4와 16이 나올 확률은 여전히 같다. 달라진 것은 두 항 사이의 relative phase다. 다음 양자 연산에서 두 항이 interference를 일으키면 이 phase 차이가 측정 확률에 영향을 준다. 따라서 출력 비트만 맞아서는 부족하다. 입력 하나에서는 global phase로 보이는 변화도, 여러 입력이 superposition으로 들어오면 입력 사이의 relative phase를 결정한다.
baseline은 먼저 작업용 register에 근삿값을 계산하고, 그 비트들을 이용해 phase를 적용한다. 이후 계산을 거꾸로 수행해 register를 처음 상태로 복원한다. 회로가 길어도 큰 흐름은 compute → phase → uncompute다.
\[\lvert x\rangle\lvert 0\rangle \xrightarrow{\text{compute}} \lvert x\rangle\lvert \widetilde f(x)\rangle \xrightarrow{\text{phase}} e^{2\pi i\widetilde f(x)}\lvert x\rangle\lvert \widetilde f(x)\rangle \xrightarrow{\text{uncompute}} e^{2\pi i\widetilde f(x)}\lvert x\rangle\lvert 0\rangle.\]제출 회로가 만족해야 할 입출력 조건은 다음과 같다.
| 조건 | 공식 규격 |
|---|---|
| 입력 x | 1…3,133,452 |
| 입력 register | 서로 다른 22개 qubit으로 이루어진 little-endian x 하나; 다른 이름의 register는 허용하지 않음 |
| 목표 phase | β=1에서 1/√x turns; 한 바퀴를 주기로 비교 |
| 허용오차 | 2⁻²⁴/√x turns |
| 계산 종료 시 상태 | x를 원래 값으로 복원하고, 나머지 모든 qubit을 0으로 만듦 |
| 검사 횟수 | 모든 x에 64 shots, 합계 200,540,928; 한 번이라도 실패하면 탈락 |
5.3 fixed-point로 소수를 표현한다
reversible 회로에는 Python의 floating-point 함수를 그대로 가져다 쓸 수 없다. baseline은 소수점 위치를 미리 정하는 fixed-point 방식을 쓴다. 소수부에 $F$비트를 배정했다면 register에 저장한 정수 $Y$를 $Y/2^F$로 읽는다. 소수부가 4비트인 경우를 보자. 0011은 비트열 자체로는 정수 3이지만, fixed-point 값은 $3/16=0.1875$다.
비트 수를 늘리면 정밀도는 좋아지지만 곱셈에서 계산할 partial product와 보조 qubit도 늘어난다. baseline은 이를 줄이려고 중간값마다 필요한 비트 수를 따로 정한다. 최종 출력에 쓰이지 않을 하위 자리의 partial product는 아예 계산하지 않는 column-truncated multiplication도 사용한다. 계산 도중 하위 비트를 여러 번 잘라 내므로, 정확한 실수 곱셈을 마친 뒤 마지막에 한 번만 반올림한 결과와는 차이가 날 수 있다.
공식 회로 생성 코드의 Precision에서 각 단계의 비트 수를 확인할 수 있다. 최종 phase word까지 함께 정리하면 다음과 같다.
| 단계의 값 | 소수부 비트 수 | 하는 일 |
|---|---|---|
다항식에 넣는 delta | 14 | 구간의 왼쪽 끝에서 입력까지의 차이 |
| 계수와 Horner 중간값, 초기값 $y_0$ | 17 | 적은 비용으로 초기 근삿값을 구한다 |
| $y_0^2$ | 28 | Newton update에 쓸 제곱을 계산한다 |
| $My_0^2$, $3-My_0^2$ | 28, 정수부 2 추가 | Newton update의 곱셈 항을 계산한다 |
| 최종 곱 $p$ | 29, 정수부 1 추가 | 보정한 값을 저장한다 |
| phase에 사용할 $Y$ | 총 40 | normalization 배율과 마지막 $1/2$까지 반영한다 |
5.4 먼저 입력을 [1, 4) 범위로 normalize한다
유효한 입력은 $1\le x\le3{,}133{,}452$다. 이 범위를 그대로 계산하려면 결과가 아주 작은 경우까지 정밀도를 확보할 수 있도록 곱셈의 비트 폭을 크게 잡아야 한다. baseline은 normalization으로 이 부담을 줄인다. 입력의 맨 앞에서 00 쌍을 세어 $s$에 저장하고, 한 쌍당 두 비트씩 왼쪽으로 shift한다. 아래 식을 읽을 때는 register에 저장한 정수와 소수점 위치를 적용한 실수 값을 구분해야 한다.
$x=64$를 직접 계산해 보자. 22비트 표현에서 유효한 7비트 앞에는 0이 15개 붙는다. 00 쌍이 7개이므로 $s=7$이다. 왼쪽으로 14비트 shift하면 $x_{\rm norm}=64\times2^{14}=2^{20}$이고, 따라서 $M=1$이다. 마지막에 배율을 적용하면 $2^{7-10}/\sqrt1=1/8$이 된다. 실제 회로에서는 이 목표값에 fixed-point truncation 오차가 더해진다.
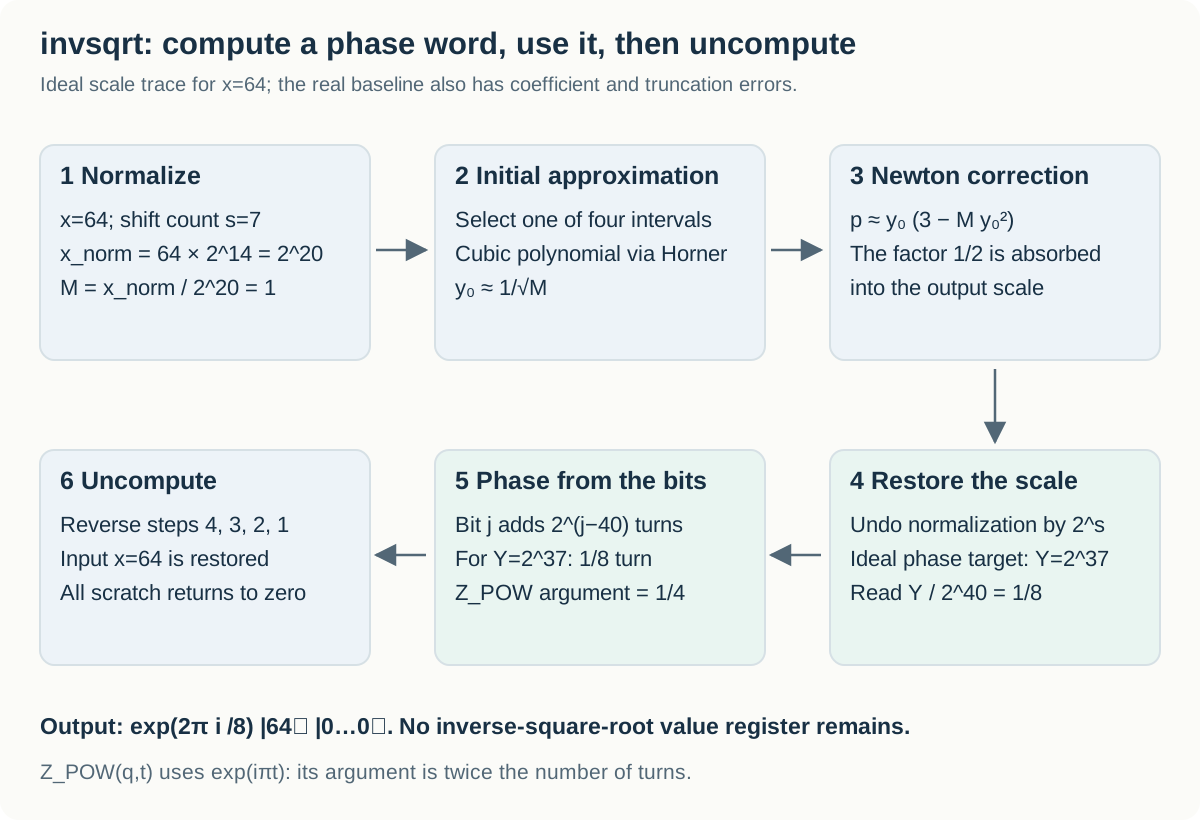
그림 3. x=64이면 s=7, M=1이고, 배율을 적용한 목표 phase는 1/8 turn이다. 이를 40비트 출력 word로 표현한 이상적인 값은 $2^{37}$이다.
$s$도 입력마다 달라지므로 회로 안에서 계산해 저장해야 한다. baseline은 여기에 10개의 flag qubit을 쓴다. 예를 들어 7을 이진수 0111로 저장하는 대신 flag 7개를 켜는 unary encoding을 사용한다. 각 flag는 이후 shift 한 번을 제어한다.
5.5 다항식으로 초기값을 구하고 Newton update를 적용한다
Normalization을 거친 입력 [1, 4)를 [1, 1.5), [1.5, 2), [2, 3), [3, 4)의 네 구간으로 나눈다. 상위 비트로 입력이 속한 구간을 확인하고, 해당 구간의 3차 다항식 계수를 작업용 register에 넣는다. 뒤의 두 구간에서는 앞의 구간에 쓴 계수를 $1/\sqrt2$ 관계에 맞춰 조정해 재사용한다.
구간의 왼쪽 끝이 $a\in{1,1.5,2,3}$이면 입력과의 차이는 $\delta=M-a$다. 다항식에는 이 차이를 넣는다. 실제 회로에서는 δ의 소수부를 14비트까지만 사용한다.
다항식 $c_0-c_1\delta+c_2\delta^2-c_3\delta^3$는 아래처럼 괄호를 묶어 계산한다. Horner’s method를 사용하면 $\delta^2$, $\delta^3$를 별도로 구하지 않고 곱셈 세 번으로 계산할 수 있다.
\[y_0=c_0-\delta\bigl(c_1-\delta(c_2-c_3\delta)\bigr) \approx\frac1{\sqrt M}.\]이 단계에서 최종 정밀도까지 맞출 필요는 없다. 먼저 구한 근삿값에 Newton update를 한 번 적용하면 오차가 크게 줄어든다.
\[y_{\rm next}=\frac{y_0}{2}(3-My_0^2).\]한 번의 update로 오차가 얼마나 줄어드는지 계산해 보자. Truncation과 반올림이 없는 이상적인 연산을 가정하고 $y_0=(1+e_0)/\sqrt M$를 대입하면 update 후 상대오차는 다음과 같다.
\[e_1=-\frac32e_0^2-\frac12e_0^3.\]처음 상대오차가 $10^{-4}$이면 update 후에는 약 $1.5\times10^{-8}$로 작아진다. 초기 오차가 충분히 작을 때는 그 제곱에 비례해 줄어드는 셈이다. 다만 이 식은 fixed-point truncation을 반영하지 않는다. 실제 회로의 오차를 평가할 때는 다항식 근사 오차에 더해, 계수를 유한한 비트 수로 저장하면서 생기는 오차와 곱셈 도중 하위 비트를 잘라 내면서 생기는 오차까지 합산해야 한다.
공식 코드를 읽을 때는 배율을 처리하는 위치에 주의하자. 생성기는 위 식의 $1/2$를 직접 곱하지 않고 $p\approx y_0(3-My_0^2)\approx2/\sqrt M$를 계산한다. 소수부 29비트로 표현한 정수 p를 $s$만큼 shift한 값이 $Y$이며, 이를 $2^{40}$으로 나누어 해석한다. 즉 $1/2$는 출력의 소수점 위치에 반영한다. $x=64$, $M=1$에서 실수 연산의 이상적인 목표를 $p_=2$라 쓰면, 출력 목표는 $Y_=2^{29}p_2^7=2^{37}$이고 $Y_/2^{40}=1/8$이다. 실제 p register는 소수부 29비트에 정수부 1비트를 더한 총 30비트이므로 2 미만의 값만 표현한다. 위 손계산에서 나온 경계값 2를 그대로 저장할 수 있는 것은 아니다. 실제로 계산한 근삿값이 허용오차 안에 들어오는지 확인해야 한다.
5.6 비트별로 phase를 적용하고 작업용 register를 복원한다
$Y=\sum_{j=0}^{39}b_j2^j$라면 목표 phase는 $Y/2^{40}=\sum_jb_j2^{j-40}$바퀴다. $b_j=1$인 비트마다 $2^{j-40}$바퀴의 phase를 적용하면 전체 합이 목표 phase가 된다. 이처럼 큰 phase 연산을 작은 비트별 연산으로 나누어 구현한다. 다만 Z_POW의 인자는 반 바퀴 단위여서, 코드에는 $2^{j-39}$를 넣는다. Z_POW q t는 $\lvert 1\rangle$ 성분에 $e^{i\pi t}$를 곱하는 연산이다. 일반적으로 $2^{j-F}$바퀴를 적용하려면 $t=2^{j-F+1}$로 지정해야 한다. Turn과 Z_POW 인자의 단위를 혼동하면 각도가 두 배 어긋난다.
Phase를 적용한 다음에는 shift부터 Newton 계산, 다항식, 구간 선택, 입력 normalization까지 거꾸로 수행한다. 그러면 $x$는 원래 정수로 복원되고 $Y$와 나머지 scratch는 모두 0이 된다. 적용한 phase만 유지된다. 중간값을 버려서는 이 uncomputation을 대신할 수 없다.
5.7 baseline은 어느 단계에서 gate를 많이 쓸까
공식 배포 파일 invsqrt.kmb에서 정적으로 집계한 단계별 Toffoli count는 다음과 같다.
| 단계 | Compute | Uncompute | 주요 내용 |
|---|---|---|---|
| Normalization | 120 | 110 | 앞에 붙은 0 판정과 controlled shift |
| 구간 선택 | 3 | 0 | 선택 flag를 지울 때 MBU 사용 |
| Horner 곱셈 3회 | 1,071 | 1,071 | 초기 근삿값 계산 |
| $y_0^2$ | 442 | 442 | 대칭을 이용한 제곱 |
| $M y_0^2$ | 1,043 | 1,043 | Toffoli를 많이 쓰는 곱셈 |
| $3-z$ | 28 | 28 | 보정항을 만드는 뺄셈 |
| $y_0(3-z)$ | 867 | 867 | 마지막 보정 곱셈 |
| Denormalization | 300 | 300 | 배율을 적용하는 controlled shift |
| 합계 | 3,874 | 3,861 | 총 7,735 |
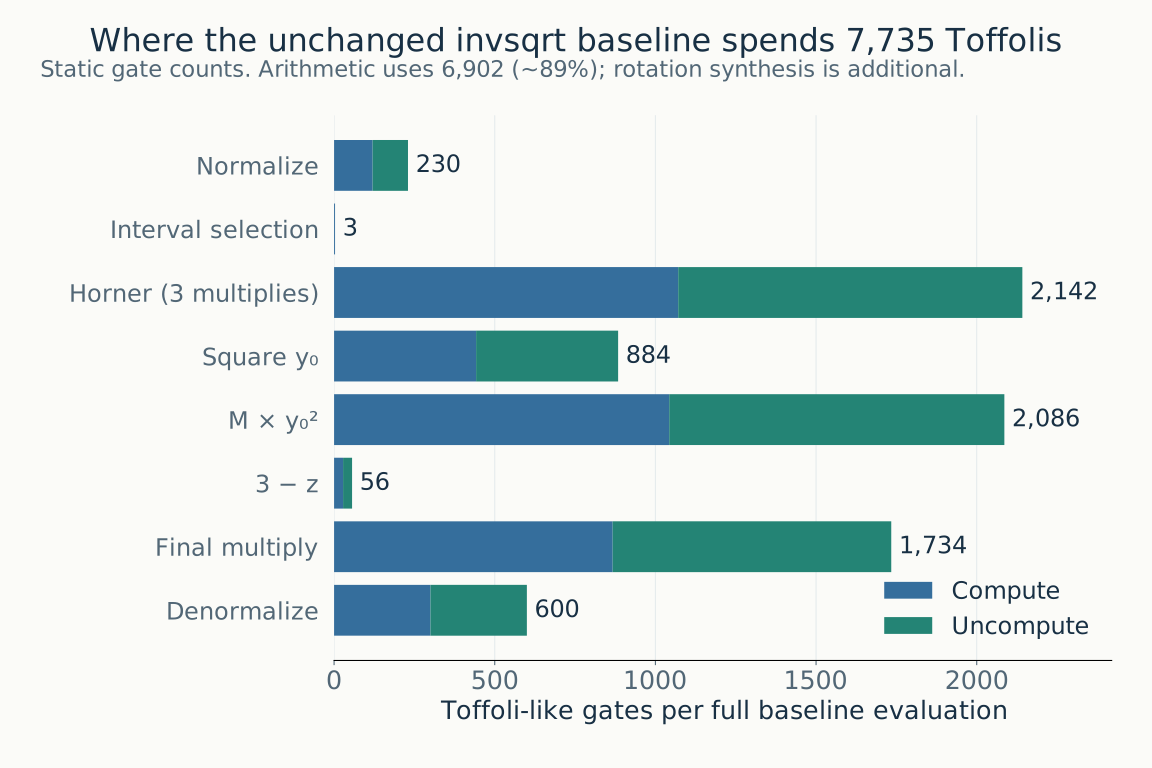
그림 4. baseline의 Toffoli 계열 gate는 총 7,735개다. 원본 회로를 정적으로 분석한 결과이며, 최종 비용에는 rotation synthesis 비용도 추가된다.
곱셈·제곱·뺄셈에 compute와 uncompute를 합쳐 6,902개, 전체의 약 89%가 들어간다. 따라서 Python 코드를 짧게 만드는 것보다 산술 구조와 정밀도를 바꾸는 쪽이 회로 비용에 직접적인 영향을 준다. 여기에 phase rotation의 synthesis 비용이 추가된다. 기존 로컬 결과에서 이 비용은 Toffoli 약 253개에 해당했다.
Uncompute가 절반 가까이를 차지한다고 해서 측정으로 그 비용을 전부 없앨 수 있는 것은 아니다. 임시 AND를 지우는 del_and에는 이미 measurement-based uncomputation을 사용한다. _add_row는 compute와 uncompute 양쪽에서 partial product의 AND를 만들고, 덧셈 또는 뺄셈을 한 뒤 해당 AND를 측정해 지운다. carry와 이전 accumulator 값까지 복원해야 하는 계산 전체에 임시 AND 하나의 처리 방식을 그대로 적용할 수는 없다.
5.8 비트 수를 줄인다고 최종 비용도 줄어들까
모든 유효한 $x$에서 phase 오차는 $2^{-24}/\sqrt{x}$바퀴 이하여야 한다. 입력이 커지면 목표 phase와 허용 절대오차가 함께 작아진다. 작은 입력 몇 개만 맞춰서는 충분하지 않다. 공식 verifier는 모든 입력에 대해 64번씩, 총 200,540,928번 실행하면서 입력 복원, scratch 0, phase를 검사한다.
작은 각도의 phase gate를 fault-tolerant gate로 구현할 때는 rotation synthesis가 필요하다. 이 과정에도 비용과 오차가 발생한다. verifier는 산술 오차를 먼저 계산하고, 전체 허용오차에서 남은 최소 여유만큼을 synthesis에 배정한다. 비트 하나를 줄여 Toffoli count를 낮췄더라도, 산술 오차가 커지면 synthesis에는 더 높은 정밀도가 필요해 비용이 늘 수 있다. 산술 계산에서 허용오차를 모두 사용하면 phase 검사 자체를 통과해도 synthesis에 배정할 여유가 없어 거부된다. 결국 비교해야 할 것은 검증을 통과한 회로의 최종 비용이다.
5.9 어디부터 개선할 수 있을까
| 접근 | 무엇이 달라지나 | 먼저 확인할 것 |
|---|---|---|
| 작업용 qubit 재사용 | 동시에 필요하지 않은 값을 같은 logical wire에 저장 | 이전 값이 0으로 돌아오는 시점과 입력 보존 여부 |
| 중간 정밀도 조정 | 필요 없는 하위 partial product와 carry를 생략 | 구간 경계와 큰 $x$에서의 가장 큰 오차, rotation synthesis에 남는 여유 |
| 초기 근사 재설계 | 구간 수·다항식 차수·lookup 크기를 조정 | 초기값 계산에서 아낀 비용보다 Newton 계산의 비트 폭 증가로 드는 비용이 크지 않은가 |
| Shift 구조 변경 | unary flag로 제어하는 shift를 다른 구조로 구현 | 제어 비트 계산과 uncompute 비용까지 포함해도 이득인가 |
| 산술 구현 변경 | 곱셈·제곱·덧셈의 reversible 구현을 변경 | carry, overflow, signed/unsigned, truncation 규칙의 일치 여부 |
처음에는 정밀도·다항식·wire 배치 중 한 가지만 바꾸고, 원본과 같은 조건으로 검증하는 편이 좋다. 여러 요소를 동시에 바꾸면 비용이 줄어든 이유나 검증에 실패한 원인을 알아내기 어렵다.
공식 코드는 nr_reference_circuit.py의 Precision → _compute_y1 → _phase_by_bits → build_nr_circuit 순서로 읽어 보자. _compute_y1에서 호출하는 _normalize, _horner, _square, _multiply_m, _correct, _multiply_y0, _denormalize가 각 산술 단계를 구현한다. fixed_point_model은 이와 별도로 작성된 수치 모델이므로, 모델에서 계산한 오차와 실제 생성 회로의 검증 결과를 구분해야 한다.
6. DQI: 조합 최적화에 Reed–Solomon decoder를 쓰는 이유
DQI의 목표는 조건을 많이 만족하는 다항식을 찾는 조합 최적화다. 이때 superposition을 유지하면서 오류 정보를 저장한 register를 정리하는 quantum subroutine이 필요하다. 이 subroutine을 Reed–Solomon decoder로 구현한다.
6.1 먼저 어떤 다항식을 찾으려는지 보자
곡선을 데이터에 맞출 때는 보통 관측점 가까이를 지나는 실수 다항식을 찾는다. Optimal Polynomial Intersection(OPI)의 조건은 다르다. finite field의 각 평가점에 허용하는 값의 집합이 정해져 있다. 계수 벡터 $x$로 다항식 $p_x$를 만들었을 때, 그 값이 허용 집합에 속하는 평가점의 수를 최대화하는 문제다.
\[p_x(z)=\sum_{k=0}^{n-1}x_kz^k, \qquad f(x)=\left|\{j:p_x(\alpha_j)\in F_j\}\right|.\]$F_j$는 평가점 $\alpha_j$에서 허용하는 값들의 집합이다. 후보 다항식이 주어지면 모든 평가점에서 $f(x)$를 계산해 점수를 매길 수 있다. 어려운 것은 높은 점수를 받는 후보를 찾는 일이다. DQI는 그런 후보의 측정 확률을 높이는 양자 알고리즘이다. 자세한 내용은 OPI와 DQI 원 논문을 참고하면 된다.
DQI가 준비하려는 상태는 개념적으로 다음과 같다.
\[\lvert \psi\rangle\propto\sum_x P(f(x))\lvert x\rangle, \qquad \Pr[x]\propto|P(f(x))|^2.\]다항식 $P$를 적절히 고르면 점수가 높은 후보에 더 큰 amplitude를 줄 수 있다. DQI는 이 상태를 만들기 위해 Fourier transform을 사용하고, 그 과정에서 sparse error pattern과 syndrome을 계산한다. syndrome은 오류 벡터를 선형 연산으로 짧게 요약한 값이다.
6.2 decoder로 오류 register를 비운다
syndrome을 계산하는 선형변환을 $B^T$라 쓰면 핵심 과정은 다음과 같다.
\[\sum_e a_e\lvert e\rangle\lvert B^Te\rangle \ \longrightarrow\ \lvert 0\rangle\sum_e a_e\lvert B^Te\rangle.\]왼쪽 상태에서는 오류 패턴 $e$와 syndrome $B^Te$가 entangled 상태다. 이후 syndrome에 Fourier transform을 적용해 원하는 interference를 얻으려면, 오른쪽처럼 오류 register를 먼저 0으로 되돌려야 한다. 오류 패턴을 측정하면 superposition이 바뀌므로, 측정 없이 syndrome으로부터 오류를 reversible하게 복원한다. 이를 원래 오류 register에 XOR하면 $\lvert e\oplus e\rangle=\lvert 0\rangle$가 된다. 이때 syndrome에서 오류를 복원하는 연산을 error-correcting decoder가 맡는다.
오류 개수가 제한되어 있으면 syndrome에서 원래 오류를 유일하게 복원할 수 있다. 대회에서 쓰는 Reed–Solomon code는 길이 4,095, 차원 4,025, 최소거리 71이며, 최대 35개의 symbol error를 복원한다. 여기서 35는 bit error 개수가 아니다. symbol 하나를 12비트로 표현하며, 오류값이 0이 아닌 위치가 최대 35개라는 뜻이다.
실제 DQI 구성에서는 qubit을 줄이려고 오류 symbol을 하나씩 계산한 뒤 X basis에서 측정하는 measurement-based uncomputation(MBU)을 사용한다. workspace는 줄어들지만, 측정 결과에 따라 superposition의 각 항에 부호가 생긴다. decoder는 syndrome에서 오류 패턴을 복원해 이 부호를 상쇄하는 데 쓰인다. 자세한 구성은 Reversible decoder와 MBU 논문에 설명되어 있다.
따라서 제출 회로는 측정 결과에 맞는 phase correction을 적용해야 한다.
6.3 GF(2¹²)의 12비트 표현은 정수와 다르게 계산한다
공식 회로의 finite field는 원소가 4,096개인 $\mathrm{GF}(2^{12})$다. 각 원소를 12비트로 저장하지만, 곱셈은 정수 곱을 4,096으로 나눈 나머지가 아니다.
비트열 $(a_0,\ldots,a_{11})$을 다항식 $a_0+a_1u+\cdots+a_{11}u^{11}$로 해석한다. 덧셈은 계수를 mod 2로 더하므로 비트별 XOR가 된다. 곱셈은 두 다항식을 곱하고, 지정된 irreducible polynomial로 나눈 나머지를 구한다. 공식 비트 순서는 little-endian이고, 나눗셈에 사용하는 polynomial은 다음과 같다.
\[u^{12}+u^6+u^4+u+1.\]| 연산 | 비트 수준에서 하는 일 | 회로 구현 |
|---|---|---|
| 두 field 원소의 덧셈 | 비트별 XOR | CNOT으로 구현 가능 |
| 고정된 field 상수와의 곱셈 | GF(2) 위의 선형변환 | CNOT network로 구현 가능 |
| qubit으로 표현한 두 field 원소의 곱셈 | 두 입력값 모두에 의존하는 bilinear 연산 | Toffoli 필요 |
| 0이 아닌 원소의 inverse | $a^{-1}$ 계산 | 여러 번의 곱셈과 workspace 필요 |
곱셈의 한쪽 값을 compile 시점에 알고 있다면 더 단순한 회로를 쓸 수 있다. 반대로 두 입력을 모두 qubit으로 받아 계산하면 Toffoli가 필요하다. 같은 field 곱셈도 회로에 따라 비용이 달라지므로 CPU에서 빠른 decoder가 여기서도 가장 저렴하리라고 가정해서는 안 된다.
6.4 입력은 오류 벡터가 아니라 syndrome이다
오류 벡터를 $e=(e_0,\ldots,e_{4094})$, field의 primitive element를 $\alpha$라고 하자. verifier는 오류 벡터로부터 아래의 syndrome 70개를 계산해 회로에 넣는다.
\[S_i=\sum_{j=0}^{4094}e_j\alpha^{(i+1)j}, \qquad i=0,\ldots,69.\]합산은 field 덧셈, 즉 비트별 XOR다. $S_0,\ldots,S_{69}$에 각각 12개의 qubit을 쓰므로 입력에만 총 840개의 qubit이 필요하다. 오류 위치마다 측정 mask $M_j$도 12개의 classical bit로 주어진다. 공식 register 이름 E0…E4094가 저장하는 값은 이 mask다. 이름에 E가 들어가지만 실제 오류 $e_j$를 입력하는 것은 아니다.
회로는 이 입력에 다음 phase를 적용해야 한다.
\[U_M\lvert S(e)\rangle\lvert 0\rangle_W =(-1)^{b(e,M)}\lvert S(e)\rangle\lvert 0\rangle_W, \quad b(e,M)=\left(\sum_j\operatorname{popcount}(e_j\mathbin{\&}M_j)\right)\bmod2.\]&는 비트 AND, popcount는 1인 비트의 개수다. 식에서는 field 곱셈을 하지 않는다. mask로 오류 비트들을 선택한 다음 그 parity를 구한다. 켜진 비트가 홀수 개면 −1, 짝수 개면 +1을 곱한다. 종료 시 syndrome은 원래 값이어야 하고 추가 qubit은 모두 0이어야 한다. 오류 벡터를 출력으로 보관할 필요는 없으므로, 필요한 phase를 적용한 뒤 중간값을 정리하는 방식으로 설계할 수 있다.
basis 입력 하나에서는 전체 부호만 바꾸는 것처럼 보인다. 그러나 부호가 $e$마다 다르기 때문에 superposition에서는 입력 사이의 relative phase를 바꾼다. 이 차이가 Fourier transform 이후 측정 확률에 영향을 준다.
S0…S69는 각각 서로 겹치지 않는 qubit 12개, E0…E4094는 각각 classical bit 12개로 구성해야 한다. 다른 이름의 register를 추가하거나 Z_POW를 사용할 수는 없다. 세부 조건은 공식 배포본의 verifiers/dqi/verify_submission_dqi.py에서 확인할 수 있다.
6.5 작은 GF(4) 예제로 phase까지 계산해 보자
RS(3,1)의 1-symbol error를 GF(4)에서 복원해 보자. field 원소는 ${0,1,\alpha,\alpha+1}$이고, $\alpha^2=\alpha+1$이다.
| 원소 | 다항식 | 비트 표현(상위→하위) |
|---|---|---|
| 0 | 0 | 00 |
| 1 | 1 | 01 |
| $\alpha$ | $u$ | 10 |
| $\alpha^2$ | $u+1$ | 11 |
이 field에서는 $\alpha^3=1$이고 $\alpha+\alpha=0$이다. 위치 1에 오류값 $\alpha^2$가 하나 있다고 하자.
\[e=(0,\alpha^2,0),\qquad S_0=\alpha^2\alpha=1,\qquad S_1=\alpha^2\alpha^2=\alpha.\]입력은 $e$가 아니라 $(S_0,S_1)=(1,\alpha)$다. 오류가 하나이므로 $S_1/S_0=\alpha^j$를 계산하면 위치 $j=1$을 알 수 있다. 이어서 $e_1=S_0/\alpha=\alpha^2$로 오류값을 구한다. 오류가 여러 개면 이 비율만으로 복원할 수 없고, 다음 절의 다항식 알고리즘이 필요하다.
이제 mask를 $M_1=\alpha$, 즉 10으로 정해 보자.
따라서 회로가 해야 할 연산은 $\lvert 1,\alpha\rangle\lvert 0\rangle_W\mapsto-\lvert 1,\alpha\rangle\lvert 0\rangle_W$다. mask가 $M_1=\texttt{11}$이면 선택된 비트의 parity가 짝수여서 부호가 +1이 된다. phase를 계산하려면 오류 위치뿐 아니라 오류값의 비트까지 알아야 한다.
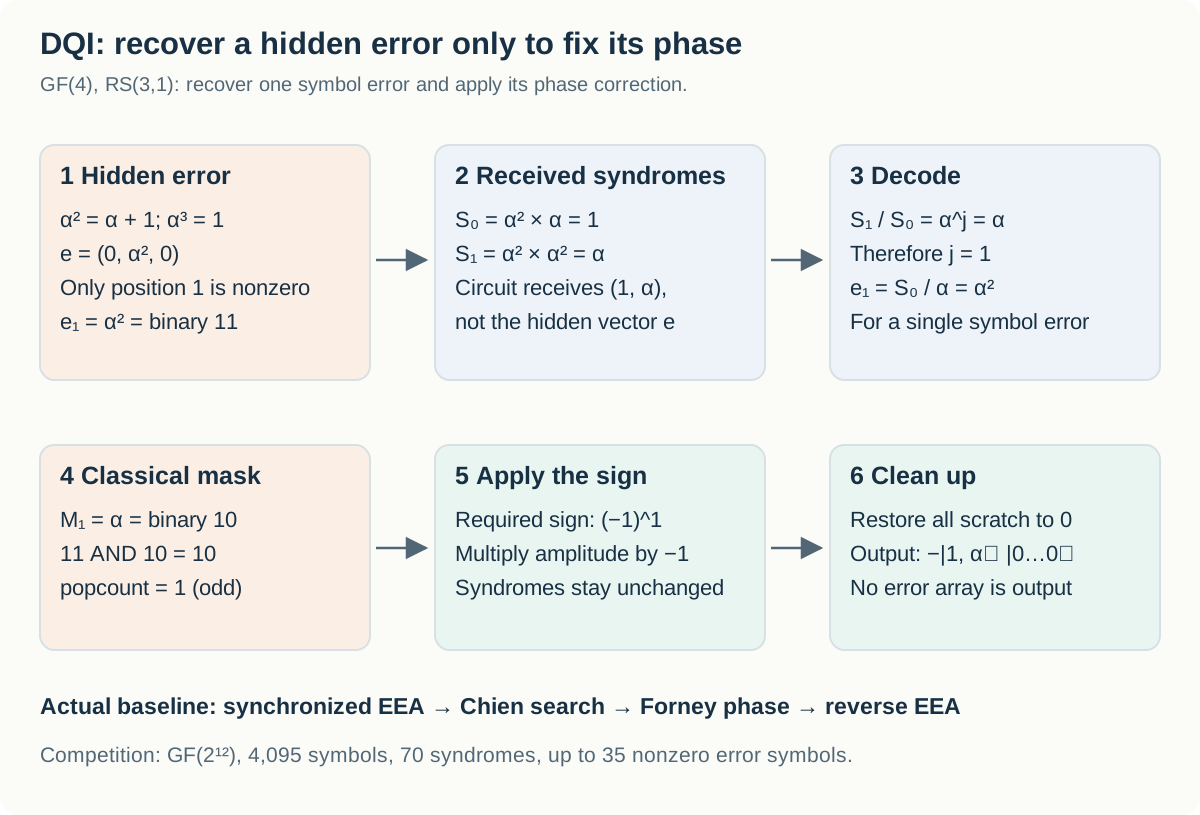
그림 5. 작은 GF(4) 예제에서 syndrome (1,α)로 위치 1과 오류값 α²를 복원한다. mask가 선택한 비트의 parity를 구하면 적용할 −1 phase가 정해진다.
6.6 baseline은 EEA → Chien → Forney 순서로 계산한다
오류가 여러 개라면 syndrome을 다음 다항식으로 표현한다.
\[S(z)=S_0+S_1z+\cdots+S_{69}z^{69}.\]오류 위치의 집합을 $J$라고 하자. Error locator polynomial $\sigma$와 error evaluator polynomial $\Omega$를 구하면 다음 관계를 만족한다.
\[\sigma(z)=\prod_{j\in J}(1-\alpha^jz), \qquad \sigma(z)S(z)\equiv\Omega(z)\pmod{z^{70}}.\]characteristic 2인 field에서는 −와 +가 같은 연산이다. $\sigma$의 root에서 오류 위치를 찾고, $\Omega$로 각 위치의 오류값을 계산한다. 식의 합동 관계는 다항식을 곱한 뒤 $z^{70}$ 이상의 항을 제외한다는 뜻이다.
| 단계 | 계산할 것 | 공식 회로 생성기의 동작 |
|---|---|---|
| Key equation 풀기 | $\sigma,\Omega$ | Proos–Zalka 방식으로 동기화한 extended Euclidean algorithm(EEA), 기본 222단계 |
| Chien search | 오류가 있는 위치 | 모든 4,095개 위치에서 $\sigma(\alpha^{-j})=0$인지 평가 |
| Forney 계산과 phase 적용 | 오류값과 mask가 정하는 부호 | $\Omega$, $\sigma’$의 inverse, mask로 phase를 적용한 뒤 임시값 정리 |
| Uncomputation | workspace 복원 | EEA와 초기 정렬을 거꾸로 실행해 원래 syndrome과 0으로 초기화된 workspace 복원 |
다항식의 normalization을 한 가지 관례로 정하면 오류값은 $e_j=\Omega(\alpha^{-j})/\sigma’(\alpha^{-j})$로 쓸 수 있다. 공식 구현은 EEA 배열의 표현에 맞춘 지수 보정을 각 위치의 상수 곱에 포함한다. 이 공식을 코드로 옮길 때는 syndrome 지수의 시작점과 다항식 계수의 저장 순서까지 맞춰야 한다. 앞의 GF(4) 예제에서는 $\sigma(z)=1+\alpha z$, $\Omega(z)=1$, $\sigma’(z)=\alpha$이며, root $z=\alpha^2$에서 $1/\alpha=\alpha^2$를 얻는다.
공식 생성기의 forney_step은 각 위치에서 inverse 계산용 workspace를 할당한다. 오류 위치를 나타내는 조건과 $\Omega$를 사용해 gf2_phase_by_product(..., mask=...)를 호출하고 phase를 적용한다. 오류값 4,095개를 모두 저장해 끝까지 유지하지는 않는다. 오류값을 출력으로 남기지 않고 phase에 바로 반영하는 방식은 baseline에서도 이미 사용한다. 이를 개선하려면 추가로 생략할 계산이나 재사용할 공간을 찾아야 한다.
6.7 CPU용 decoder를 회로로 옮길 때 달라지는 점
CPU용 decoder는 배열을 덮어쓰거나 이전 나머지를 버릴 수 있고, 입력값에 따라 반복문을 일찍 끝낼 수도 있다. 양자 회로에서는 서로 다른 syndrome이 superposition으로 들어올 수 있어 이런 동작을 그대로 옮기기 어렵다. 이전 값을 복원할 정보가 필요하고, 분기 조건을 계산하는 회로와 곱셈의 중간값을 uncompute하는 회로도 만들어야 한다. 계산 경로에 따라 남은 중간값이 입력과 entangled 상태가 되지 않도록 정리해야 한다.
알고리즘을 비교할 때도 CPU 실행시간만 봐서는 안 된다. 이 대회에서 중요한 값은 uncomputation까지 포함한 Toffoli count, qubit 수, 공식 입력 분포에서의 실패율이다. workspace를 줄이려고 중간값을 재계산하면 gate 수는 늘어난다. 하지만 비용에 $Q^2$가 들어가므로 그만큼 qubit을 줄였다면 전체 비용은 낮아질 수 있다.
공식 문헌의 baseline 자원 추정치는 qubit 1,893개, Toffoli 5,725,461개다.
6.8 실패율까지 포함해 비용을 비교한다
공식 verifier는 102,400 shots를 실행한다. 각 shot에서 오류 개수 $w\in{0,\ldots,35}$를 정하고, 서로 다른 오류 위치와 0이 아닌 오류값, 측정 mask를 뽑는다. 오류 개수의 분포는 균등하지 않다. DQI 상태에 맞춰 36×36 tridiagonal matrix의 최대 eigenvalue에 해당하는 normalized eigenvector $v$를 계산하고, $\Pr[w]=v_w^2$로 뽑는다.
\[A_{w,w}=\frac{w(q-2r)}{\sqrt{r(q-r)}},\qquad A_{w-1,w}=A_{w,w-1}=\sqrt{w(m-w+1)}, \quad(q,m,r)=(4096,4095,2016).\]오류 개수 $w$를 정한 뒤에는 그 조건 안에서 오류 위치와 0이 아닌 값을 균등하게 선택한다. $w$의 기대값은 약 31.05다. 따라서 오류가 적은 입력에서만 decoder를 시험해 보고 공식 분포에서도 잘 동작할 것으로 판단해서는 안 된다.
syndrome이 달라졌거나 workspace에 계산값이 남으면 값 검사 실패다. 값은 맞지만 부호가 다르면 phase 검사 실패로 센다. 둘을 중복 집계하지는 않는다. 실패 횟수의 합을 $k$, 전체 shot 수를 $N$이라 할 때 비용식에는 관측 비율 $k/N$ 대신 one-sided Clopper–Pearson upper bound $\epsilon_+$를 사용한다.
\[\mathrm{cost}_{\mathrm{DQI}}=R(\epsilon_+)Q^2T, \qquad R(\epsilon)=\frac{\ln2}{-\ln(\tfrac12+2\sqrt\epsilon)}.\]신뢰수준은 $1-2^{-128}$이며, 통과 조건은 $\epsilon_+<1/16$이다. $T$는 uncomputation을 포함해 각 shot에서 실제로 실행한 Toffoli 계열 gate 수의 평균이다. $Q$에는 입력용 qubit 840개와 workspace가 들어간다. 조건부로 실행되는 gate가 있으므로 소스에 작성한 전체 gate 수와 shot별 실행 수의 평균이 같다고 가정해서는 안 된다.
한 번도 실패하지 않아도 $\epsilon_+=1-(2^{-128})^{1/102400}\approx0.00086606$, $R\approx1.19126$이다. 유한한 표본에서 실패가 없었다고 실제 실패 확률을 0으로 확정할 수는 없기 때문이다.
| 가정한 변화 | 비용비 | 해석 |
|---|---|---|
| qubit 10% 감소, Toffoli 동일 | $0.9^2=0.81$ | 비용 19% 감소 |
| qubit 10% 감소, Toffoli 20% 증가 | $0.9^2\times1.2=0.972$ | 비용 2.8% 감소 |
| qubit 10% 감소, Toffoli 30% 증가 | $0.9^2\times1.3=1.053$ | 비용 5.3% 증가 |
| Toffoli 20% 감소, 실패 penalty $R$ 30% 증가 | $0.8\times1.3=1.04$ | 비용 4% 증가 |
일부 실패를 허용해 회로를 짧게 만들었다면, 그에 따라 늘어난 $R$까지 포함해서 비용이 줄었는지 확인해야 한다.
6.9 처음에는 무엇을 개선할 수 있을까
| 접근 | 확인할 가설 | 유지해야 할 조건 | 확인할 결과 |
|---|---|---|---|
| workspace 재사용 | 동시에 필요하지 않은 workspace를 공유할 수 있는가 | syndrome 입력과 각 단계의 초기화·정리 조건 | $Q$ 감소, 추가 계산을 반영한 $Q^2T$ |
| GF 곱셈과 inverse | 같은 field 연산에 필요한 Toffoli와 workspace를 줄일 수 있는가 | irreducible polynomial, bit basis, 0 입력 처리 방식 | 연산과 uncomputation을 합한 비용 |
| EEA 저장과 addressing | 다항식·나머지·pointer를 저장하는 비용을 줄일 수 있는가 | key equation과 reversible 복원에 필요한 정보 | 전체 decoder의 $Q$, $T$ |
| Chien·Forney | 위치별 inverse와 phase 계산을 공유하거나 다른 방식으로 바꿀 수 있는가 | 4,095개 위치와 mask 조건 | 반복 구간의 총비용, workspace가 0으로 돌아오는지 |
| 다른 decoding algorithm | Berlekamp–Massey 등의 reversible 구현이 더 저렴한가 | 같은 syndrome·field·mask·입력 분포 | 완성된 회로의 공식 비용과 실패율 upper bound |
처음부터 decoder 전체를 바꾸면 field 표현, 위치 순서, key equation, phase mask, uncomputation 중 어느 부분이 잘못됐는지 찾기 어렵다. 작은 field에서 손으로 계산해 수학을 확인하고, 연산 하나를 reversible하게 구현한 다음, 같은 입출력 조건을 유지하며 공식 크기로 늘리는 편이 좋다.
소스를 읽을 때는 build_reference_circuit의 입력 구성과 verifier에서 syndrome 지수를 정한 방식을 먼저 확인하자. 이후 dqi_reference_circuit.py의 ProosAndZalkaDecoder에서 초기화, EEA, EEA의 inverse 실행 순서를 살펴보면 된다. 마지막으로 forney_step에서 inverse 계산 → mask에 따른 phase 적용 → 중간값 정리가 어떻게 이어지는지 읽어 보자.
7. dfthcsos: 분자 에너지 계산용 데이터 로딩 회로
7.1 분자 에너지를 계산하는 데 왜 테이블을 읽어야 할까
이 과제의 배경은 분자의 ground-state energy 계산이다. 전자 수가 정해졌을 때 가능한 가장 낮은 에너지를 추정하는 문제다. 대회에서는 그 계산에 반복해서 사용하는 Hamiltonian의 압축 표현과 데이터 로딩 회로를 개선한다. 참가자가 전체 분자를 시뮬레이션하거나 에너지를 직접 예측해 제출하지는 않는다.
Hamiltonian H는 전자의 운동과 상호작용을 나타내는 operator다. H의 eigenvector는 에너지가 정해진 상태이고, 그에 대응하는 eigenvalue가 에너지다. 가능한 모든 상태를 거대한 행렬로 나열하기보다는 orbital 사이의 상호작용 계수를 이용해 H를 표현한다.
orbital은 전자 하나의 상태를 표현하는 basis function이다. 특정 위치의 작은 상자나 원자를 뜻하는 것은 아니다. 이 과제에서는 전자를 하나씩 구별해 추적하는 대신, 각 상태에 전자가 얼마나 있는지 나타내는 occupation number를 사용한다. 이러한 표현을 second quantization이라고 한다.
공식 인스턴스 FeMoCo76o113e는 질소 고정 효소의 활성 중심인 FeMoCo를 대상으로 한 spatial orbital 76개, 전자 113개 문제다. spatial orbital 하나에 spin mode 두 개가 대응한다. 76은 orbital 수이며 전자 수나 원자 수, 제출 회로의 qubit 수가 아니다. ANGLE 회로의 119 qubit과 전체 비용 모델의 730 qubit 역시 각각 다른 범위의 자원을 센 값이다.
| 표기 | 의미 | 대회에서 주어지는 것 |
|---|---|---|
| N | spatial orbital 수 | 76 |
| η | 전자 수 | 113 |
| h⁽¹⁾ₚq | one-electron term의 계수 | FCIDUMP에서 읽는 기준 계수와 정해진 변환 |
| h⁽²⁾ₚqrs | two-electron term의 계수 | orbital 번호 네 개로 인덱싱하는 tensor |
| H | 전체 전자계의 Hamiltonian | 위 계수들로 표현하는 operator |
one-electron term은 전자 하나의 운동과 외부 환경의 영향을, two-electron term은 전자 사이의 상호작용을 나타낸다. creation·annihilation operator의 순서와 계수 convention에 따라 식의 모양이 달라질 수 있어 공식 코드도 지정된 방식으로 계수를 변환한다. two-electron coefficient에는 p,q,r,s라는 인덱스 네 개가 붙는다.
각 인덱스가 N개의 값을 가지므로 계수의 수는 단순히 세면 N⁴이다. N=76이면 76⁴=33,362,176개다. 대칭성을 이용해 중복을 줄여도, 계수마다 개별 분기를 만드는 회로는 너무 커진다. 그래서 먼저 고전 컴퓨터에서 계수의 구조를 압축하고, 양자 회로는 압축한 데이터만 읽어 계산하도록 구성한다.
7.2 factorization으로 계수를 압축한다
간단한 행렬에서 압축이 어떻게 가능한지 보자.
\[A=\begin{pmatrix}1&2\\2&4\end{pmatrix} =\begin{pmatrix}1\\2\end{pmatrix} \begin{pmatrix}1&2\end{pmatrix} =5uu^{\mathsf T},\qquad u=\frac{1}{\sqrt5}\begin{pmatrix}1\\2\end{pmatrix}.\]이 행렬은 네 원소를 모두 저장할 필요가 없다. 벡터 u와 가중치 5만 있으면 전체를 복원할 수 있다. 실제 coefficient tensor는 훨씬 크고, 작은 rank로 정확히 표현되지 않을 수도 있다. 하지만 같은 형태의 항을 몇 개 더해 허용오차 안에서 근사할 수 있다. factorization에서는 이런 표현을 찾는다.
공식 dfthcsos는 double factorization과 tensor hypercontraction을 결합한 DFTHC 구조를 사용한다. 참가자는 그 구조 안에서 크기와 수치 파라미터를 조정한다. verifier는 제출한 데이터로 다음 X를 계산한다.
X의 outer product를 더하면 아래 coefficient tensor를 얻는다.
\[G_{pqrs}=\sum_{\rho=1}^{R}\sum_{c=1}^{C} X^{(\rho c)}_{pq}X^{(\rho c)}_{rs}.\]이를 공식 two-electron integral과 비교하려면 먼저 G에서 고정된 symmetric shift를 되돌려야 한다. 따라서 위 식의 G를 원본 integral과 곧바로 비교해서는 안 된다. 벡터 u, 가중치 w, identity offset W, 고정 shift는 각각 다른 역할을 한다.
| 바꿀 수 있는 선택 | 뜻 | 값을 줄이거나 바꿀 때 고려할 점 |
|---|---|---|
| R | factorization 성분 수 | 성분 수를 줄이면 원래 계수를 충분히 표현하지 못할 수 있다 |
| B | 성분별 one-particle vector 수 | 로딩 주소는 줄지만 reconstruction error가 늘 수 있다 |
| C | 성분별 coefficient copy 수 | state preparation 비용과 계수를 조절할 자유도가 함께 바뀐다 |
| u, w, W | 수치 파라미터 | 같은 오차에서도 normalization과 회로 비용이 달라진다 |
세 과제 중 수치 최적화 경험을 가장 직접적으로 활용할 수 있는 과제다. 다만 reconstruction error만 최소화하면 되는 것은 아니다. 같은 정확도에서도 필요한 주소가 적고 state preparation이 단순하며 normalization에 따른 비용이 낮은 표현을 찾는 편이 좋다. factorization 후보를 비교할 때 최종 회로 비용까지 계산해야 한다.
7.3 block encoding으로 Hamiltonian을 회로에 구현한다
양자 회로의 reversible 연산은 unitary여야 한다. 일반적인 Hamiltonian H는 unitary가 아니다. 상태에 H를 곱했을 때 norm이 바뀔 수 있으므로 H를 그대로 gate 하나로 사용할 수는 없다.
block encoding에서는 더 큰 unitary U를 만들고, 그 일부 block이 normalization을 적용한 operator가 되도록 한다. 보조 register를 0으로 준비했을 때 만족해야 하는 관계는 다음과 같다.
\[(\langle0\rvert _{\mathrm{anc}}\otimes I)\, U\, (\lvert 0\rangle_{\mathrm{anc}}\otimes I) =\frac{\widetilde H}{\alpha}.\]H̃는 사용할 알고리즘에 맞춰 상수항을 shift하는 등의 처리를 거친 Hamiltonian이다. α는 H̃/α를 unitary의 일부 block으로 표현할 수 있도록 정하는 normalization factor다. 에너지 추정 알고리즘은 이렇게 만든 U와 그 inverse를 반복 호출한다. 이 회로 한 번의 실행으로 에너지가 출력되는 것은 아니다.
반복 호출하기 때문에 데이터 로딩 한 번의 비용도 중요하다. 호출당 비용을 조금만 줄여도 전체 에너지 추정에서는 큰 차이가 난다. normalization factor가 커지면 같은 정밀도에 도달하는 데 더 많은 호출이 필요하다. 대회가 평가하는 값도 block encoding 한 번의 비용 × normalization에 따른 배수다.
DFTHC의 sum of squares(SOS)는 energy shift를 적용한 근사 Hamiltonian $H_{\mathrm{DFTHC}}-E_{\mathrm{SOS}}I$의 구조를 가리킨다. 전자 수를 고정한 sector에서 이 operator가 positive semidefinite가 되도록 구성한다. 원래 분자의 음수 에너지가 전부 양수가 된다는 뜻은 아니다. 이 SOS 구조와 에너지 기준을 사용해 spectrum amplification의 비용을 줄인다. 같은 근사 오차를 만족해도 factorization의 normalization에 따라 전체 비용이 달라진다.
공식 verifier는 다전자 Hamiltonian을 직접 diagonalize해 ground state를 찾지는 않는다. 대신 고정된 에너지 상한 E_upper와 factorization에서 계산한 E_SOS로 다음 값을 구한다.
\[E_{\mathrm{gap}}=E_{\mathrm{upper}}-E_{\mathrm{SOS}},\qquad \lambda_{\mathrm{eff}} =\sqrt{E_{\mathrm{gap}}(2\Lambda-E_{\mathrm{gap}})}.\]LCU(linear combination of unitaries)는 operator를 여러 unitary의 선형 결합으로 표현하는 방법이다. 계수의 크기에서 raw normalization factor Λ를 구한다. 위 식은 Λ와 SOS 에너지 기준을 사용해 최종 비용에 곱할 λ_eff를 계산한다. 여기서 E_gap은 에너지 상한과 SOS 기준의 차이다. ground state와 first excited state 사이의 물리적 excitation gap이 아니다. lambda_eff도 분자 에너지나 근사 오차가 아니라 비용식에 쓰는 effective normalization factor다.
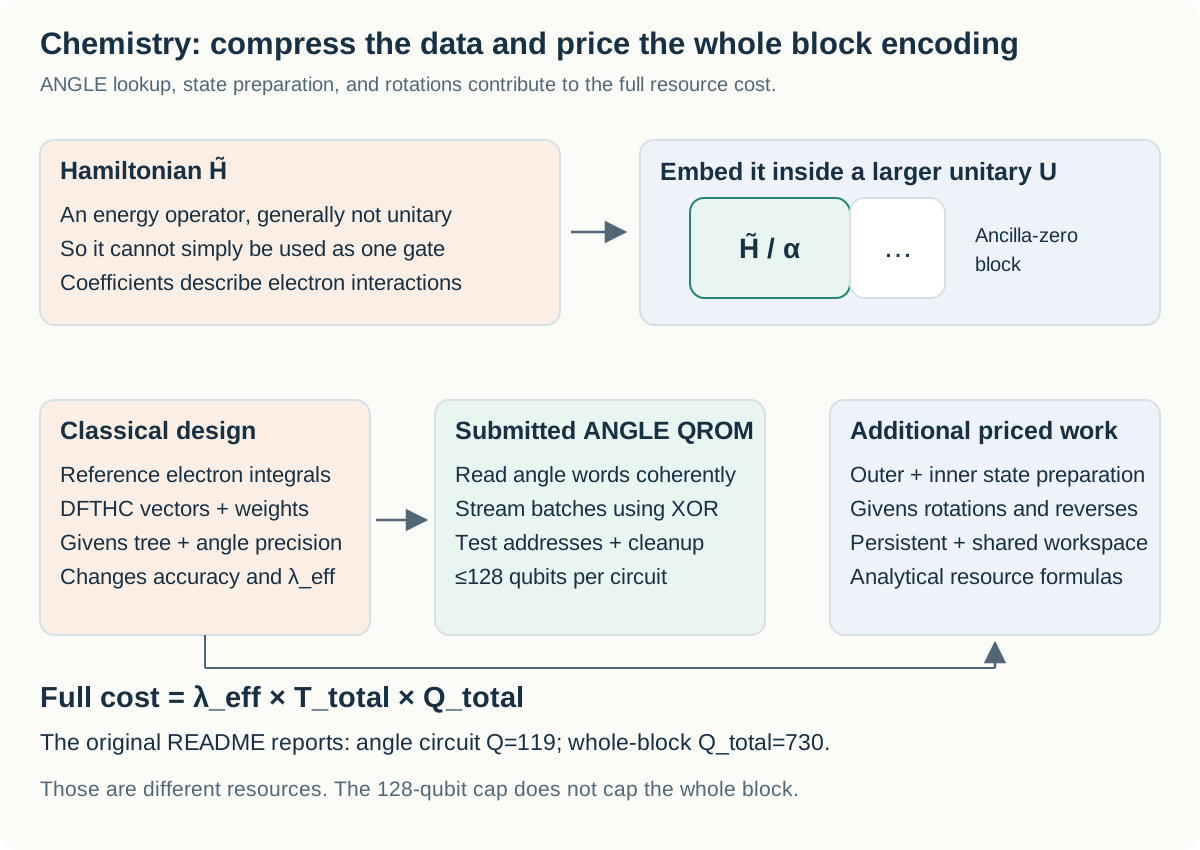
그림 6. Hamiltonian H를 더 큰 unitary의 일부 block에 구현한다. factorization과 rotation tree에 따라 ANGLE 조회 비용이 달라진다. 전체 비용에는 state preparation과 Givens rotation도 포함된다. ANGLE 회로 하나의 qubit 수와 전체 block의 qubit 수는 별도로 계산한다.
7.4 QROM은 superposition 상태의 주소를 어떻게 읽을까
Python의 table[a]는 a번째 행을 읽는다. 양자 알고리즘에서는 주소 a가 superposition일 수 있어, 주소를 측정해 하나를 고를 수 없다. 주소의 superposition을 유지한 채 각 주소의 데이터를 출력 register에 XOR하는 회로가 필요하다.
이를 QROM(quantum read-only memory)이라고 한다. 별도의 대형 양자 메모리 장치가 아니라, 미리 알고 있는 고전 데이터를 gate 패턴으로 구현하는 방식이다. d₀=01, d₁=10인 표를 예로 들면 선형성에 따라 다음과 같이 동작한다.
\[\frac{\lvert 0\rangle+\lvert 1\rangle}{\sqrt2}\lvert 00\rangle \longmapsto \frac{\lvert 0\rangle\lvert 01\rangle+\lvert 1\rangle\lvert 10\rangle}{\sqrt2}.\]결과에서는 각 주소와 해당 데이터가 함께 superposition을 이룬다. 데이터를 사용한 뒤 같은 XOR 조회를 다시 적용하면 데이터 register를 0으로 복원할 수 있다. 대회에서는 measurement-based uncomputation도 허용한다. 이 방법을 쓸 때는 측정 결과에 따른 phase correction까지 맞춰야 한다.
회로에서 표를 읽으려면 주소를 선택하는 reversible 논리와 출력 register에 데이터를 XOR하는 gate가 필요하다. 일반 프로그램의 배열 인덱싱 한 줄에도 양자 회로에서는 비용이 드는 것이다. 주소가 많고 출력 word가 길어질수록 분기 논리와 workspace를 잘 설계해야 한다.
7.5 벡터 대신 Givens rotation의 각도를 로딩한다
벡터 u의 성분을 quantum amplitude로 표현하려면 그 상태를 만드는 회로가 필요하다. 공식 방식에서는 u를 만드는 Givens rotation의 각도를 읽어 순서대로 적용한다. Givens rotation은 벡터의 두 성분을 선택해 회전시키는 연산이다. verifier는 아래 2×2 연산으로 각도 표에 해당하는 벡터를 고전 컴퓨터에서 복원한다.
\[\begin{pmatrix}u_p'\\u_q'\end{pmatrix} =\begin{pmatrix}\cos\theta&-\sin\theta\\ \sin\theta&\cos\theta\end{pmatrix} \begin{pmatrix}u_p\\u_q\end{pmatrix}.\]성분이 3개인 예를 계산해 보자. u=(1,0,0)에서 시작해 rotation tree의 edge 0→1과 0→2에 π/4 회전을 차례로 적용한다.
\[(1,0,0) \xrightarrow{(0,1),\,\pi/4} (1/\sqrt2,1/\sqrt2,0) \xrightarrow{(0,2),\,\pi/4} (1/2,1/\sqrt2,1/2).\]회전할 때마다 norm이 유지되므로 최종 결과도 unit vector다. 회전 각도가 같아도 rotation tree와 적용 순서가 다르면 다른 벡터가 나올 수 있다. 따라서 tree도 제출해야 한다.
N=76이면 벡터 하나에 tree edge 75개와 각도 75개가 필요하다. 각도는 실수 그대로 저장하지 않고 b_rot 비트의 정수 word로 표현한다.
\[\theta=\pi\frac{\mathrm{word}}{2^{b_{\mathrm{rot}}-1}}, \qquad 0\leq\mathrm{word}<2^{b_{\mathrm{rot}}}.\]각도를 [0,2π)의 유한한 격자에 맞추는 셈이다. 12비트 word라면 간격은 2π/4096라디안이다. 비트 수를 줄이면 각도 register와 rotation 비용은 줄어들지만, 복원한 벡터와 coefficient tensor의 오차는 커질 수 있다. 높은 정밀도로 구한 factorization이 잘 맞더라도 각도를 반올림한 뒤에는 통과하지 못할 수 있다. verifier는 회로에서 실제로 읽은, quantization된 각도로 평가한다.
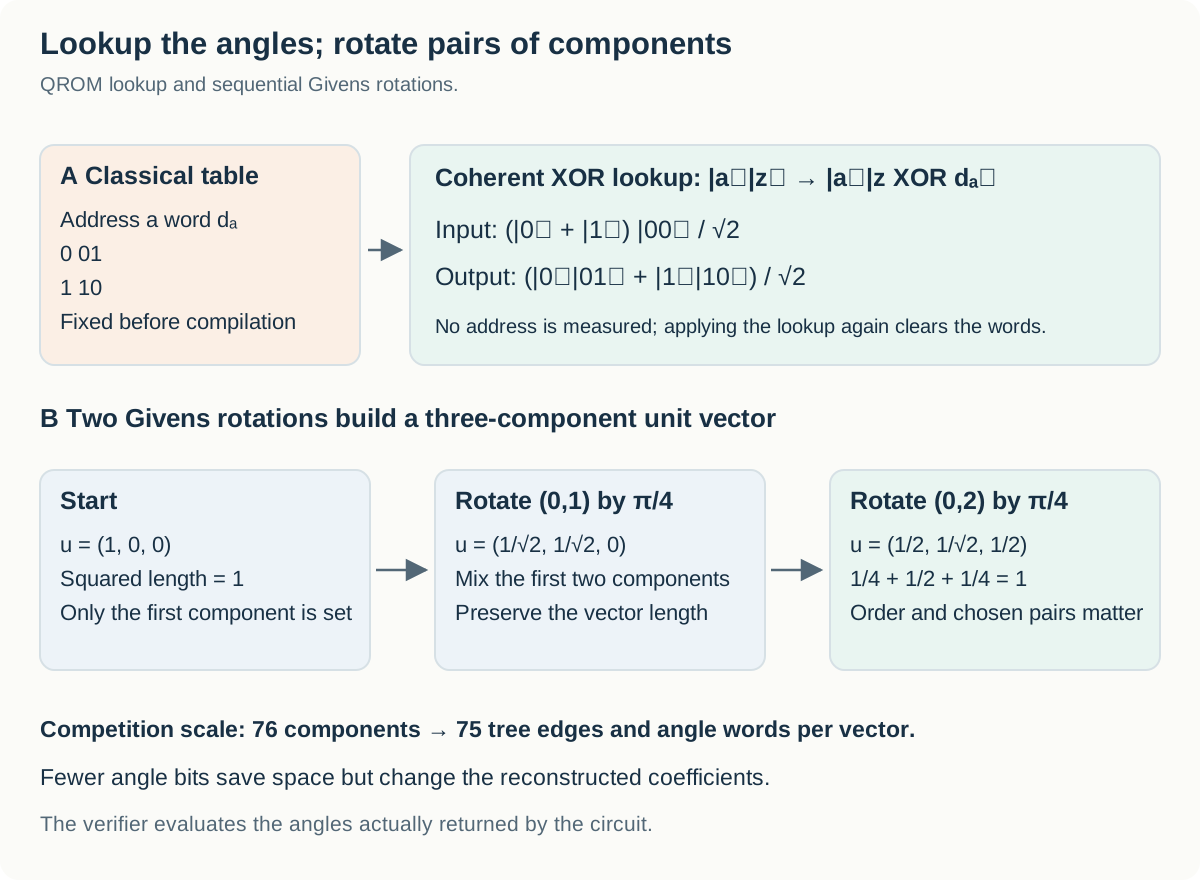
그림 7. 위쪽 QROM은 주소를 측정하지 않고 주소별 데이터를 읽는다. 아래쪽 예에서는 두 성분씩 회전해 unit vector를 만든다.
7.6 각도 75개를 batch로 나눠 register를 재사용한다
각도를 J개씩 묶어 읽으면 같은 word register를 재사용할 수 있다. 기준 설정은 b_rot=12, J=8이다. 데이터 word에 필요한 qubit은 96개이고, 각도 75개를 10개 batch로 나눠 읽는다. 벡터 주소는 N+RB=76+65×60=3,976개이므로 주소 register에는 12 qubit을 쓴다.
ANGLE_k는 batch마다 기존 word를 0으로 지우고 새 값을 넣는 회로가 아니다. 공식 규격에서는 직전 batch와 현재 batch의 XOR 차이를 읽는다. 같은 주소의 batch들을 B₀,B₁,…라 쓰면 다음과 같다.
word register에 B₀가 있을 때 δ₁을 XOR하면 B₁으로 바뀐다. 이렇게 기존 register를 계속 재사용한다. 마지막 batch는 실제 각도 3개에 0 padding 5개를 더해 8칸을 채운다. inverse 조회에서는 이 순서를 거꾸로 따라가며 register를 복원한다. J를 키우면 조회 횟수는 줄지만 각도 word를 동시에 더 많이 저장해야 하므로 128 qubit 제한을 확인해야 한다.
7.7 verifier는 제출한 자료 중 무엇을 평가할까
| 부분 | 참가자가 제공하는 것 | 검증 방식 |
|---|---|---|
| factorization 수치 | R,B,C를 정하는 배열 shape와 가중치 | 기준 적분과의 reconstruction error 및 normalization 계산 |
| rotation 표현 | tree_edges, word 정밀도와 batch 크기 | 회로가 읽은 각도로 unit vector 복원 |
| 각도 로딩 | angle_k_0, …, angle_k_(K−1) 회로 | 모든 주소에서 forward·inverse 방향을 64 shots씩 검사 |
| 나머지 회로 | 전체 회로를 직접 제출하지는 않음 | state preparation과 Givens rotation을 공식 비용식으로 계산 |
submission.npz에서 U는 배열 shape를 정하는 데 사용한다. 실제 벡터는 ANGLE 회로가 출력하는 각도로 복원한다. U 배열에 넣은 벡터가 아무리 좋아도, 회로의 각도가 그 벡터를 표현하지 못하면 원하는 결과로 평가받을 수 없다. 제출한 H1_I와 Hsym_lower는 사용하지 않고 공식 symmetric shift를 적용한다.
각 ANGLE 회로는 입력 주소를 유지하고 scratch qubit을 0으로 복원해야 한다. 의도하지 않은 ±1 phase가 남아도 안 된다. shot마다 출력 word가 다르거나 padding·inverse 조회·phase 검사에 실패하면 거부된다. 제출 대상은 각도를 이진 word로 출력하는 Boolean oracle이다. Givens rotation 자체를 Z_POW로 구현해 제출하는 것이 아니며, Z_POW 사용도 금지된다.
7.8 전체 비용에서 개선 효과를 확인한다
공식 비용식은 다음과 같다. 여기서 T는 Toffoli 수이며 T gate 수와 혼동하지 않도록 주의하자.
\[C_{\mathrm{chem}}=\lambda_{\mathrm{eff}}\,T_{\mathrm{total}}\,Q_{\mathrm{total}}.\] \[T_{\mathrm{total}}= T_{\mathrm{ANGLE,fwd+rev}}+T_{\mathrm{outer}}+T_{\mathrm{inner}} +2(N-1)(2b_{\mathrm{rot}}-1).\] \[Q_{\mathrm{total}}= Q_{\mathrm{outer,persist}}+Q_{\mathrm{inner,persist}}+Jb_{\mathrm{rot}} +\max(Q_{\mathrm{outer,temp}},Q_{\mathrm{inner,temp}},Q_{\mathrm{ANGLE,temp}}).\]state preparation과 각도 조회는 순서대로 실행하므로 temporary workspace를 공유할 수 있다. 필요한 크기는 각 단계의 합이 아닌 최댓값이다. 각도 word는 rotation을 적용하는 동안 유지해야 해서 persistent workspace에 포함한다. 이 때문에 ANGLE 회로의 qubit을 줄인 만큼 전체 Q도 줄어드는 것은 아니다.
| 공식 README의 baseline 비용 | 값 |
|---|---|
| R,B,C / b_rot / J / batch 수 K | 65,60,60 / 12 / 8 / 10 |
| ANGLE 회로 하나 | 119 qubit, 3,974 Toffoli |
| ANGLE 전체 forward·inverse 조회 | 79,480 Toffoli |
| outer state preparation / inner state preparation / Givens | 846 / 9,461 / 3,450 Toffoli |
| 전체 T_total | 93,237 |
| 전체 Q_total | 730 = persistent 186 + 공유 temporary 544 |
| raw Λ / E_gap | 약 308.45594 / 3.96548 Ha |
| λ_eff / 과제 비용 | 약 49.30137 / 3.3556×10⁹ |
기준 설정에서는 ANGLE 조회에 전체 Toffoli의 약 85%를 쓴다. 한편 전체 qubit 중 상당수는 state preparation에 필요한 공유 temporary workspace 544개다. 따라서 조회 회로의 Toffoli를 줄이는 작업과 factorization 크기·정밀도를 바꿔 state preparation 공간을 줄이는 작업은 각각 다른 비용 항에 영향을 준다. 조회에 scratch qubit을 더 배정하더라도 공유 공간 544개와 ANGLE의 128개 제한 안에 머문다면 전체 Q가 늘지 않을 수 있다. 실제 적용 가능성은 회로 배치와 공식 비용식으로 확인해야 한다.
통과 조건은 error_1 ≤ 20 mHa, error_2 ≤ 20 mHa, 각 ANGLE 회로 ≤128 qubit, Λ>49.0, E_gap>3.914898 Ha, 0<E_gap<2Λ다. Λ와 E_gap의 하한에는 등호를 허용하지 않는다. 두 오차는 각각 one-electron coefficient와 two-electron coefficient tensor를 얼마나 정확히 복원했는지 평가하는 Frobenius residual이다. 이 조건을 통과해도 실제 다전자 ground-state energy의 오차가 20 mHa 이하라고 보장되는 것은 아니다.
7.9 어느 부분부터 개선해 볼까
| 접근 | 먼저 고정할 것 | 바꾸는 것 | 통과 후 비교할 것 |
|---|---|---|---|
| 조회 회로 개선 | factorization·tree·각도 word | 주소 분기, 공유 논리, QROM 구성 | 같은 word를 읽을 때의 ANGLE Toffoli와 temp |
| batch 크기 탐색 | factorization·tree·정밀도 | J와 batch 수 | 128 qubit 제한, 전체 T와 Q |
| rotation tree·rounding 개선 | 고정밀 factorization | tree와 각도 quantization | 복원 후 error_1·error_2·λ_eff |
| factorization 자체 개선 | 공식 적분·shift·최종 평가식 | R,B,C와 u,w,W | 오차 조건을 만족하는 후보의 λ_eff×T_total×Q_total |
처음에는 기준 각도 표를 고정하고 QROM 생성기부터 살펴보는 편이 이해하기 쉽다. 각도까지 함께 바꾸면 조회 회로의 버그인지, factorization의 근사 오차인지, quantization의 영향인지 원인을 나누기 어렵다. 수치 최적화가 익숙하다면 고정밀 factorization을 먼저 개선할 수도 있다. 다만 최종 회로에서 쓸 정밀도로 각도를 변환한 뒤 reconstruction error를 다시 확인해야 한다.
검토할 만한 방법으로는 scratch를 더 사용해 여러 주소를 묶어 처리하는 QROM, 반복되는 출력 비트의 논리를 공유하는 회로, batch·tree·rounding 방식을 함께 선택하는 최적화가 있다. 어떤 방법이 실제로 유리한지는 공식 제한을 통과한 회로의 비용을 비교해야 알 수 있다.
소스는 SCORING_README.md의 worked example → example_submission/angle_k_reference_circuit.py의 batch별 XOR 표 → verify.py의 evaluate_words → scoreinfra/dfthc_math.py의 벡터·계수 복원 순으로 읽어 보자. 회로가 word를 정확히 출력하는지 확인하는 검사와, 그 word로 복원한 Hamiltonian의 오차를 평가하는 검사를 따로 이해할 수 있다.
8. 비용을 줄이면 리더보드 점수는 얼마나 오를까
앞에서 살펴본 세 과제의 비용식을 다시 모아 보자.
| 과제 | 낮출 비용 | 비교에서 함께 고정할 것 |
|---|---|---|
| invsqrt | Q×C, C=Toffoli+T gate/4 | 전체 x, phase 오차, synthesis에 남겨 둘 오차 여유 |
| dqi | R(ε₊)×Q²×T | finite field, syndrome, mask, 공식 분포 |
| dfthcsos | λ_eff×T_total×Q_total | 재구성 오차와 전체 block encoding 자원 |
기호를 혼동하지 않도록 주의하자. 뒤의 두 과제에서 T는 T gate 수가 아니라 Toffoli 수다. invsqrt에서는 임의 각도 회전 하나를 구현하는 비용을 synthesis 오차 ε에 따라 $0.56\log_2(1/\epsilon)+5.3$개의 T gate로 계산한다. 표의 C에는 이 synthesis 비용도 들어 있다.
과제별 비용은 낮을수록 좋지만, 최종 리더보드 점수는 높을수록 좋다. 먼저 각 과제에서 baseline 비용을 제출 회로의 비용으로 나눠 얼마나 개선했는지 계산한다. 그런 다음 세 비율의 기하평균을 구한다.
\[\mathrm{Score} =\left(\prod_{b=1}^{3} \frac{\mathrm{cost}^{\mathrm{ref}}_b}{\mathrm{cost}_b} \right)^{1/3}.\]| 가상의 변화 | 세 과제의 개선 배수 | 전체 점수 |
|---|---|---|
| 기준 제출과 같음 | 1, 1, 1 | 1.000 |
| 한 과제의 비용만 절반 | 2, 1, 1 | 약 1.260 |
| 한 과제의 비용만 1/4 | 4, 1, 1 | 약 1.587 |
| 세 과제 모두 비용 절반 | 2, 2, 2 | 2.000 |
세 과제를 모두 개선해야만 점수가 오르는 것은 아니다. 한 과제만 개선해도 전체 점수는 올라간다. 다만 제출 패키지에는 세 과제의 파일이 모두 필요하므로, 아직 개선하지 않은 과제에는 공식 baseline 파일을 넣으면 된다.
검증 결과 JSON을 읽을 때는 필드 이름에 주의해야 한다. invsqrt 검증기의 score는 해당 과제의 비용 Q×C다. 이 값은 작아야 좋으며, 세 과제를 합친 Kaggle 리더보드 점수와는 다르다.
9. 공식 파일을 받고 실행 환경을 준비하기
공식 배포본에는 train.csv, test.csv 같은 학습·평가 데이터 대신 회로, 검증기, 수치 자료가 들어 있다. 2026년 10월 23일 받은 공식 배포본은 34개 파일, 압축 해제 후 약 1.04 GB다. 주요 파일의 위치는 다음과 같다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
official/
├── sample_submission/
│   ├── invsqrt.kmb
│   ├── dqi.kmb
│   └── dfthcsos/
│       ├── angle_k_0.kmb ... angle_k_9.kmb
│       └── submission.npz
├── verifiers/
│   ├── invsqrt/
│   ├── dqi/
│   └── dfthcsos/
├── kickmix/
│   └── kickmix.so
└── verifiable_circuit_compilation.pdf
회로 파일은 텍스트 형식인 .kmx와 binary 형식인 .kmb를 지원하며, 둘 다 제출할 수 있다. Python에서는 kickmix.Circuit과 CircuitBuilder로 회로를 읽고 만든다. 처음에는 회로 파일의 gate를 하나씩 고치기보다 baseline 생성 코드와 builder API를 같이 읽어 보길 권한다. 그래야 배열과 산술 연산이 어떤 gate들로 구현되는지 이해하기 쉽다.
설치가 부담스럽다면 Kaggle notebook부터
먼저 실행해 보고 싶다면 공식 starter notebook과 데이터를 이용하면 된다. 배포본의 kickmix/를 Python 검색 경로에 추가하면 라이브러리를 불러올 수 있다. 데이터가 연결된 경로는 notebook의 Input 패널에서 확인한다. 다만 제공된 .so를 로컬로 복사하는 것만으로는 설치되지 않는다. OS와 Python ABI가 맞아야 사용할 수 있다.
2026년 10월 23일 현재 데이터 안내에는 kickmix의 PyPI 배포가 예정되어 있다. 아래는 Qualtran 소스에서 빌드하는 방법이다.
로컬 실행 환경
로컬 검증 환경은 macOS arm64, Python 3.12.13, NumPy 2.2.6, Apple C++20 toolchain이다. kickmix는 공식 Qualtran 저장소에서 아래 commit을 받아, 독립된 하위 패키지만 빌드했다.
1
638777fac4379bc62e2a1e4a52cf1a1753895d48
빌드에는 uv, Git, 플랫폼에 맞는 C++20 컴파일러가 필요하다.
1
2
3
4
5
6
mkdir quantum-circuit-start
cd quantum-circuit-start
uv venv --python 3.12.13
uv pip install --python .venv/bin/python 'numpy==2.2.6' \
  'kickmix @ git+https://github.com/quantumlib/Qualtran.git@638777fac4379bc62e2a1e4a52cf1a1753895d48#subdirectory=kickmix'
.venv/bin/python -I -c 'import numpy, kickmix; print(numpy.__version__); print(kickmix.__file__)'
이후 명령은 모두 quantum-circuit-start/에서 실행한다. 파일을 받으려면 Kaggle CLI 인증을 설정하고 대회 규칙에 동의해야 한다. API 토큰은 글이나 저장소에 적지 말자. CLI가 준비됐다면 원본 데이터와 메트릭 notebook을 각각 내려받는다.
1
2
3
4
5
mkdir -p downloads official metric runs
kaggle competitions download google-verifiable-quantum-circuit-compilation -p downloads
.venv/bin/python -m zipfile -e \
  downloads/google-verifiable-quantum-circuit-compilation.zip official
kaggle kernels pull metric/google-quantum-ai-metric -p metric
공식 baseline 회로와 검증기는 수정하지 않고 보관한다. 후보 회로는 다른 디렉터리에 만들고, 나중에 같은 파일을 비교할 수 있도록 원본·후보·검증기의 SHA-256을 기록해 두자. 메트릭 notebook은 과제별 검증뿐 아니라 파일을 읽을 수 있는지, 허용 gate와 register 규칙을 지켰는지, 제출 구조가 맞는지도 확인한다. 과제별 스크립트에서 PASS를 받았더라도 전체 제출 검사는 따로 해야 한다.
아래 결과는 macOS에서 소스 빌드한 kickmix로 얻었다. Kaggle Linux binary의 소스 commit은 공개되지 않아 두 구현의 일치 여부는 미확인이다.
10. invsqrt baseline의 비용과 실행시간을 재현하기
처음부터 전체 범위를 실행하기보다는, 입력 일부로 파일 경로와 라이브러리가 제대로 설정됐는지 확인하자. 아래 smoke 명령은 22비트 원본 회로를 바꾸지 않고 검사할 x의 범위만 줄인 것이다. 결과를 덮어쓰지 않도록 실행마다 새 디렉터리를 만든다.
1
2
3
4
5
6
7
8
9
mkdir runs/invsqrt-smoke-001 && \
.venv/bin/python -I official/verifiers/invsqrt/verify_submission_invsqrt.py \
  official/sample_submission/invsqrt.kmb \
  --n-p 10 --beta 1 --precision-bits 24 --eta 218 \
  --max-x 64 --shots-per-x 64 \
  --batch-size 256 --max-workers 1 \
  --salt quantum-circuit-local-v1 \
  > runs/invsqrt-smoke-001/result.json \
  2> runs/invsqrt-smoke-001/stderr.log
이 명령은 입력 범위를 줄여 총 4,096 shots로 설치와 입출력을 확인한다. rotation synthesis 비용은 검사 범위의 최소 오차 여유로 계산하므로, 전체 범위에서 계산한 비용과 달라질 수 있다.
전체 검증은 x의 상한을 3,133,452로 지정한다.
1
2
3
4
5
6
7
8
9
10
11
mkdir runs/invsqrt-full-001 && \
OMP_NUM_THREADS=1 OPENBLAS_NUM_THREADS=1 MKL_NUM_THREADS=1 \
VECLIB_MAXIMUM_THREADS=1 NUMEXPR_NUM_THREADS=1 \
.venv/bin/python -I official/verifiers/invsqrt/verify_submission_invsqrt.py \
  official/sample_submission/invsqrt.kmb \
  --n-p 10 --beta 1 --precision-bits 24 --eta 218 \
  --max-x 3133452 --shots-per-x 64 \
  --batch-size 256 --max-workers 4 \
  --salt quantum-circuit-local-v1 \
  > runs/invsqrt-full-001/result.json \
  2> runs/invsqrt-full-001/stderr.log
위 shell 명령에는 timeout이 없다. 로컬 측정에서는 부모 프로세스가 최대 1,800초로 제한하고 시작·종료 시각과 로그를 기록했다.
출력은 파일에 저장하므로 실행 중에는 터미널에 아무것도 나오지 않을 수 있다. 실행을 마치면 다음 명령으로 결과를 확인한다.
1
.venv/bin/python -m json.tool runs/invsqrt-full-001/result.json
우선 프로세스가 정상 종료했는지 확인한다. 그런 다음 status가 PASS인지, verified_shots가 200,540,928인지 살펴보고 num_qubits와 score를 아래 표와 비교하면 된다. FAIL이면 JSON의 error와 stderr.log에서 원인을 확인한다. JSON에는 실행 시간이 없어서, 아래의 199.921초는 부모 프로세스에서 별도로 측정해 기록했다.
전체 로컬 검증 결과
원본 sample_submission/invsqrt.kmb의 전체 범위 로컬 검증 결과다. 실행 시간은 한 차례 측정한 값이다.
| 측정 항목 | 결과 |
|---|---|
| 검증 상태 | PASS |
| 검사한 shots | 200,540,928 |
| qubit 수 Q | 260 |
| shot당 Toffoli 수 | 7,735 |
| 직접 집계한 T gate | 1 |
| 합성 비용을 계산하는 임의 각도 회전 | 37 |
| rotation synthesis를 포함한 Toffoli 환산 C | 7,987.593206597238 |
| 과제 비용 Q×C | 2,076,774.233715282 |
| 검증 프로세스 wall time | 199.921초, 약 3분 20초 |
| 검증 worker 수 | 4 |
JSON의 t_count: 1만 보고 회전 비용이 거의 없다고 생각하면 안 된다. 37개 회전의 synthesis 비용은 최종 toffoli_equivalent에 포함된다. phase 오차를 허용오차로 나눈 비율은 최대 약 0.476912였으며, 이때 x는 2,588,411이었다. 후보 회로를 바꿀 때는 phase 오차와 synthesis에 남길 여유를 다시 계산해야 한다.
검증한 원본 회로의 SHA-256은 다음과 같다.
1
e2bf8eb64350a4460a271fc7f1d591ef125b1e276377e9a0f64b96ab3ca321e1
측정한 시간에는 Python 프로세스 시작부터 회로 로딩과 검증까지 포함된다. 실행 전에 파일 해시를 계산한 시간은 뺐다. 이 값은 고전 컴퓨터에서 검증기를 실행한 시간이다. 공식 안내에 나오는 전체 제출 채점 약 45분도 검사 범위와 실행 환경이 달라 직접 비교하기 어렵다.
11. 다음 회로와 비교할 수 있도록 기록 남기기
후보를 비교하려면 변경 내용과 실행 조건을 함께 기록해야 한다. 공식 원본, 후보 생성 코드, 실행 결과를 나누고, 각 기록을 한곳에서 관리하면 비교 조건을 유지하기 쉽다.
1
2
3
4
5
6
7
8
9
project/
├── AGENTS.md / CLAUDE.md        # 공통 진입 지침과 도구별 연결
├── TODO.md / DECISIONS.md      # 다음 작업 / 근거가 남는 결정
├── docs/                      # 목표, 정책, 자료 안내
├── .agents/skills/             # 반복해서 쓰는 실행 절차
├── .agent_runtime/exchange/    # 날짜별 검토 요청과 응답
├── data/official/<snapshot>/   # 수정하지 않은 공식 원본과 manifest
├── candidates/                # 필요해질 때 추가할 생성 코드·후보
└── runs/<run-id>/              # 한 실행의 결과·로그·실행 기록
실행 기록은 다음 질문에 답할 수 있으면 된다. 어떤 원본과 후보를 어떤 코드·환경·난수·자원 한도로 실행했는가? 끝까지 통과했는가? 비용과 시간은 얼마인가? 실패하거나 중단된 시도도 지우지 않는다. 검사 도중에 멈춰서 비용이 작게 나온 결과를, 전체 검증을 통과한 후보와 혼동하지 않기 위해서다.
에이전트 간 검토 의견은 날짜별 exchange 문서에, 결정은 DECISIONS.md, 다음 작업은 TODO.md, 측정값은 실행 기록에 남긴다.
12. 제출 파일과 대회 일정
제출 ZIP의 최상위에는 아래 파일과 디렉터리가 있어야 한다.
1
2
3
4
5
6
7
8
submission.zip
├── invsqrt.kmb                 # 또는 .kmx
├── dqi.kmb                     # 또는 .kmx
└── dfthcsos/
    ├── angle_k_0.kmb
    ├── angle_k_1.kmb
    ├── ...                    # 0부터 빠짐없이 연속된 번호
    └── submission.npz
submission.npz에 넣을 항목은 U, W, H2_I, H1_I, Hsym_lower, tree_edges다. 회로를 생성한 뒤에는 전체 메트릭의 사전 검사와 과제별 검증을 실행하고, ZIP 내부 경로와 필수 파일도 확인해야 한다. 자세한 규칙은 공식 평가 페이지를 참고하면 된다.
대회 일정은 다음과 같다. 각 마감은 해당 날짜 23:59 UTC이며, 한국 시각으로는 다음 날 08:59다.
| UTC 날짜 | 일정 |
|---|---|
| 2026-10-22 | 대회 시작 |
| 2026-11-20 | 중간 마일스톤 상 기준 시각 |
| 2027-01-04 | Longest Leader 집계 종료 및 해당 공개 자료 마감 |
| 2027-01-13 | 참가 규칙 동의·팀 병합 마감 |
| 2027-01-20 | 최종 제출 마감 |
총상금은 150,000달러다. 팀원은 최대 5명이고 하루에 최대 5회 제출할 수 있으며, 최종 평가용으로 고를 수 있는 제출은 2개다. 중간·선두 유지·과제별 추가 상에는 자료 공개 등 별도 조건이 있으므로 상금 안내와 규칙를 확인하자. 일정이나 배포 패키지가 바뀔 수 있으니 실제로 참가하거나 제출하기 전에는 공식 안내를 다시 읽어야 한다.
처음 참가한다면 공식 원본을 받은 뒤 invsqrt baseline을 실행해 PASS와 비용부터 확인하면 된다. 그다음에는 바꿀 부분을 하나 정하고, 같은 검증 조건에서 baseline과 비교한다.
13. 대회는 어떻게 흘러갈까
Santa 2023에서는 퍼즐의 수학적 구조에 맞는 연산을 만들고, 연산 사이의 상쇄를 찾아 이동 횟수를 줄였다. Santa 2024에서는 단어 순서를 탐색하되, 가벼운 neural network로 후보를 먼저 걸러 비싼 Gemma 평가 횟수를 줄였다. Santa 2023 공개 해법 · Santa 2024 공개 해법
종합 점수는 세 과제의 비용 개선 배율을 geometric mean으로 합친 값이다. 따라서 나머지 두 과제의 비용이 같다면, 어느 과제든 하나의 비용을 절반으로 줄일 때 종합 점수는 $2^{1/3}$배가 된다. 과제별 최고 성능에도 각각 10,000달러의 상금이 있으므로, 한 과제를 깊게 파는 참가자와 세 과제를 나눠 맡는 팀이 모두 나올 만하다. 공식 상금 안내
다만 Toffoli 수만 줄여서는 충분하지 않다. 특히 DQI의 비용에는 Q²이 들어간다. 같은 실패율 상한에서 Toffoli 수를 절반으로 줄이더라도 qubit 수가 기존의 $\sqrt{2}$배가 되면 비용은 그대로다. 따라서 빠른 고전 decoder를 그대로 옮기기보다는, 중간값을 적게 저장하고 uncomputation을 싸게 만드는 설계가 중요할 것이다.
초반에는 공개 회로를 대회 조건에 맞춰 옮기는 것만으로도 큰 개선이 나올 가능성이 있다. Gu 등의 논문과 공개 코드는 DQI의 EEA를 Berlekamp–Massey로 바꾸고, uncomputation에 필요한 중간값 저장도 줄였다. 다만 논문과 대회의 조건·비용식이 모두 같지는 않으므로 실제 이득은 공식 검증기로 다시 확인해야 한다. 이후에는 이 구현을 다듬는 작업과 근사식·decoder·factorization·QROM을 새로 설계하는 작업이 함께 진행될 것으로 보인다.
중간 시상과 longest-leader 시상에는 공개 notebook 조건도 있어, 개선 아이디어가 대회 도중 공유될 동기가 있다. longest-leader 상의 공개 기한은 별도로 정해져 있다. 후반에는 그렇게 알려진 방법을 얼마나 잘 구현하느냐와 함께, phase 오차와 DQI 실패율에 충분한 여유를 남겼는지가 중요해질 것이다. Public과 Private은 같은 제출 회로를 서로 다른 salt와 측정 결과로 검사한다. 특정 salt에서 한 번 잘 나온 결과보다, 다른 검사에서도 통과할 회로를 만드는 편이 최종 순위에 유리할 것이다. 공식 상금 안내 · 평가 방식 · 메트릭 구현
참고 자료
- Kaggle 대회 · 평가 · 데이터 · 도메인 설명 · 일정 · 규칙
- 공식 Google Quantum AI Metric — 제출 로딩, 사전 검사, 세 과제 점수 결합의 구현.
- Khattar 등, Leveraging verifiable structure in quantum circuits to find more efficient compilations with agentic AI — 대회 동반 논문.
- Qualtran의 kickmix 문서 · 이번 로컬 빌드의 소스 커밋
- DFTHC starter kit · starter notebook
- Gu 등, Discovering state-of-the-art quantum circuits with large language models · 구현 저장소
- Kaggle CLI — 다운로드와 인증 설정.