RSNA Knee, Part 4: 엇갈린 근거와 최종 두 후보
그림은 눌러서 확대할 수 있습니다. 좁은 화면에서는 넓은 표와 수식을 좌우로 움직여 보세요.
현재 최종 제출로 골라 둔 것은 0.957의 v229와 0.953의 v236이다. 공개 Helios 예측 H는 0.958로 더 높고, 두 번째 후보와 구성이 비슷한 clean 조합도 0.954를 받았다. Public 점수만 보면 더 높은 대안이 있는데도 이 둘을 선택했다. 로컬 평가와 Public이 서로 다른 쪽을 지지하기 때문이다.
두 제출은 다시 평균할 재료가 아니라 최종 평가를 받을 별개의 후보다. 두 번째 제출이 도움이 되려면 Private에서 첫 번째보다 높은 점수를 내야 한다. Architecture가 다르거나 예측의 상관이 낮다는 사실만으로 그런 결과를 기대할 수는 없다. 구체적으로 무엇이 다르고, 그 차이를 택하면서 어떤 불리한 결과를 감수하는지 살펴봐야 한다.
오늘은 2026년 10월 22일 09:00 KST, 00:00 UTC다. 마감은 10월 22일 23:59 UTC, 한국 시각으로 10월 23일 08:59다. Private 점수와 최종 순위는 아직 모른다.
공개 자산의 활용 방식
마지막 주에는 새 모델을 학습하는 것 외에도 강한 공개 예측을 활용할 수 있게 됐다. CoAtNet에 여러 학습 신호와 보조 데이터를 결합한 구성, 작은 입력을 쓰는 ConvNeXt와 소견별 pooling, 소견마다 비중이 다른 순위·확률 조합이 공개됐다. 다만 각 자료에서 보고한 향상 폭을 그대로 더할 수는 없다. 같은 checkpoint를 여러 notebook에서 다시 쓰기도 하고, 이름이 다른 조합들이 예측의 상당 부분을 공유하기도 한다.
공개 자료를 쓰는 방법은 세 가지로 나눴다. 준비된 checkpoint는 호환되는 OOF가 없어도 test 추론에 바로 쓸 수 있다. 학습 방식 전체를 내 fold에 맞춰 재현하면 다른 모델과 비교할 clean 모델군을 얻는다. 입력 방식이나 pooling 아이디어만 가져오면 그 부분의 효과를 따로 시험할 수 있다. 각각 test 성능을 확인하는 일, 재사용할 held-out 예측을 만드는 일, 특정 원리를 검토하는 일이다. 세 경우를 구분하지 않으면 유용한 공개 예측을 배제하거나, 전체 데이터로 학습한 예측을 clean OOF로 잘못 다루게 된다.
공개 자료를 어떤 용도로 쓸지는 리더보드를 보면서도 고민했다. 어제인 10월 21일 저장한 자료에서는 전체 6,307팀 중 1,471팀의 표시 점수가 0.958이었다. 그보다 높은 점수를 받은 팀은 228팀이었고, 0.958에 모인 팀들은 229위부터 1,699위까지 차지했다. 이 정도로 많은 팀이 도달한 점수라면, 같은 수준을 재현하는 것 외에 무엇을 더할 수 있을지도 생각해야 한다.
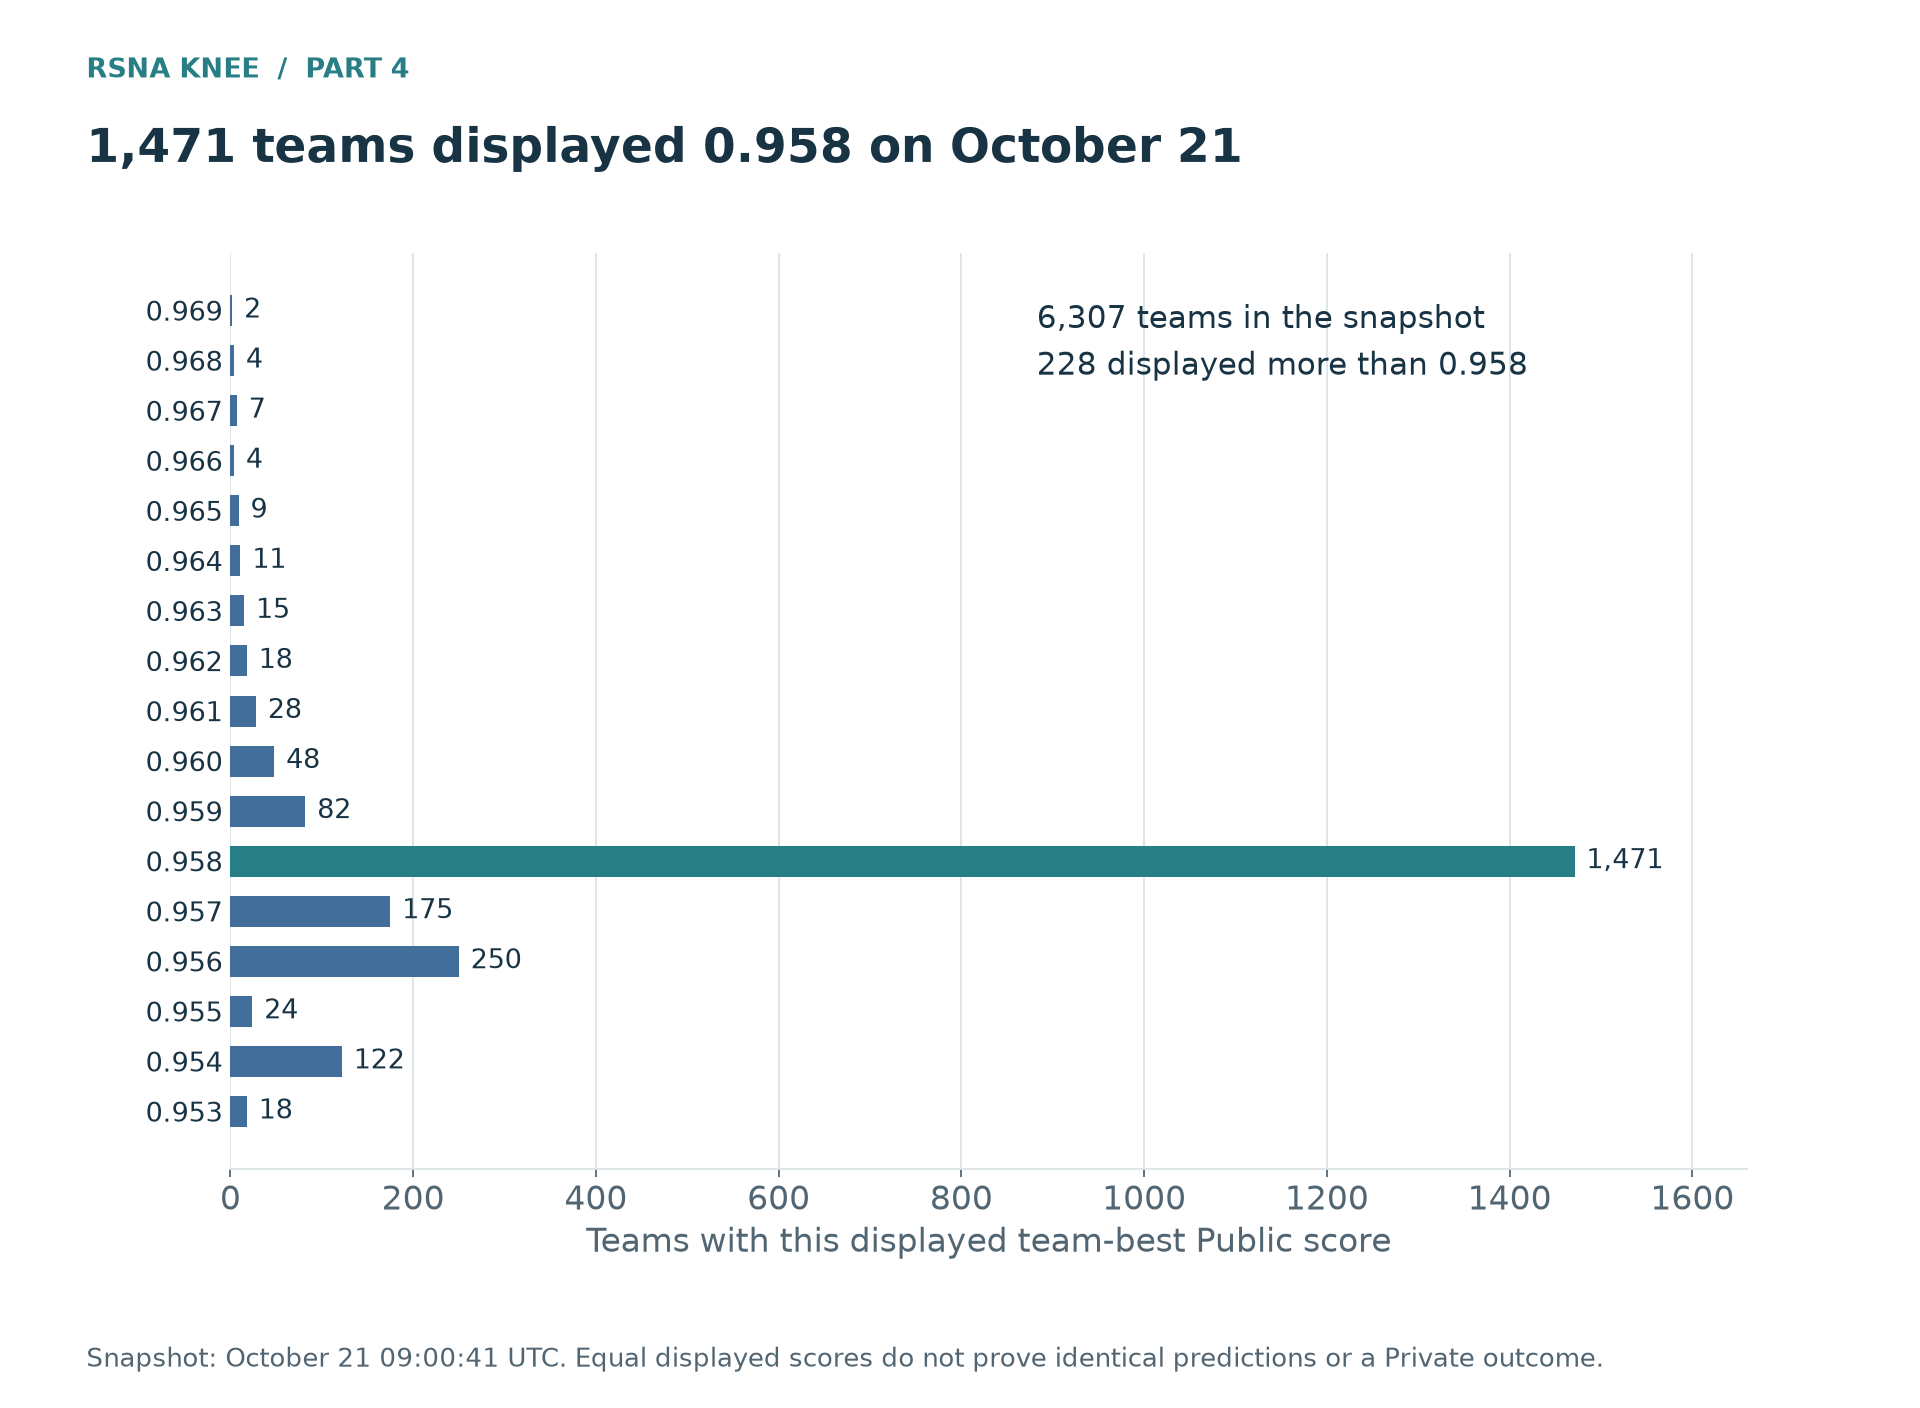 그림 1. 10월 21일 09:00:41 UTC 자료의 팀별 최고 Public 점수 중 0.953 이상. 0.958에 모인 큰 집단은 점수의 밀집도를 나타낸다. 같은 예측을 제출했다는 증거도, 모든 팀의 모델 출처를 보여주는 자료도 아니며, 개별 제출이 최종 몇 위일지 보여주는 그림도 아니다.
공개 예측을 그대로 재현하면 강한 비교 기준을 확보할 수 있다. 그러나 같은 검사에 같은 예측을 내면 원본과 다른 결과를 얻을 수는 없다. 반대로 소수 셋째 자리까지 점수가 같다는 이유만으로 복제라고 단정할 수도 없다. 반올림 전 AUC나 예측값이 달라도 표시 점수는 같을 수 있다. 1,471팀이 모두 같은 예측을 썼는지, Private에서 함께 움직일지는 이 자료만으로 알 수 없다.
최종 선택에는 여러 대안이 있다. Public이 가장 높은 H를 그대로 남길 수도 있고, 자체 예측과 섞을 수도 있으며, clean 조합에 한 자리를 줄 수도 있다. 다른 구성을 고르는 이유는 보지 못한 검사에서 순위를 더 잘 맞힐 수 있다고 판단하기 때문이다. 직접 학습했거나 clean OOF를 확보했다는 사실만으로 test 성능이 높아지는 것은 아니다. 같은 점수에 많은 팀이 모였다고 H가 Private에서 약할 것이라고 볼 근거도 없다.
남은 실험에서도 이 구분을 지키려 했다. 학습과 추론 준비까지 마칠 수 있고 새로운 강한 모델군을 만들 만하다면 공개 recipe를 재현한다. 공개 예측을 섞을 때는 무엇을 바꾸며 그 결과에 따라 최종 선택이 어떻게 달라질지 먼저 정한다. 인기 있는 조합의 가중치를 조금씩 바꾸는 일을 반복해서는 내 예측이 실제로 도움이 되는지 파악하기 어렵다.
라벨 실험 결과와 새 모델군
3편을 쓴 10월 15일에는 N의 multimodal 라벨 비교가 끝나지 않았지만, 같은 날 뒤늦게 N-mm12의 Public 0.945를 확인했다. 정의 기반 N의 0.942보다 높았다. 로컬에서 좋아졌던 라벨 변경이 full-field 모델의 Public에서도 개선으로 이어졌다. 이 결과를 보고 N-mm12를 이후 ensemble의 후보로 넣었다.
공개 recipe 두 종류를 완전히 재현한 결과도 clean 비교의 폭을 넓혔다. R949F는 CoAtNet에 원래 구성의 전처리, 연속값 혼합 라벨, 보조 OAI 데이터를 사용했으며 10월 16일 Public 0.944를 받았다. 비교에 쓴 관련 이전 제출은 0.937이었다. S6F는 소견별 spatial·window attention을 사용하는 ConvNeXt-S recipe로, 10월 17일 0.952를 받았다. 둘 다 평가 영상을 학습에서 제외한 완전한 OOF를 남겼다. 다만 3편에서 설명한 라벨 설계의 전문가 사례 노출은 그대로 남았다. S6F를 더하자 미리 정한 추론 시간 안에서 전체 OOF로 조합을 고르는 절차의 평가도 좋아졌다.
이 결과를 보면 여러 요소가 맞물린 학습 방식은 전체를 재현해 볼 필요가 있다. 입력은 encoder가 볼 정보를 정하고, attention head는 소견별로 반영할 특징을 고르며, 학습 신호는 어떤 차이를 구별하도록 학습할지 정한다. 셋을 함께 바꿨으므로 개선을 backbone 하나의 효과로 볼 수는 없다. 그래도 다른 모델과 조합할 수 있는 더 강한 모델군을 얻었다는 점은 분명하다.
Teacher supervision에서는 다른 성격의 후보가 나왔다. N-T*는 10월 16일 0.951을 받았다. 라벨에 섞인 예측의 학습 이력이 clean student OOF에 필요한 제외 조건을 지키지 못했으므로 final-only로 분류했다. Full-field와 2.5D window T* student를 섞은 점수는 0.950으로 N-T* 단독보다 낮았다. Student 두 개가 각각 좋아졌다고 둘을 평균해도 좋아지는 것은 아니다. 같은 teacher의 예측을 배운 만큼 비슷한 순서를 되풀이할 수 있고, 서로 다른 부분에서는 오히려 맞았던 양성–음성 쌍의 순서를 뒤집을 수도 있다.
최종 예측을 고를 때는 두 종류의 근거를 구분한다. Clean 모델들은 같은 held-out 검사에서 조합을 비교하고, 조합 선택 절차를 fold별로 평가한다. 강한 공개 예측이나 teacher 기반 예측을 넣은 전체 조합은 그 방법으로 평가할 수 없으므로, 따로 test에서 성능을 확인해야 한다. 쓸 수 있는 예측을 막으려는 구분이 아니라, 무엇을 근거로 선택하는지 분명히 하기 위한 구분이다.
최종 두 후보의 구성과 조합식
첫 번째 최종 후보 v229는 공개 Helios 예측 H가 중심이다. 여기에 내가 학습한 N-mm12의 fold 모델 다섯 개와 80-slice V3-mm12의 다섯 개를 더했다. 소견별 백분위 순위 변환을 $R$로 쓰면, 이 열 개 모델은 각자 순위로 바꾼 뒤 평균하고 H와 섞을 때 다시 순위로 바꾼다.
\[\begin{aligned} A_{10}&=\frac{1}{10}\sum_{m=1}^{10}R(p_m),\\ C2_{0.25}&=0.75\,R(H)+0.25\,R(A_{10}). \end{aligned}\]먼저 순위로 바꾸면 어느 모델의 예측 확률이 더 넓게 분포한다는 이유만으로 평균을 지배하지는 않는다. 그렇다고 모든 계산 순서가 같아지는 것은 아니다. 한 모델군의 확률을 평균한 뒤 순위로 바꾸는 것과, 개별 모델의 순위를 평균하는 것은 검사의 순서를 다르게 만들 수 있다. 바깥에서 한 번 더 순위를 매기는 것은 합쳐진 자체 예측과 H의 척도를 맞춘다.
H에 호환되는 clean OOF가 없었으므로 v229 전체는 final-only다. 구성 요소인 N과 V3까지 clean하지 않게 되는 것은 아니다. N/V3의 held-out 예측은 분석할 수 있지만, 그 평가로 H가 대부분을 차지하는 최종 조합을 검증했다고 말할 수는 없다.
두 번째 최종 후보 v236, 즉 K-W2는 clean 모델군 세 종류의 확률을 섞는다.
\[\begin{aligned} K\text{-}W2&=0.50\,B_{10}+0.25\,N+0.25\,V3,\\ B_q&=\sigma\!\left(\frac{1}{q}\sum_{m=1}^{q}z_m\right). \end{aligned}\]$z_m$은 S6F checkpoint의 logit이다. $B_{10}$은 seed 두 개에서 다섯 fold씩 학습한 열 개 모델을 합친다. N과 V3는 각각 다섯 fold 모델의 확률 평균이다. 이전 K-W, v231은 바깥 가중치를 그대로 두고 $B_5$를 사용했다. S6F seed를 하나 더해 모델군 내부의 추정을 바꿨지만, 최종 비중은 여전히 절반이다. 이 식은 hidden test 추론에 쓰는 계산이다. 로컬 OOF의 검사 하나를 평가할 때는 각 seed에서 해당 검사를 학습하지 않은 checkpoint만 사용하므로, S6F 내부에서 $q=1$과 $q=2$를 비교한다.
이처럼 안팎의 계산을 구분해야 한다. Logit 평균에 sigmoid를 적용한 값은 확률 평균과 다르다. 최종 조합의 checkpoint 스무 개를 같은 가중치로 평균해도 다른 예측이 된다. Checkpoint 수는 계산량을 설명하지만 최종 예측에 주는 비중을 곧바로 뜻하지 않는다. 정확히 어떤 연산을 했는지 알아야 K-W와 K-W2의 비교도 해석할 수 있다.
| 비교 | v229 | v236, K-W2 |
|---|---|---|
| Public | 0.957 | 0.953 |
| 구성 | H 0.75 + N/V3 순위 평균 0.25 | S6F 두 seed 0.50 + N 0.25 + V3 0.25 |
| 로컬 평가 | 전체 조합은 final-only | 구성 모델군의 완전한 clean OOF |
| 가까운 대안 | v227, 자체 비중 0.50, Public 0.956 | v231, S6F 한 seed, Public 0.954 |
현재 고른 두 후보는 H 중심의 순위 조합과 S6F 비중이 큰 clean 확률 조합이다. 둘 다 N과 V3를 쓰므로 구성이 다르다는 이유만으로 서로 독립적인 예측이 되는 것은 아니다.
학습량 확대와 seed 추가의 비교
다음 학습에 시간을 어디에 쓸지도 결정해야 했다. S6F는 Public에서 이미 가장 강한 clean 모델군이었지만, 16-epoch 일정을 늘려 더 학습할 여지가 있을 수 있었다. Seed 추가는 목적이 다르다. 학습 시간을 늘려 표현을 개선하는 대신, 잘 작동한 학습 방식을 반복한 뒤 서로 달라진 예측을 합치는 방법이다.
긴 학습의 가설은 새로 초기화한 32-epoch S6F pilot으로 시험했다. Cosine과 warmup schedule 전체를 늘렸으며, 16-epoch checkpoint를 이어서 열여섯 epoch 더 학습한 실험은 아니다. 다섯 fold 전체에는 약 18.5 GPU-hours를 계획했다. 첫 fold 약 3.7시간을 마치면 나머지 약 14.8시간이 남는 구조였다. 영상과 학습 환경이 준비된 GPU 한 대의 예상 학습 시간으로, 숨겨진 test 추론의 9시간 한도와는 다른 비용이다.
Pilot에서는 단독 점수와 ensemble에 넣었을 때의 효과가 달랐다. 조건을 맞춘 non-gold 검사 870건의 결과는 다음과 같다.
| Fold-0 교체, e32 − e16 | Primary 차이 | 저장된 report-group 구간 |
|---|---|---|
| S6F 단독 | −0.00622 | [−0.01117, −0.00140] |
| 고정 K-W 안의 S6F 교체 | +0.00062 | [−0.00165, +0.00267] |
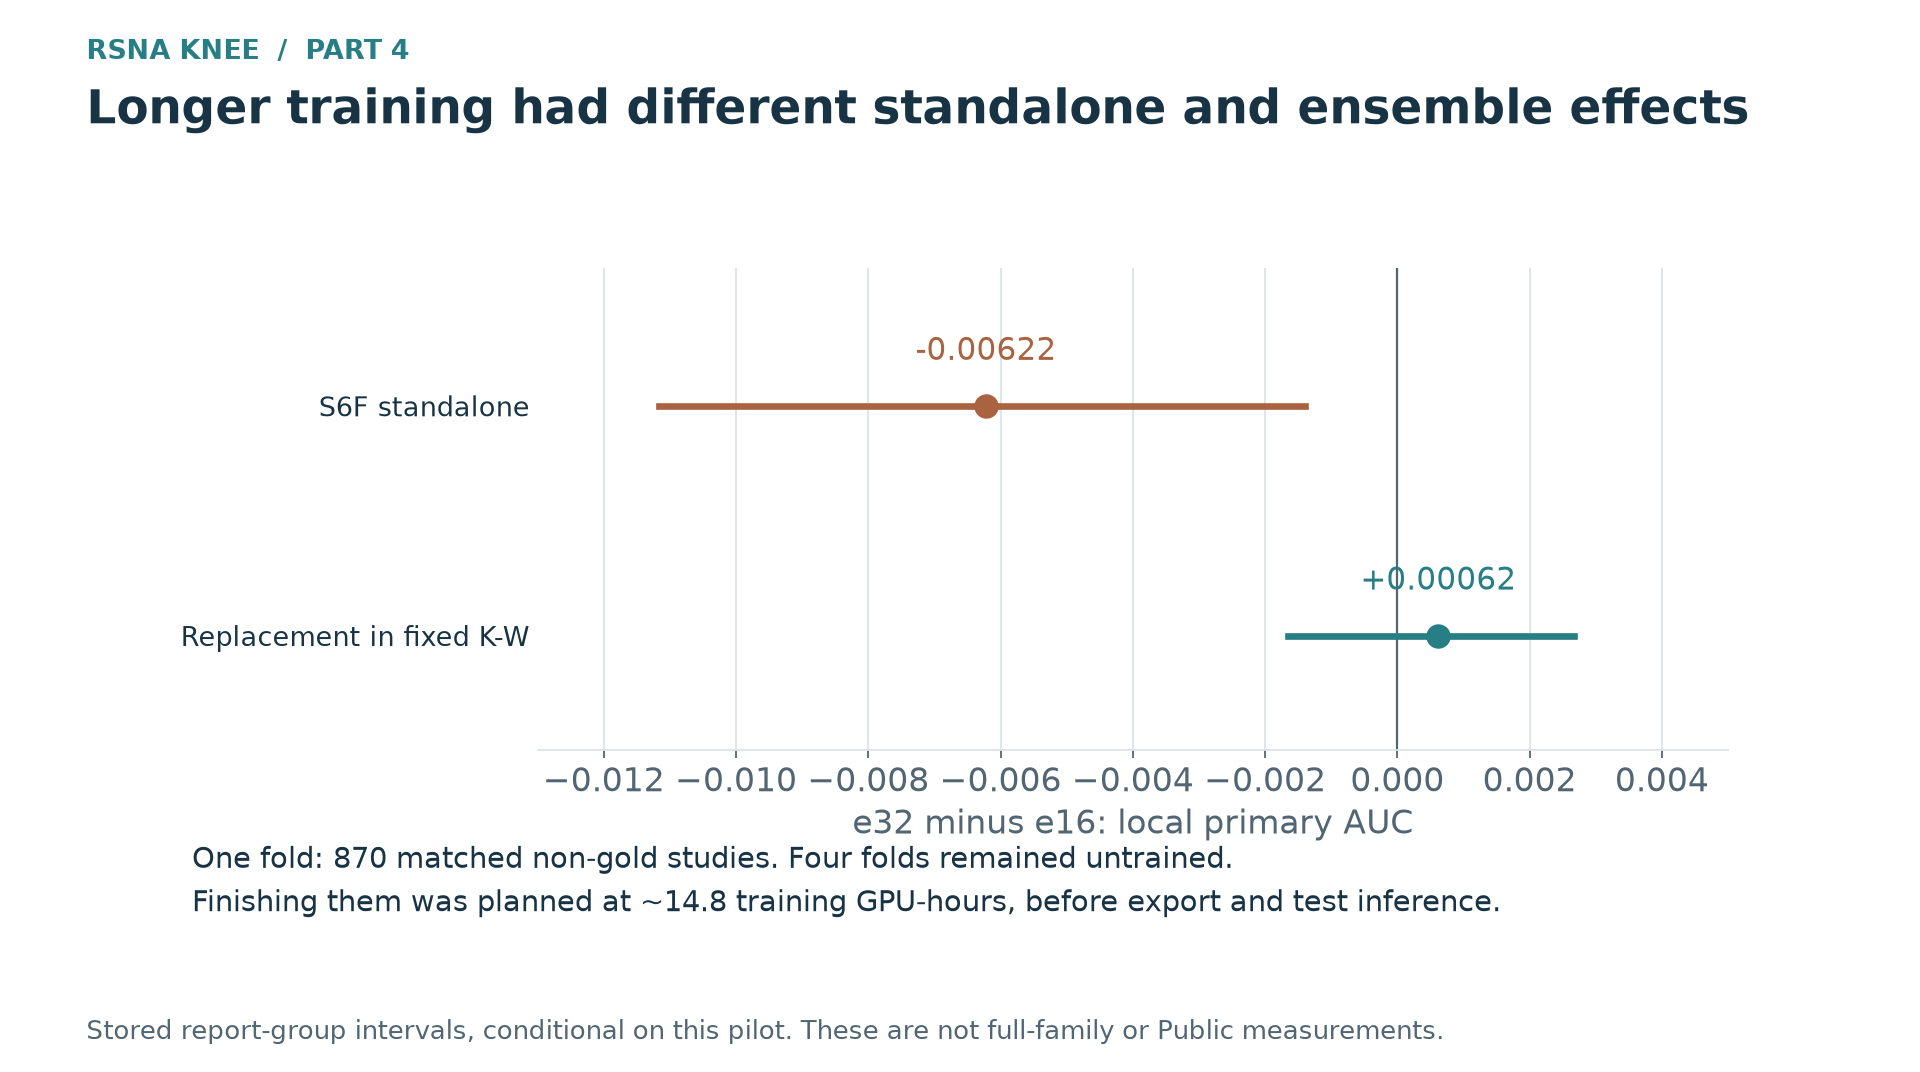 그림 2. 더 오래 학습한 S6F는 단독 점수가 낮아졌지만 고정 K-W 안에서 교체한 효과는 불확실했다. 두 비교 모두 같은 fold-0 검사 870건을 사용했다. 구간은 report-group에 따른 조건부 변동을 나타내며, 나머지 네 fold는 학습하지 않았다.
단독에서는 열두 소견 중 아홉 점수가 내려갔다. 그래도 K-W 안의 S6F를 바꾸면 점 추정은 작은 양수였고 구간은 0을 포함했다. 단독 점수가 낮은 모델이라도 ensemble이 틀리던 순서를 바로잡을 수 있다. 이 pilot만으로 조합에서도 도움이 되지 않을 것이라고 단정할 수는 없다.
남은 판단은 계획상 14.8시간을 더 쓸지였다. 모델군을 완성하면 첫 fold의 결과가 다른 fold에서도 반복되는지, 전체 ensemble에서는 도움이 되는지 확인할 수 있다. 대신 같은 머신에서 예정한 multimodal 라벨 S6F와 기존 recipe의 추가 seed는 약 열다섯 시간씩 늦어진다. 이 모델들도 export와 평가를 거쳐 전체 test 추론을 마쳐야 최종 선택에 쓸 수 있다. 학습만 마감에 맞춰 끝내는 것과 결과를 비교할 시간을 확보하는 것은 다르다.
나는 e32 pilot을 중단하고 다른 학습을 앞당겼다. K-W에서의 이득은 불확실했고, 단독 및 소견별 결과는 나빠졌다. 부분 예측과 checkpoint는 보존했지만 완전한 e32 모델군이나 Public 결과는 없다. 따라서 전체 모델군을 완성했을 때도 나빴을 것이라고 단정할 수는 없다. S6F가 이미 수렴했다거나 다른 긴 schedule도 실패한다는 결론 역시 아니다.
S6F 두 seed의 기존 결과는 추가 seed 쪽을 선택할 근거가 됐다. 하지만 두 실험의 학습 시간당 효과를 비교할 수는 없다. K-W에서의 약 +0.000945는 전체 OOF 결과이고 e32는 한 fold의 결과다. 이를 각각 학습 시간으로 나눠도 조건을 맞춘 비교가 되지는 않는다. 이번에는 완전한 OOF에서 좋아진 구성을 먼저 보강했다. 긴 학습은 미뤄 두지만, 이 pilot을 모든 학습에 적용할 early-stopping 규칙으로 삼지는 않는다.
OOF 조합 선택과 최종 추론 준비
이미 확보한 모델들을 다시 조합해 간결한 K-W보다 더 강한 예측을 만들 수 있는지도 확인했다. 기존 조합에 하나씩 추가하는 방식으로만 비교하면 교체나 삭제가 더 나은 경우를 놓친다. 그래서 전체 OOF에서 모델군을 추가·삭제·교체하며 탐색했다. 기존 조합은 비교 기준으로만 쓰고, 반드시 포함하도록 강제하지 않았다.
10월 19일 조합 탐색에서는 non-gold 검사 4,349건에 두 조건을 비교했다. P540은 S6F 한 seed와 계획상 540분 한도를 사용했다. PUNC는 S6F 두 seed의 예측을 사용하면서 한도를 사실상 없앴다. 둘 다 모델군 146개를 대상으로 Opus/GPT primary를 최적화했다. 확률을 평균하는 연산과 beam width 16, 최대 열 차례의 탐색, outer fold마다 최대 50,000조합을 사용했다. 넓게 탐색했지만 가능한 모든 ensemble 연산과 가중치의 최적해를 찾은 것은 아니다.
여기서는 선택 절차와 최종적으로 고정할 조합을 구분해야 한다. Fold $k$마다 나머지 fold로 조합을 고른 뒤 $k$에서 평가했다.
\[S_{-k}=\operatorname{Select}(D_{-k}), \qquad \widehat A_{\mathrm{select}}=\frac1K\sum_k A_r(D_k,p_{S_{-k}}).\]모든 자료로 최종 조합을 고르면 별도로 $S_{\mathrm{all}}$을 얻는다. 선택에 쓴 자료에서 계산한 고정 조합의 점수를 위 절차의 held-out 추정치와 같은 것으로 볼 수는 없다. 이번에는 추가할 네 번째 모델군만 고르는 간단한 절차도 비교했다. 이 절차는 fold마다 다른 GPT 라벨 모델을 골랐다. 그 뒤 추가할 모델군 하나를 $U$로 고정하고 $C1U=0.8\,K\text{-}W+0.2\,U$로 섞었다. C1U는 추가 모델 단독이 아니라 이 네 모델군의 조합이다. 선택 후 계산한 점수는 그 후보를 새 자료에서 검증한 결과가 아니었다.
| 같은 검사와 primary에서의 비교 | Pooled AUC | Fold별 AUC 평균 |
|---|---|---|
| 고정 K-W | 0.901375 | 0.901405 |
| 최선의 네 번째 모델군 선택 절차 | 0.902831 | 0.902951 |
| P540 c1 절차 | 0.902772 | 0.903094 |
| PUNC c1 절차 | 0.902750 | 0.903067 |
| 탐색 후 선택한 고정 C1U | 0.903310 | 0.903372 |
더 넓게 탐색했지만, 네 번째 모델군만 고르는 간단한 절차보다 primary가 뚜렷하게 좋아지지는 않았다. 반면 전체 자료로 고른 조합은 훨씬 무거웠다. P540은 일곱 모델군에 계획 535.3분, PUNC는 열한 모델군에 1009.7분이었다. P540은 별도로 영상을 decoding하는 그룹까지 늘면서 시간 여유가 거의 없었다. 로컬 점수가 비슷해도 구현 준비와 실행 비용은 크게 달랐다.
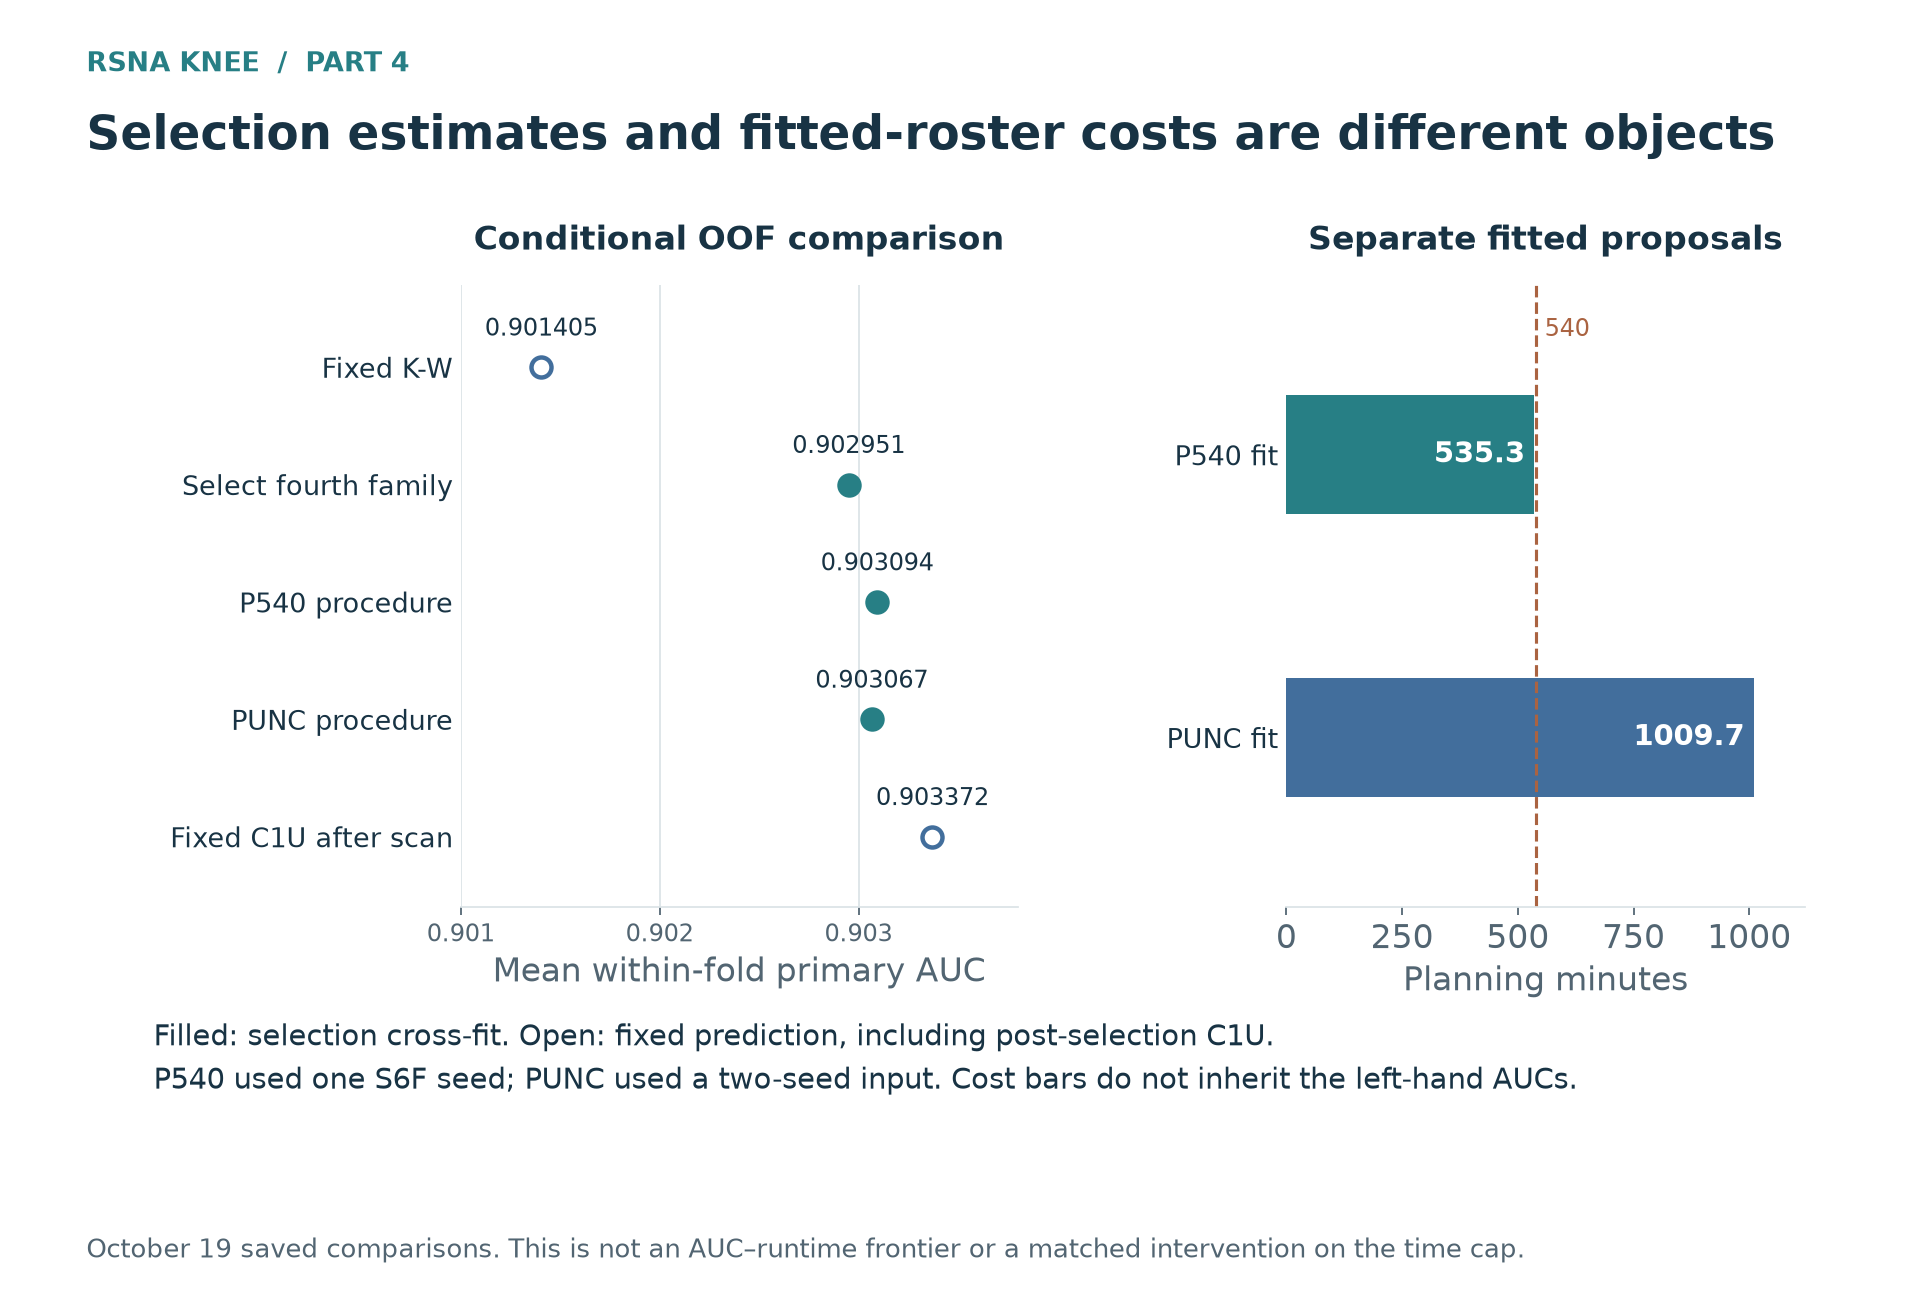 그림 3. 선택 절차의 점수와 전체 자료로 고른 조합의 계획 시간을 구분해 표시했다. P540과 PUNC는 S6F 입력도 다르므로 점수 차이를 시간 한도 해제의 효과로만 볼 수 없다. 절차 평가에서 얻은 AUC를 고정 조합의 검증 점수로 대신 쓸 수도 없다.
이 결과만 보고 시간 한도가 성능에 영향을 주지 않았다고 결론 내릴 수는 없다. 한도에 따라 선택한 조합과 비용이 달라졌고, S6F 구성도 함께 바뀌었다. 확인한 것은 이번 탐색에서 찾은 큰 조합이 primary에서 유용한 추가 이득을 보이지 않았다는 점이다. 목적함수나 집계 연산, 탐색 방법을 바꾸면 결과가 다를 수 있다. 지금 비싼 조합 하나의 구현을 미룰 근거는 되지만, OOF bank에서 더 나은 조합을 찾을 수 없다는 뜻은 아니다.
C1U는 평가 라벨에 따라서도 결과가 갈렸다. Opus는 약 +0.001910, DeepSeek는 +0.001773이었지만 Gemini3f는 −0.001235, dread는 −0.001779였다. Dread에서는 열두 소견 모두 내려갔다. 같은 예측을 서로 다른 기준으로 평가했을 때 방향이 반대였고, 이 기준들은 독립적인 투표도 아니다. Primary에는 추가 모델군이 학습한 GPT 라벨을 기준으로 한 평가도 포함됐다. 가장 좋은 숫자만 골라 불리한 결과를 무시할 수는 없었다.
OOF도 이미 여러 선택에 써 온 자료다. Selection cross-fitting에서는 outer split마다 base model 전체를 다시 학습하지 않았고, 저장된 bootstrap 구간에도 recipe·seed·후보 선택에 따른 변동이 모두 들어 있지는 않다. 이 한계를 감안하면 한도에 가까운 큰 조합을 바로 구현하기보다, K-W를 유지하면서 고정한 C1U 하나를 Public에서 비교하는 편이 낫다고 판단했다.
이후 모델군 155개를 넣어 다시 탐색했을 때도 비슷한 문제가 있었다. 새 seed 때문에 추천 조합은 달라졌지만, 전체 자료로 고른 533.8분 조합은 아직 구현과 실행 확인이 필요하다. S6F 세 그룹에 같은 확률 가중치를 줘 S6F가 전체의 3/5를 차지하는 구성이다. 이를 하나의 logit 평균 묶음으로 바꾸면 예측 자체가 달라진다. Fold와 소견별 결과도 엇갈려, 준비된 비교보다 먼저 실행할 만큼 근거가 충분하지는 않다. 모델군이 늘면 검토할 조합은 많아지지만, 새 모델을 모든 최종 예측에 넣어야 하는 것은 아니다.
Public 점수와 혼합 비중 비교
S6F, N-mm12, V3-mm12를 같은 비중으로 섞으면 0.953이었다. S6F의 확률 가중치를 절반으로 늘린 K-W는 0.954를 받았다. 이 비교에서는 모델군을 똑같은 비중으로 쓰기보다, 더 강한 S6F에 무게를 두는 편이 나았다.
H와 자체 예측의 혼합 비중도 비교했다. 자체 비중 0.50의 v227은 0.956, 0.25의 v229는 0.957, H 단독은 0.958이었다. 자체 비중을 높일수록 Public은 낮아졌다. 적어도 이 결과에서는 내 예측을 섞어 H를 개선하지 못했다.
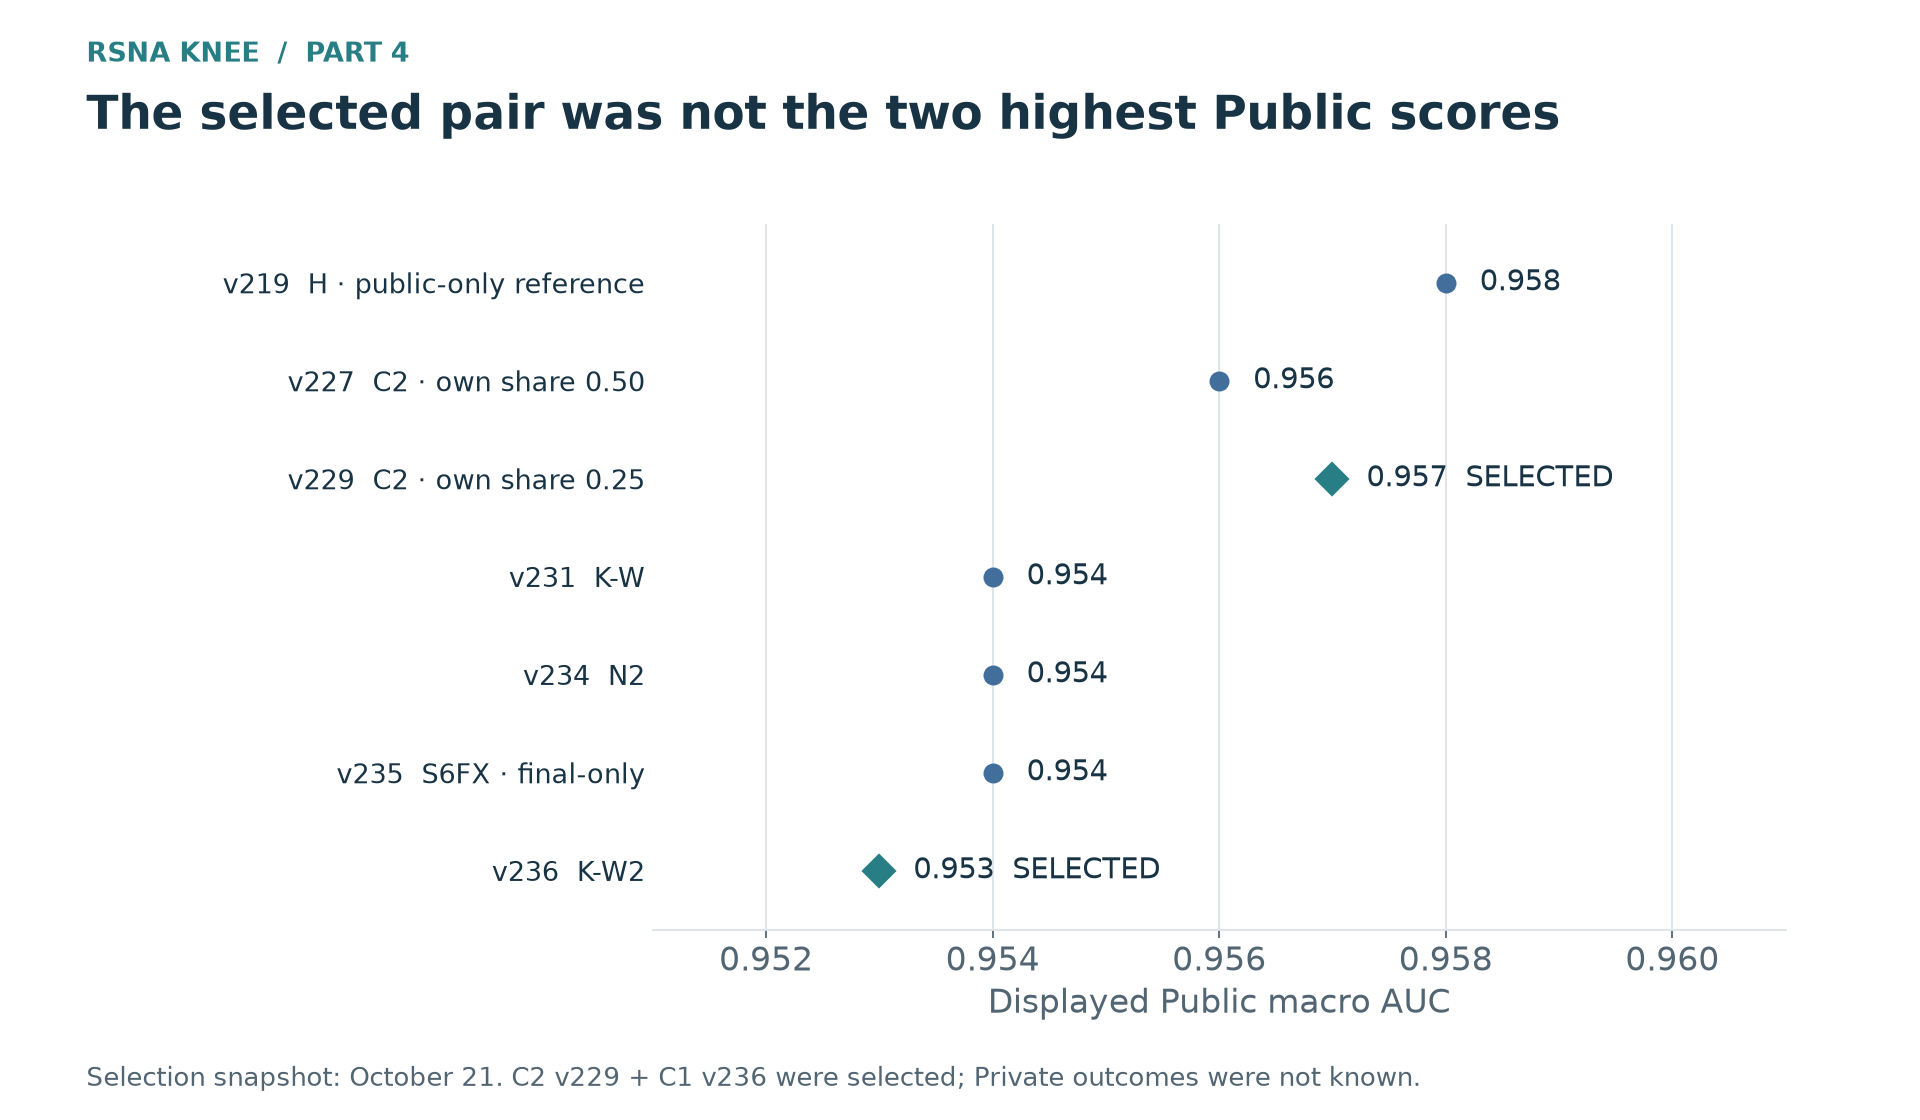 그림 4. H, 최종 선택한 v229·v236, 비교 가능한 다른 제출의 Public 결과. Timeout에는 AUC가 없으므로 낮은 품질의 예측처럼 그리지 않았다.
전체 혼합은 clean OOF로 평가할 수 없으므로, 비중 차이가 큰 몇 가지 조합을 Public에서 비교했다. 하지만 그 사이를 작은 간격으로 계속 시험하면 같은 Public 검사들에 맞춰 비중을 고르게 된다. 나는 0.25를 0.50보다 조금 더 선호하지만, 표시 점수 차이만으로 최적 비중을 찾았다고 생각하지는 않는다. 가장 높은 Public을 택한다면 H 단독이 여전히 유력하다.
자체 조합의 변형에서는 모델을 더하는 것과 비중을 바꾸는 것이 함께 일어나기도 했다.
| 후보 | K-W에서 바꾼 점 | Public |
|---|---|---|
| C1U, v233 | GPT 라벨 모델군 추가와 비중 변경 | 0.951 |
| N2, v234 | N 두 seed 사용, 모델 구성과 비중 변경 | 0.954 |
| S6FX, v235 | S6F 내부에 전체 데이터 학습 모델 추가, final-only | 0.954 |
| K-W2, v236 | S6F 두 seed 사용, 모델군 비중 유지 | 0.953 |
C1U는 OOF 분석에서 기대한 개선을 Public에서 보여 주지 못했다. 추가 모델군의 clean 예측은 다른 조합에서도 쓸 수 있도록 남겨 뒀다. N2의 Public이 같다고 seed 추가 효과가 없었다고 단정할 수는 없다. N/V3 비중도 함께 바뀌었기 때문이다. S6FX에는 전체 데이터로 학습한 모델이 들어가므로 최종 예측에는 쓸 수 있어도 전체 조합의 로컬 점수를 clean 검증 결과로 볼 수는 없다. K-W2는 N과 V3, 바깥 가중치를 그대로 두어 S6F seed 추가를 가장 가깝게 비교할 수 있다.
모델 추가와 비중 변경이 함께 일어난 비교에서는 결과를 한 요소의 효과로 떼어 낼 수 없다. 새 모델군을 얻었다고 모두 넣은 큰 조합을 고를 이유도 없다.
K-W2의 로컬·Public 평가 차이
K-W2는 K-W와 조건을 맞춰 비교한 clean primary가 약 0.00095 높았다. 저장된 조건부 구간은 약 +0.00055에서 +0.00136이었다. 다섯 fold의 차이가 모두 양수였고, 평가에 사용할 수 있었던 다른 판독문 기반 기준에서도 양수였다. 다만 네 소견에서는 작은 손실이 있었다. Public은 반대로 0.954에서 0.953으로 내려갔다.
K-W2의 로컬 결과를 중요하게 본 이유는 나머지 예측을 고정한 비교이기 때문이다. S6F만 한 seed에서 두 seed로 바꿨고, 개선이 한 fold에 몰리지 않았다. 여러 기준 라벨에서도 좋아졌지만, 이 기준들은 같은 판독문과 관련된 가정을 공유한다. 관측한 검사에서 개선이 일관됐다는 뜻으로 받아들여야지, 독립적인 전문가 검증이 여러 번 이뤄진 것으로 볼 수는 없다.
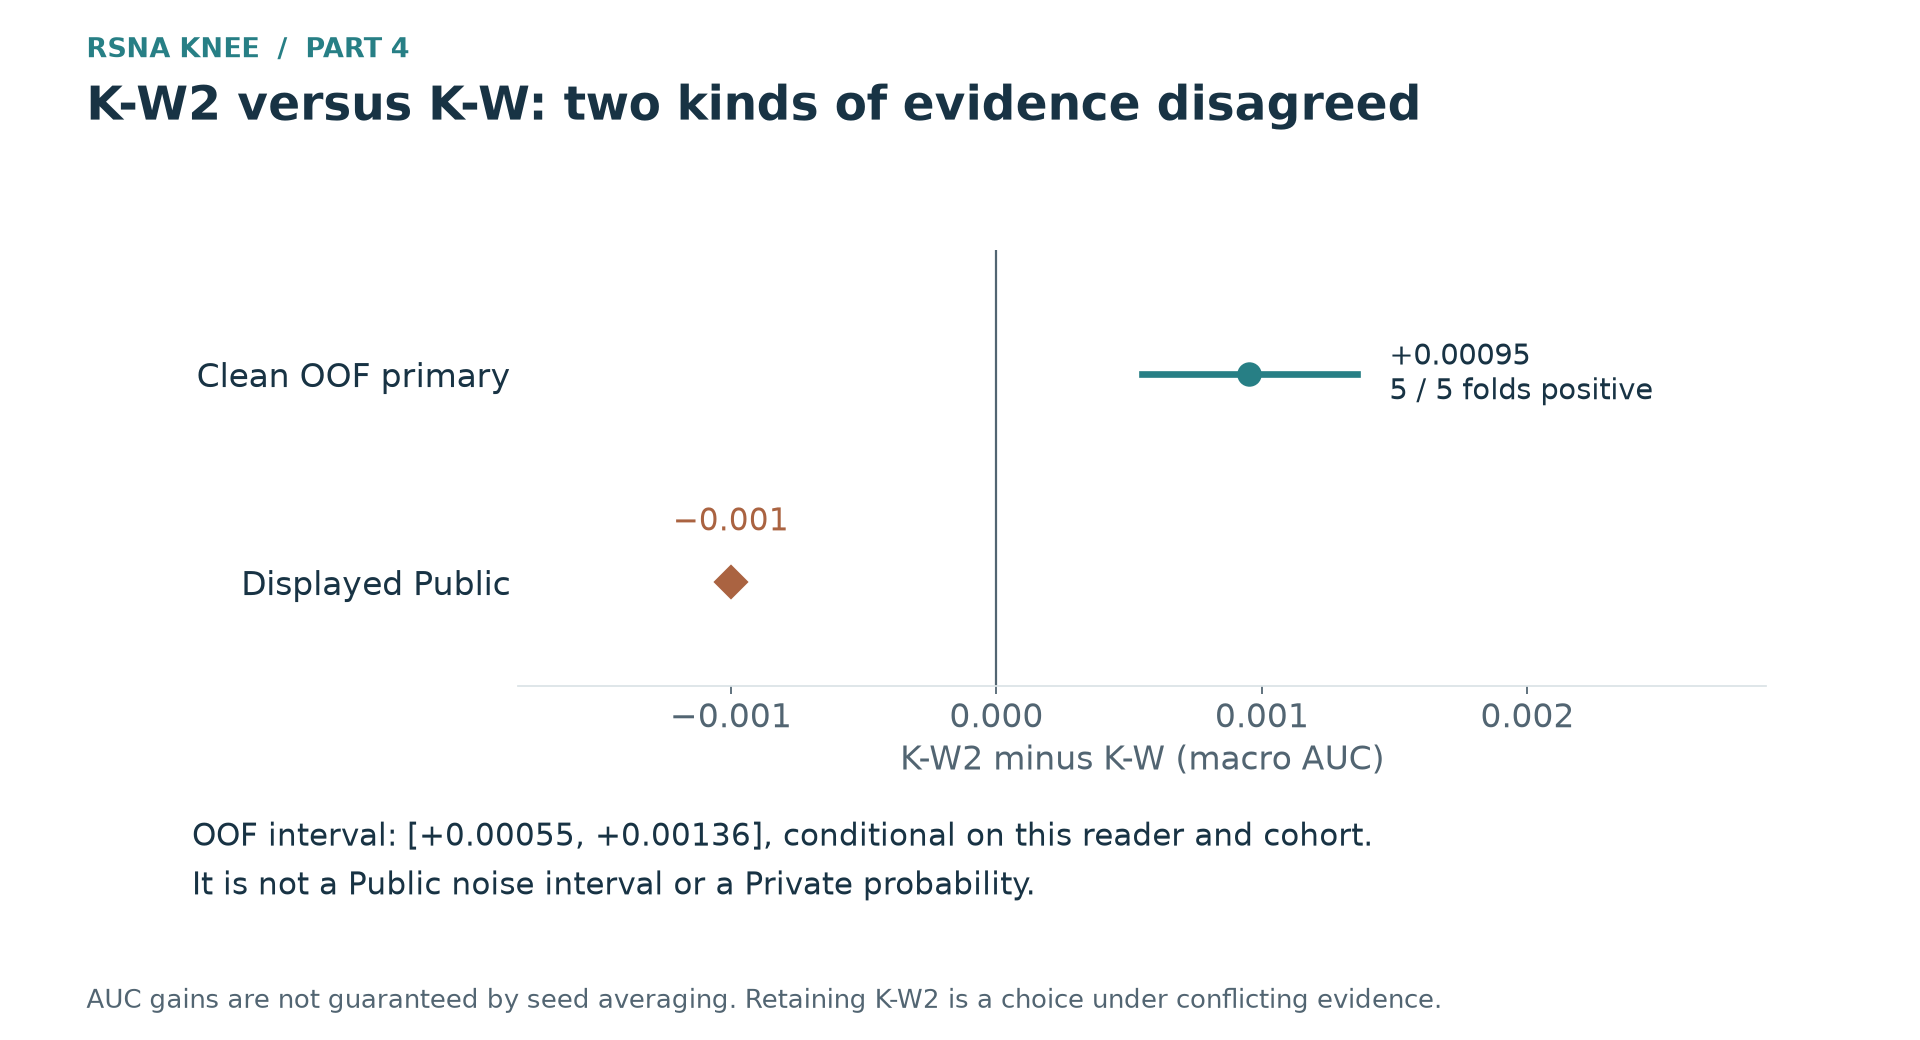 그림 5. K-W2에서 K-W를 뺀 차이. 로컬 primary는 약 +0.00095와 저장된 조건부 구간을 보이지만, 표시된 Public 차이는 −0.001이다. 이 구간은 로컬 비교에 관한 값이며 Public 변동이나 Private 역전 확률을 추정하지 않는다.
Seed를 더했는데 왜 한쪽에서는 좋아지고 다른 쪽에서는 나빠질까? 확률 조합의 각 구성 요소를 $m$으로 나타내면 양성과 음성 사례 한 쌍의 margin은 다음과 같다.
\[D_{ab}=\sum_m w_m\bigl[p_m(x_a^+)-p_m(x_b^-)\bigr].\]AUC는 이 margin이 양수인지를 세고, 동점에는 절반의 점수를 준다. 예측을 더하면 맞는 순서를 강화하거나 틀린 순서를 바로잡을 수 있지만, 간신히 맞았던 순서를 뒤집을 수도 있다. 예측의 변동을 줄이는 일과 필요한 모든 순서를 개선하는 일은 같은 목적이 아니다. S6F는 내부에서 logit을 평균하므로 계산식은 달라지지만 쌍별 순서라는 문제는 그대로다. 쉽게 구별하는 사례의 일치보다 순위가 뒤집힐 경계에 있는 사례가 중요하다.
전체 예측의 상관계수만으로 충분하지 않은 이유도 같다. 쉬운 사례 수천 개에서 비슷하게 예측해 높은 상관을 보이면서, AUC 차이를 결정하는 적은 수의 쌍에서는 달라질 수 있다. 기준 라벨을 바꾸면 무엇이 양성인지 달라지고, test 분포가 바뀌면 어려운 사례의 구성도 달라진다. 어느 한쪽을 잘못 측정하지 않았어도 평가 자료가 달라지면 seed를 추가한 효과는 달라질 수 있다.
대형 조합의 실행 한계
이미 학습한 모델로 더 큰 조합도 시험했다. S6F 두 seed에 N의 두 번째 seed를 함께 쓰거나, S6F를 세 seed로 늘리거나, 전체 데이터 학습 모델 X를 S6F의 logit 평균에 넣었다. 바뀌는 모델과 비중이 다르므로 각각 구분해 비교했다.
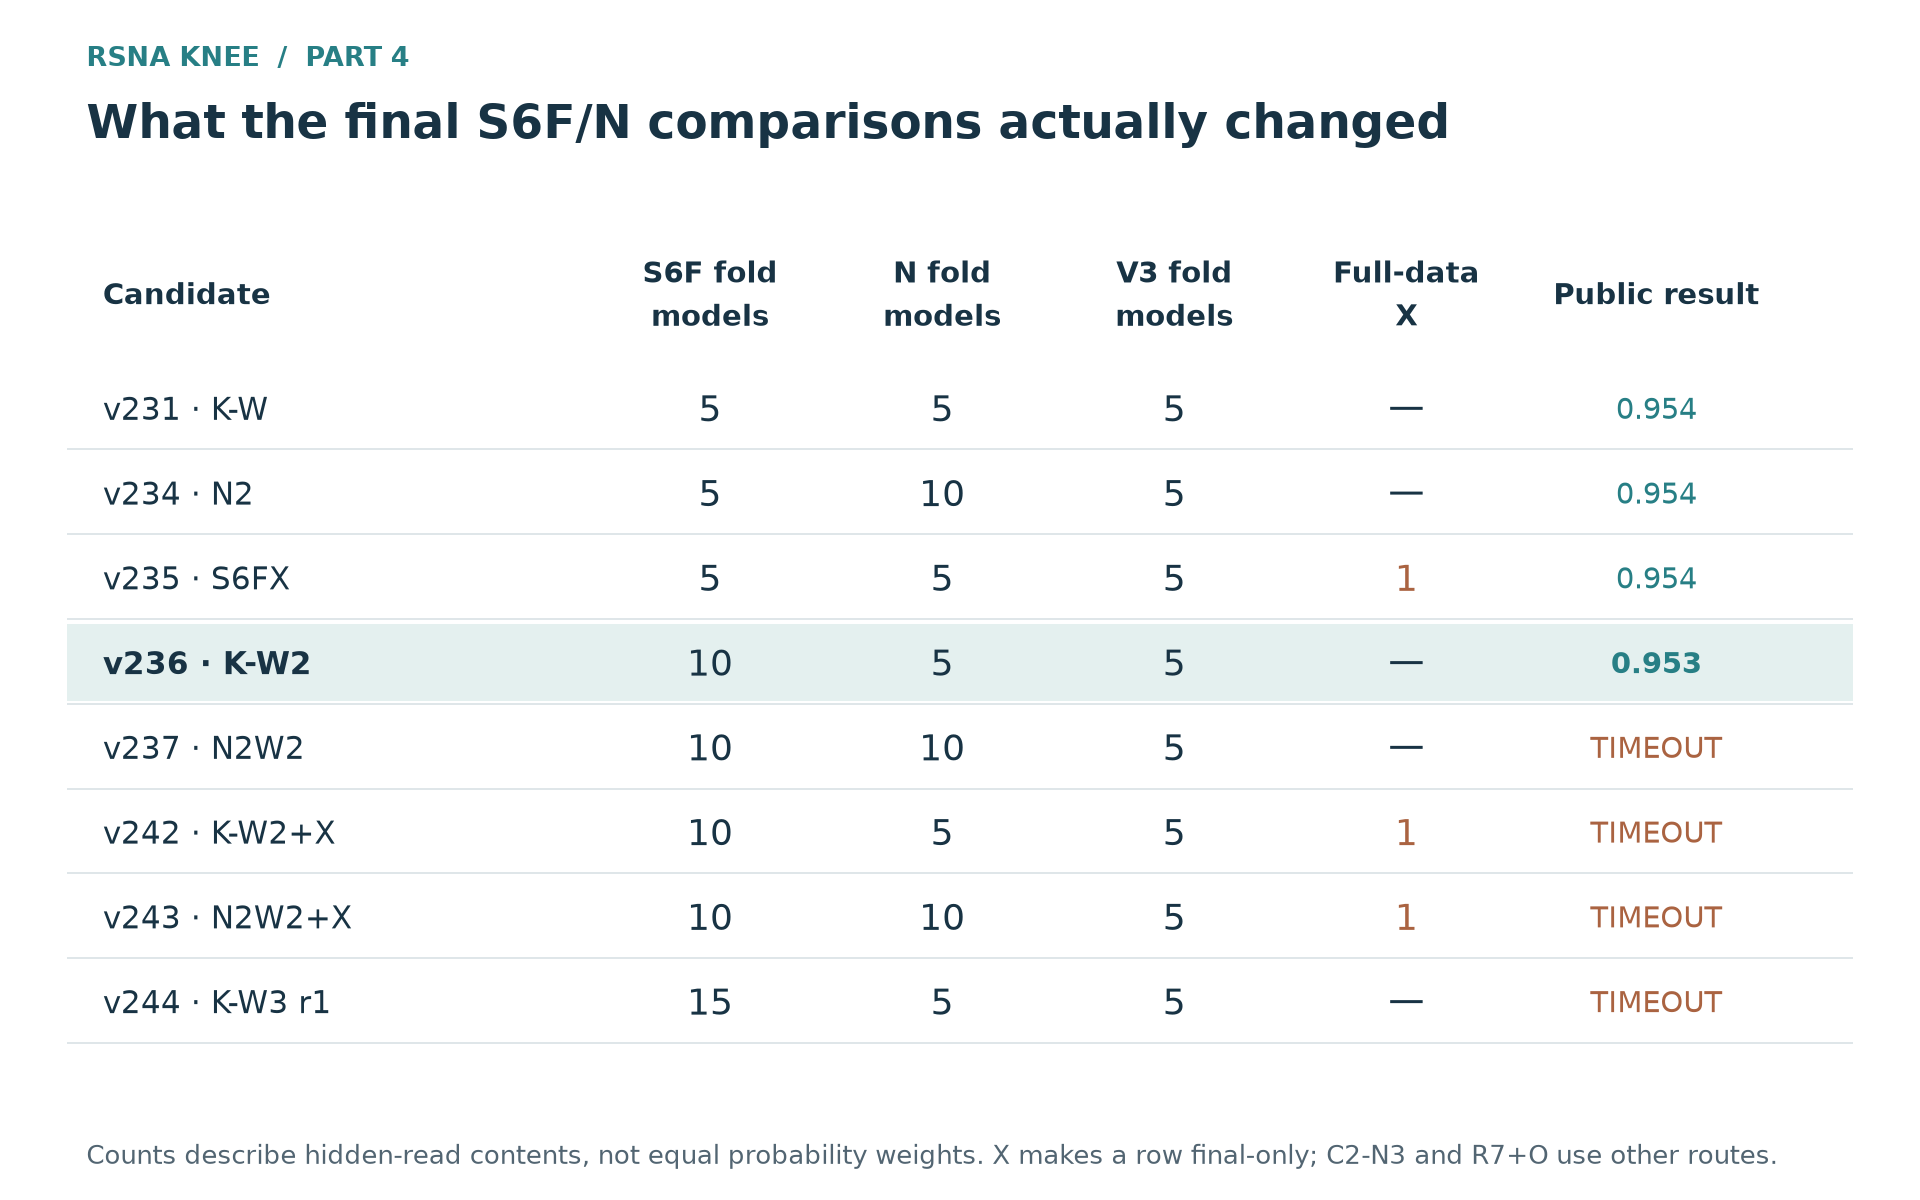 그림 6. 관련 S6F·N·V3 조합의 fold checkpoint 수. X는 전체 데이터로 학습한 모델로 따로 표시했다. 모델 수가 최종 확률 가중치는 아니며 S6F의 바깥 비중은 0.5다. X를 포함한 조합은 final-only다. C2-N3와 R7+O는 다른 방식으로 계산한다.
N2W2는 S6F 두 seed와 N 두 seed를 결합하면서 모델뿐 아니라 N/V3 비중도 바꿨다. K-W3는 S6F의 바깥 비중을 유지하고 세 번째 seed를 더했다. S6FX에서 X는 S6 모델 여섯 개 중 하나였지만, K-W2+X에서는 열한 개 중 하나였다. 따라서 앞 조합에서 좋아졌더라도 뒤 조합의 효과를 그대로 예측할 수 없다. 내부 가중치가 달라졌기 때문이다. C2-N3는 v229의 자체 순위 평균을 열 개 모델에서 열다섯 개로 늘리되 바깥 비중은 고정했다.
이 여섯 번의 큰 조합은 모두 정해진 구성을 끝까지 계산하거나 실패하도록 실행했고, 점수 없이 끝났다.
| 후보 | 질문 | 결과 |
|---|---|---|
| v237, N2W2 | S6F 두 seed와 N 두 seed를 함께 사용 | Timeout, AUC 없음 |
| v238, C2-N3 | H 옆에 자체 모델 열다섯 개의 순위 평균 사용 | Timeout, AUC 없음 |
| v240, R7+O | 공개 R7과 더 큰 final-only 자체 조합 사용 | Timeout, AUC 없음 |
| v242, K-W2+X | S6F 두 seed 내부에 전체 데이터 학습 모델 X 추가 | Timeout, AUC 없음 |
| v243, N2W2+X | 더 큰 S6F/N 조합에 X 추가 | Timeout, AUC 없음 |
| v244 retry 1, K-W3 | 같은 모델군 비중에서 S6F 세 번째 seed 추가 | Timeout, AUC 없음 |
처음 v244는 플랫폼 시스템 오류로 끝났고, 재시도에서도 timeout이 났다. 지금 확인할 수 있는 것은 제출한 구현이 허용 시간 안에 끝나지 않았다는 점이다. 점수가 없으므로 모델 아이디어가 약했다고 평가할 수는 없다. 추론 단계별 시간도 충분히 확보하지 못해, 얼마나 더 시간이 필요했는지나 어느 단계에서 막혔는지는 알 수 없다.
계획 시간만으로 성공 여부를 확정하기도 어렵다. 영상 decoding을 공유하고 두 GPU에 나눠 실행하면 전체 시간은 개별 시간의 합과 달라진다. 모델 수를 늘리면 메모리 사용량과 작업 배치도 바뀐다. 작은 조합이 성공하고 조금 큰 조합이 실패했다고, 모든 조합에 적용할 안전한 시간 경계를 얻은 것은 아니다. 성공한 후보는 최종 선택에 쓸 수 있지만 이 여섯 후보는 아직 쓸 수 없다.
마감 전에는 추론을 끝내는 데서 그치지 않고 결과를 검토할 시간도 있어야 한다. 준비, 전체 추론, 플랫폼 대기와 결과 확인까지 마쳐야 최종 선택을 바꿀 수 있다. 구현을 고치거나 실행에 관한 새 근거를 얻지 못한 채 timeout을 반복하면 남은 기회만 줄어든다. 현재는 이미 점수를 받은 후보를 유지한다.
v229·v236의 선택 근거
V229는 H에 자체 예측을 조금 섞은 후보이고, V236은 가장 강한 clean 모델군에 무게를 둔 후보다. V236은 Public이 더 낮지만 조건을 맞춘 로컬 비교에서는 좋았다. 이를 두 번째로 남기려면 다른 구성이라는 사실을 넘어, Private에서 첫 번째보다 나을 수 있는지를 생각해야 한다. N/V3와 관련 학습 데이터를 공유하므로 독립적인 예측 두 개를 확보한 것은 아니다.
처음에는 K-W2의 Public이 0.953이면 K-W를 유지하려 했다. 하지만 조건을 맞춘 clean 비교에서 폭넓게 좋아진 결과를 다시 살펴본 뒤, Public이 낮아도 v236을 남기는 쪽으로 판단을 바꿨다. 로컬 AUC 향상과 Public 하락을 맞바꿔 계산할 근거는 없다. 두 수치를 임의로 평균하면 판단에 필요한 가정을 숫자 뒤에 숨기게 된다.
다른 선택도 가능하다. H 단독은 Public이 0.958로 가장 높고, V227은 자체 비중을 더 크게 유지하면서 0.956을 받았다. Clean 모델로 만든 V231도 합리적인 대안이다. Public은 0.954로 더 높다. V236을 고르면 로컬에서 좋았던 변화가 Private에서는 도움이 되지 않을 위험을 감수한다. V231을 고르면 로컬에서 일관되게 개선된 변화를 포기한다. 지금 가진 근거만으로 Private에서 어느 쪽이 나을지는 알 수 없다.
나는 v229와 v236을 남겨 두기로 했다. 선택하지 않은 모델군의 완전한 clean 예측도 보존한다. 다른 조합을 비교하거나 이번 결과를 분석할 때 쓸 수 있기 때문이다. 현재 선택은 낮은 Public을 감수하면서, 구성의 차이와 조건을 맞춘 로컬 결과에 무게를 둔 결정이다. Private에서 어느 쪽이 더 나을지는 결과가 나와야 안다.
이전 글: Part 3: 학습 신호와 Public 성능