Kaggriculture RL 1 — 벤치마크에서 전략 개선으로
Kaggriculture의 실제 학습 실패를 선택지·실행기·평가 문제로 나누고, BC·PPO·계획 탐색이 전략을 바꾸는 원리와 필요한 설계를 연결한다.
Kaggriculture에서 가장 답답했던 순간은 벤치마크 결과를 받은 다음이었다. 어떤 상대에게 지는지, 현금이 언제 부족해지는지, 어떤 작물의 수입이 적은지는 알 수 있었다. 기존 전략을 바꾸려는 생각도 계속했다. 하지만 무엇을 어떻게 바꿔야 더 나은 전략이 되는지는 막막했다. 더 많은 경기를 돌릴 수 있어도, 그 계산으로 어떤 변경을 찾아낼지 정하지 못했다.
첫 작업 노트에서는 농장 경제를 손으로 설계하고 공개 경기의 행동 기록을 분석했다. 대회가 끝난 뒤 참가자들의 writeup과 공개 코드를 읽으면서, 더 나은 전략을 만드는 방법이 눈에 들어오기 시작했다. 사람이 행동을 하나씩 고친 팀도 있었지만, 강자의 플레이를 배우거나, 새 대전의 결과로 행동 확률을 바꾸거나, 노동·토지·작물을 함께 바꾼 계획을 계산으로 찾은 팀도 있었다.
나도 학습을 했고, 전체 계획을 만들려고 시도했으며, 실전 패배에서 유용한 규칙을 찾아냈다. 부족했던 것은 그다음으로 이어지는 과정이었다. 준비한 대안 중에 정말 더 나은 것이 있는지, 좋은 계획을 실제로 끝까지 실행할 수 있는지, 로컬에서 본 개선이 최신 상대에게도 통하는지를 각각 확인해야 했다.
1. 고용을 수익으로 연결하기 위한 후속 작업
Kaggriculture는 두 농장을 30일 동안 운영한 뒤 최종 잔액을 비교하는 게임이다. 하루는 24턴이며, 매 턴 생산·이동·운반·시장 주문을 처리한다. 두 플레이어가 같은 시장에서 거래하므로 한쪽의 판매가 다른 쪽의 가격에도 영향을 준다. 지금 현금이 많다고 반드시 유리한 것도 아니다. 한쪽은 이미 땅과 작물에 투자했을 수 있고, 다른 쪽은 제때 팔지 못할 재고를 쌓고 있을 수 있다.
초반에 일손을 더 고용한다고 해 보자. 고용비는 바로 나가고, 고용한 일손은 그날만 일한다. 다음 날에도 필요하면 다시 고용해야 한다. 그 일손에게 맡길 일이 없다면 돈만 쓴 셈이다. 땅을 사는 일도 마찬가지다. 씨앗 구매부터 물주기·수확·운반까지 이어져야 투자가 수익이 된다.
고용과 토지 구매에 쓴 돈을 회수하려면 그 뒤의 작업을 제때 마쳐야 한다. 시장 가격이 떨어지거나, 새 밭에 일손을 보내느라 기존 가축을 돌보지 못하면 계획 전체가 손해일 수도 있다.
“토마토를 더 심자”는 생각을 실행하려면 어느 일손이 어디에서 무엇을 할지까지 정해야 한다. 신경망을 쓴다고 이 과정이 없어지지는 않는다. 학습 데이터에 이런 운영이 들어 있거나, 탐색기가 서로 맞물리는 작업들을 만들어 낼 수 있어야 한다.
최종 잔액·bank margin·승패의 차이
한 경기에서 내 최종 잔액이 100,000이고 상대가 100,001이면 진다. 다른 경기에서 70,000 대 60,000이면 이긴다. 경기마다 상점과 시장 조건이 다르므로, 100,000을 번 쪽이 70,000을 번 쪽보다 강하다고 단정할 수도 없다. 여기서는 final bank margin을 ‘내 최종 잔액 − 상대 최종 잔액’으로 정의하고, 줄여서 margin이라고 쓰겠다.
성능을 볼 때는 적어도 세 가지를 나눠야 한다.
| 값 | 답하는 질문 | 쓰는 곳 |
|---|---|---|
| 내 최종 잔액 | 이 조건에서 얼마를 벌었나? | 생산·투자·물류 분석 |
| Final bank margin | 같은 경기에서 상대보다 얼마를 더 벌었나? | 경제적 격차와 박빙 경기 분석 |
| 승·무·패 | 이기는 경기가 얼마나 자주 나오나? | 대전 강도와 최종 평가 |
평균 margin이 늘어도 이미 크게 이기던 경기에서만 더 벌었다면 승점은 그대로일 수 있다. 반대로 적은 돈이라도 박빙 패배를 여러 번 승리로 바꾸면 중요한 개선이다. “몇 코인 더 벌었다”를 일정한 비율로 평점에 환산할 수 없는 이유다. 어떤 상대와 조건에서 승패가 바뀌었는지를 봐야 한다.
2. Policy·학습기·벤치마크의 역할
Policy는 에이전트가 받은 정보로 다음 행동인 action을 고르는 프로그램이다. 돈이 충분하면 소를 산다 같은 규칙도 policy이고, 상점 조합에 따라 녹화된 행동열인 tape를 고르는 표도 policy이며, 신경망도 policy다. ‘정책’이라는 말이 특정 신경망 구조를 뜻하는 것은 아니다.
학습기는 자료나 새 경험으로 policy의 숫자를 바꾼다. 벤치마크는 정해진 조건에서 policy를 실행해 성적을 측정한다. 사람이 벤치마크를 읽고 규칙을 고쳐도 policy는 개선할 수 있다. 다만 그 방식에서는 다음에 무엇을 바꿀지 매번 사람이 정해야 한다.
강화학습(RL, reinforcement learning)은 행동의 결과로 받은 reward를 이용해 더 좋은 선택을 배우는 방법이다. 강자의 action을 정답으로 배우는 BC(behavior cloning)는 지도학습을 이용한 모방 학습이다. PPO는 자기 경험의 reward로 policy를 바꾸는 강화학습 알고리즘의 하나다. BC와 PPO를 이어서 쓸 수 있지만, 둘이 배우는 신호는 다르다.
실제로 프로그램을 나눠 보면 어느 부분을 고쳐야 할지 더 분명해진다.
| 부품 | Kaggriculture의 예 | 이 부품이 약할 때 |
|---|---|---|
| 전략 표현 | 하루 목표, 전체 경로, action 확률, 선택 표 | 표현 범위 밖의 전략은 만들 수 없다. |
| 후보 생성 | 경로 재배치, 작물 구성 변경, policy에서 action 뽑기 | 비슷한 약한 대안만 반복한다. |
| 실행 | 목표를 이동·작업·주문으로 변환 | 예상 수익이 높은 계획도 실행 중 무너진다. |
| 평가·학습 | 미래 수익 추정, BC loss, PPO update | 실제 목표와 다른 방향으로 좋아질 수 있다. |
| 독립 평가 | 새로운 조건에서 내 행동에 대응하는 상대와 대전 | 개발용 경기의 개선을 실전 강도로 착각한다. |
GPU는 이 중 계산이 많은 부분을 빠르게 처리한다. 하지만 후보 생성 방법이 없거나, 계획을 action으로 옮기지 못하거나, 엉뚱한 목표를 최적화하고 있다면 장비를 늘려도 그 문제는 남는다. 평가할 상대와 조건을 모은 묶음을 panel이라고 부른다. 내 행동으로 시장이 달라졌을 때 상대도 새 정보를 보고 대응한다면 reactive 상대다. 녹화된 명령만 재생하는 상대와는 다르게 다뤄야 한다.
에이전트가 받을 수 있는 observation의 범위
사람이 게임 화면을 보고 판단하듯, 프로그램은 게임이 API로 건네준 observation을 보고 판단한다. Kaggriculture에서는 현재 날짜와 시각, 내 현금, 밭의 작물, 일손의 위치, 공개된 시장 가격과 상점 정보 등이 여기에 들어간다. 게임 엔진은 앞으로 쓸 난수와 상대의 비공개 정보까지 갖고 있을 수 있지만, 에이전트가 그 정보를 모두 받는 것은 아니다.
리플레이를 읽는 사람은 경기 끝까지 볼 수 있다. 그렇다고 “나중에 토마토 상점이 나온 경기니까 첫날부터 토마토 계획을 고른다”는 프로그램을 제출할 수는 없다. 전체 기록은 정답과 결과 분석에 쓰더라도, policy에는 그 결정을 내릴 때 알 수 있던 정보만 넣어야 한다.
이를 수식으로 쓰면 $a_t\sim\pi_\theta(\cdot\mid o_t,m_t)$다. “시점 $t$에 받은 정보와 기억으로 action별 확률을 계산하고, 그중 하나를 뽑는다”고 읽으면 된다.
| 기호 | 뜻 | 농장에서는 |
|---|---|---|
| $t$ | 결정을 내리는 시점 | 0번째, 1번째, 2번째 turn |
| $o_t$ | 그때 받은 observation | 날짜·현금·일손 위치·시장 가격 등 API 입력 |
| $m_t$ | 이전 turn에서 저장한 기억 | 지난 가격이나 이전에 내린 결정 |
| $a_t$ | 고른 action | 고용·이동·수확·시장 주문 등 |
| $\pi_\theta$ | 숫자 $\theta$로 정해진 policy | 규칙의 계수·선택 표·신경망 가중치가 정하는 행동 방식 |
세로선 $\mid$ 뒤는 판단에 주어진 정보이고, 점 $\cdot$는 가능한 action들이 들어갈 자리다. $\sim$는 계산한 확률분포에서 action 하나를 뽑는다는 뜻이다. 항상 같은 행동을 하는 규칙도 그 행동의 확률이 1인 policy로 볼 수 있다. RL의 기본 정의
이 숫자들을 자료에 맞추는 일을 fit이라고 한다. 학습 목표에 맞춰 줄일 값을 loss라고 정한다. BC라면 교사 action에 낮은 확률을 줄수록 loss가 커진다. Gradient는 각 숫자를 조금 바꿨을 때 loss가 어떻게 달라지는지 나타낸다. Optimizer는 이 gradient로 숫자를 바꾸는 계산 절차다. 결국 확인할 것은 하나다. 이번 학습에서 어떤 숫자가 바뀌고, 그 숫자가 어떤 행동을 바꿀 수 있는가?
세 번의 결정으로 구성한 작은 농장 예제
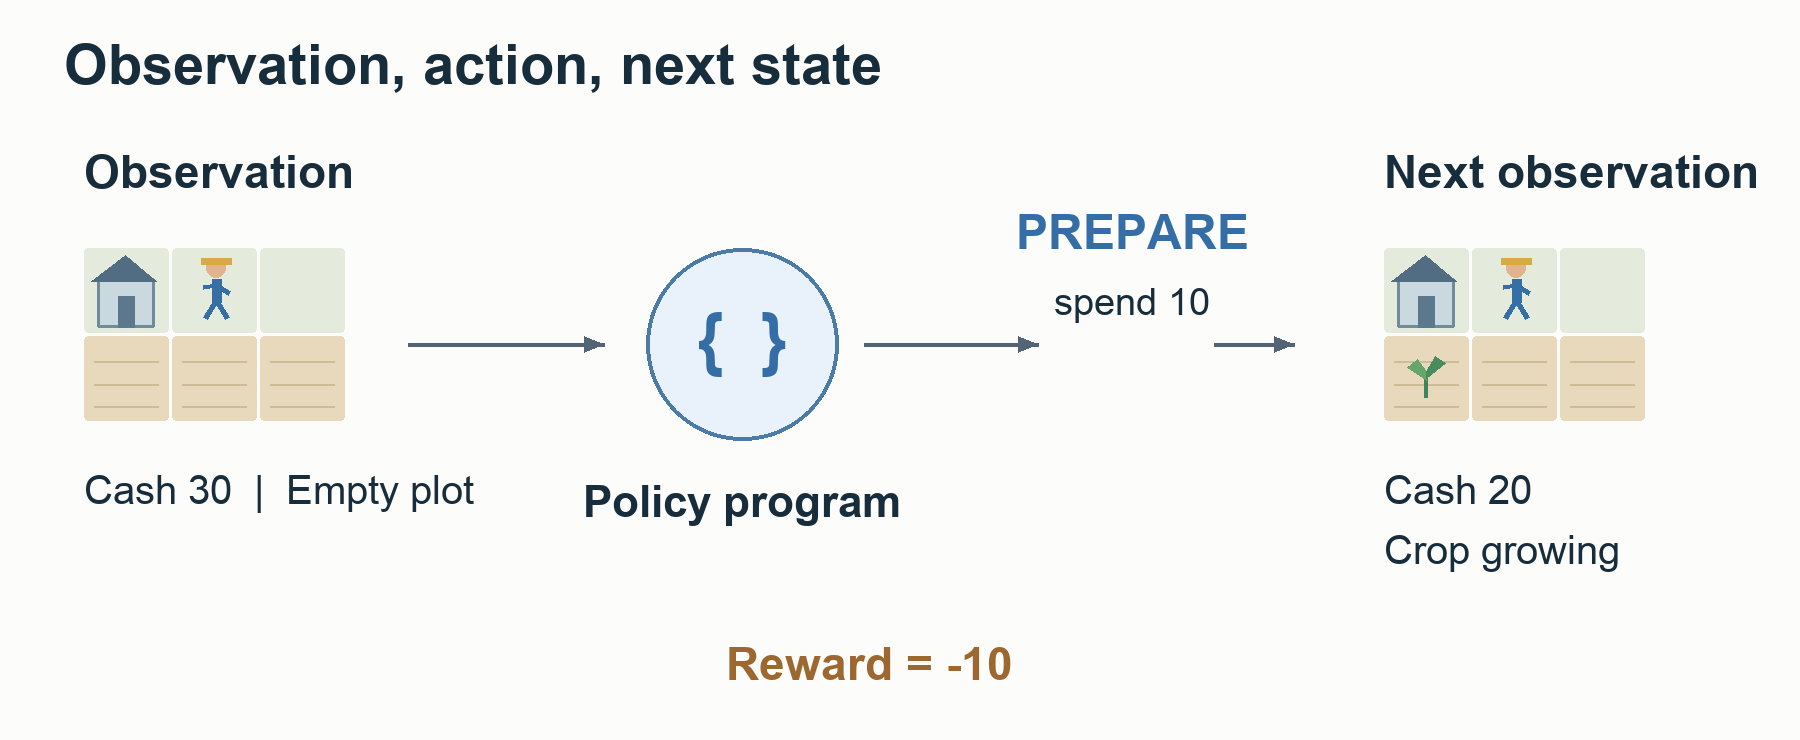
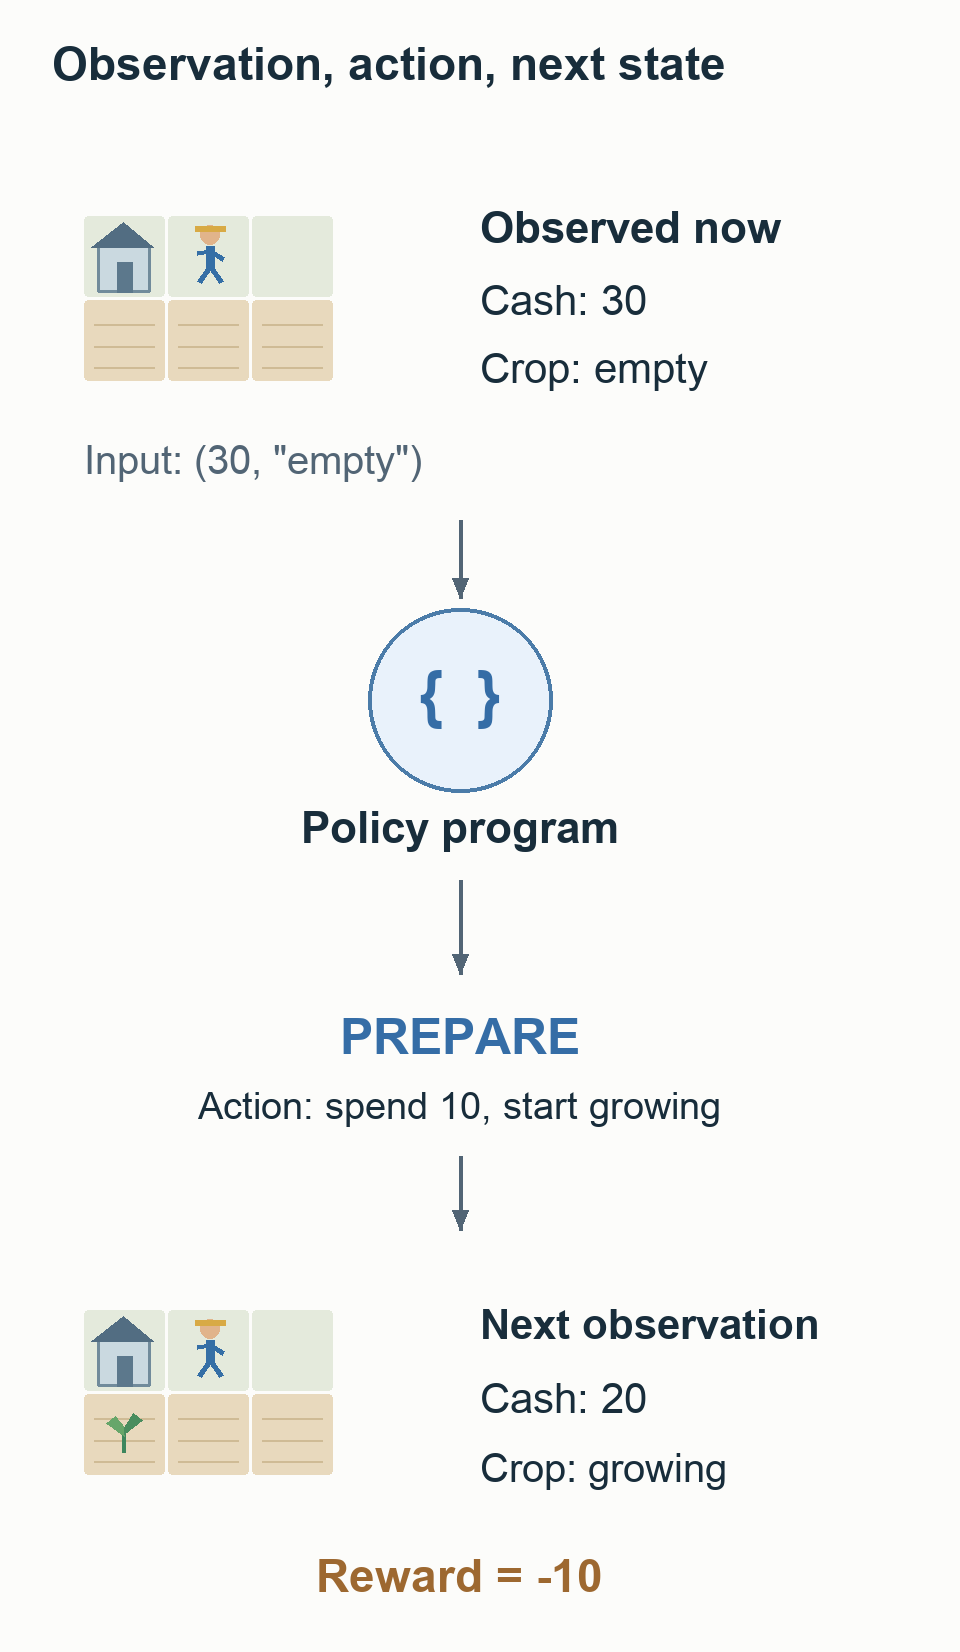
농장 한 판을 세 번의 결정으로 줄여 보자. 현금 30으로 시작해 준비에 10을 쓰고, 작물을 돌본 다음 수확물을 20에 판다고 하자. 날짜·가격·고용비를 생략한 가상의 작은 게임이다. 이 예에서는 게임의 전체 상태인 state가 observation에 그대로 들어온다.
| 결정 시점 | 현재 state | Action | 다음 state | Reward |
|---|---|---|---|---|
| 0 | 현금 30, 빈 밭 | 준비하기 | 현금 20, 자라는 작물 | −10 |
| 1 | 현금 20, 자라는 작물 | 돌보기 | 현금 20, 익은 작물 | 0 |
| 2 | 현금 20, 익은 작물 | 판매하기 | 현금 40, 종료 | +20 |
환경은 action을 받아 다음 state를 만든다. 이 과정을 transition이라고 한다. Reward는 그 결과를 학습에 쓰기 위해 숫자로 정한 피드백이다. 위에서는 현금 변화를 reward로 썼지만, 승리했을 때만 마지막에 +1을 주도록 정할 수도 있다. 게임이 어떻게 진행되는지와 그 결과에 어떤 reward를 붙일지는 별개의 문제다.
| 용어 | 같은 장난감 농장에서 가리키는 것 |
|---|---|
| turn 또는 step | 준비하기처럼 action을 한 번 내고 환경을 진행하는 단위 |
| episode | 빈 밭에서 시작해 종료할 때까지의 한 판. 여기서는 transition 3개, state 4개 |
| trajectory | state → action → reward → 다음 state를 시간순으로 모은 기록 |
| rollout | Policy로 환경을 진행해 trajectory를 모으는 과정이나 그 결과. 한 번에 여러 판을 모을 수도 있다. |
| batch | 한 번의 계산에 함께 넣는 표본 묶음. 위 transition 세 개를 한 묶음으로 사용할 수 있다. |
| epoch | 정해진 학습 자료를 한 바퀴 사용하는 것. 같은 표본 세 개를 두 바퀴 쓰면 2 epoch다. |
| update | 계산한 gradient를 이용해 optimizer가 가중치를 한 번 바꾸는 일 |
Epoch와 update는 같은 말이 아니다. 자료가 1,000행이고 batch가 100행이면 한 epoch에 보통 10번 update한다. 여러 batch의 gradient를 모았다가 한 번 반영하는 gradient accumulation을 쓰면 이 관계가 달라진다. Rollout도 항상 한 판 전체를 뜻하지는 않는다. 경기 중간까지 진행한 기록을 모을 수도 있다. 경기 수, transition 수, 표본을 다시 쓴 횟수, 가중치를 바꾼 횟수는 구분해서 세어야 한다.
Transition을 기록하는 코드
다음 코드는 한 판을 진행하며 transition을 기록한다. policy는 현재 state에서 action을 고르고, rules는 그 결과로 현금과 작물 상태가 어떻게 바뀌는지 정한다. 이 예에서는 현금 변화인 cash_change를 그대로 reward로 쓴다. Policy는 이미 정해져 있다. 여기까지는 더 나은 행동을 배우는 코드가 아니라 경험을 모으는 코드다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
rules = {
    "empty": ("prepare", -10, "growing"),
    "growing": ("water", 0, "ripe"),
    "ripe": ("sell", 20, "done"),
}
policy = {"empty": "prepare", "growing": "water", "ripe": "sell"}
state = (30, "empty")
trajectory = []
for turn in range(3):
    cash, phase = state
    action = policy[phase]
    expected, cash_change, next_phase = rules[phase]
    assert action == expected
    next_state = (cash + cash_change, next_phase)
    reward = cash_change
    done = next_phase == "done"
    trajectory.append((state, action, reward, next_state, done))
    state = next_state
print("actions:", [row[1] for row in trajectory])
print("final cash:", state[0])
출력은 actions: ['prepare', 'water', 'sell'], final cash: 40이다. 첫 기록 ((30, 'empty'), 'prepare', -10, (20, 'growing'), False)를 읽으면 “현금 30과 빈 밭에서 준비를 했고, reward −10을 받았으며, 현금 20과 자라는 작물 상태로 넘어갔다”는 뜻이다. 마지막 False는 아직 경기가 끝나지 않았다는 표시다.
기록 모양이 같아도 누가 플레이했는지에 따라 학습에 쓰는 정보는 달라진다.
| 기록의 출처 | 실제로 꺼내 쓰는 정보 | 묻는 질문 |
|---|---|---|
| 강자가 플레이한 teacher trajectory | (현금 30, 빈 밭) → prepare 같은 observation–action 쌍 | 이 정보에서 교사가 고른 action을 예측할 수 있나? |
| 현재 내 policy의 rollout | 내가 고른 action, 그때의 확률과 value 예측, 이후 reward | 예상보다 결과가 좋았나? 그 action의 확률을 어떻게 바꿀까? |
강자의 기록에서 만든 BC 표본과, 내 policy가 새로 만든 PPO 경험은 이렇게 구분된다. 위 코드를 PPO용 수집기로 만들려면 고른 action의 확률을 로그로 바꾼 logprob와 그 상태에서 기대한 결과인 value도 저장해야 한다. 나중에 policy를 바꿀 때 당시의 선택 확률과 예상을 기준으로 쓰기 때문이다.
초기 비용과 미래 reward의 연결
Return은 지금부터 받을 reward를 합친 값이다. 위 경기의 reward는 −10, 0, +20이고 단순 합은 +10이다. 시점 $t$의 reward를 $R_t$, 그때부터의 return을 $G_t$라고 쓰자. 할인율 $\gamma=0.9$를 쓰면 한 step 뒤 reward는 0.9배, 두 step 뒤는 $0.9^2$배로 계산한다. 시작 시점에서는 다음과 같다.
현금이 6.2 늘었다는 뜻은 아니다. 현금은 30에서 40으로 늘었고, 미래 reward에 할인을 적용한 return이 6.2다. $\gamma=1$이면 return도 +10이 된다. 준비 비용 −10만 보고 손해라고 판단하면 그 뒤의 수익을 놓친다. RL에서는 지금의 선택이 나중의 결과에 얼마나 기여했는지를 경험으로 추정해야 한다.
Critic은 현재 state에서 그 policy를 계속 따랐을 때의 return을 예측하는 모델이다. 그 예측을 value라고 한다. 위 농장의 시작 state에서 목표로 삼는 값은 현금 30이나 최종 현금 40이 아니라, 정한 할인율로 계산한 return 6.2다. 실제 게임은 미래가 정해져 있지 않으므로 여러 경험에서 그 기대값을 배운다.
Kaggriculture 순위는 이 작은 예제의 현금 reward 합으로 정하지 않는다. 경기에서는 최종 잔액으로 승패를 가르고, 여러 상대와의 결과로 최종 평가를 한다. 학습에 쓰는 reward, critic이 예측하는 return, 대회에서 높여야 할 성적을 구분해야 무엇이 좋아졌는지 알 수 있다. 단일 5090 사례의 자금 차 reward와 우승팀의 승패 reward도 이 기준으로 비교해야 한다.
3. 전략 선택 모델과 후보 전략의 한계
기존 계획, 가축 확장, 작물 확장이라는 세 프로그램이 이미 있다고 하자. 네 가지 상황에서 각 프로그램의 기대승점이 아래와 같다고 가정한다. 승리 1점, 무승부 0.5점, 패배 0점으로 센다.
| 관측 조건 | 기존 계획 | 가축 확장 | 작물 확장 |
|---|---|---|---|
| 현금·일손 여유 | 0.50 | 0.80 | 0.30 |
| 현금 부족, 빈 땅 많음 | 0.50 | 0.20 | 0.80 |
| 먹이 확보, 작물 시장 과잉 | 0.50 | 0.70 | 0.30 |
| 먹이 부족, 작물 시장 수요 | 0.50 | 0.10 | 0.70 |
네 상황이 똑같이 자주 나온다면 기존 계획만 쓰는 평균은 0.50, 가축 확장만 쓰면 0.45, 작물 확장만 쓰면 0.525다. 상황마다 가장 좋은 것을 고를 수 있다면 $(0.8+0.8+0.7+0.7)/4=0.75$다. 이렇게 모든 값을 안다고 가정하고 최선의 선택을 하는 기준을 oracle이라고 부른다. 이 선택지들에는 상황에 맞게 골라서 얻을 수 있는 이익이 있다.
표의 행과 열을 그대로 Python 목록으로 옮기면 계산을 손으로 확인할 수 있다.
1
2
3
4
5
6
7
8
9
10
11
scores = [
    [0.50, 0.80, 0.30],
    [0.50, 0.20, 0.80],
    [0.50, 0.70, 0.30],
    [0.50, 0.10, 0.70],
]
fixed = [sum(row[col] for row in scores) / len(scores)
         for col in range(3)]
oracle = sum(max(row) for row in scores) / len(scores)
print("fixed:", [round(value, 3) for value in fixed])
print("oracle:", round(oracle, 3))
출력은 fixed: [0.5, 0.45, 0.525], oracle: 0.75다. sum(row[col] ...)는 모든 상황에서 같은 프로그램을 쓰는 계산이고, max(row)는 각 상황에서 가장 좋은 프로그램을 고르는 계산이다. 가장 강한 고정 전략과 oracle의 차이는 $0.75-0.525=0.225$다. 하지만 실제로는 표의 기대승점을 정확히 모르고, observation만으로 구별할 수 없는 상황도 있을 수 있다. 이 차이를 모두 얻을 수 있다는 보장은 없다.
반대로 두 대안이 모든 상황에서 기존 계획보다 약하다면, 선택기를 개선해도 기존 계획을 더 자주 고르게 될 뿐이다. “선택 신경망을 키우자”에 앞서 “지금 선택지 안에 정말 더 나은 것이 있나”를 확인해야 한다.
실험에서는 같은 초기 조건과 상대에게 각 대안을 실행해 다음 둘을 비교할 수 있다.
- 전체 표본에서 하나만 고정해 쓰는 정책 중 가장 좋은 성적.
- 결과를 본 뒤 각 셀에서 가장 좋은 대안을 고른 성적.
둘째는 결과를 본 뒤 고른 사후 oracle이다. 위 예제는 상황별 기대승점을 안다고 가정했지만, 실제 한 경기에서 얻는 것은 0·0.5·1 중 하나다. 그 결과를 보고 최댓값을 고르면 우연히 잘된 후보까지 선택한다. 실제 policy가 미래 결과를 알 수 있는 것도 아니므로 사후 oracle을 달성 가능한 성적이라고 보면 안 된다.
다만 같은 표본에서조차 더 나은 대안이 없다면, 잘 고르는 법보다 좋은 대안을 만드는 일이 먼저라는 신호다. 이득이 보이더라도 그 상황을 결정 전에 구별할 수 있는지, 새로운 경기에서도 이득이 남는지는 따로 확인해야 한다.
모델의 출력으로 바꿀 수 있는 전략의 범위
둘 다 현금과 농장 정보를 입력받아도 출력이 다르면 바꿀 수 있는 전략은 다르다.
| 프로그램 | 입력 | 출력 | 출력 뒤에 누가 농장을 운영하나? |
|---|---|---|---|
| 단순 선택기 | 선택 시점의 observation | 기존·가축·작물 중 계획 이름 하나 | 이미 만들어 둔 제어기 |
| 매 turn action을 내는 policy | 그때그때의 observation과 기억 | 고용·이동·작업·시장 명령 | Policy가 다음 observation을 읽어 다시 결정 |
| Planner | 현재 농장과 자원·시간 제약 | 인력·작업·경로·거래를 묶은 계획 | 실행기가 계획을 실제 명령으로 변환 |
입력 → 바꿀 수 있는 숫자 → 출력 → 실행을 한 줄로 적어 보면 차이가 보인다. 신경망이 가축 확장이라는 번호만 고른다면 소를 어디에 놓고 누가 먹이는지는 이미 작성한 코드가 정한다. 선택기의 가중치를 바꿔도 그 코드에 없는 축사는 생기지 않는다. 매 turn action을 고르는 policy는 더 많은 결정을 바꿀 수 있다. 대신 한 시즌의 운영을 배울 데이터와 여러 action의 자원 충돌을 막는 실행 방식이 필요하다. Planner는 이런 작업들을 계획으로 묶어 만드는 프로그램이다.
4. 내 학습 모델이 바꿀 수 있었던 것
내가 만들었던 학습기 중 하나는 현재 상황에서 어느 작업 계획을 쓸지 고르는 선택 가치 모델이었다. 같은 상황에서 기존 policy와 대안을 각각 끝까지 실행하고, 둘의 승점 차와 margin 변화를 정답으로 만들었다. 현금·인력처럼 observation에서 뽑은 숫자인 feature로 이득을 예측하도록 ridge regression을 fit했다. 여러 대안 중 무엇을 고를지 학습한 것이며, 매 turn의 action 확률을 PPO로 바꾼 것은 아니다.
이 회귀 모델은 feature에 계수를 곱해 예상 이득을 계산한다. Margin 보조값은 잠시 빼고 기존 policy와의 승점 차만 예측해 보자. 현금 여유 $x_1=0.8$, 노동 부담 $x_2=0.2$처럼 feature를 0–1 범위로 만들었고, 학습한 계수가 다음과 같다고 가정한다.
\[\begin{aligned} \widehat y&=0.05+0.10x_1-0.20x_2\\ &=0.05+0.08-0.04\\ &=0.09. \end{aligned}\]$\widehat y=0.09$는 승점이 기존 policy보다 9%포인트 높을 것으로 예측했다는 뜻이다. 대회 평점이 9점 오른다는 뜻은 아니다. 예측이 채택 기준을 넘으면 대안을 실행하고, 아니면 기존 policy를 쓴다. 학습할 때는 여러 경기의 실제 이득 $y$에 예측이 가까워지도록 계수를 구한다. Ridge regression은 특정 계수가 지나치게 커지지 않도록 penalty도 더한다. 위 숫자는 계산 예이며 실제 모델은 더 많은 feature를 썼다.
실제 구현의 ridge 식 읽기
$X$는 여러 상황의 feature를 행으로 쌓은 표, $y$는 실제 대전에서 얻은 대안의 이득이다. $W$는 표본마다 얼마만큼 중요하게 볼지 정한 가중치 행렬이다. 학습할 계수들을 $\widehat\beta$로 묶어 쓰며, $\lambda$는 penalty의 세기다. 위 첨자 $\mathsf T$는 행과 열을 뒤집는 전치, $^{-1}$은 역행렬을 뜻한다.
\[\begin{aligned} \widehat\beta&=(X^\mathsf{T}WX+\lambda R)^{-1}X^\mathsf{T}Wy,\\ R&=\operatorname{diag}(0,1,\ldots,1). \end{aligned}\]실제 구현에서는 승점 차와 margin 보조값을 정답 두 개로 놓고 같은 식으로 각각의 계수를 구했다. 보조값은 margin 변화를 10,000으로 나눈 뒤 tanh로 −1~1 범위에 제한한 값이다. 계획을 고를 때는 예측 승점 차에, 가중치를 곱한 보조값을 더한다. 본문의 예제는 이 중 승점 차만 예측하도록 단순화했다.
Penalty 행렬 $R$의 첫 값이 0인 것은 상수항을 penalty에서 제외했기 때문이다. 코드에서는 역행렬을 직접 만들지 않고 np.linalg.solve로 선형 시스템을 풀었다. 여러 계수를 한꺼번에 구하므로, 계수 하나씩 손으로 바꾼 뒤 매번 대전하는 방식과 다르다.
이렇게 바꾼 policy로 새 경기를 모아 다시 fit하기도 했다. 하지만 학습에 쓴 표를 잘 맞힌다고 새 경기에서도 잘 고르는 것은 아니다. 학습 자료의 우연한 패턴까지 외워서 새 자료에서 성능이 나빠지는 것을 overfitting이라고 한다. 학습 자료에서의 정확도와 새 조건에서의 대전 성적은 따로 봐야 한다.
이 모델이 배우는 것은 “지금 어느 계획을 쓰는 편이 나은가”다. 매 turn 이동·고용·파종·판매를 고르는 신경망과는 바꿀 수 있는 범위가 다르다. 어느 쪽이 언제나 낫다는 뜻은 아니다. 현재 문제를 해결할 선택이 모델의 출력 범위 안에 있는지를 봐야 한다.
선택 모델은 기존 계획보다 얼마나 나은가를 예측하고, PPO의 critic은 현재 policy를 계속 따를 때의 return을 예측한다. 기준과 reward 단위가 다르므로 둘 다 0.1을 출력해도 같은 뜻이 아니다.
4.1 학습 성적의 개선과 새 경기의 성능 저하
9월 13일의 비료 선택 실험에서는 두 번 fit했다. 기록에 남은 기존 policy와의 평균 승점 차는 다음과 같다.
| 측정 구간 | 승점 차 |
|---|---|
| 첫 모델: 학습에 쓴 대안 표에서 평가 | +0.14583 |
| 첫 모델: 새로 모은 경험에서 평가 | −0.06250 |
| 두 번째 모델: 학습에 쓴 대안 표에서 평가 | +0.09375 |
| 두 번째 모델: 새 개발 조건에서 실행 | −0.03125 |
자료는 192행이었지만 서로 다른 결정 상황은 64개, seed 묶음은 16개였다. Seed는 난수의 초기값이다. 같은 seed에서 나온 조건으로 여러 대안과 좌석을 비교하면 행 수는 늘어도 독립적인 경기 조건이 늘어난 것은 아니다. 이름이 달랐던 두 대안도 실제로는 같은 action을 냈고, 기대했던 당근 시비는 한 번도 실행되지 않았다.
그러니 “RL update를 한 번도 안 했다”는 진단은 틀리다. 모델은 실제로 바꿨다. 다만 제한된 자료에서 작은 대안의 이득을 학습했고, 새 조건에서는 성적이 나빠졌다. 대안이 정말 다른 행동을 하는지, 서로 다른 경험을 충분히 모았는지부터 확인해야 했다.
4.2 후보 계획 자체의 수익성 문제
9월 14일 cashflow 실험에서는 당근 생산에 필요한 자금·고용·시비·수확·운반·판매를 하나의 계획으로 묶었다. 처음 비교한 160개 조건 중 이 계획을 실행한 것은 95개였고, 95개 모두 기존 policy를 쓸 때보다 margin이 줄었다. 유효한 대전은 모두 528경기를 돌렸으며 모델을 학습하지는 않았다.
새 작업으로 늘어난 당근은 154개였다. 하지만 거기에 일손을 보내느라 원래 경로에서 얻던 당근 531개와 밀 396개를 잃었다. 비료를 아낀 금액보다 추가 고용비도 더 컸다. 새 작업의 수확량만 보면, 그 일을 하느라 포기한 생산을 놓친다. 이것이 노동의 기회비용이다.
이 경우에는 모델을 키우거나 epoch를 늘리기 전에 계획을 바꿔야 한다. 전체 생산이 실제로 늘어나거나, 포기한 기존 작업보다 더 큰 이익을 내야 한다. 손해 나는 대안을 잘 걸러 내는 모델도 유용하지만, 그것만으로 새로운 고득점 전략이 생기지는 않는다.
4.3 약한 baseline만 비교했을 때의 착시
9월 15일에는 두 제어기 중 하나를 고르는 모델을 학습했다. 학습 뒤 새로 확인한 같은 표본에서 평균 승점은 다음과 같았다.
| 정책 | 평균 승점 |
|---|---|
| C2를 고정 사용 | 0.291667 |
| 학습 선택기 B | 0.541667 |
| V43을 고정 사용 | 0.666667 |
C2보다 0.25 높아졌다는 것만 보면 성공처럼 보인다. 하지만 V43을 항상 쓰는 편이 더 좋았다. 이 표본에서 학습 선택기는 V43보다 0.125 낮았다. 입력이 학습 범위를 벗어나면 더 약한 C2를 쓰도록 한 fallback도 성적을 낮춘 이유 중 하나였다.
Baseline은 새 모델의 가치를 판단하기 위한 비교 대상이다. 약한 이전 모델 하나만 baseline으로 잡으면 개선을 과대평가하기 쉽다. 강한 고정 policy와 단순한 선택 규칙, 실제 쓰던 프로그램을 함께 비교해야 복잡한 선택기를 만들 가치가 있었는지 알 수 있다.
세 실험의 수치는 남아 있는 실행 기록과 결과 문서로 확인했다. 실험 ID는 각각 rl_system_20260913, cashflow_rl_20260914, strategy_learning_20260915다. 이 승점 차이만으로 공식 최종 평점이 얼마나 달라졌을지는 알 수 없다.
5. 계획을 실제 행동으로 옮기는 실행기
전체 계획을 만드는 생성기와 새 실행기도 만들었다. 초기 구현에서는 한 일꾼의 가방에 있는 밀을 모두가 쓸 수 있는 공동 재고로 잘못 셌다. 계산상으로는 먹이가 충분했지만, 정작 먹이를 줄 일꾼은 밀을 가져올 수 없었다. 동물을 사고도 설치하지 못하거나 기존 policy의 후속 투자를 이어 가지 못하는 문제도 있었다.
계획에 적은 수익을 얻으려면 실제 작업이 다음 조건을 충족해야 한다.
| 의도한 동작 | 실제로 필요한 조건 |
|---|---|
| 내일 소에게 먹이를 준다. | 먹이가 있는 곳에서 담당 일손이 먹이를 가져와 제때 도착해야 한다. |
| 새 땅에 작물을 심는다. | 토지와 씨앗을 사용할 수 있게 된 뒤 파종할 일손이 도착해야 한다. |
| 고용한 일손이 생산을 늘린다. | 하루 안에 이동·작업·귀환을 마칠 수 있는 경로를 맡겨야 한다. |
| 수확물을 판다. | 가방과 창고에 담을 수 있어야 하며, DROP·시장 처리 순서와 판매 기한을 지켜야 한다. |
| 기존 생산도 유지한다. | 새 작업 때문에 놓칠 물주기·먹이·돌봄까지 계산해야 한다. |
이 실행 방식도 policy의 일부다. 모델 출력을 실제 명령으로 바꾸는 프로그램을 decoder라고 한다. Decoder가 학습 때와 다른 의미의 명령을 내거나, 시뮬레이터에서 되던 거래가 공식 엔진에서는 실패한다면 학습한 전략을 그대로 실행하지 못한다.
먼저 검사할 것은 action → label → action 왕복 변환이다. 교사의 action을 학습 정답인 label로 바꾼 뒤 다시 명령으로 복원해 공식 규칙에서 실행한다. 돈·재고·작물이 기록과 같은 결과로 이어지는지 확인한다. 여기서 틀리면 신경망이 정답을 얼마나 잘 맞히는지 보기 전에 변환과 실행부터 고쳐야 한다.
6. Replay 복사·BC·계획 탐색의 차이
같은 강자의 경기 기록을 보더라도 무엇을 가져와 어떻게 쓰는지는 다르다.
| 방식 | 저장하거나 배우는 것 | 새 경기에서 하는 일 |
|---|---|---|
| Tape | 특정 경기의 action을 순서대로 저장 | 해당 시점의 명령을 재생하고 일부 보정한다. |
| BC | Observation에서 teacher action을 예측하는 모델 | 지금 받은 정보로 다음 action을 고른다. |
| 계획 탐색 | 작물·작업·경로를 표현하는 방법과 평가 함수 | 현재 state에서 실행할 계획을 만들고 비교한다. |
Tape가 쓸모없었던 것은 아니다. 내가 쓰던 에이전트도 공개 리플레이에서 얻은 완전 경로를 조건에 맞춰 고르는 방식을 물려받았다. 별도의 완전 tape를 시험한 기록도 있다. 문제는 다른 현금·시장·상대에서도 그 명령을 끝까지 실행할 수 있느냐였다. 평가 panel을 통과한 tape가 실제 다른 라우터에게는 11승 37패를 거둔 적도 있다.
BC는 “144번째에는 고용한다”는 명령을 재생하는 대신 현재 날짜·현금·인력·농장 정보를 보고 고용할 확률을 예측한다. 교사와 다른 행동을 했더라도 그 결과로 바뀐 observation을 다시 읽는다. 이렇게 자기 행동의 결과를 보고 다음 결정을 하는 방식을 closed-loop라고 한다. 그렇다고 낯선 상태에서 저절로 회복하는 것은 아니다. 작은 실수가 쌓일 수 있으므로 교사 기록에서의 정확도와 직접 한 시즌을 운영한 성적을 따로 봐야 한다.
Planner는 현재 state에서 후보 계획을 만들고 예상 결과를 계산한다. 고용 인원만 바꿀 수 있는 planner와, 고용·토지·파종·경로를 함께 바꿀 수 있는 planner는 찾을 수 있는 전략이 다르다. 계획을 잘 평가하더라도 필요한 후보를 만들지 못하면 투자 방식을 바꾸기 어렵다.
7. 수작업 수정과 알고리즘의 역할
사람이 결정한 부분은 많았다. 어떤 정보를 넣을지, action을 어떤 단위로 표현할지, 어느 팀의 기록을 teacher로 쓸지, 어떤 상대와 훈련할지, reward를 무엇으로 정할지는 사람이 설계했다. 패배 로그에서 토마토 생산 부족이나 창고 문제를 찾아내기도 했다.
그렇다고 모든 파라미터를 하나씩 고친 뒤 각각 큰 벤치마크를 돌린 것은 아니다. 자동으로 바꾸는 대상이 방법마다 달랐다.
BC: 강자의 observation–action 관계 학습
강자가 고용하고, 땅을 사고, 파종하고, 돌보고, 판매한 기록을 모은다. 신경망은 그때그때의 observation에서 teacher action에 높은 확률을 주도록 많은 가중치를 함께 바꾼다. 사람이 “이 상태에서는 왼쪽으로 가라”는 규칙을 수십만 개 작성할 필요는 없다.
다만 BC loss는 교사보다 강해지도록 정의한 값은 아니다. 교사의 운영을 얼마나 배웠는지, 드문 고용·토지 주문도 놓치지 않는지, 잘못 따라 한 뒤에 회복하는지는 실제 플레이에서 확인해야 한다.
PPO: 새 경험을 이용한 action 확률 갱신
현재 policy로 새 경기를 돌린 뒤 예상보다 좋거나 나쁜 결과를 이용해 action 확률을 조정한다. 여기서도 바꾸는 것은 여러 state에 공통으로 쓰이는 가중치다. Critic은 그 상태의 return을 예상하고, advantage는 경험이 그 예상보다 얼마나 좋거나 나빴는지 추정한다. 이 신호로 action을 평가하므로 한 판 이겼다고 그 안의 모든 행동을 좋은 선택으로 취급하지는 않는다. PPO 논문
매 update마다 큰 벤치마크를 돌리지는 않는다. Rollout과 update를 반복하면서 학습이 정상인지 보고, 중간 가중치를 저장한 checkpoint를 골라 개발 평가를 한다. 마지막으로 정한 후보는 따로 남겨 둔 조건에서 확인한다. 학습 중의 많은 변경과 최종 후보의 검증은 빈도와 비용을 나눠야 한다.
ES·CEM: 여러 전략 변수의 동시 탐색
초기 투자 금액, 목표 가축 수, 판매할 때 며칠 뒤까지 내다볼지처럼 조절할 숫자가 적다면 여러 조합을 뽑아 평가할 수 있다. ES(Evolution Strategies)는 무작위 방향으로 값을 바꿔 얻은 결과를 모아 좋은 방향으로 이동한다. CEM(Cross-Entropy Method)은 잘한 후보들 주변에서 다음 후보를 더 많이 뽑도록 분포를 바꾼다. 변수 하나씩 모든 값을 시험하는 방식과는 다르다. ES 원 논문
이 방법도 후보를 대전시키는 비용은 든다. 가축 수를 늘렸는데 실행기가 먹이와 노동을 함께 조절하지 못한다면, 탐색은 실행 불가능한 조합만 반복할 수 있다. 숫자를 바꿨을 때 실제로 그에 맞는 운영이 나오는지부터 확인해야 한다.
계획 탐색: 게임 구조를 이용한 빠른 후보 평가
작물 성장과 하루 작업을 작은 문제로 나누거나 바뀐 경로만 다시 계산하면, 후보 하나를 평가하는 비용을 줄일 수 있다. 우승팀 planner는 이런 방식으로 미래 생산·노동비·판매 수익을 근사하며 일손 수와 작물 구성이 다른 계획을 만든다. 이 점수는 planner의 예상값이다. 완성한 프로그램이 강한지는 공식 규칙에서 reactive 상대와 실제로 대전해 확인한다. 우승팀 탐색 구현
8. 고득점 팀의 전략 개선 과정
단일 RTX 5090으로 10위에 오른 팀은 강자 리플레이로 BC를 학습한 뒤, GPU에서 환경을 실행해 새 경험을 모으고 PPO를 적용했다. 공개 코드에서는 환경·observation·합법 action·학습·CPU 제출까지 이어지는 과정을 볼 수 있다. GPU 한 장에서 학습과 실행을 끝까지 연결한 사례다. 시간과 자원은 저자가 보고한 값이며, 공개 코드를 읽는 것만으로 그 순위를 재현했다고 할 수는 없다.
24위 팀은 초기 몇 주 동안 규칙·계획·판매 최적화를 시도하다 후반에 강자의 운영을 BC로 배웠다. 판매 시점을 정하는 표를 수백만 경기로 학습할 때는 CPU를 썼고, 최종 제출은 BC 계열이었다. 소비자 GPU로 반복 학습했지만 모델의 공통 표현을 만드는 trunk의 사전학습에는 Colab A100도 사용했다. “작은 GPU로 표 하나를 학습해 금메달을 땄다”고 요약하면 실제 과정을 놓친다.
이 팀은 토마토 관련 규칙을 덧붙이는 것과 teacher 데이터를 바꾸는 것도 비교했다. 파종 한 수만 고친 규칙으로는 개선이 제한적이었다. 토마토를 잘 운영하던 최신 교사의 시연을 추가하면서는 노동 배치와 생산도 함께 배웠다. 그렇다고 보정 규칙을 모두 버린 것은 아니며 최종 제출에도 일부 규칙은 남았다.
116위 팀은 수백 개의 완전 tape 중 공개된 상점 조건에 맞는 것을 고르는 표를 CPU 시뮬레이션으로 만들었다. 새 농장 운영을 처음부터 만들어 낸 것이 아니라, 이미 좋은 계획을 현재 조건에 맞게 고르는 방법을 개선했다. 좋은 계획을 확보하는 일과 그중에서 잘 고르는 일은 구분해서 볼 수 있다.
어떤 방법으로 높은 순위를 얻었다고 해서 그 안의 한 부품이 몇 점을 올렸는지까지 알 수는 없다. Teacher 데이터, 모델의 표현 범위, 실행기, 상대 구성, 학습량이 함께 달랐다. 다음 대회에 적용하려면 알고리즘 이름보다 어떤 실패를 발견했고, 그다음 무엇을 바꿨는지를 봐야 한다.
9. 기존 벤치마크의 한계
9월 15일 점검에서는 전체 2,048경기 중 1,024경기를 이미 거의 다 이기던 Land·Plateau 상대에게 쓴 사실을 확인했다. 두 policy는 각각 그 구간에서 254/256승이었다. 익숙한 약한 상대에게 seed만 더 넣어서는 최신 강자를 상대할 방법을 알아내기 어렵다.
이후 실전 기록을 대조해 보니, panel에 있던 같은 프로그램 버전에 대해서는 로컬 결과가 실전과 맞았다. 주로 진 상대는 panel 밖의 최신 프로그램이었다. “로컬 대전이 전부 틀렸다”기보다는, 시험한 상대에 대한 예측은 맞았지만 실제 경쟁 상대를 충분히 시험하지 않았던 것이다.
로그를 감시에만 썼다는 자기진단도 정확하지 않았다. 실전 패배에서 가드·비료·당근 규칙을 찾아 후보를 만들었다. 다만 강한 상대를 찾을 때 “우리 코드와 몇 수만 다른가”로 걸렀다. 조금 다른 수를 보정 규칙으로 가져오기는 편했지만, 처음부터 다른 투자·생산 방식을 쓰는 강자는 그 과정에서 빠졌다.
더 나은 계획을 찾으려면 질문을 바꿨어야 했다.
지금 강한 제출 버전은 어떤 조건에서, 어떤 투자와 작업 배치로 앞서 나갔나? 그 운영을 현재 observation에서 실행할 policy나 계획으로 배울 수 있나?
강자의 로그를 전부 섞으면 된다는 뜻은 아니다. 어느 버전의 기록인지, 당시 볼 수 있던 정보인지, action label이 맞는지, 함께 배워도 운영이 충돌하지 않는지 확인해야 한다. 마지막에는 reactive 상대와 대전해야 한다. 다만 내 코드와 비슷하다는 이유만으로 좋은 전략이라고 판단하지는 않게 된다.
10. 다음 실험을 선택하는 기준
새로 학습하기 전에 어디서 막혔는지부터 구분할 수 있다.
| 보이는 문제 | 먼저 확인할 것 | 다음 계산으로 할 일 |
|---|---|---|
| 대안이 모두 기존 policy보다 약하다. | 전체 생산 변화와 포기한 기존 작업 | 더 좋은 계획 만들기 |
| 좋은 대안이 있는데 선택기가 놓친다. | Observation, 서로 다른 결정 상황 수, fallback | 어떤 상황에서 고를지 학습 |
| 예상 수익은 높은데 실행 중 무너진다. | 현금·재고 위치·경로·기한 | 실제로 실행되도록 수정 |
| BC 정확도는 높은데 직접 운영하면 약하다. | 드문 결정, action–label 변환, 자기 실수 뒤의 상태 | Feature·decoder·teacher 데이터 보강 |
| PPO loss는 바뀌는데 행동과 성적은 같다. | Action 확률의 실제 변화, critic, reward, 탐색 | 학습 신호가 맞는지 조사 |
| 옛 panel에서만 강하다. | 최신 상대 버전과 reactive 여부 | 평가할 상대 바꾸기 |
어디서 막혔는지 모르면 다른 문제에도 같은 처방을 반복한다. 선택지가 나쁜데 모델을 키우고, 실행이 틀렸는데 학습량을 늘리고, 상대가 달라졌는데 옛 panel의 seed만 늘리는 식이다.
병목 진단 연습문제
문제 1. 같은 32개 세계·상대에서 기존 policy와 두 대안을 비교했다. 매 조건에서 두 대안이 모두 기존 policy보다 낮은 승점을 얻었다. 학습 데이터의 행 수를 늘리고 선택 신경망을 키우는 것이 먼저일까?
풀이
지금 표본에서는 더 잘 고를 대안이 없다. 먼저 전체 생산이 얼마나 달라졌는지, 새 작업 때문에 무엇을 포기했는지 조사하고 기존 policy보다 나은 계획을 만든다. 모든 가능한 전략이 약하다고 결론 내리는 것은 아니다. 지금 가진 선택지가 나쁜 것인지, 그중에서 잘 고르지 못한 것인지를 구분하는 문제다.문제 2. BC 모델은 교사 기록에서 action을 99% 맞힌다. 그런데 새 경기에서는 초반 고용을 한 번 놓친 뒤, 없는 일손에게 일을 맡기며 생산이 무너진다. 같은 teacher 데이터를 더 오래 학습하면 충분할까?
풀이
평균 정확도만 봐서는 드물지만 중요한 고용 실패를 놓칠 수 있다. 일손을 고용하지 못한 뒤에는 teacher 기록과 다른 state에도 들어갔다. 고용 label과 decoder, 없는 일손을 입력과 명령에서 처리하는 방식을 먼저 확인한다. 처음 어긋난 지점과 그 뒤의 기록을 모아 teacher 데이터를 보충할지, 복구 행동을 가르칠지, 새 rollout으로 학습할지 정한다. 교사 기록을 잘 맞히는지와 자기 policy로 끝까지 잘하는지는 따로 평가해야 한다.처음에는 작은 실험 하나를 끝까지 해 보는 편이 좋다. Observation으로 실행 가능한 action을 고르고, 경험을 기록하고, 학습으로 선택을 바꾼 뒤, 새로운 조건에서 기존 policy보다 나은지 확인한다. 이 과정이 이어져야 실패했을 때도 무엇을 다음에 계산할지 정할 수 있다.
다음 대회에서는 “GPU로 몇 경기를 돌릴까”보다 “이 계산을 마치면 지금 없는 어떤 후보가 생길까”를 먼저 적으려고 한다. 그다음에는 그 후보를 실제로 실행할 수 있는지, 학습과 선택에 쓰지 않은 어떤 경기에서 더 강한지 확인할지를 정해야 한다.
이어 읽기와 원전
- 2편 — BC와 PPO, 탐색은 어떻게 더 나은 전략을 만드는가: 실제 코드, 학습 신호, 고용·토지·작물 묶음의 미래 가치 계산.
- 3편 — 로그에서 학습하고 실전 강도로 검증하는 작업 순서: 데이터 연결, 평가 분리, GPU 측정, 다음 대회 실행 순서.
- Kaggriculture 첫 작업 노트: 게임 경제와 초기 정책·리플레이 분석.
- 단일 5090 공개 구현, 우승팀 공개 구현, 24위 회고, 116위 회고.
- RL 기본 개념, PPO 원 논문, ES 원 논문.
우리 실험의 수치는 프로젝트에 보존된 docs/rl_system_20260913.md, docs/cashflow_rl_20260914.md, docs/strategy_learning_20260915.md, docs/field_audit_20260915.md와 해당 결과 파일을 대조했다. 프로젝트를 닫을 때의 라이브 점수와 대회 종료 후의 공식 최종 성적은 구분했다. 종료 당시 스냅샷으로 공식 최종 순위를 추정하지 않았다.