Kaggriculture RL 3 — 로그 수집부터 학습·검증까지
Kaggriculture의 전체 리플레이·자기 경기·리더보드를 학습 자료로 연결하고, 교사 선택과 BC·PPO, 상대 리그, 독립 검증, GPU 비용 측정을 거쳐 다음 정책을 만드는 구체적인 절차.
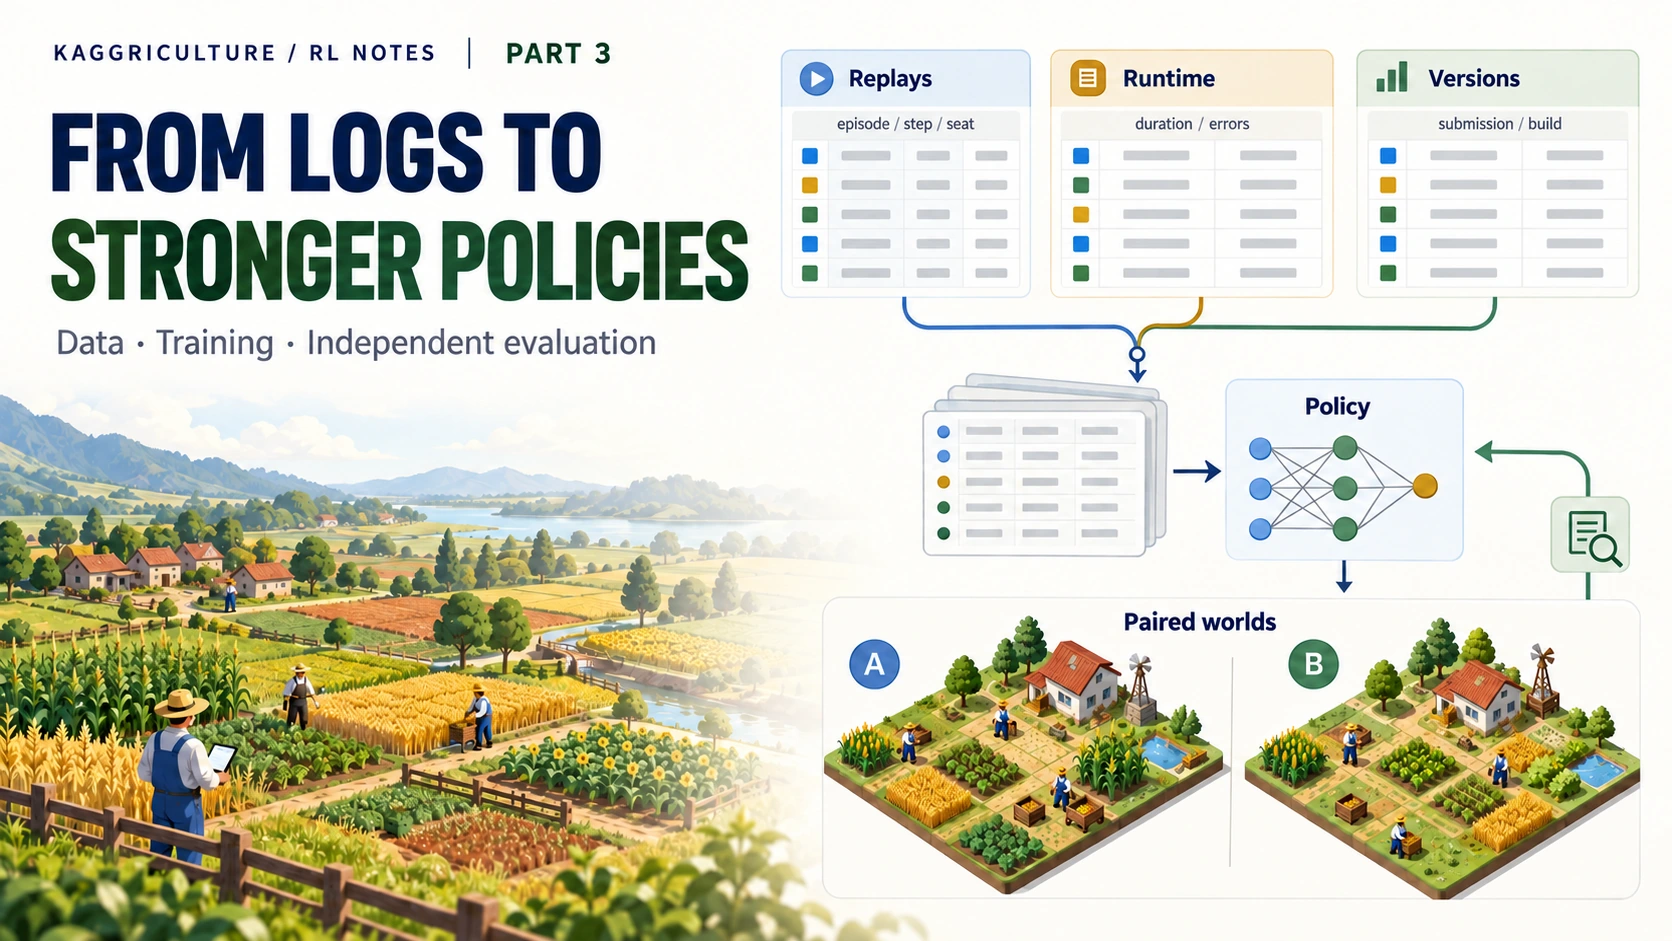
새 GPU를 빌렸는데 실행할 계산이 떠오르지 않는다면, 장비보다 먼저 확인할 것이 있다. 어떤 입력으로 새로운 행동을 만들고, 그 행동이 더 좋은지 무엇으로 판단할 것인가.
Kaggriculture에서 나는 많은 대전을 돌렸다. 로그를 읽고 작은 규칙을 만들었으며, 준비한 대안의 가치를 학습하는 제어기도 시도했다. 그 과정의 약점은 계산량 하나로 설명되지 않는다. 강한 운영을 학습 가능한 자료로 바꾸는 일, 기존 메뉴에 없는 운영을 생성하는 일, 바뀐 실전 상대에게 검증하는 일이 충분히 연결되지 않았다.
BC에는 그 순간 볼 수 있던 정보인 observation과 교사가 고른 명령인 action이 필요하다. PPO에는 행동을 고르는 프로그램인 정책(policy)을 직접 플레이시켜 모은 새 경험, 즉 rollout이 필요하다. 최종 판단에는 학습에 쓰지 않은 대전 결과가 필요하다. 모두 경기에서 얻는 자료지만 용도가 다르다. 무엇을 배우고 확인할지 정해야 어떤 로그를 더 모으고 무슨 계산을 할지도 정해진다.
다음 대회에서는 자료 수집 → teacher 선정 → policy 생성·학습 → 실패 진단 → 독립 평가를 연결해야 한다. 실패한 조건이 드러나면 teacher와 학습 자료를 보강하거나, 새로운 운영을 만들 방법부터 고친다.
이 과정은 다음 대회에서 사용할 작업 순서다. 우승팀의 공개 코드는 BC·self-play·교사 개선의 연결을 보여 주지만, 모든 대회의 수집·평가·출시 절차까지 대신 정해 주지는 않는다. 환경과 목표가 달라지면 각 단계의 구현도 달라져야 한다.
1. 경기·로그·제출 버전을 연결하는 데이터 설계
자료별 용도: 전체 리플레이·내 경기·실행 로그
| 자료 | 주로 답할 질문 | 다음에 바뀌는 것 |
|---|---|---|
| 공식 전체 경기 리플레이 | 지금 강한 프로그램은 어떤 운영을 하는가? | 교사, 생산 전략, 학습할 게임 조건 |
| 내 제출의 리플레이 | 내 정책은 실제 상대를 만나 어디서 갈라지는가? | 결함 수정, 복구 데이터, 약점별 훈련 |
| 에이전트 실행 로그 | 어느 분기가 실행됐고, 무엇이 실패했으며, 시간이 어디에 쓰였는가? | 실행기와 진단 장치 |
| 제출 메타데이터·리더보드 | 어느 버전이 언제 낸 성적인가? | 교사 선정, 상대별 비중, 최근 전략 변화 판단 |
| 직접 수집한 학습 rollout | 내가 선택한 행동이 예상보다 어떤 결과를 냈는가? | PPO의 다음 가중치 |
전체 아카이브에서 강자의 운영을 발견하고, 내 경기에서 같은 운영을 못 하는 이유를 찾을 수 있다. 예를 들어 실행 로그에 자원 부족으로 구매를 취소했다고 나온다면, 실제로 돈이 부족했는지부터 확인한다. 돈이 있는데 잘못 취소했다면 실행 코드를 고친다. 앞선 투자 때문에 정말 돈이 모자랐다면 투자 순서를 조사한다. 반대로 정상적으로 실행되는데 보유 전략이 모두 같은 조건에서 진다면, 다른 교사를 찾거나 새로운 계획을 만들 방법이 필요하다.
내가 받았던 실행 로그의 stdout과 stderr는 비어 있었고, 직접 쓸 수 있는 정보는 주로 호출 시간이었다. 그렇다고 실행 로그가 시간만 알려 주는 자료는 아니다. 내 에이전트에는 어떤 규칙을 선택했는지, 모델이 낸 명령을 후처리에서 어떻게 바꿨는지, 왜 취소했는지를 기록할 수 있다. 상대의 내부 로그를 볼 수 없는 것과 내 프로그램이 아무 설명도 남기지 않는 것은 다른 문제다.
매 turn 모든 observation을 다시 출력할 필요는 없다. 리플레이에 이미 있는 정보는 가져다 쓰고, 리플레이만으로 알 수 없는 결정 이유를 남긴다. 예를 들면 토지 구매를 검토했지만 내일 재고용할 돈을 남기려고 취소했다는 판단이다. 출력량과 실행 시간에 한도가 있다면 중요한 사건과 규칙별 발동 횟수만 남긴다.
제출 버전과 엔진 빌드에 따른 데이터 연결
한 팀이 오늘 높은 점수를 받았다고 그 팀의 일주일 전 제출까지 강한 교사가 되는 것은 아니다. 같은 팀 이름 아래에도 초반 투자, 생산 품목, 거래 방식이 다른 버전이 있다. 자료를 합칠 때는 이름보다 같은 경기·좌석·프로그램을 가리키는 식별값(key)을 써야 한다.
1
2
3
4
5
경기: episode_id, 생성 시각, 엔진 버전
좌석: episode_id, seat, submission_id, team_id
프로그램: submission_id, 공개/제출 시각, 코드 해시 또는 확인 범위
평점: submission_id 또는 team_id, 관측 시각, 점수의 소유 단위
실행: episode_id, seat, step, duration, 내부 사건
API가 팀 점수만 주면 특정 제출의 점수라고 바꿔 적지 않는다. 제출이 교체되는 시간에 같은 팀의 두 버전이 섞였다면 그 구간을 표시한다. 버전을 확인하지 못했다면 빈칸으로 남긴다. 그래야 교사 선정에서 제외하거나, 그 자료를 빼도 결론이 같은지 확인할 수 있다.
교사를 고를 때도 시점이 중요하다. 당시 알 수 있던 정보로 강자를 골랐다면 어땠을까를 평가하면서 대회 종료 뒤 점수로 과거 기록을 고르면 미래 정보를 사용하게 된다. 대회가 끝난 뒤 가장 좋은 모델의 운영을 배우려는 BC는 목적이 다르다. 어떤 질문에 답할 자료인지 먼저 정한다.
원본 파일과 manifest는 따로 보관한다. manifest는 어느 경기의 어느 좌석을 어떤 버전·목적으로 쓸지 적은 자료 목록이다. 파일을 옮겼을 때도 원본의 해시를 대조해 자료가 바뀌지 않았는지 확인한다.
1
2
3
4
5
6
7
8
9
10
{
  "episode_id": 123456,
  "seat": 0,
  "submission_id": 765432,
  "engine_version": "pinned-engine",
  "replay_sha256": "...",
  "teacher_family": "early-expansion",
  "split": "train",
  "selection_as_of": "2026-10-01T00:00:00Z"
}
이 형식은 다음 프로젝트용 예다. 우승팀 공개 패키지도 교사 좌석을 명시하는 인덱스를 받으며, 경기 결과의 승자나 리더보드 위치로 교사를 자동 추측하지 않는다. 교사 manifest와 중복·분할 처리
경기 좌석 5행의 데이터 결합 예제
가상의 경기 좌석 5행, 좌석별로 요약한 내 실행 로그 3행, 제출 메타데이터 3행을 합쳐 보자. 좌석(seat)은 한 경기에서 어느 플레이어인지를 나타내는 0·1번 자리다. 입력은 모두 11행이지만, 좌석별 결과를 만드는 것이므로 출력은 5행이다. 기준인 경기 좌석을 모두 남기고 일치하는 부가 정보만 붙이는 left join을 쓴다. 내 실행 로그가 없는 상대 좌석도 빠지지 않는다.
실제 실행 로그는 보통 (경기, 좌석, step)마다 한 행이 있어 경기 하나에도 수백 행이 생긴다. 먼저 좌석별 첫 호출 시간·최대 호출 시간·오류 수를 요약해야 아래처럼 좌석당 한 행으로 합칠 수 있다. 어느 수에서 실패했는지 조사할 때는 step까지 맞춰 리플레이와 연결한다. 원시 로그를 그대로 붙여 같은 좌석을 수백 번 센 뒤 승률을 계산해서는 안 된다.
| 경기 | 좌석 | 제출 | 내 은행 / 상대 은행 | 승점 | 내 실행 로그 |
|---|---|---|---|---|---|
| 101 | 0 | 10 | 100 / 80 | 1 | 있음 |
| 101 | 1 | 20 | 80 / 100 | 0 | 없음 |
| 102 | 0 | 10 | 90 / 90 | 0.5 | 있음 |
| 102 | 1 | 30 | 90 / 90 | 0.5 | 없음 |
| 103 | 0 | 10 | 70 / 85 | 0 | 있음 |
다음 코드는 Python 3 표준 라이브러리만 사용한다. rows의 돈은 기록된 결과이며, logs에는 좌석별 최대 호출 시간만 남겼다. meta의 평점은 한 시점에 관측한 팀 평점이다. 이 숫자를 제출 10·20·30의 고유 평점으로 바꾸어 쓰지 않는다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
engine = "toy-engine"
rows = [
    (101, 0, 10, 100, 80),
    (101, 1, 20, 80, 100),
    (102, 0, 10, 90, 90),
    (102, 1, 30, 90, 90),
    (103, 0, 10, 70, 85),
]

# Key: engine, episode, seat, submission.
logs = {
    (engine, 101, 0, 10): {"max_duration": 0.01},
    (engine, 102, 0, 10): {"max_duration": 0.02},
    (engine, 103, 0, 10): {"max_duration": 0.03},
}
snapshot_time = "2026-10-01T12:00:00Z"
meta = {
    10: {"team": "A", "team_rating": 2800},
    20: {"team": "B", "team_rating": 2500},
    30: {"team": "C", "team_rating": 2900},
}

joined = []
seen = set()
seen_seats = set()
for episode, seat, submission, bank, other in rows:
    seat_key = (engine, episode, seat)
    assert seat_key not in seen_seats
    seen_seats.add(seat_key)
    key = (engine, episode, seat, submission)
    assert key not in seen
    seen.add(key)
    point = 1.0 if bank > other else 0.0
    if bank == other:
        point = 0.5
    joined.append({
        "key": key,
        "point": point,
        "execution": logs.get(key),
        "team_snapshot": meta.get(submission),
        "snapshot_time": snapshot_time,
    })

assert not (set(logs) - seen)
mine = [r for r in joined if r["key"][3] == 10]
matched = sum(r["execution"] is not None for r in joined)
points = sum(r["point"] for r in mine)
print("inputs:", len(rows), len(logs), len(meta))
print("joined / logs / missing:", len(joined), matched,
      len(joined) - matched)
print("submission 10:", points, "/", len(mine),
      "=", points / len(mine))
출력은 inputs: 5 3 3, joined / logs / missing: 5 3 2, submission 10: 1.5 / 3 = 0.5다. 원본 11행을 11경기로 세거나, 합친 5좌석을 한 정책의 5경기로 세면 안 된다. 제출 10의 분모는 3이다.
같은 경기 양쪽의 승점은 서로 연결돼 있다. 자료를 합친 것은 누가 언제 무엇을 했나를 정리한 단계이며, 누가 더 강한지 판단하는 일은 그다음이다. 위처럼 팀 점수를 한 번 저장한 snapshot만으로는 경기 당시 평점을 알 수도 없다. 시간에 따른 변화를 보려면 점수를 확인할 때마다 시각과 함께 저장해야 한다.
logs.get(key)와 meta.get(submission)는 일치하는 정보가 없으면 None을 남긴다. 상대 좌석에 내 실행 로그가 없는 것은 당연하지만, 내 좌석의 로그가 빠졌거나 교사 버전을 모르는 것은 수집이 덜 된 것이다. 같은 None이어도 이유를 구분해 센다. 전체 좌석 수 → 버전을 확인한 좌석 수 → 리플레이를 받은 수 → 내 실행 로그를 받은 수를 적으면 어떤 분석에 자료가 부족한지 보인다.
자료를 합치기 전에 중복도 검사한다. 이 예제의 seen과 seen_seats는 같은 경기 좌석을 두 번 세지 않게 한다. Python dictionary인 logs와 meta는 같은 키를 두 번 넣으면 앞의 값을 덮어쓴다. 따라서 원본 CSV나 JSONL을 dictionary로 바꾸기 전에 같은 키의 내용이 충돌하지 않는지 확인해야 한다. 실제 시간별 메타데이터에서는 시각도 키에 포함하고, 나중에 얻은 점수를 과거에 알았던 것처럼 붙이지 않는다.
2. Teacher 데이터의 선정과 전처리
승패 기록과 운영 방식에 따른 teacher 선정
강자의 승리만 모으면 좋은 운영은 볼 수 있지만, 불리한 세계에서의 복구가 빠질 수 있다. 반대로 순위가 높은 여러 팀을 모두 섞으면 초반 계획이 충돌할 수 있다. 한 교사는 노동에 먼저 투자하고 다른 교사는 현금을 모아 가축을 산다면, 두 교사의 중간 행동은 어느 계획도 완성하지 못할 수 있다.
처음에는 운영 방식이 일관된 강한 버전 하나나 소수로 시작하는 편이 문제를 찾기 쉽다. 교사가 봤던 observation에서 행동을 맞히는지 검사하고, 모델을 직접 플레이시켜 끝까지 운영하는지도 확인한다. 그 뒤 부족한 전략을 가르칠 교사를 추가한다. observation에 전략을 구별할 정보가 충분하다면 한 모델이 여러 운영을 배울 수 있다. 문제는 구별할 단서가 없는 상태에 서로 다른 정답을 주고 있지는 않느냐는 것이다.
70위의 replay BC·교사 선택 글은 넓은 자료에서 출발한 뒤 강하고 호환되는 교사 계열로 좁히는 과정을 설명한다. 교사의 유명세와 데이터 양보다 우리 표현과 실행기로 끝까지 배울 수 있는 운영인지가 중요하다.
Observation–action의 시간 정렬
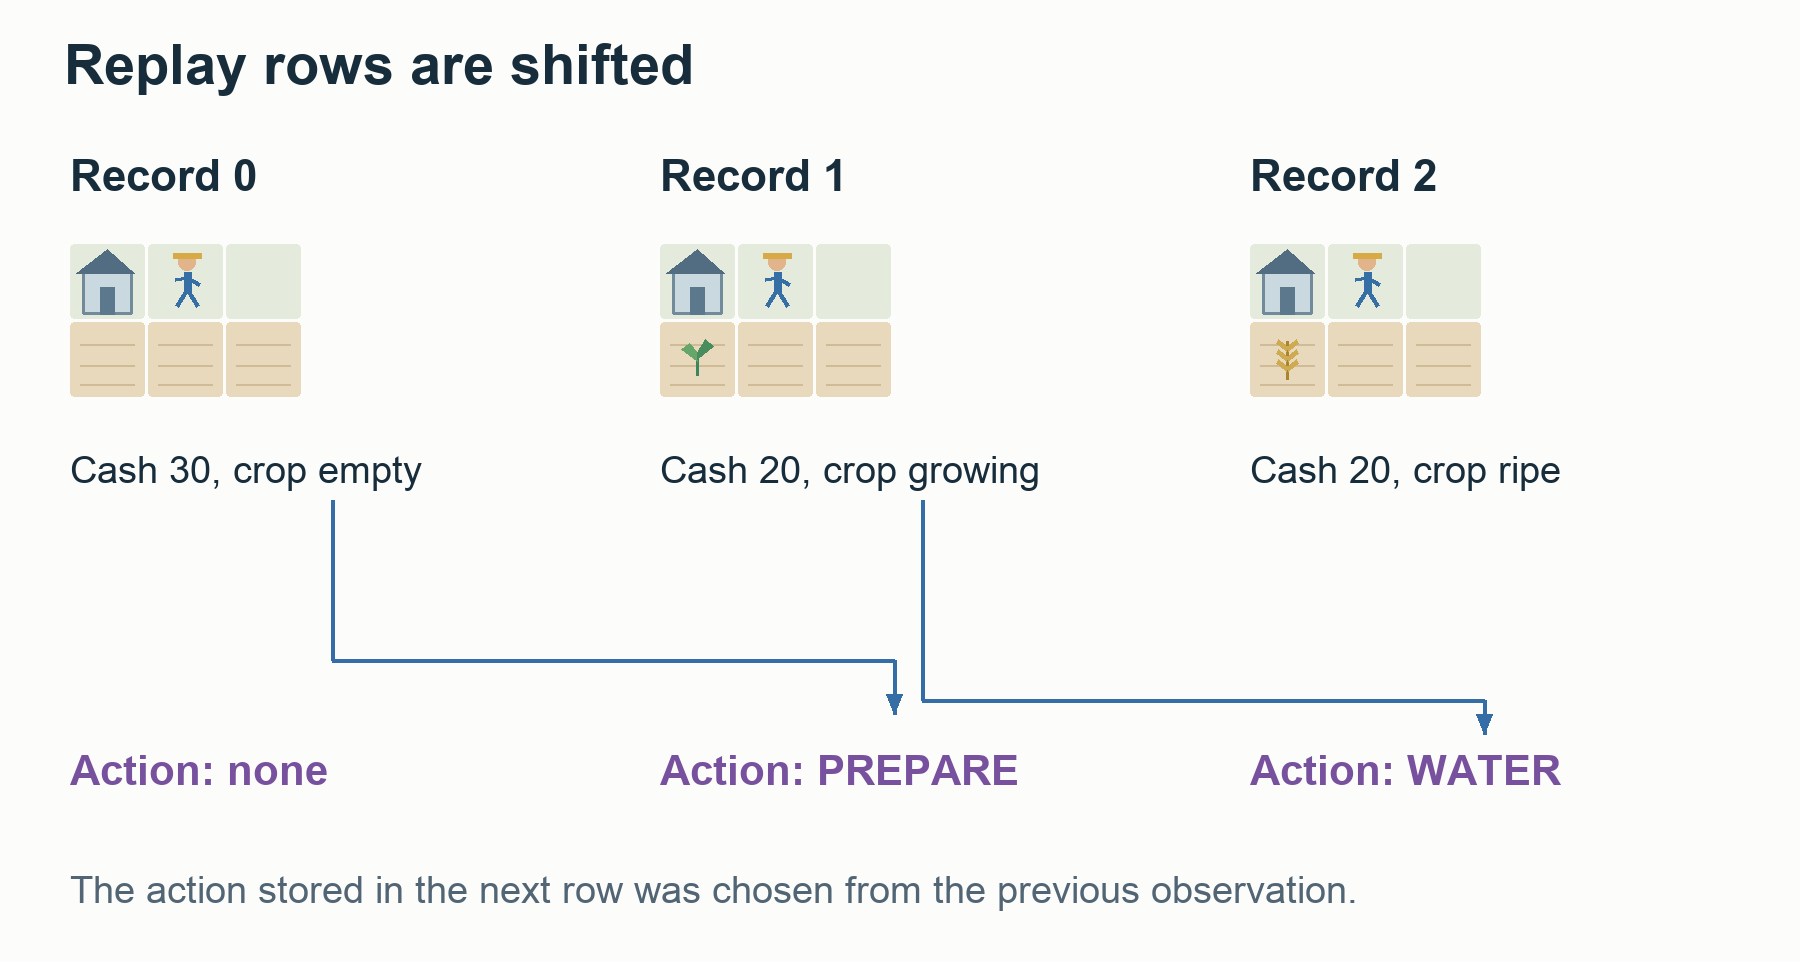
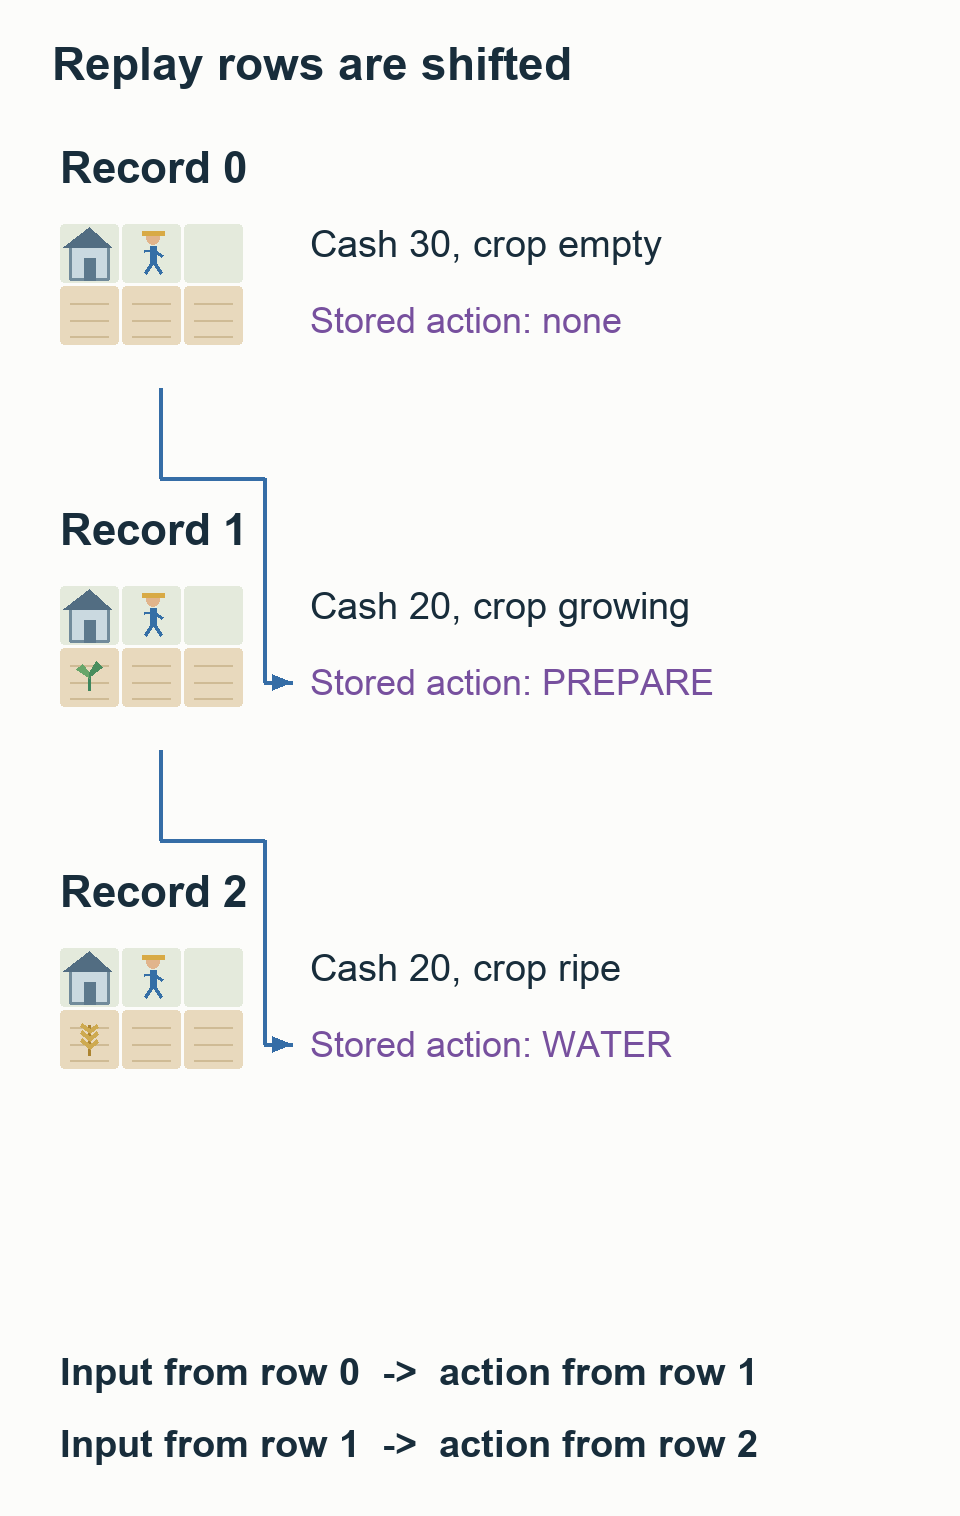
리플레이의 steps[t]에 들어 있는 행동이 observation[t]를 보고 고른 행동인지, 이전 관측의 결과로 기록된 행동인지 확인해야 한다. 한 칸만 어긋나도 모델은 행동의 원인 대신 결과를 입력받을 수 있다.
우승팀의 Kaggriculture 추출 코드는 observation[t]와 action[t+1]을 연결한다. 720개 상태에서 719개 의사결정을 만든다. 다른 게임에도 무조건 한 칸을 미는 규칙은 아니다. 공식 엔진의 기록 규약을 확인하고, 구매·이동·수확처럼 상태 변화가 보이는 몇 수를 직접 따라가며 맞춘다. 실제 추출 루프
한 표본을 다음 다섯 칸으로 펼쳐 보면 오류를 빨리 찾을 수 있다.
1
2
3
4
5
1. 이 결정을 내리기 직전에 정책이 본 관측
2. 원래 요청한 행동과 시장 주문의 순서
3. 엔진이 실제 실행한 양과 실패한 부분
4. 학습에 사용할 라벨과 무시할 라벨
5. 모델 출력을 다시 명령으로 바꿨을 때의 결과
3 → 4 → 5의 왕복이 틀리면 교사를 완벽히 외워도 약한 농장이 된다. 전체 정확도만 보면 이런 문제를 놓치기 쉽다. 이동과 PASS를 잘 맞히면서 드문 고용 한 번을 놓치면 그 뒤 수백 수의 생산이 바뀔 수 있기 때문이다.
시장 주문의 순서와 체결량 처리
현금이 100이고 앞 주문에서 물건을 팔아 50을 받은 뒤, 뒷 주문에서 120짜리 투자를 할 수 있다고 하자. 두 주문을 종류순으로 정렬해 구매부터 처리하면 현금 부족으로 실패한다. 비교의 편의를 위해 주문을 정렬하는 순간 다른 정책이 된다.
학습 정답인 label을 만들 때도 무효 주문을 지워 버리면 안 되는 경우가 있다. 엔진이 양쪽 주문을 슬롯별로 번갈아 처리한다면, 2번 슬롯을 지워 3번 주문을 당기는 것만으로 상대 주문과의 선후 관계가 달라진다. 제자리에 SKIP을 남길지, 그 정답만 loss에서 제외할지, 요청량과 체결량을 어떻게 구분할지 정해야 한다. 모델 출력을 실제 명령으로 바꾸는 decoder도 이 처리와 맞아야 한다.
우승팀 코드는 무효·미실행 행동의 라벨을 제외하고, SELL은 요청량이 아닌 실제 체결한 절대 수량을 정답으로 만든다. 구매 계열까지 모두 체결량 라벨로 통일한 것은 아니다. 같은 전처리 안에서도 행동 종류별 의미가 다르다. 라벨 생성 함수
decoder는 앞선 선택이 소비한 자원도 반영해야 한다. 이미 쓴 씨앗을 다른 일손도 쓰게 하거나, 가방의 물건을 창고 재고로 착각하면 행동 하나하나가 맞아도 전체는 실패한다. 같은 turn에 일손이 창고에 내려놓을 물건은 시장 처리 때 팔 수 있으므로, 현재 창고만 보고 판매를 막는 것도 잘못이다. 학습 정답을 만드는 규칙, 가능한 선택을 표시하는 mask, 자원 계산, 실제 명령이 서로 맞아야 한다. 24위의 실행·디코더 분석
학습 목표와 policy 입력의 정보 범위
미래 보상으로 현재 행동의 가치를 학습하는 것은 RL의 기본이다. 그러나 내 정책이 아직 보지 못한 미래 상점이나 상대의 비공개 재고를 현재 입력으로 받으면 다른 문제가 된다. 관전자 리플레이가 완전한 정보를 갖고 있어도 플레이어에게 허용된 관측만 인코딩한다.
가치 함수만 훈련 중 추가 정보를 쓰는 설계도 가능하지만, 실행 정책과의 정보 경계를 명시적으로 나눠야 한다. 처음 작은 파이프라인을 만들 때는 입력을 일관되게 제한하는 편이 검사하기 쉽다.
3. 학습·개발·후보 선택·최종 검증 데이터의 분리
학습할 자료를 모은 dataset을 train/validation으로 나누는 것만으로 대회 평가가 끝나지는 않는다. BC의 validation은 학습하지 않은 기록에서 교사 행동을 얼마나 잘 맞히는지 보는 자료다. 새 정책이 실제로 강한지 확인하려면 직접 대전시켜야 한다. 다음 네 역할을 나눠 두면 정답을 잘 맞힌 결과와 더 잘 플레이한 결과를 혼동하지 않을 수 있다.
| 역할 | 사용하는 일 | 반복해서 봐도 되는가? |
|---|---|---|
| 학습 | BC·가치 함수·PPO 갱신 | 갱신 알고리즘이 허용하는 범위에서 사용 |
| 개발 | 표현·보상·decoder·저장한 모델(checkpoint) 선택 | 가능하나 이 결과에 맞춘 선택이 쌓임 |
| 후보 선정용 평가 | 정한 소수 후보 중 다음 하나 선택 | 그 결과를 보고 고른 만큼 최종 독립 증거는 아님 |
| 최종 확인 | 고정한 한 후보가 기준보다 나은지 판정 | 결과를 본 뒤 수정하면 새 확인 필요 |
예산이 작으면 개발과 후보 선정을 한 묶음으로 합칠 수 있다. 이름을 네 개 붙이는 것이 목적은 아니다. 어디까지 보고 골랐고 무엇을 아직 보지 않았는지가 남아야 한다.
보통 train은 가중치 갱신용, dev 또는 validation은 수정·선택용, holdout은 마지막까지 선택에 쓰지 않고 남겨 둔 자료를 뜻한다. 이름보다 실제로 어떻게 썼는지가 중요하다. holdout이라는 이름으로 저장했어도 결과를 보고 모델을 고쳤다면 그 뒤에는 개발 자료다. 최종 확인에 쓸 새로운 세계와 상대·평가 방법은 미리 정하고, 후보를 고정한 뒤 판단에 사용한다.
리플레이는 최소 경기 단위로 나눈다. 같은 경기의 양쪽 좌석과 인접한 수를 train과 validation에 나누면 같은 세계의 거의 같은 상태가 양쪽에 나타난다. 우승팀도 경기 ID 해시로 분할하고 양 좌석을 함께 둔다. 분할 함수와 추출 결과
앞의 자료에서 경기 101을 학습에 넣었다면 좌석 0과 1을 모두 학습에 둔다. 경기 102를 개발용으로 골랐다면 그 두 좌석도 함께 둔다. 경기를 나눈 뒤 각 경기의 719개 표본을 펼치는 순서다. 먼저 모든 수를 섞은 다음 임의로 90:10을 나누면 이 경계가 깨진다.
경기별로 나눈 뒤에도 확인할 것이 있다. 거의 같은 교사 버전이 양쪽에 있으면 새로운 버전을 잘 다룬다는 증거는 되지 않는다. 새로운 상점 조합에 강해지고 싶은지, 다른 상대 스타일을 이기고 싶은지, 다음 주에도 통할 전략을 원하는지에 따라 조건·버전·시기를 더 나눠서 확인한다.
최종 확인에서 점수가 아쉽다고 seed를 바꾸고 다시 고르면 그 확인도 개발 데이터가 된다. 표본을 늘릴 수는 있지만, 언제 얼마나 늘릴지 미리 정하거나 순차 판단에 맞는 방법을 써야 한다. 유리한 순간에만 멈춘 결과를 보통의 고정 표본 신뢰구간으로 설명하지 않는다.
4. Reactive 상대와 replay 상대의 검증 범위
강자의 명령을 녹화대로 내게 하고 내 행동만 바꾸면 많은 가설을 빠르게 시험할 수 있다. 토마토를 더 팔면 이익인지, 마지막 운반이 가능한지 확인하는 데 유용하다. 그러나 내가 시장을 바꿔도 상대는 원래 주문을 그대로 낸다. 새 상황에 맞춰 판단하는 실제 프로그램과의 대전은 아니다.
| 상대 형태 | 유용한 일 | 강도 평가의 한계 |
|---|---|---|
| 고정 녹화 테이프 | 시연 재현, 경제 분해, 값싼 초기 가설 검토 | 시장·자원 변화에 적응하지 못함 |
| 관측으로 고르는 조건부 테이프 | 알려진 세계에 맞는 전체 계획 선택 | 선택 이후의 반응 범위가 제한됨 |
| 직접 실행하는 상대 코드 | 바뀐 시장에 상대도 대응하는 대전 | 구할 수 있는 코드만 시험할 수 있음 |
| 원래 상태에서 복제한 양측 환경·기억 | 특정 분기 대안의 실제 반응 비교 | 기억·난수·엔진 복제가 정확해야 함 |
녹화 상대가 현금 부족으로 운영을 멈추면 내 후보가 큰돈을 벌 수 있다. 상대에게 대출을 주거나 주문을 정렬해 녹화를 이어 가는 훈련 장치를 만들 수도 있지만, 그렇게 얻은 성적을 실제 상대 프로그램에 대한 승률로 해석해서는 안 된다.
우리 kenjo 완전 테이프도 옛 E3 패널은 통과했지만 실제 적응형 yhay81 라우터를 상대로 11승 37패였다. 여기서 얻을 교훈은 완전 계획 복사를 금지하는 것이 아니다. 계획의 좋은 생산력과 상대 변화에 대한 견고성을 서로 다른 시험으로 확인해야 한다는 것이다. 당시 원장·판정 근거를 정리한 이전 글
최상위 팀의 코드가 공개되지 않았다면 그 프로그램을 상대로 직접 시험하지 못한 것이다. 그 팀의 경기 기록을 재생했다고 금메달권의 실제 판단 능력까지 시험한 것은 아니다. 결과표에도 녹화 재생과 코드 실행을 나눠 적는다.
5. Policy × 상대 × world × seat의 벤치마크 설계
실전 로그는 누구를 자주 만나고 어디서 지는지 알려 준다. 그러나 상대와 조건이 다른 과거 성적만으로는 새 후보 때문에 얼마나 좋아졌는지 구분하기 어렵다. 로그에서 시험할 상대와 가설을 고른 뒤, 조건을 맞춘 새 대전에서 비교 기준인 baseline과 후보를 실행한다. 아래 짝 비교는 그런 직접 설계한 대전의 계산이다.
승률 해석에 필요한 상대 분포
승패로 순위를 매기는 게임이라면 승점은 중요한 최종 지표다. 문제는 서로 다른 상대를 섞은 숫자 하나가 무엇을 뜻하는지다. 가령 무승부가 없는 다음 결과를 생각해 보자.
| 정책 | 쉬운 상대 E | 강한 상대 H |
|---|---|---|
| 기준 A | 90% | 30% |
| 후보 B | 80% | 50% |
상대 비중이 E:H=80:20이면 A는 78%, B는 74%다. 20:80이면 A는 42%, B는 56%다. 같은 후보가 더 강한지에 대한 답이 달라지는 이유는 게임 결과가 틀려서가 아니라 최대화하려는 상대 분포가 바뀌었기 때문이다.
최근 내 경기에서 상대를 얼마나 자주 만났는지는 가중치를 정할 근거가 된다. 최종 평가에서도 같은 비중일지는 모르므로, 최근 빈도로 계산한 값과 앞으로의 상대 구성을 가정한 값을 따로 둔다. 같은 공개 파일의 복사본을 많이 만난다면 그 빈도도 반영하되, 전략 계열마다 같은 비중을 준 결과도 함께 본다. 자주 만나는 상대에게 강한지와 여러 스타일에 강한지는 다른 질문이다.
World별 paired 비교와 좌석 교대
상점 추첨 같은 초기 조건 한 묶음을 world라고 하자. 아래의 ‘세계’는 이 게임 조건을 뜻한다. 가능하면 baseline과 후보에 같은 조건을 주고 좌석을 바꾼다. 후보는 운 좋은 경기, baseline은 운 나쁜 경기에서 실행한 뒤 차이를 정책 효과로 착각하지 않으려는 것이다. 상대 하나와 세계 하나를 고정하고 후보·baseline을 각각 양 좌석으로 실행하면 네 경기가 된다.
이때 세계 번호와 경기 번호는 다르다. 같은 초기 조건을 공유한 네 대전에도 서로 다른 경기 기록이 생긴다. 결과를 policy_hash, opponent_hash, world_id, seat로 저장하고 각 행에 실제 episode_id를 붙여야 나중에 같은 조건의 네 결과를 찾을 수 있다.
무승부는 0.5점으로 두자. 상대 $j$, 세계 $s$, 좌석 $r$에 대한 승점을 $y_{pjsr}$라고 하면 세계별 차이는 다음처럼 쓸 수 있다.
\[d_{js}=\frac{1}{2}\sum_{r=0}^{1} \left(y_{\mathrm{candidate},jsr}-y_{\mathrm{baseline},jsr}\right).\]상대 가중치 $w_j$를 고정하면 최종 요약은 다음과 같다.
\[\widehat\Delta=\sum_jw_j\frac{1}{n_j}\sum_sd_{js}, \qquad \sum_jw_j=1.\]계산은 세 번의 평균이다. 먼저 한 세계에서 두 좌석의 차이를 평균해 $d_{js}$를 만든다. 그다음 상대 $j$의 $n_j$개 세계를 평균한다. 마지막으로 상대별 비중 $w_j$를 곱해 더한다. 가중치가 큰 상대를 이기는 변화가 최종 요약에도 더 크게 반영된다.
승점이 0.52 → 0.55면 변화는 +0.03, 즉 승점 3%포인트다. 상대를 바꾸지 않은 같은 비교의 차이인지도 함께 적는다. 여러 작은 층을 합쳤을 때의 변화는 층별 숫자를 단순히 더하기보다 최종 합성 후보를 다시 비교해 확인한다.
seed는 난수 생성을 시작할 때 쓰는 값이다. seed가 같다고 모든 추첨 결과가 같아지는 것은 아니다. 행동에 따라 난수를 꺼내 쓰는 횟수가 달라지면 같은 seed에서도 이후 추첨이 달라질 수 있다. 정책과 무관한 추첨을 따로 관리하는지, 중간 상태와 난수를 그대로 복제해 이어갈 수 있는지 엔진을 확인한다. 지원하지 않으면 그 한계를 적는다. 조건을 같게 만들려고 상대 반응까지 고정하지는 않는다. 내 행동으로 시장과 상대가 달라지는 효과는 측정에 포함해야 한다.
10개 world의 가중 승점 차이 계산
가상의 상대군 E와 H에 가중치 0.7과 0.3을 주자. 각 상대군에는 여기서 실행할 대표 프로그램 하나가 있다. 열 세계 모두에서 기준과 후보를 양 좌석으로 실행한다. 필요한 결과 수는 2정책 × 2상대 × 10세계 × 2좌석 = 80경기다.
경기 결과는 80개지만 여기서 독립적으로 뽑은 세계는 10개다. 한 세계에 E 상대의 네 경기와 H 상대의 네 경기, 총 여덟 경기가 묶인다. 세계를 재추출할 때 이 여덟 결과를 함께 움직여야 한다.
기준은 모든 경기에서 무승부를 거둔다고 하자. 후보는 E의 첫 네 세계에서 한 좌석의 무승부를 승리로 바꾼다. H에서는 첫 두 세계가 개선되지만 다음 두 세계가 나빠진다.
| 세계 | 기준 양 좌석 승점 | E의 후보 승점 | E의 차이 | H의 후보 승점 | H의 차이 |
|---|---|---|---|---|---|
| 1–2 | (0.5, 0.5) | (1, 0.5) | +0.25 | (1, 0.5) | +0.25 |
| 3–4 | (0.5, 0.5) | (1, 0.5) | +0.25 | (0, 0.5) | −0.25 |
| 5–10 | (0.5, 0.5) | (0.5, 0.5) | 0 | (0.5, 0.5) | 0 |
E의 평균 변화는 4 × 0.25 / 10 = +0.10, H는 (+0.5 − 0.5) / 10 = 0이다. 따라서 가중 변화는 0.7 × 0.10 + 0.3 × 0 = +0.07이다. 전체를 동일 가중치로 섞으면 +0.05이므로, 요약표에는 가중치도 있어야 한다.
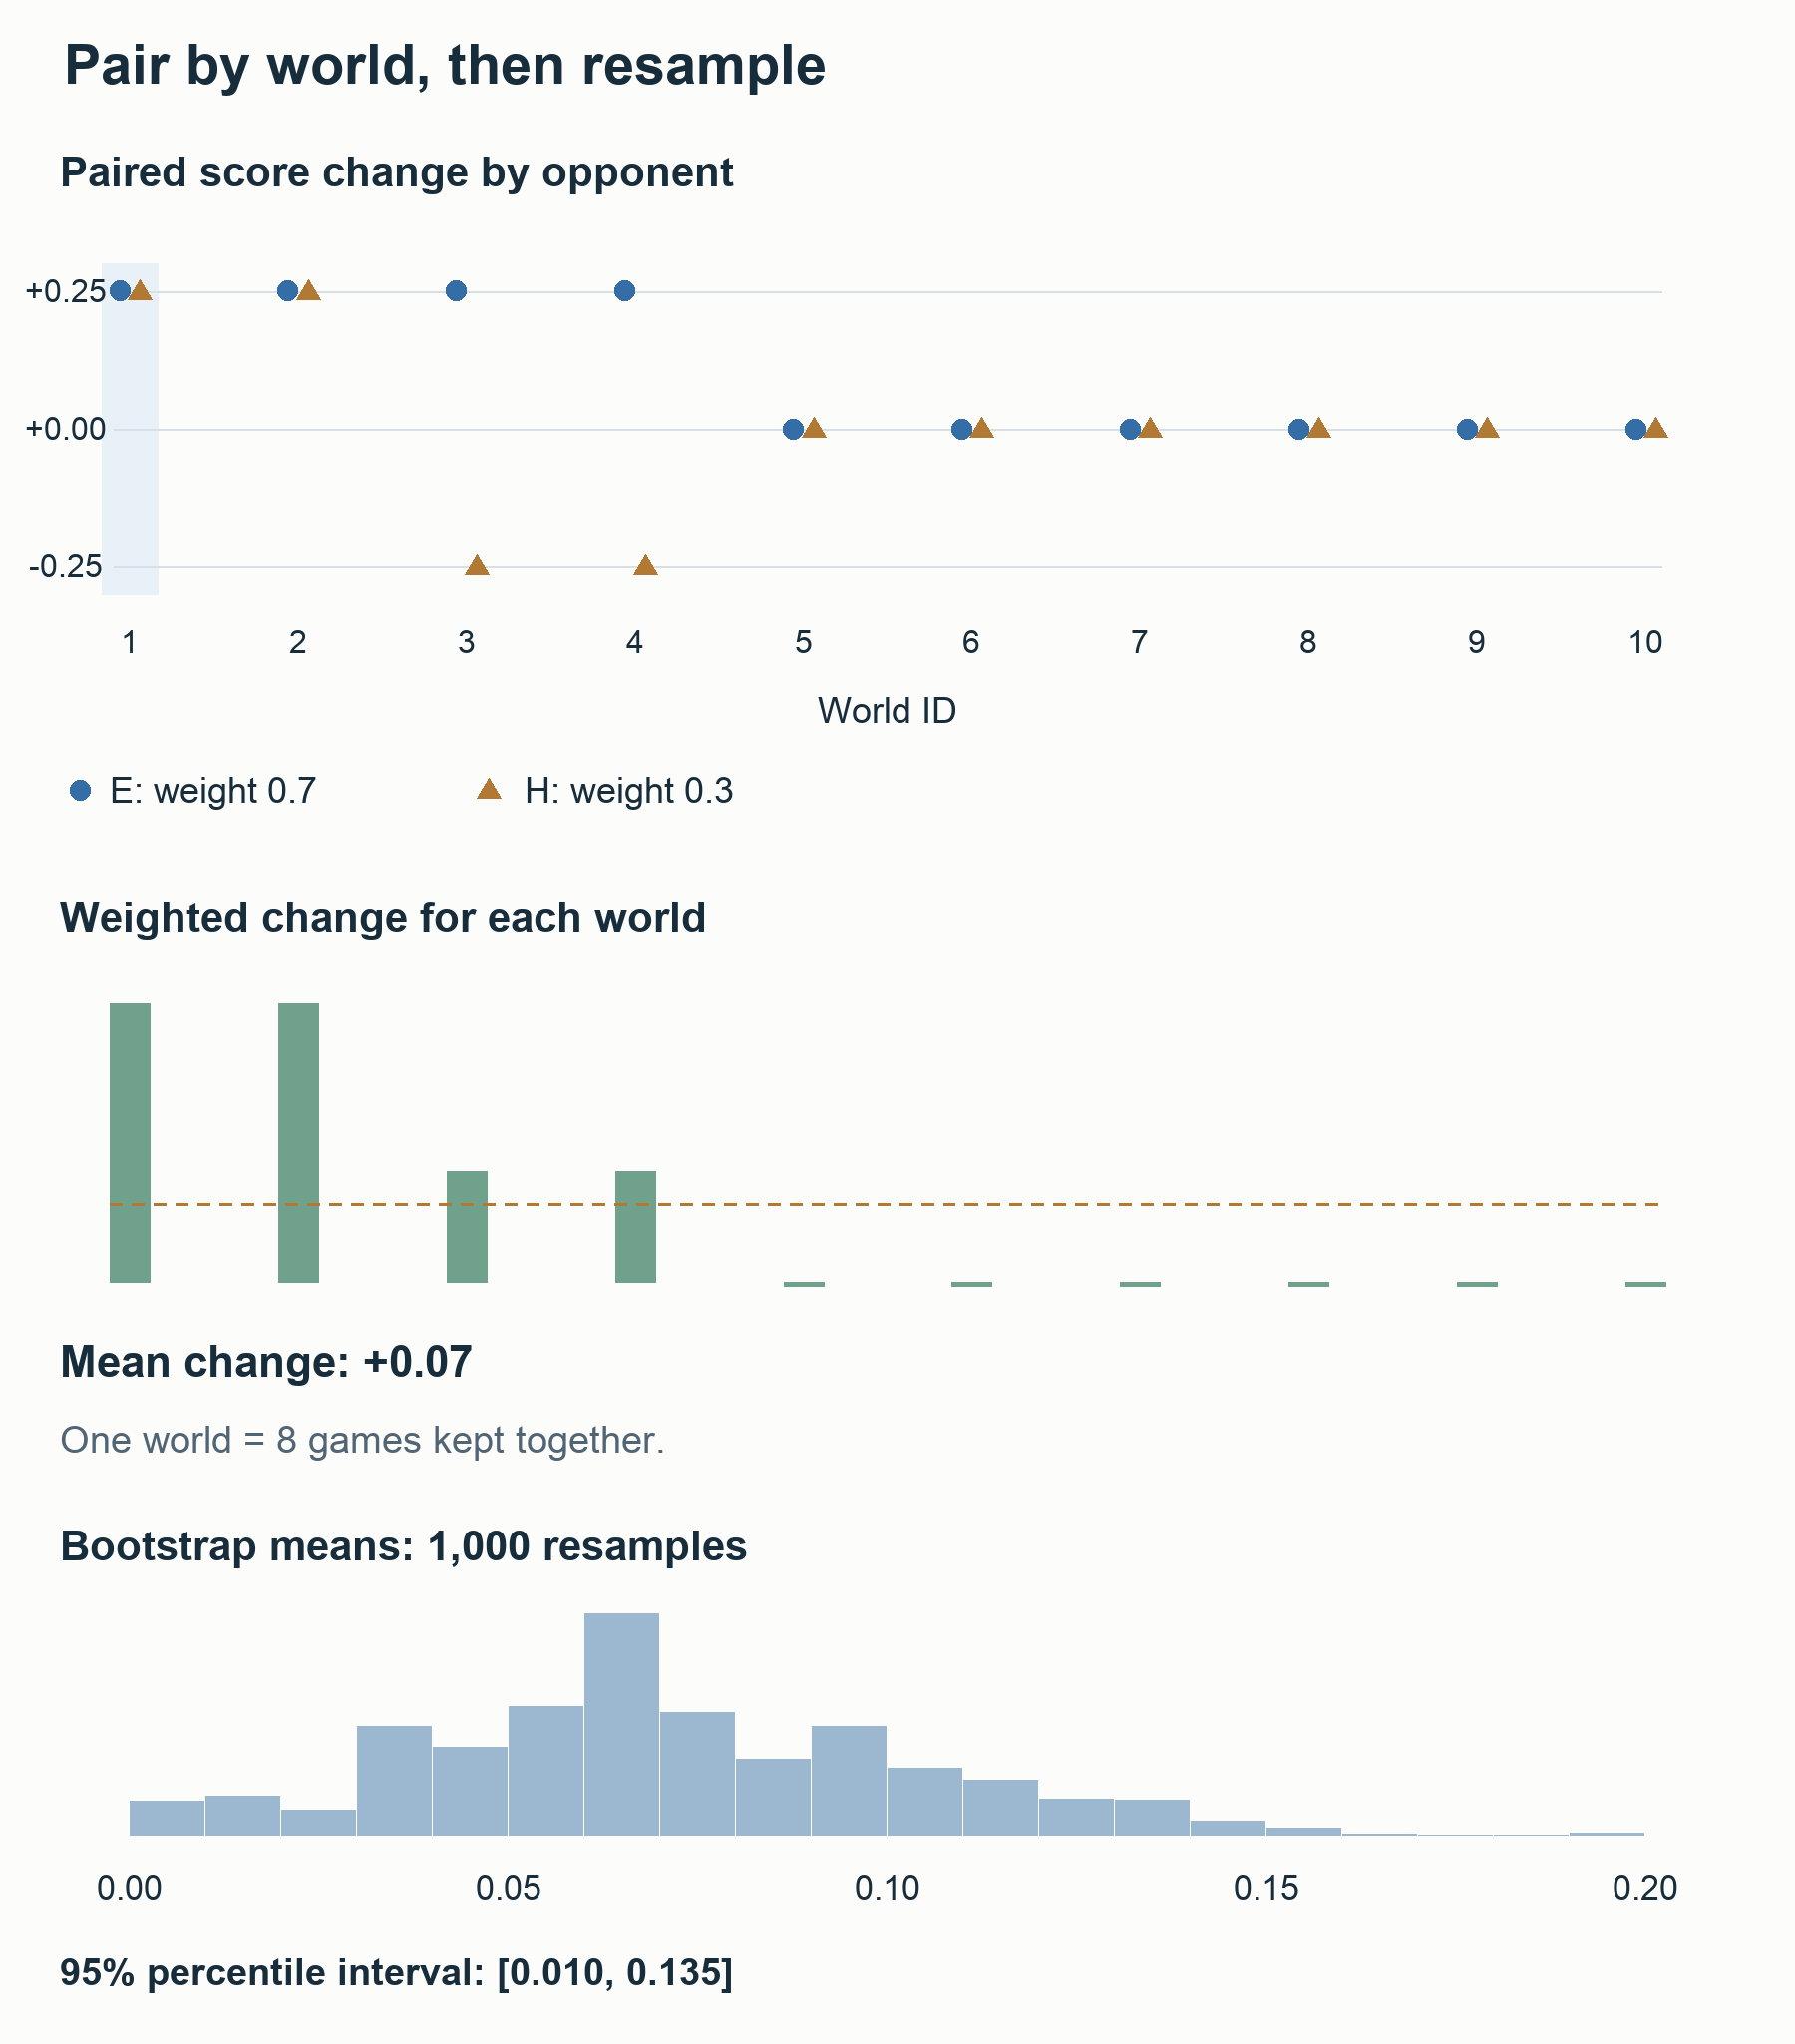
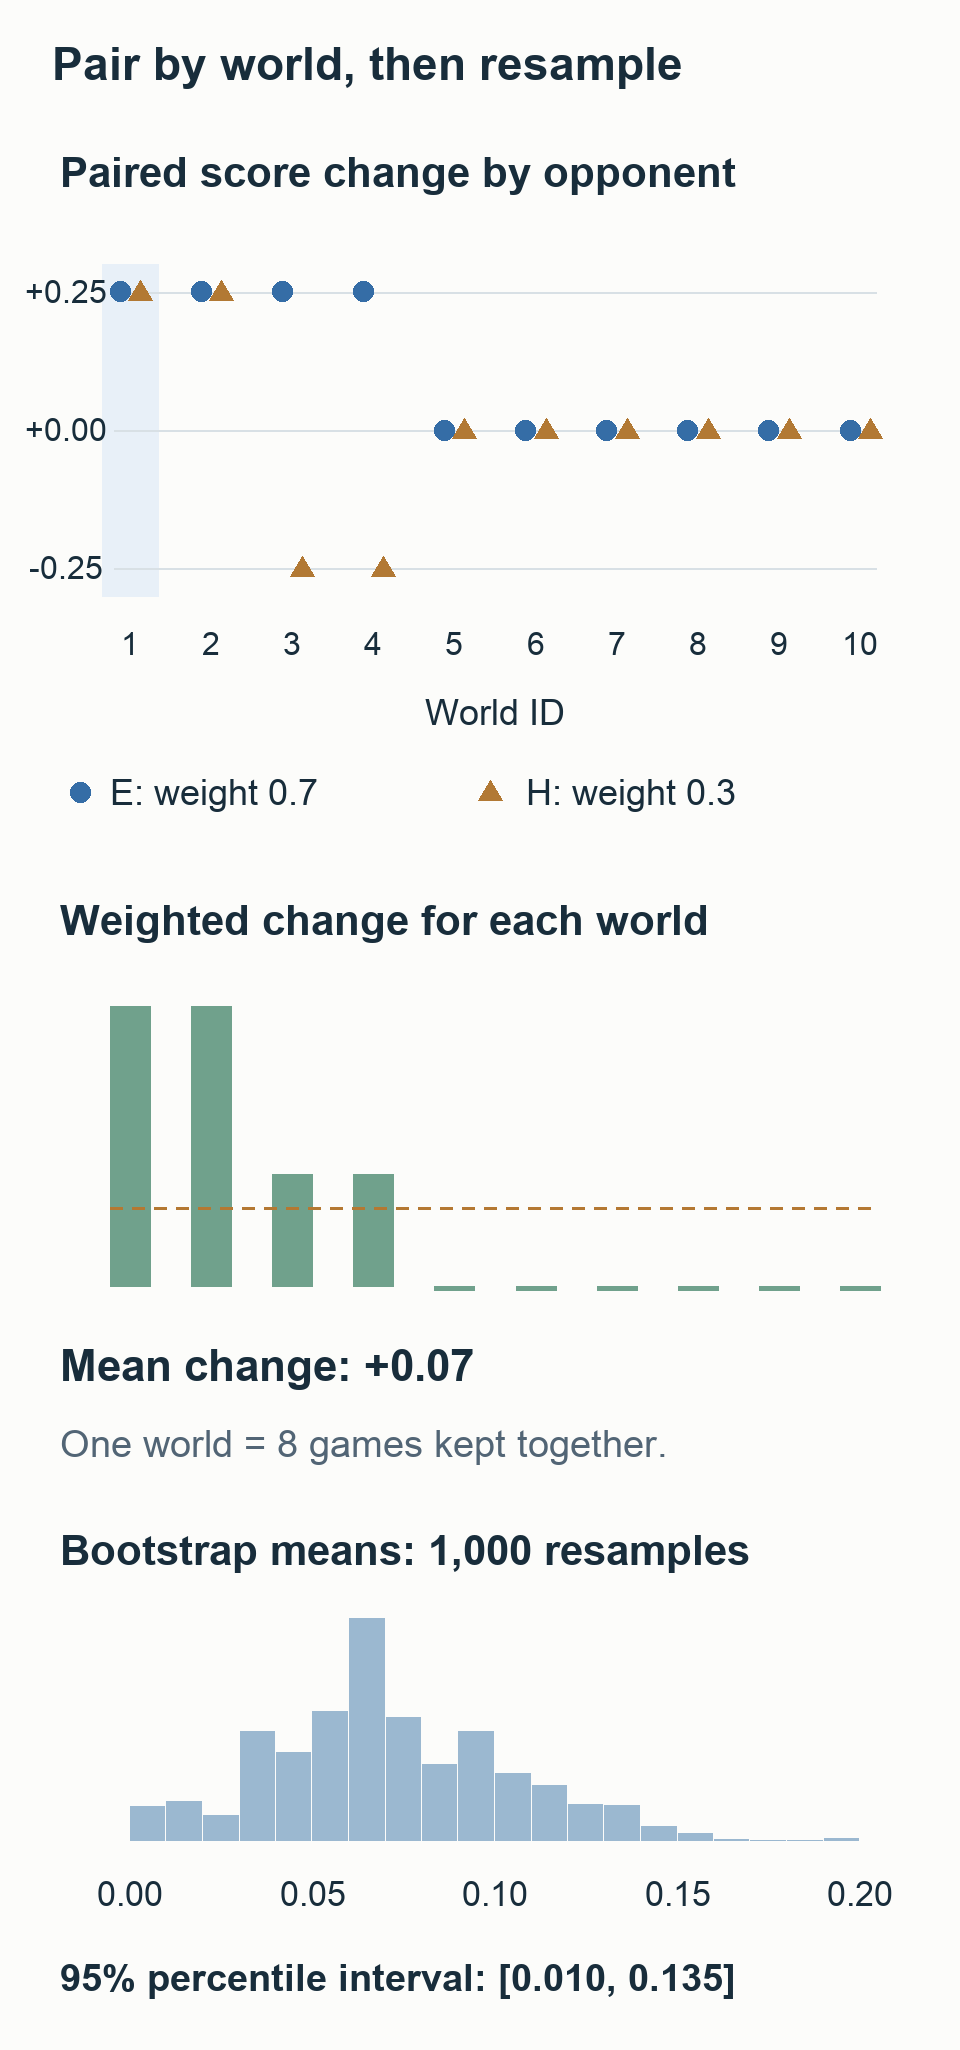
세계별 차이의 평균이 +0.07이어도 열 세계를 우연히 잘 골랐을 수 있다. 여기서 통계적 bootstrap은 기존 세계를 중복을 허용해 다시 뽑는 계산이다. 2편에서 다음 상태의 가치 예측으로 현재 학습 정답을 만드는 bootstrapping과는 다른 계산이다. 한 번에 열 세계를 뽑되 같은 세계가 두 번 나올 수도 있고 다른 세계가 빠질 수도 있다. 이렇게 만든 자료에서 평균을 다시 계산하는 일을 반복해 평균이 얼마나 흔들리는지 본다. 새 경기를 생성하는 작업은 아니다.
표의 세계 1–10은 코드에서 0–9로 번호를 붙였다. 예를 들어 그림 8의 세계 1·상대 E의 차이는 pair_delta("E", 0)이다. 다음 코드는 열 세계를 다시 뽑아 평균을 구하는 일을 1,000회 반복한다. 같은 세계의 양 좌석, 두 정책, 두 상대를 한 묶음으로 유지한다. 상대와 가중치는 고정하고 세계 표본만 바꾸므로, 새 상대가 등장할 불확실성은 이 계산에 들어 있지 않다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
from random import Random

worlds = list(range(10))
weights = {"E": 0.7, "H": 0.3}
baseline = {}
for opponent in weights:
    for world in worlds:
        for seat in (0, 1):
            baseline[opponent, world, seat] = 0.5
candidate = baseline.copy()

for world in range(4):
    candidate["E", world, 0] = 1.0
for world in range(2):
    candidate["H", world, 0] = 1.0
for world in range(2, 4):
    candidate["H", world, 0] = 0.0

def pair_delta(opponent, world):
    changes = []
    for seat in (0, 1):
        key = (opponent, world, seat)
        changes.append(candidate[key] - baseline[key])
    return sum(changes) / 2

group_means = {
    opponent: sum(pair_delta(opponent, w) for w in worlds)
    / len(worlds)
    for opponent in weights
}
world_changes = [
    sum(weights[o] * pair_delta(o, w) for o in weights)
    for w in worlds
]
estimate = sum(world_changes) / len(worlds)

rng = Random(2026)
bootstrap = []
for _ in range(1000):
    sampled = rng.choices(world_changes, k=len(worlds))
    bootstrap.append(sum(sampled) / len(sampled))
bootstrap.sort()

def percentile(sorted_values, q):
    position = (len(sorted_values) - 1) * q
    left = int(position)
    right = min(left + 1, len(sorted_values) - 1)
    fraction = position - left
    return (sorted_values[left] * (1 - fraction)
            + sorted_values[right] * fraction)

lo = percentile(bootstrap, 0.025)
hi = percentile(bootstrap, 0.975)
assert len(baseline) == len(candidate) == 40
assert set(candidate.values()) <= {0.0, 0.5, 1.0}
print("games / world clusters:", 80, len(worlds))
print("E / H:", *(round(group_means[o], 3) for o in weights))
print("weighted change:", round(estimate, 3))
print("bootstrap interval:", round(lo, 3), round(hi, 3))
weighted change: 0.07, bootstrap interval: 0.01 0.135가 나온다. 코드의 pair_delta()는 양 좌석의 차이를 평균하고, world_changes는 같은 세계의 E·H 결과에 0.7·0.3을 곱해 합친다. 가중치가 고정돼 있어 이 세계별 요약을 다시 뽑는 것은 원래의 결과 묶음을 함께 뽑는 것과 같은 계산이다.
다시 뽑는 값은 [0.25, 0.25, 0.10, 0.10, 0, …, 0]다. 경기 80개를 따로 뽑아 원래의 짝을 깨는 방식과 다르다. 코드가 1,000개 평균을 정렬한 뒤, percentile()로 2.5%와 97.5% 위치의 값을 보간해 구간을 만든다. 어떤 세계가 표본에 들어가느냐에 따라 평균이 얼마나 달라질 수 있는지 보는 계산이다. 새 세계 하나에서 개선될 확률이 95%라는 뜻은 아니다.
세계가 열 개뿐인 이 가상 예제의 bootstrap 구간을 그대로 채택 기준으로 삼을 수는 없다. 실제로는 세계 수, 시험한 상대가 실전을 얼마나 대표하는지, 후보를 몇 번 골랐는지도 함께 본다. 예제에서 확인할 것은 결과 80개가 어떻게 10개의 묶음이 되고, 가중치가 최종 평균에 어떻게 들어가는지다.
World 단위 bootstrap과 유효 표본 수
한 경기에서 나온 719수는 승패 평가의 719개 독립 표본이 아니다. 양 좌석의 쌍도 같은 세계를 공유한다. 불확실성을 계산할 때는 관련된 결과를 한 덩어리로 묶는다.
같은 세계에서 모든 상대를 시험했다면 그 세계의 정책·상대·좌석 결과를 통째로 다시 뽑는다. 이렇게 관련된 표본을 묶어서 뽑는 방법이 cluster bootstrap이다. 상대마다 독립적으로 뽑은 세계를 썼다면 각 상대 안에서 세계별 묶음을 다시 뽑는다. 이 계산이 다루는 것은 정해 둔 상대를 시험했을 때의 표본 오차다. 앞으로 다른 상대가 등장할 위험은 다른 계열·버전을 추가하거나 상대 구성을 바꿔 계산해 봐야 한다.
구간의 아래끝이 0보다 큰지만 보면 실용성도 놓칠 수 있다. 아주 작은 개선에 출시 비용이 큰 대회라면 필요한 최소 효과를 먼저 정한다. 반대로 표본이 작아 구간이 넓고 0을 포함하면 개선 여부를 아직 구분하지 못한 것일 수 있다. 곧바로 두 정책이 같거나 후보가 열등하다고 결론 내리지 않는다. 효과 크기, 불확실성, 중요한 상대군에서 성적이 나빠진 정도, 남은 비용을 함께 판단한다.
후보 100개 중 개발 결과가 가장 좋은 하나를 골랐다면 선택 자체가 낙관 편향을 만든다. 그 100개에 모두 거대한 최종 대전을 돌릴 필요는 없다. 작은 내부 점수와 개발 패널로 줄인 뒤, 고정한 후보 하나를 새로운 조건에서 확인한다.
Bank margin과 승점의 용도 구분
우리 은행이 5,000 늘어도 상대가 7,000 더 벌면 패배할 수 있다. 압승 한 판에서 20,000을 더 벌고 박빙 여러 판에서 지면 평균 은행은 좋아져도 승점은 떨어질 수 있다.
따라서 결과표에는 승점과 함께 우리·상대 은행, 상품별 매출, 투자 시점, 생산량, 미판매 재고를 둔다. 은행 차이는 어떤 경제 경로가 바뀌었나를 찾는 진단 지표다. 최종 목적이 승패라면 그 진단만으로 채택하지 않는다.
저비용 BC 금메달 회고의 저자는 큰 모델이 특정 기준을 새 평가에서 92–36으로 이기고도 실전에서는 더 약했다고 보고했다. 한 상대를 잘 이겼다는 사실과 여러 스타일에 강하다는 결론 사이에는 간격이 있다.
6. Bradley–Terry 점수와 내부 league의 활용
Bradley–Terry는 두 정책의 강도 차이로 승리 확률을 설명하는 모델이다. 무승부를 따로 두지 않은 기본형에서는 추정 강도가 같으면 승리 확률을 50%로 보고, 강도 차이가 벌어질수록 강한 쪽의 승리 확률을 높인다. 이 차이를 0~1 사이의 확률로 바꾸는 S자 모양 함수를 sigmoid라고 부른다. 여러 직접 대전 결과를 하나의 순서로 요약하고, 덜 확인한 상대 조합에 계산을 배분할 때 쓸 수 있다.
하지만 가위바위보 같은 순환 상성이 있으면 한 숫자가 전부 설명하지 못한다. 정책 두 집단이 서로 대전하지 않아 대전 기록이 연결되지 않거나 상대 수가 너무 적어도 순위 추정이 불안정하다. 무승부를 어떻게 다뤘는지, 어떤 사전분포와 불확실성 모형을 썼는지도 결과에 영향을 준다. BT를 보조 요약으로 두고 정책별·상대별 원래 성적표를 보관한다.
여러 정책을 모아 반복 대전시키고 상대별 성적을 관리하는 구성이 league, 즉 리그다. Pokémon TCG의 population RL 사례는 여러 정책·덱으로 리그를 만들고, 덜 확실한 대전에 평가를 더 배정한 방법을 설명한다. 그 게임의 상대 비중을 Kaggriculture에 그대로 쓰는 것은 아니며, 평가를 조직한 방식을 참고할 수 있다.
학습 상대도 최신 자기 모델 하나로 고정하지 않을 수 있다. 현재 모델과 과거 checkpoint, 강한 공개 프로그램, 다른 스타일의 정책을 작은 상대 풀로 둔다. 최신 모델만 이기도록 학습하다가 예전 상대에게 다시 지거나 한 스타일에만 강해지는 문제를 확인하기 위해서다.
PFSP(prioritized fictitious self-play)는 상대별 성적을 이용해 학습할 상대의 비중을 조절하는 계열의 방법이다. 어려운 상대나 학습할 여지가 큰 상대에 더 많은 경험을 쓸 수 있다. AlphaStar는 다양한 역할의 리그와 약점을 찾는 에이전트를 사용했다. DeepMind의 리그 설명
첫 프로젝트에서 AlphaStar의 리그를 전부 구현할 필요는 없다. 작은 고정 상대 풀과 상대별 전적으로 시작해, 예전에 이기던 상대에게 다시 지는 현상이 보이면 상대를 고르는 규칙을 추가하면 된다. 배우기 어려워 H를 학습 상대의 50%로 뽑았다고 해서 실전 평가에도 H의 비중을 50%로 넣지는 않는다.
최선의 대응 전략에 얼마나 취약한지 따지는 exploitability도 주의해서 쓴다. 내가 만든 공격 정책 하나에 약하다는 것은 알 수 있지만, 그것만으로 가능한 모든 상대 중 누가 얼마나 크게 이길 수 있는지 계산한 것은 아니다. 제한된 상대 풀에서는 발견한 취약점, 시험한 공격 상대에 대한 최악 성적이라고 적는 편이 정확하다.
7. GPU 임대 전 학습 한 주기의 비용 측정
BC·PPO·탐색의 병렬화 대상
BC에서는 관측을 묶어 처리하는 신경망 추론, 손실 계산, 역전파가 GPU에 잘 맞는다. PPO에서는 여러 환경의 배치 추론과 신경망 갱신이 대상이다. 환경도 JAX 같은 배열 연산으로 구현했다면 여러 게임의 상태 전개까지 GPU에서 처리할 수 있다.
반대로 조절할 숫자가 몇 개 없는 전략 표를 C++ 시뮬레이터에서 비교하거나 작은 ridge 회귀를 학습한다면 CPU 성능이 더 중요할 수 있다. GPU가 놀고 있다고 모델부터 키우기보다 어느 계산에 시간이 드는지 확인한다.
단일 5090의 10위 사례는 JAX 환경·정책을 연결했고, 우승팀 공개 소스는 Rust 환경과 JAX 정책, C++ 교사를 연결한다. 두 사례 모두 GPU를 썼지만 CPU/GPU 경계가 다르다. 대회에서 내 병목을 측정한 뒤 선택할 구조다. 우승팀 실행 환경과 구성
고속 시뮬레이터와 공식 엔진의 동작 일치 검사
빠른 시뮬레이터가 거래량, 자원 순서, 종료 보상을 다르게 계산하면 정책은 그 차이를 이용할 수 있다. 학습 전에 같은 초기 상태와 행동을 넣어 상태 전이를 비교한다. 평범한 몇 경기뿐 아니라 현금 부족, 재고 부족, 동시 구매, 종료 직전 같은 경계를 포함한다.
최종 해시만 비교하지 말고 어느 step의 어떤 값이 처음 달라졌는지 찾을 수 있게 검사한다. 공식 엔진이 바뀌면 버전을 맞추고 관련 시험을 다시 실행한다. 아직 검사하지 않은 규칙도 적어 둔다. 모든 경우를 수학적으로 증명할 때까지 기다리는 대신, 학습할 행동과 중요한 예외부터 확인한다.
그다음 아래 시간을 따로 잰다.
| 구간 | 측정 단위와 확인할 것 |
|---|---|
| 원본 자료 전처리 | 경기/초, 캐시 크기, RAM, 중복 작업 |
| 환경 전개 | 관측·마스크 생성까지 포함한 step/초 |
| 정책 추론 | 실제 rollout 배치의 신경망 추론 시간 |
| 전송·동기화 | CPU/GPU 복사와 대기 시간 |
| 학습 갱신 | 실제 미니배치의 역전파·optimizer 시간 |
| 저장·평가 | 체크포인트, 로그 읽기·쓰기, 개발 대전의 시간 |
환경만 10만 step/초로 돌아간다고 전체 학습도 그 속도로 진행되지는 않는다. 실제 신경망, decoder, observation 생성, 저장을 모두 붙여 한 바퀴를 재야 한다. 처음 컴파일하고 준비하는 시간과 이후 반복 속도도 나눠 잰다.
step의 단위도 적어야 한다. Kaggriculture 한 경기에서 세계를 진행하는 횟수는 719번이고, 두 좌석의 의사결정은 합쳐 1,438번이다. 같은 실행도 어느 쪽을 분자로 세느냐에 따라 step/초가 두 배 차이 난다. VRAM 사용량·batch 크기·엔진 버전과 함께 기록해야 처리량을 비교할 수 있다.
GPU 작업은 CPU가 실행 요청만 하고 먼저 돌아오는 경우가 있다. 시간 측정의 끝에는 GPU 계산이 실제 끝날 때까지 기다려야 한다. 그렇지 않으면 추론 시간이 아니라 작업을 예약한 시간만 잴 수 있다. 한편 각 구간을 따로 측정할 때 넣은 동기화는 원래 파이프라인의 겹침을 없앨 수 있으므로, 전체 주기 시간도 별도로 확인한다.
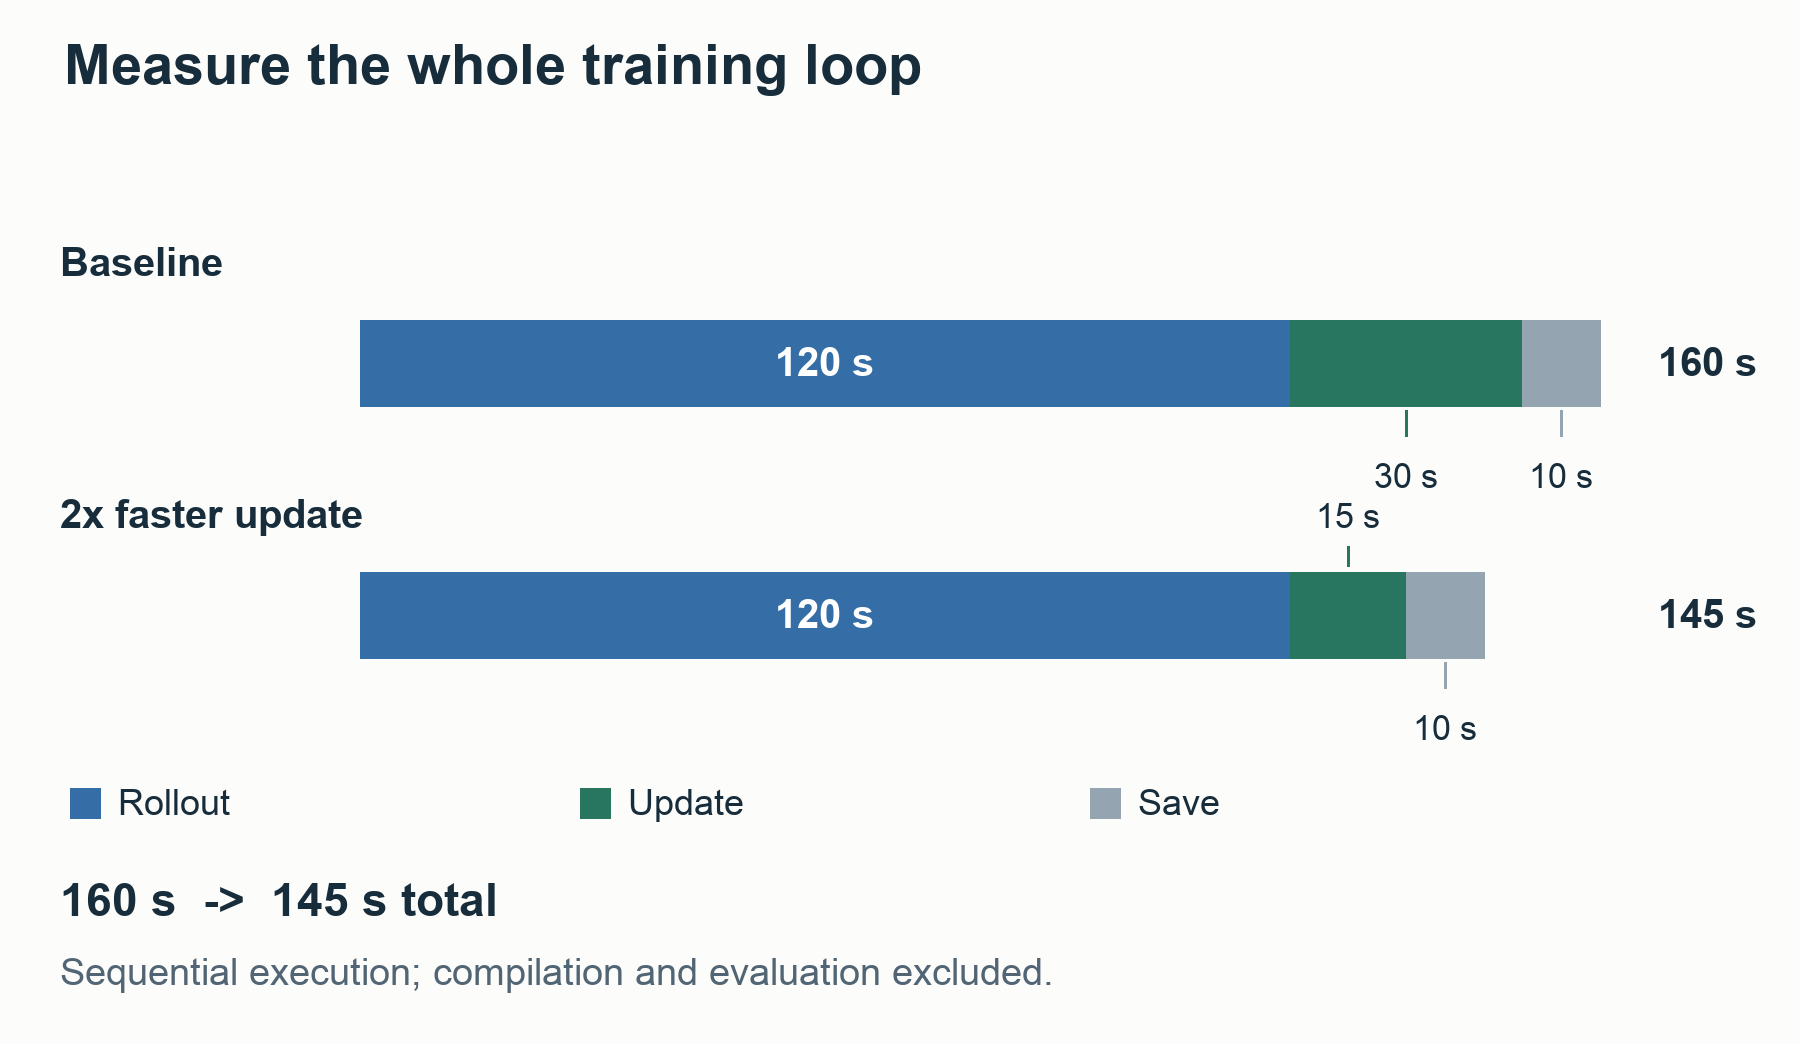
가령 rollout, 갱신, 저장을 차례로 실행하는 데 120초·30초·10초가 걸리면 한 주기는 160초다. GPU에서 갱신만 두 배 빨라지면 전체는 145초로 줄어든다. 작업을 겹쳐 실행하면 시간 계산은 달라지지만, 경험을 모은 정책이 현재 학습 정책보다 얼마나 오래됐는지도 관리해야 한다. 처음에는 작은 묶음을 순서대로 수집·갱신하며 계산이 맞는지 확인하는 편이 낫다.
GPU 임대 예산 계산 예제
시간당 요금을 가상의 1,000원, 개발 평가를 10회 갱신마다 600초로 두자. 한 주기 160초로 100회 갱신하면 16,000초, 평가에 6,000초가 든다. 약 6.1시간이므로 계산 비용은 약 6,100원이다. 여기에 데이터 준비·초기 컴파일·복구 여유·별도 CPU·저장 비용이 붙는다.
학습 주기를 두 배 빠르게 끝내도 별도 평가 6,000초가 그대로라면 총 시간은 14,000초, 약 3.9시간이다. 어느 작업이 빨라졌는지에 따라 절감액이 달라진다. 요금과 시간은 예산을 계산하려고 둔 가정이며 장비 견적이 아니다.
긴 학습 시간을 먼저 예약하기보다 이 비용을 쓰면 다음에 무엇을 결정할 수 있나를 묻는다. 작은 BC가 끝까지 운영하지도 못하는데 PPO 수백 회를 예약하지 않는다. 한 주기가 정상 작동하고 개선이 보이면, 그때 잰 시간으로 더 큰 실행의 예산을 잡는다.
8. 다음 대회의 첫 실험: 설계부터 독립 평가까지
첫 실행부터 A–G를 모두 자동화할 필요는 없다. 이미 있는 프로그램으로 A를 확인하고, B에서 교사 기록 한 개가 학습 표본으로 바뀌는 과정을 따라간 뒤 C로 간다. 단계마다 결과를 저장하고 검사를 통과했을 때 다음 계산을 붙인다. 나중에 문제가 생기면 마지막으로 정상 작동한 단계부터 이어갈 수 있다.
단계 A — 목표와 baseline 설정
입력은 대회 규칙, 점수식, 실행 제한, 구할 수 있는 강한 프로그램이다. 승점과 수익 중 무엇을 높여야 하는지, 상대를 어떻게 뽑는지, 여러 제출 중 무엇을 평가하는지 적는다. 모델이 전체 계획 하나를 고를지 매 turn의 작업·시장 명령을 고를지도 정한다.
계산은 작은 재현 대전과 실행 시간 측정이다. 출력은 코드·엔진·decoder의 버전이 고정된 baseline 하나다. 편리하다는 이유로 약한 이전 정책만 비교하지 말고, 이미 갖고 있는 가장 강한 단순 정책도 포함한다. 같은 패키지를 같은 조건으로 다시 실행해 정상 작동하는지 확인한 뒤 다음으로 간다.
단계 B — Teacher dataset과 action 처리 규칙
입력은 버전을 확인한 교사 프로그램의 전체 경기 기록과 메타데이터다. 계산은 교사 좌석을 고르고, 경기별로 자료를 나누고, 관측·행동·체결·label 변환을 확인하는 일이다. 출력은 작은 manifest와 입력·출력 형식, 손으로도 설명할 수 있는 학습 표본이다.
고용·설치·판매처럼 이후 운영을 바꾸는 행동이 label에서 사라지지 않았는지 확인한다. 우선 기록 한 수에서 유효한 행동을 label로 바꿨다가 명령으로 되돌려 본다. 수량·주문 순서·자원 소비가 달라지면 변환을 고친다. 무효 명령 문자열까지 원문 그대로 복구할 필요는 없지만, 그 자리를 지워 뒤 주문의 순서를 바꾸면 안 된다. 처음부터 전체 아카이브를 학습 배열로 변환할 필요도 없다.
단계 C — 작은 BC 모델의 전체 경기 실행
입력은 검사를 마친 교사 자료와 작은 모델이다. 계산은 BC를 돌려 작은 학습 표본을 충분히 맞힐 수 있는지 보고, 학습하지 않은 경기의 loss와 중요한 행동도 확인하는 일이다. 출력은 테이프를 읽지 않고 현재 observation으로 끝까지 플레이하는 정책이다. 학습 표본도 맞히지 못하면 데이터 변환과 loss부터 확인한다. 학습 표본에서는 맞는데 개발 표본에서 틀리면 어떤 조건과 교사를 더 배워야 하는지 조사한다.
모델을 직접 플레이시켜 고용·생산·운반·판매가 이어지는지 본다. 교사 기록의 행동은 잘 맞히는데 실제 운영이 무너지면 곧바로 모델을 키우지 않는다. decoder가 명령을 잘못 바꿨는지, 교사의 서로 다른 운영을 섞었는지, 자기 실수로 학습에 없던 상태에 들어갔는지 찾는다. 충분히 강한 BC가 나오면 PPO 없이도 후보로 평가할 수 있다.
단계 D — 실패 원인에 따른 전략 개선 방법 선택
입력은 BC나 기존 정책이 진 기록과 강자의 다른 운영이다. 계산은 진 이유를 나누고 어느 방법이 그 행동을 바꿀 수 있는지 확인하는 일이다. 출력은 다음에 시험할 가설 하나다.
| 확인한 부족함 | 우선 시도할 계산 |
|---|---|
| 좋은 운영은 있는데 제대로 못 배움 | 라벨·특징·BC·교사 혼합 수정 |
| 자기 실수 뒤 복구 경험이 없음 | 자기 상태 수집과 가능한 교사 재라벨링 |
| 보유 메뉴 모두 약함 | 완결된 새 교사·계획·행동 표현 생성 |
| 투자 강도처럼 조절할 숫자가 몇 개 있음 | 좋은 조합 주변에서 새 후보를 뽑는 탐색·CEM·ES |
| 강한 초기 정책이 있고 반응을 개선할 여지가 있음 | 새 rollout의 PPO |
| 계획은 좋지만 실행이 충돌함 | 스케줄·자원 예약·실행기 수정 |
내 정책이 들어간 새로운 상태에 교사의 정답을 붙이려면, 그 상태를 받아 좋은 행동을 계산해 주는 교사 코드나 탐색기가 있어야 한다. 남의 옛 리플레이만으로는 거기에 없는 상태의 정답을 얻을 수 없다.
우승팀은 토마토·편중 상점에서 약함을 발견하자 교사 플래너를 개선해 해당 세계의 완전한 시범을 만들고 다음 BC에 넣었다. 모든 약점을 같은 PPO 예산으로 해결하려 한 구조가 아니다. 표적 교사 데이터 생성
단계 E — PPO 한 주기의 계산 검증
BC나 계획 탐색만으로 후보를 만들었다면 이 단계를 건너뛰고 F의 독립 평가로 간다. BC 뒤에 PPO를 반드시 붙여야 하는 것은 아니다.
입력은 버전을 고정한 수집 정책, 상대 풀, 새 세계다. 계산은 당시 행동의 로그확률(logprob)·가치 예측(value)·mask·보상(reward)을 저장하고 advantage로 한 번 갱신하는 일이다. reward는 그 행동의 결과를 학습 목적으로 점수화한 값이다. 출력은 어떤 경험으로 갱신했는지 확인할 수 있는 checkpoint다.
수집 직후 같은 mask로 logprob를 다시 계산해 저장값과 맞는지 확인한다. 후처리가 행동을 강제로 바꿨다면 원래 행동의 확률을 그대로 붙여 학습하지 않는다. 가치 예측이 부정확하다면 actor는 그대로 둔 채 critic부터 학습할 수 있다. 과거 다른 정책으로 만든 기록을 현재 정책의 새 PPO 데이터처럼 섞지도 않는다.
첫 갱신에서는 계산이 의도대로 이어지는지 확인한다. 저장한 옛 확률과 advantage는 그대로 두고, 현재 policy의 계산을 거슬러 가며 각 가중치의 gradient를 구해야 한다. loss에 NaN이 없고 가중치 파일이 바뀌었다는 것만으로는 충분하지 않다. 그렇다고 매번 승률이 올라야 하는 것도 아니다. 정해 둔 짧은 학습을 마친 뒤 중요한 행동과 개발 대전을 보고 판단한다. 확률 계산이 틀리거나 운영이 갑자기 무너지면 마지막 정상 checkpoint로 돌아가 원인을 찾는다.
저장 확률과 재계산 확률의 일치 검사
행동이 BUY, WAIT, SELL 세 개이며 현재 현금으로 BUY가 불가능하다고 하자. 네트워크가 낸 logits는 [2, 1, 0]이어도 합법 행동에만 정규화하면 확률은 [0, 약 0.731, 약 0.269]가 된다.
아래의 chosen은 그 분포에서 WAIT가 선택된 한 표본을 뜻한다. 실제 rollout에서 항상 WAIT를 고른다는 규칙이 아니다. 검사할 한 행동을 고정해 두고 수집 시점과 재계산 시점의 확률만 비교한다.
아직 가중치를 바꾸지 않았다면 같은 상태·행동·마스크에서 계산한 새 확률은 수집할 때 확률과 같아야 한다. 따라서 PPO ratio도 1이다. logits만 저장하고 마스크를 다르게 복원하면 가중치가 그대로여도 ratio가 달라진다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
import math

actions = ["BUY", "WAIT", "SELL"]
logits = [2.0, 1.0, 0.0]
mask = [False, True, True]
chosen = actions.index("WAIT")

def masked_probs(values, allowed):
    assert len(values) == len(allowed)
    legal_values = [v for v, ok in zip(values, allowed) if ok]
    if not legal_values:
        raise ValueError("no legal action")
    offset = max(legal_values)
    terms = [
        math.exp(v - offset) if ok else 0.0
        for v, ok in zip(values, allowed)
    ]
    total = sum(terms)
    return [term / total for term in terms]

collect_probs = masked_probs(logits, mask)
old_logprob = math.log(collect_probs[chosen])
repeat_probs = masked_probs(logits, mask)
new_logprob = math.log(repeat_probs[chosen])
ratio = math.exp(new_logprob - old_logprob)
assert math.isclose(ratio, 1.0, abs_tol=1e-12)

wrong_probs = masked_probs(logits, [True, True, True])
wrong_ratio = wrong_probs[chosen] / collect_probs[chosen]
print("chosen probability:", round(collect_probs[chosen], 6))
print("unchanged-policy ratio:", round(ratio, 6))
print("wrong-mask ratio:", round(wrong_ratio, 6))
선택 확률은 0.731059, 바꾸지 않은 정책의 ratio는 1.0, mask만 잘못 바꾼 ratio는 0.334759가 나온다. 정책을 바꾼 효과를 계산하기 전에, 같은 정책을 같은 확률로 평가하는지 확인하는 검사다. 예제의 허용오차 1e-12는 Python의 이 작은 실수 계산에 쓰는 값이다. 실제 float32·혼합 정밀도에서는 사용한 수치 형식에 맞게 허용오차를 정한다.
여러 일손과 시장 주문을 차례로 고르는 정책은 앞선 선택이 남긴 자원에 따라 mask가 바뀐다. 재계산할 때도 같은 순서로 각 선택의 조건부 logprob를 구해 더해야 한다. 최종 명령만 같다고 확률 계산도 같은 것은 아니다. observation·정책 버전·mask·추론 설정을 모두 맞춰야 한다.
후처리가 WAIT를 SELL로 바꿨다면 위의 WAIT 확률을 SELL의 old logprob로 저장할 수 없다. 후처리로 바꾼 행동을 학습에서 어떻게 취급할지 정하거나, 처음부터 수집과 학습에 같은 제약을 적용해 행동을 골라야 한다.
단계 F — 새로운 조건에서 후보의 독립 평가
입력은 개발 결과로 고른 후보 하나와 미리 정한 상대별 가중치다. 계산은 학습·선택에 쓰지 않은 세계에서 baseline과 짝을 맞춰 양 좌석으로 실행하고, 상대별로 성적이 나빠지는지도 보는 일이다. 출력은 개선 폭과 오차 범위, 채택·보류·기각의 이유다.
최종 후보는 실제 제출과 같은 sampling 또는 argmax, 후처리·mask·수치 정밀도로 검사한다. 확률대로 뽑는 sampling에서 좋아졌다고 가장 높은 확률만 고르는 argmax에서도 좋아지는 것은 아니다. 1·2위 확률이 뒤바뀌는 작은 변화가 매 경기의 같은 초반 결정을 바꿀 수 있다.
가령 첫 시장 행동의 선택지가 투자와 대기뿐이라고 하자.
| 정책 | 투자 확률 | 대기 확률 | argmax로 제출한 첫 행동 |
|---|---|---|---|
| 갱신 전 | 0.49 | 0.51 | 대기 |
| 갱신 후 | 0.51 | 0.49 | 투자 |
sampling에서는 투자 빈도가 2%포인트 늘었다. 그러나 argmax에서는 이 관측의 첫 행동이 매번 뒤집힌다. 두 분포의 KL(갱신 전 ∥ 갱신 후)는 약 0.0008 nat로 작아도 그렇다. 이후 현금·일손·생산이 달라지면 한 경기 전체의 차이는 커질 수 있다. 작은 KL과 작은 배포 행동 변화는 같은 말이 아니다.
몇 경기면 충분하다는 공통 기준은 없다. 구별하려는 개선 폭, 세계별 결과 차이, 상대 수, 실행 비용에 맞춰 정한다. 기대하는 효과가 너무 작아 지금 예산으로 구분하기 어렵다면 더 큰 변화를 만들 가설로 돌아가거나 판단을 보류한다.
단계 G — 제출 패키지와 학습 재시작 준비
입력은 통과한 후보와 최종 CPU 패키지다. 계산은 공식 환경의 완전 경기, 첫 호출·정상 호출 시간, 메모리, 초기화, 오류 복귀 확인이다. 출력은 최종 패키지와 그 해시, 재현 명령, 선택 근거다.
다시 학습할 때 필요한 것은 가중치만이 아니다. optimizer·학습률 스케줄·난수 상태, 상대 풀, manifest, 완료·미완료 rollout, 코드·엔진 버전도 남긴다. 마지막 경험 묶음의 갱신을 끝냈는지 기록한다. 임대를 끝내도 어느 버전에서 무엇을 이어갈지 알 수 있어야, 같은 경험으로 실수로 두 번 갱신하거나 중간 결과를 잃지 않는다.
우승팀 공개 평가기도 seed마다 양 좌석을 실행하지만 Kaggle의 컨테이너 스케줄과 시간 계산을 정확히 복제하지는 않는다. 로컬에서 잘 돌아가는지와 실제 제출 환경에서도 문제없이 동작하는지는 따로 확인해야 한다. 공개 평가기의 범위
9. 실행 전 실험 계획서
가령 강한 BC가 토마토 수요 세계에서 과소투자한다는 가설이 나왔다고 하자. 다음처럼 적으면 계산을 시작하고 멈출 근거가 생긴다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
질문
  토마토 수요 세계의 완결된 교사 시범을 추가하면,
  기존 정상 세계 성능을 유지하면서 해당 약점이 줄어드는가?

기준과 변경
  기준: 고정 BC checkpoint + 고정 배포 디코더
  변경: 같은 모델·예산, 표적 교사 자료를 추가한 BC
  대조: 같은 양의 일반 교사 자료를 추가한 BC

입력
  교사 코드/좌석, 엔진, 자료 hash, 경기 단위 split
  수요 세계의 정의와 정상 세계 표본

계산
  작은 라벨 검사 → 작은 학습 → 개발 대전
  유망한 후보 하나만 새로운 세계의 짝 확인

판정
  표적 세계의 승점 변화와 구간
  정상 세계·상대 계열별 허용 범위를 넘는 성능 하락 여부
  토마토 투자·수확·매출 연쇄가 실제로 달라졌는가

예산과 중단
  실제 측정한 1회 학습·평가 비용과 총 상한
  라벨 불일치/실행 붕괴면 즉시 중단
  개발 예산 안에서 유망한 변화가 없으면 확대하지 않음

복구
  기준 checkpoint, optimizer, RNG와 재시작 명령
특정 조건의 교사 자료를 추가한 후보와 일반 자료를 같은 양만큼 추가한 후보를 비교한다. 단순히 데이터가 많아져 좋아진 것인지, 부족했던 운영을 배워 좋아진 것인지 구분하기 위해서다. 후보를 많이 만들면 확인 비용도 커지므로 처음부터 모든 변경을 조합하지 않는다.
총 학습 예산도 맞추되, 갱신 횟수와 각 자료를 반복 사용한 횟수를 기록한다. 자료가 늘어난 상태에서 epoch만 같게 하면 계산량까지 같아지는 것은 아니다.
10. 실패 원인별 점검 항목과 대응
| 현상 | 우선 확인할 것 | 곧바로 늘리지 않을 것 |
|---|---|---|
| 작은 표본도 외우지 못함 | 시간 정렬, 라벨, loss mask, 출력·디코더 | 전체 자료와 모델 크기 |
| 교사 상태는 맞추나 자기 경기 붕괴 | 첫 중요한 분기, 자원 충돌, 자기 상태의 자료 부족 | PPO 기간 |
| 정상 운영하지만 강자보다 크게 약함 | 좋은 전략이 교사·메뉴에 실제로 있는가 | 약한 메뉴 선택기의 복잡성 |
| PPO 직후 악화 | old logprob, mask·action 자동 보정, critic, reward scale | 병렬 환경 수 |
| 개발만 좋아지고 새 확인에서 실패 | 선택 편향, 상대 계열, 새로운 세계와 디코더 | 같은 개발 패널의 재실행 |
| 은행은 증가하나 승점 하락 | 상대 은행, 박빙 경기, 상품별 시장 효과 | 은행 보상의 가중치 |
| 학습은 빠른데 전체 주기는 느림 | CPU 환경, 관측 생성, 전송, I/O와 평가 | GPU 수 |
한 판 진 이유에 그럴듯한 설명을 붙이기는 쉽다. 같은 문제가 여러 경기에서 반복되는지, 수정하면 실제로 사라지는지, 다른 조건에서 손해를 보지는 않는지까지 확인해야 다음 학습을 바꿀 근거가 된다.
로그를 볼 때는 양쪽의 현금·재고·행동, 모델의 행동 확률과 가치 예측, 실제 체결량, 명령 취소 이유를 같은 시간축에 놓는다. 가치 예측이 내려간 지점은 조사할 단서다. 그 수가 원인이라고 단정하지 말고 앞선 투자·이동·재고 변화를 따라간다.
학습 기록에 남길 지표와 해석
처음에는 지표가 많아 어느 숫자를 봐야 할지도 막막하다. return은 그 시점부터 받을 보상을 합친 값이다. 평균 return 하나만 보고 판단하지 말고, 전략을 만들고 배우고 실행하는 각 과정과 실제 대전 성적을 따로 본다.
| 지표 | 함께 적을 조건 | 나빠질 때의 첫 질문 |
|---|---|---|
| 평균 return | 보상 정의, 수집 정책, 상대 버전·비중 | 상대가 쉬워진 것인가, 정책이 달라진 것인가? |
| critic 오차 | 같은 보상 단위의 return target, 평가 표본 | 보상 단위·종료·다음 가치 예측을 쓰는 처리가 맞는가? |
| entropy | 어떤 행동 head인지, 합법 후보 수 | 실제로 선택이 굳었나, 합법 행동이 줄었나? |
| 이전 정책과의 KL | 동일 관측·마스크, 비교 방향 | 어떤 상태·행동에서 크게 바뀌었나? |
| 실행 행동 지표 | 고용·확장·수확·판매의 시점과 성공률 | 의도한 action이 취소되거나 자동으로 바뀌고 있나? |
| 새 확인 승점 | 고정 상대, 새 세계, 제출용 decoder | 학습 지표가 좋아진 만큼 실제 대전도 좋아졌나? |
critic이 얼마나 잘 맞히는지는 같은 observation의 예측 $V(s_t)$와 학습 목표인 return target $G_t$를 비교해 본다. 예를 들어 두 값의 차이에 절댓값을 취해 평균하면 다음과 같다.
\[\operatorname{MAE}_V =\frac{1}{N}\sum_{t=1}^{N}|V(s_t)-G_t|.\]여기서 $N$은 오차를 계산한 observation의 개수다.
훈련 정답을 잘 맞히는 것과 새 경기의 결과를 잘 예측하는 것은 다르다. target을 실제 보상을 끝까지 합친 Monte Carlo return으로 만들었는지, GAE로 가치 예측을 섞어 만들었는지도 적는다. 보상 단위가 달라지면 오차의 크기도 달라지므로 다른 실험의 숫자를 그대로 비교하지 않는다.
entropy는 확률이 여러 행동에 얼마나 나뉘어 있는지 나타낸다. 세 행동의 확률이 비슷하면 높고 한 행동에 몰리면 낮다. 고용할 현금이 없어 가능한 행동이 하나뿐이라 entropy가 0이라면 문제가 아니다. 중요한 구매를 선택할 수 있던 상태와 선택지가 없던 상태를 섞어 평균내면 왜 낮아졌는지 놓칠 수 있다.
가상의 학습 노트에서 아래 변화가 보였다고 하자. 수집 평균은 그때그때 상대 풀에서 얻었고, 고정 평가 return은 같은 별도 상대 구성에서 계산했다. 중간 보상은 0, 종결 보상은 승리 +1·무승부 0·패배 −1이고 할인율은 $\gamma=1$이다. 이 표의 return은 경기당 종결 보상의 평균이다.
구매 head는 구매 계열 행동을 출력하는 모델의 일부다. 여기서는 가능한 선택이 네 개 이상인 상태를 가정하므로 2편의 세 행동 예제보다 entropy가 높을 수 있다. 필요한 고용을 놓친 비율은 교사 행동과 실행 조건으로 미리 고른 상태에서만 잰다. 모든 상태에서 고용하지 않은 비율도, 뒤늦게 판단한 최적 행동과 다른 비율도 아니다.
| 기록 | 수집 평균 return | 고정 평가 return | 평가 critic MAE | 구매 head entropy | 필요한 고용을 놓친 비율 |
|---|---|---|---|---|---|
| 시작 | +0.10 | +0.10 | 0.80 | 1.20 | 2% |
| 다섯 번째 갱신 | +0.28 | +0.02 | 0.50 | 0.30 | 22% |
이 승무패 보상에서는 평균 return이 2 × 평균 승점 − 1이다. 고정 평가 return +0.10 → +0.02는 승점 0.55 → 0.51에 해당한다. 앞에서 계산한 승점과 같은 결과를 다른 눈금으로 적은 것이다. 대회의 BT 레이팅이 0.08 내려갔다는 뜻은 아니다.
수집 return과 critic 오차만 보면 좋아진 것처럼 보인다. 하지만 같은 평가 상대에게는 더 못했고 중요한 고용도 더 자주 빠졌다. 먼저 고용할 수 있던 상태의 mask와 행동 확률, decoder가 명령을 취소한 이유를 본다. entropy가 줄었다고 보너스 계수부터 올리거나 PPO를 더 오래 돌릴 단계는 아니다.
mask가 고용을 잘못 막았다면 그 조건식을 고친다. 고용할 수 있는데 학습 뒤 확률이 사라졌다면 그 상태의 advantage·reward·교사 KL을 확인한다. 애초에 더 나은 초반 투자를 보여 준 시범이 없었다면 다른 데이터나 전략 생성 방법이 필요하다. 같은 지표를 보고도 원인에 따라 바꿀 코드는 다르다.
학습 노트의 마지막 칸에는 더 학습한다 대신 다음에 확인할 한 가지와 그 결과에 따라 바꿀 것을 적는다. 예를 들면 고용 가능한 상태에서 mask와 실제 명령 처리 결과를 비교한다. 다르면 학습 전에 고치고, 맞으면 그 상태의 advantage를 조사한다 정도다. 다음 실행에도 같은 계산만 막연히 반복하지 않게 한다.
11. 단계별 학습 목표와 실습 산출물
처음부터 RL의 모든 알고리즘을 공부할 필요는 없다. 다음 여섯 가지를 직접 설명하고 만들어 볼 수 있으면 작은 대회 루프를 시작할 수 있다.
- 한 경기의 상태 전이. 관측·행동·보상·종료를 손으로 몇 수 추적한다. 엔진을 읽고 작은 재현 표본을 만든다.
- 분류 모델과 BC. logits, softmax, cross-entropy, minibatch, gradient를 배운다. 작은 교사 자료를 학습하고 실제로 끝까지 플레이시킨다.
- 가치와 advantage. 한 경기의 기록에서 return과 예상 결과의 차이를 계산한다. 경기에서 받은 reward만으로 개별 action을 평가할 수 없는 이유를 설명한다.
- PPO의 확률 계산. old/new logprob와 ratio, clip, entropy, KL, value loss가 어디서 계산되는지 한 update를 추적한다.
- 게임 상대와 평가. self-play, 과거 체크포인트, 상대 가중치, 짝 비교, 개발·최종 확인 분리를 작은 행렬로 구현한다.
- 생성 방법의 확장. 그제야 ES/CEM, 계획 탐색, 교사 증류, 리그를 구체적인 약점에 붙인다.
중요한 것은 읽은 페이지 수보다 직접 확인한 결과다. 내 코드와 자료에서 이 observation을 보고 이 action을 골랐고, 이 결과로 가중치를 이렇게 바꿨다고 따라갈 수 있어야 한다. 작은 한 바퀴가 정상 작동하면 GPU로 그 계산을 더 많이, 더 다양한 조건에서 실행할 수 있다.
다음 대회의 첫날에는 코드보다 아래 세 칸을 먼저 채우려고 한다.
1
2
3
지금 가진 것보다 더 좋은 행동이 생성되는 위치:
그 행동을 배우거나 평가하는 데 필요한 새로운 정보:
이번 계산을 끝내면 채택·기각할 수 있는 한 가지 결정:
세 칸이 구체적이면 BC, PPO, 전략 표, 계획 탐색 중 무엇을 돌릴지도 정하기 쉬워진다. 기존 후보를 반복해 순위만 매기는 상태라면 첫 칸을 다시 봐야 한다. 새로운 후보는 많이 생기는데 강도를 믿을 수 없다면 두 번째와 세 번째 칸으로 돌아가야 한다.