RSNA Knee, Part 6: 상위권 해법 종합 분석 — 라벨·모델·검증·추론
상위권의 라벨·영상 입력·검증·ensemble을 비교하고, 내 판단이 잘못된 지점과 당시의 대안, 다른 대회에 적용할 연구 원칙을 구체적으로 정리했다.
그림은 눌러서 확대할 수 있습니다. 좁은 화면에서는 넓은 표와 수식을 좌우로 움직여 보세요.
RSNA Knee 상위권은 영상 classifier의 성능을 높이는 데서 한 걸음 더 나아갔다. MRI 검사에서 학습 target이 만들어지기까지의 과정을 바꿨다. 어떤 소견을 positive로 볼지, 판독 모델에 어느 영상을 보여 줄지, 불확실성을 어떤 확률로 표현할지, classifier가 어디서 근거를 모을지, 판독문의 어느 부분이 영상 소견보다 병원별 관행을 반영하는지를 각각 연구 대상으로 삼았다.
이 대회는 일반적인 supervised learning 데이터와 출발점부터 달랐다. MRI study마다 열두 소견의 확률을 예측해야 했지만, 학습 study 4,407건 가운데 전문가 영상 라벨이 있는 것은 58건뿐이었다. 나머지 대부분에는 여러 언어로 쓰인 판독문이 주어졌다. 반면 test annotation은 영상의학과 전문의가 영상을 보고 만들었다. 따라서 판독문을 정확하게 추출한 라벨은 유용한 supervision이지만, 그것이 곧 test target을 정확하게 나타내는 라벨은 아니었다.
대회 후 공개된 해법에서는 이 차이를 구체적인 비교로 확인할 수 있다. 21위는 영상 learner를 그대로 두고 학습 라벨을 바꿨고, 표본이 큰 약라벨 reference와 작은 전문가 패널에서 모두 개선을 얻었다. 72위는 학습한 site 관련 항을 inference에서 의도적으로 제거했다. 그러자 판독문 reference의 pooled OOF는 내려가고 Private은 올랐다. 우승 팀은 study 단위 확률만 주는 대신 anatomy·lesion annotation을 feature aggregation에 연결했다. 외부 영상을 더 넣거나 distillation을 반복하거나 blend 변형을 늘려도 별 효과가 없었다는 팀도 있었다. 서로 다른 실험이며, 그 결과로 답할 수 있는 질문도 다르다.
나도 multimodal labeling, 잘못된 영상을 넣는 대조군, native-field·local-view reader, teacher target, complete OOF family, whole-bank combination search를 갖고 있었다. 필요한 기법은 여러 개 갖췄지만, 이를 연결해 충분히 강한 prediction basis를 만들지 못했다. 마감 때까지 완성한 자체 모델만의 최고 조합은 Private 0.941, 공개 H 시스템은 0.942, 내가 선택한 혼합은 0.943이었다. 점수의 흐름과 대회를 마친 뒤의 생각은 마지막 회고에 정리했다. 더 나은 정보를 learner에 전달하고, 그 변화에 맞는 기준으로 평가한 뒤, 결과에 따라 다음 연구의 우선순위를 바꿨어야 했다.
수집한 해법 글은 36팀의 38편이며, 공개 notebook 소스 51묶음도 보관했다. 같은 우승 팀의 두 글은 팀원별 기여를 설명한 것이다. 아래 ablation 수치는 원저자의 보고값이다. 공개 코드를 읽어 일부 operator와 입력 경로를 확인했지만, 그 점수를 독립적으로 재현한 것은 아니다. Local label AUC, local student AUC, Public AUC, Private AUC는 끝까지 구분해서 읽어야 한다.
점수와 평가 자료를 읽는 방법
Macro ROC AUC는 소견의 빈도와 관계없이 열두 소견에 같은 비중을 준다. 소견 하나의 AUC는 positive study가 negative study보다 높은 점수를 받는 비율이며, 동점에는 절반의 점수를 준다. Threshold 0.5에서의 분류 정확도가 아니다. AUC가 0.01 올랐다고 환자 1%를 더 정확하게 진단했다는 뜻도 아니다.
Out-of-fold prediction은 평가할 study와 필요한 group을 학습에서 제외한 영상 모델의 예측이다. 이를 채점하는 reference는 여전히 만들어진 약라벨일 수 있다. Public과 Private은 서로 다른 숨겨진 평가 subset이며, 여기 인용한 Private 값은 마감 후에 공개됐다. 학습 데이터의 전문가 라벨 58건은 개발에 쓸 수 있는 자료이지 Private set이 아니다.
같은 AUC라는 이름을 써도 무엇을 채점했는지는 다를 수 있다. 라벨표는 학습 target을 제공하고, 모델은 그 값으로 학습한다. Evaluator는 reference 표에 threshold를 적용해 이진화한 뒤 AUC를 계산할 수 있으며, 최종 대회 평가는 전문가 annotation을 기준으로 한다. 어느 한 단계에서 숫자가 높아졌다고 다른 단계도 자동으로 좋아지는 것은 아니다. 특히 열 개 소견의 라벨 평가와 열두 개 소견의 모델 점수, five-fold family와 full-data checkpoint 하나를 비교할 때 이 차이가 중요하다.
1. 학습 target과 라벨 설계
소견의 정의와 판독문 기반 라벨
열두 finding은 각각 positive의 의미가 달랐다. ACL·MCL injury, medial·lateral meniscus tear, 세 compartment의 osteoarthritis, effusion, synovitis, Baker’s cyst, contusion, fracture는 확인할 anatomy와 contrast, severity threshold가 서로 다르다. 판독문이 이상 소견을 정확히 기술해도 대회의 positive 기준에는 미치지 않을 수 있다. 반대로 대회 기준에 따라 영상을 다시 보면 임상 판독문에는 굳이 적지 않은 소견도 positive로 잡힐 수 있었다.
5위 팀의 분석은 이 차이를 잘 보여 준다. Host rubric에서 MCL injury는 급성 high-grade partial tear 또는 complete tear였지만, 초기 라벨은 low-grade MCL 변화를 적은 판독문 199건도 positive로 처리했다. 이 가운데 전문가 세트에 포함된 다섯 건은 모두 negative였다. 그 밖의 report-positive MCL은 열세 건 중 아홉 건이 전문가 positive였다. Effusion도 small effusion을 적은 판독문에서는 스물두 건 중 열 건, 나머지 report-positive 판독문에서는 스물여덟 건 중 스물네 건이 전문가 positive였다. 작은 집단의 관측값이므로 일반적인 임상 빈도로 볼 수는 없다. 다만 같은 진단 용어가 나왔다는 이유만으로 같은 target을 주면 severity 기준을 놓친다는 점은 분명하다.12
| 소견·집단 | 대회에서 구분해야 한 기준 | 판독문을 그대로 target으로 만들 때의 문제 |
|---|---|---|
| MCL injury | 급성 high-grade partial·complete injury와 더 낮은 grade의 변화 | 낮은 grade의 이상을 정확히 추출하고도 잘못된 positive target을 만들 수 있음 |
| Effusion·Baker’s cyst | 액체나 낭종의 존재 자체가 아닌 대회의 크기 기준 | “Trace”·“small”을 rubric-positive와 같은 집단으로 묶을 수 없음 |
| Compartment별 OA | 해당 compartment에서 기준 이상의 cartilage damage | 일반적인 OA 기술만으로는 중증도와 medial·lateral·patellofemoral 구분을 잃을 수 있음 |
| Synovitis·effusion | 관련은 있지만 서로 다른 근거가 필요한 두 소견 | 하나로 다른 하나를 추정하면 라벨 사이의 상관을 인위적으로 만들 수 있음 |
반대로 판독문에 소견 자체가 빠진 경우도 많았다. 2위가 확인한 전문가 라벨 58건에서는 positive study–finding 조합이 240개였지만, 판독문이 명시한 positive는 154개였다. Patellofemoral OA는 각각 스물한 개와 두 개였다. Text에 없는 정보는 extractor를 아무리 정확하게 만들어도 복구되지 않는다. 의학적으로 더 정교한 prompt도 필요한 정보가 판독문에 있을 때에만 효과가 있다.3
Target을 만들 때는 명시적인 negative, 이상은 있지만 대회의 positive threshold에 미달하는 경우, 아예 언급이 없는 경우를 구분해야 했다. 응답을 해석할 수 없거나 모델이 답하지 않은 경우는 또 별개다. 이는 의학적 판단이 아니라 annotation pipeline의 실패다. 네 상태를 같은 수치로 처리하면 학습 목표가 결측값을 기록하는 구현 방식에 좌우된다.
5위 팀이 처음 사용한 공개 표 하나에서는 study–finding pair의 27%에 답이 없었고, synovitis에서는 84%에 달했다. 같은 0.5라도 실제 불확실성을 뜻할 수도, 추출 실패나 결측 표기일 수도 있다. 그러나 soft-target BCE에 넣으면 모두 예측을 0.5 쪽으로 미는 target이 된다. Mask한 entry는 gradient를 만들지 않고, 명시적인 negative는 예측을 0 쪽으로 민다. 의미가 다른 상태를 구현 편의상 같은 기본값으로 채워서는 안 되는 이유다.
예를 들어 target의 유무를 나타내는 mask를 $m_{i,c}$, 0 이상의 confidence weight를 $w_{i,c}$, target을 $q_{i,c}$, 예측을 $p_{i,c}$라 하면 masked objective는 다음처럼 쓸 수 있다.
\[\mathcal L= \frac{\sum_{i,c}m_{i,c}w_{i,c}\, \ell_{\mathrm{BCE}}(q_{i,c},p_{i,c})} {\sum_{i,c}m_{i,c}w_{i,c}}.\]분모는 양수라고 가정한다. $m_{i,c}=0$이면 그 entry는 학습 신호를 주지 않는다. $m_{i,c}=1$로 두고 낮지만 0이 아닌 확률을 넣으면, 해당 집단에 그 소견이 얼마나 있을지에 대한 가정을 학습에 반영한다. 이 값은 parsing의 편의가 아니라 target의 정의와 데이터에서 근거를 찾아 정해야 한다.
판독문 이외의 네 가지 정보원
“외부 정보”라는 말에는 서로 다른 개입이 들어 있다. 추가 knee MRI는 영상의 모집단을 넓히거나 바꾼다. Pretrained encoder·segmenter·VLM은 다른 곳에서 학습한 지식을 제공한다. 대회 영상을 다시 판독하면 이미 있는 사례에 supervision이 추가된다. Teacher prediction은 영상 모델이 이미 얻은 정보를 다른 학습 신호로 바꾼다. 각각 비용과 계보, 평가에 미치는 영향이 다르다.
추가 MRI를 학습에 넣지 않고도 좋은 결과를 낸 팀이 많았다. 7위는 대회 데이터와 ImageNet-pretrained backbone을 사용했고, 8위도 MRI 데이터를 추가하지 않았다고 밝혔다. 21위는 OAI·KneeMRI를 진단용 비교에만 쓰고 최종 training pool에서는 제외했다. 22위는 외부 training data나 다른 참가자의 prediction weight를 쓰지 않았다고 보고했지만, ImageNet weight와 pretrained anatomical segmenter는 활용했다. 따라서 이들의 “외부 데이터 없음”은 외부에서 학습한 지식까지 사용하지 않았다는 뜻은 아니다.4567
2위는 용도를 나누어 외부 자료를 썼다. Encoder와 orientation pipeline의 일부에는 fastMRI·fastMRI+를, patellofemoral specialist에는 OAI MOAKS cartilage grade를 활용했다. 큰 데이터셋을 통째로 추가한 실험보다 무엇을 얻으려 했는지가 구체적이다. 외부 clinical grade가 대회의 열두 target과 모두 일치하지 않더라도, 특정 finding을 위한 head에는 유용한 supervision이 될 수 있다.
여러 해법에 공통적으로 나타난 변화는 더 강한 reader가 대회 MRI 자체를 판독하게 한 것이었다. Inference에서는 영상만 쓰는 classifier도 학습할 때는 판독문, VLM의 추론, 전문가 사례, spatial annotation을 활용할 수 있다. 이런 privileged training information은 hidden-test study마다 비싼 판독을 반복하는 대신 target을 만들 때 한 번 확보한다.
내 image-assisted label도 이 방향을 제한적으로 시험한 결과였다. 같은 판독문을 다시 읽히면 번역·추출 오류는 줄일 수 있지만, 빠진 소견을 복구하려면 관련 영상을 확인하는 편이 직접적이다. Teacher는 불확실한 target을 완화하고 영상 패턴을 반영할 수 있는 한편, 자신이 학습한 report-derived target의 오류도 물려줄 수 있다. 중요한 차이는 provider나 모델 이름보다 어떤 근거를 더하고 어떤 오류를 남기는가에 있었다.
영상 범위와 재확인, 판독문의 영향
Image-assisted supervision은 annotation 시스템 전체의 설계에 달려 있었다. 어떤 영상을 보여 주는지, 어떻게 고르는지, target을 어떻게 정의하고 응답받는지, 판독문을 어느 정도 신뢰하게 하는지가 함께 작용했다. API만 바꿔서는 어떤 개입을 시험하는지 정해지지 않는다.
2위의 첫 pilot은 134 slice 중 마흔네 장만 보여 줬고, 영상이 도움이 되지 않을 것이라는 결과가 나왔다. 후속 Astra 판독에는 모든 slice, study당 약 277장과 판독문·text reader의 답을 함께 줬다. 판독문은 누락이 있을 수 있는 동료의 판독으로 제시했다. 전문가 58건에 대한 label AUC는 report reading의 0.899에서 0.942로 올랐다. Effusion은 0.806에서 0.975, Baker’s cyst는 0.803에서 0.979로 개선됐다. Reader와 입력 방식을 함께 바꿨으므로 완성된 annotation recipe의 비교다. Slice 수만 늘린 효과로 분리할 수는 없다.3
우승 팀도 multimodal label을 한 번 만드는 데서 그치지 않았다. Sakaku의 초기 reader에는 sagittal·coronal·axial 영상을 일곱 장씩 고른 고정 스물한 장 packet을 줬다. ClinFusion은 진단 설명을 만들고, Hulu는 제한된 형식의 yes/no token 확률을 계산하고, Qwen은 추론 뒤 연속 확률을 출력했다. 최종 Astra reader는 overview를 본 뒤 인접 slice, crop·window 조정, 다른 sequence의 대응 위치를 요청할 수 있었다. Production 한도는 study당 도구 호출 열 번과 상세 image sheet 열 장이었다. DICOM geometry로 대응 위치의 후보를 찾더라도 anatomy가 맞는지는 reader가 다시 확인해야 했다.8
이미 multimodal Hulu-plus-Sol label을 쓰던 224-pixel CoAt에서도 Astra label로 바꾸자 matched Public AUC가 0.922에서 0.935로 올랐다. 처음 영상을 도입한 효과가 아니라, 영상을 활용하는 supervision 안에서도 품질 차이가 있었다는 결과다. 다만 보관된 session의 호출 일곱 번·sheet 여덟 장을 2위의 개별 영상 약 277장과 같은 단위로 비교할 수는 없다. Sheet, slice, 도구 호출은 각각 다른 것을 센다.
21위 reader는 모든 series를 preview 네 장씩 넘겨 보고, 필요할 때 원 해상도 PNG에서 crop·window를 조정했다. 초기에는 판독문이 positive를 명시하면 확률을 반드시 1로 만들도록 지시했지만, 이 지침을 없애 영상 근거와 대회 기준이 text보다 우선할 수 있게 했다. 22위는 각 series를 sagittal 열여덟 tile, coronal·axial 열두 tile의 montage로 만들고 metadata를 별도로 줬다. 판독문은 확인이 필요한 참고 자료로 취급했다. 필요한 영상을 다시 선택해 보는 도구는 coverage를 확보하는 한 방법이었지만, 모든 성공 사례가 같은 interface를 사용한 것은 아니다.67
| 해법 | 영상 접근과 판독문 처리 | 비교가 뒷받침하는 내용 |
|---|---|---|
| 1위 sakaku | Overview와 제한된 slice·crop·window·cross-sequence 요청 | 이미 multimodal인 baseline에서도 더 강한 label recipe로 개선 가능 |
| 2위 | Study당 약 277장, 틀리거나 빠진 부분이 있을 수 있는 동료의 판독문 | Reader와 넓은 coverage를 함께 바꾸자 전문가 라벨과의 일치도 개선 |
| 7위 | Structured·image-only·verification의 세 판독 | 같은 reader도 근거와 framing에 따라 달라지며 소견별 실패가 있음 |
| 8위 | 영상과 근거 위치를 먼저 보고 판독문은 나중에 확인 | Image-first 평가로 처음부터 판독문에 끌려가는 정도를 줄일 수 있음 |
| 21위·22위 | 모든 series의 paging·metadata를 함께 준 montage | 넓은 coverage를 확보하는 interface와 호출 예산은 한 가지가 아님 |
7위는 같은 target protocol 아래에서 세 가지 판독을 비교했다. Report와 key slice를 준 structured read는 gold-58에서 0.935, 판독문 없이 모든 영상을 본 image-only는 0.919, 틀릴 수 있는 초안으로 report를 제시한 verification은 0.947이었다. 세 판독을 섞으면 0.949였지만, verification은 synovitis·effusion을 과도하게 positive로 만들었다. Positive 비율이 각각 0.24에서 0.31, 0.37에서 0.48로 늘었다. 이 두 finding에서 verification을 빼면 label AUC는 0.947로 조금 낮아져도 target 사이의 관계는 더 타당하게 유지됐다.4
8위는 먼저 Astra에 판독문과 기존 label을 숨긴 채 영상을 보여 줬다. 확률이 0.5 이상인 판단에는 근거 slice와 box를 요구했다. 그다음 판독문과 어긋나는 부분을 찾아 영상을 다시 확인했다. 최종 image weight도 finding별로 달랐다. Fracture·synovitis·Baker’s cyst는 5/6, patellofemoral OA·lateral OA·MCL은 1/6이었다. 작은 전문가 세트로 선택한 recipe이므로 VLM의 질환별 판독 능력을 독립적으로 순위 매긴 결과는 아니다. 다만 모든 finding에서 report target을 같은 비율로 대체할 이유가 없었다는 점은 보여 준다.5
32위도 특정 부분만 교정했다. Site와 연관된 disagreement group 가운데 non-gold study–finding cell 847개에서는 일반적인 50/50 report·image target 대신 image reading만 썼다. 나머지는 그대로 뒀다. 저자는 두 버전의 표시 점수가 모두 0.960인 상태에서 제출 순서가 개선됐다고 보고했다. 특정 하위 집단을 겨냥한 가설이지, 전체의 image 비중을 높이면 좋다는 근거는 아니다.9
65위는 모든 slice를 보여 주는 대신 finding에 맞는 입력을 골랐다. Anatomy별 group을 만들고 각 group에 열두 장에서 서른두 장의 slice를 렌더링했다. Effusion·synovitis에는 sagittal overview, sagittal zoom, axial zoom sheet를 줬다. Marrow group에는 edema를 볼 fluid-sensitive 영상과 fracture line을 볼 non-fat-suppressed 영상을 함께 넣었다. Lateral group은 sagittal의 외측 1/3과 coronal joint crop을 사용했다. 판독 전에 target에 필요한 공간 정보를 선별한 것이다.10
Finding 열 개를 한 번에 묻고 영상 아흔 장을 보내는 방식도 시험했다. 비용은 네다섯 배였는데 development 비교에서 lateral OA·patellofemoral OA는 각각 약 0.08 낮아졌다. 작은 target별 packet은 무관한 영상을 줄이고, 빽빽한 contact sheet에서 사라질 수 있는 detail을 보존했다. 이후 fracture에서는 모든 사례를 같은 방식으로 비싸게 읽히는 대신, 불확실한 study 748건에 local zoom과 box 판독을 집중했다.
Reader의 단독 성능과 text를 보완하는 효과도 달랐다. Group마다 prompt reference 네 건을 제외한 전문가 54건에서 lateral OA AUC는 Astra 0.962, text 0.886, Opus 5.5 0.574였다. 반면 synovitis는 text 0.820, Astra 0.808, Opus 0.822였고, Opus와 text를 결합하면 0.883이었다. Provider의 종합 순위만 봤다면 이 조합을 놓쳤을 것이다. 최종 선택에는 finding과 crop, 비용, 기존 text source에 더해지는 정보가 함께 반영됐다.
Prompt에는 gold example이 들어갔고, 그 사례 자체를 판독할 때는 reference를 다른 사례로 바꿨다. 해당 호출에서 자기 정답을 직접 보지 않도록 한 것이다. 그러나 같은 사례가 prompt·exemplar·reader 배치·mixture 선택에 사용된 이력은 남는다. 54건의 점수는 protocol과 실패를 살펴볼 수 있는 development 결과다. 독립적인 임상 test로 볼 수는 없다.
판독문을 함께 주는 효과도 7위와 달랐다. 65위에서는 report를 본 image read가 단독으로는 강해도 text source에 더했을 때 기여가 작아졌고, blind read가 오히려 더 잘 보완했다. 반면 7위에서는 대부분의 finding에서 verification이 유리했다. 평가할 대상이 reader 하나가 아니라 근거를 제공하고 결과를 결합하는 pipeline 전체이기 때문이다. Report 정보가 이미 target mixture에 들어 있다면, 이를 다시 이용한 source는 단독 성능이 높아도 추가 기여가 작을 수 있다.
실패 사례도 적용 범위를 보여 준다. 74위는 특정 finding에서만 일부 image reader를 채택했고, Opus 5.5의 image-reading 비교에서는 crop·zoom을 없애자 0.726에서 0.693으로 떨어졌다. 77위의 multi-step reader는 report-plus-montage의 단순한 prompt보다 낫지 않았다. 129위는 직접 영상 판독의 gold AUC가 약 0.73으로 text label의 약 0.92보다 크게 낮았다. 영상이 있어도 reader의 능력, 입력 방식, target 정의가 맞아야 유용한 supervision이 된다.111213
학습 신호로서의 확률값
라벨이 순위를 잘 매기면서 확률값은 부정확할 수 있다. ROC AUC는 순서를 보지만 soft-target 학습은 target과 현재 예측 사이의 수치 차이도 사용한다. Logit이 $z$, 예측이 $p=\sigma(z)$, target이 $q$라면
\[\ell_{\mathrm{BCE}}(q,p)=-q\log p-(1-q)\log(1-p), \qquad \frac{\partial\ell_{\mathrm{BCE}}(q,\sigma(z))}{\partial z}=p-q.\]예측이 0.8일 때 target이 0.55이면 gradient는 +0.25, 0.95이면 −0.15다. 같은 student의 예측을 반대 방향으로 바꾼다. Strictly increasing transform은 완성된 라벨표의 소견별 AUC를 보존하지만, 유한한 용량과 regularization 아래에서 student가 최적화하는 objective까지 보존하지는 않는다.
우승 팀은 AUC와 함께 log loss·confident error도 봤다. Tascj의 base reader와 out-of-fold trained guide는 라벨 AUC가 모두 약 0.936이었지만, log loss는 0.329에서 0.307로, confident error는 서른다섯 개에서 열아홉 개로 줄었다. Guide를 fit한 전문가 사례에 그대로 적용한 점수 0.943은 fold 밖에서 적용한 비교와 별도로 적었다. 이후 보고한 temperature 보정식은 0보다 크고 1보다 작은 확률에 대해 대략 $q^{\prime}=\sigma(0.77\operatorname{logit}q)$였다. 양의 temperature는 순서를 보존한다. 여기서는 supervision이 얼마나 강하게 작용하는지를 바꾸려는 보정이었다.14
Sakaku의 출력 방식 비교에서는 차이가 더 컸다. 동일하게 확보한 근거를 바탕으로 여섯 구간의 출력은 development AUC가 0.8832, 연속 출력은 0.9363이었다. 연속 방식 전체를 새로 반복한 값은 0.9392였다. 모든 discrete 방식이 실패한다는 뜻은 아니다. 2위 reader는 범주와 0–100 score를 함께 반환하고 코드로 soft label에 매핑하는 방식을 유용하게 썼다. 문제는 category field의 존재 자체가 아니라, 특정 표현 방식 때문에 유용한 구분이 사라지는 것이었다.
21위 라벨은 또 다른 차이를 보여 준다. AUC는 0.89576에서 0.93493, Brier error는 0.13941에서 0.10396으로 좋아졌지만, threshold 0.5에서 F1은 0.75013에서 0.72823으로 낮아졌다. 순위와 확률 오차가 개선돼도 고정된 binary threshold의 성능까지 좋아지는 것은 아니다. F1이 낮다는 이유로 이 target을 hard label로 바꾸면 student가 배워야 할 성질을 오히려 버릴 수 있다.6
Confidence weight도 별도의 모델링 선택이다. Weight는 0 이상으로 고정하고, presence mask를 쓴다면 그 효과까지 $w$에 포함하자. Weighted BCE를 최소화하는 이상적인 unconstrained learner의 $x$에서의 최적 예측은 다음과 같다.
\[p_w^*(x)=\frac{\mathbb E[wQ\mid X=x]}{\mathbb E[w\mid X=x]}, \qquad \mathbb E[w\mid X=x]>0.\]불확실한 report의 weight를 낮추면 신뢰하기 어려운 gradient를 줄일 수 있다. 동시에 눈에 잘 띄는 소견과 전형적인 판독 표현을 강조해 실질적인 conditional target을 바꿀 수도 있다. Confidence는 반드시 annotation이 맞을 확률을 뜻하지 않는다. 라벨을 만든 reader가 confidence까지 만들었다면 특히 그렇다. 라벨 내용, target scale, missingness mask, example weight를 하나의 “라벨 정제”로 묶지 말고 각각 무엇을 바꿨는지 구분해야 한다.
Report group과 전문가 기준의 calibration
5위 팀은 내가 공개한 표를 포함한 두 개의 report table에서 시작했다. 초기 calibration인 calA는 soft target을 전문가 positive 빈도에 맞췄다. 각 validation fold에 쓸 조정은 다른 fold의 전문가 사례만으로 fit했다. 학습과 inference를 고정한 CoAtNet의 Private AUC는 0.916에서 0.926으로 올랐다. 기존 공개 라벨에서도 유용한 정보를 더 얻을 수 있음을 보여 주는 matched 비교다. 이후 EfficientNetV2-M의 0.946에서 0.954로의 개선은 새 라벨 recipe와 학습을 열일곱 epoch에서 스물다섯 epoch로 늘린 변경이 함께 들어 있다. 이 차이를 모두 calibration 효과로 볼 수는 없다.1
전역 보정 하나로 해결되지 않는 차이도 있었다. Hedged·low-grade finding에 준 약 0.75의 report-positive label은 전문가 확인율이 38%였다. Effusion에서 추정한 synovitis와 판독문이 직접 기술한 synovitis에는 모두 약 0.84를 줬지만, 확인율은 38%와 65%로 달랐다. 점수만 입력으로 쓰는 변환은 같은 값을 받은 두 사례를 group에 따라 다르게 처리할 수 없다. Group을 나누면 전역 보정만으로는 쓸 수 없던 정보를 활용할 수 있다.
38위는 report statement를 rubric-positive, threshold 미달, uncertain, negative, unmentioned로 나누고 근거 문장과 severity를 붙였다. 확인한 gold study–finding pair 중 전문가 positive는 각각 unmentioned 9/144, explicit negative 9/197, mild·borderline 32/96, rubric-positive 128/150이었다. 여러 finding을 합쳐 센 진단용 빈도다. 독립 study 144건이나 모든 질환에 공통인 확률로 읽어서는 안 된다.15
| Report group | 관측된 전문가 positive pair | Target을 만들 때의 의미 |
|---|---|---|
| Unmentioned | 9 / 144, 약 0.06 | 이 표본에서는 대체로 negative였지만 정확히 zero도, annotation 실패와 같은 상태도 아님 |
| Explicit negative | 9 / 197, 약 0.05 | 모델의 추출 오류를 생각하기 전부터 negative 문구 자체가 완전하지 않음 |
| Mild·borderline | 32 / 96, 약 0.33 | 낮은 중증도 표현만으로 대회의 definite positive를 만들 수 없음 |
| Rubric을 충족한 positive | 128 / 150, 약 0.85 | 모든 positive를 반복해서 낮추면 지나치게 보수적인 target이 될 수 있음 |
Unmentioned에 0.05와 절반의 weight를 주는 실험은 열한 finding에만 적용했다. Entry의 84%가 unmentioned인 synovitis는 제외했다. Public은 0.909에서 0.921로 올랐다. Mild·borderline label을 약 0.33으로 둔 변경도 도움이 됐지만, 0.20으로 더 낮추면 나빠졌다. 같은 pipeline에서도 missingness가 특히 큰 synovitis를 따로 다뤘다는 점이 이 결과를 해석하는 조건이다.
이후 이 팀은 확실한 positive group까지 지나치게 낮아졌음을 발견했다. 모든 소견을 합친 해당 group의 positive rate를 prior로 사용하고 prior strength를 열다섯으로 둬 finding–group별 rate를 추정했다. 그다음 group 안의 순서는 유지하면서 라벨 수준을 shrunk rate 쪽으로 옮기되 변화량을 제한했다. Shrinkage 자체는 일반적으로 다음처럼 쓸 수 있다.
\[\widehat\pi_{c,g}=\frac{k_{c,g}+\kappa\pi_g}{n_{c,g}+\kappa}, \qquad \kappa=15,\]여기서 $k_{c,g}$는 전문가 pair $n_{c,g}$개 중 positive 수이고, $\pi_g$는 해당 report group을 소견 전체에서 합쳐 계산한 rate다. 원문의 후속 capped level adjustment는 별도 단계다. Shrinkage 식만으로 최종 target transform이 모두 정해지는 것은 아니다. Compact single model의 re-levelling 비교는 Public/Private 0.958/0.945에서 0.960/0.948이었다. 그 수준을 정하는 데 쓴 전문가 사례로는 결과 모델을 독립적으로 평가할 수 없었다.
전문가 사례는 target을 평가하는 데도, target 자체를 개선하는 데도 쓸 수 있다. Calibration을 설계하는 데 정답을 활용했다면 이후 같은 사례의 점수는 development 결과다. 작은 panel을 supervision 개선에 얼마나 쓰고, 그 뒤 어떤 비교를 남겨 둘지 정해야 했다.
Matched student 비교와 12-slice 판독 실험
의미 있는 student를 고정하고 target만 바꾸는 비교가 라벨의 유용성을 판단하는 데 가장 직접적이다. 21위의 fixed-epoch 비교는 group split, 초기화, update budget, inference 설정을 동일하게 뒀다. Epoch 열여섯에서 training pool은 4,345 study였고, 3,613건을 image-label로 교체했다. 미리 정한 무작위 832-study 평가 subset은 image-assisted reference를 썼으며, 0.5를 넘으면 positive로 읽었다. 작은 전문가 세트는 두 번째 비교 기준이었다.6
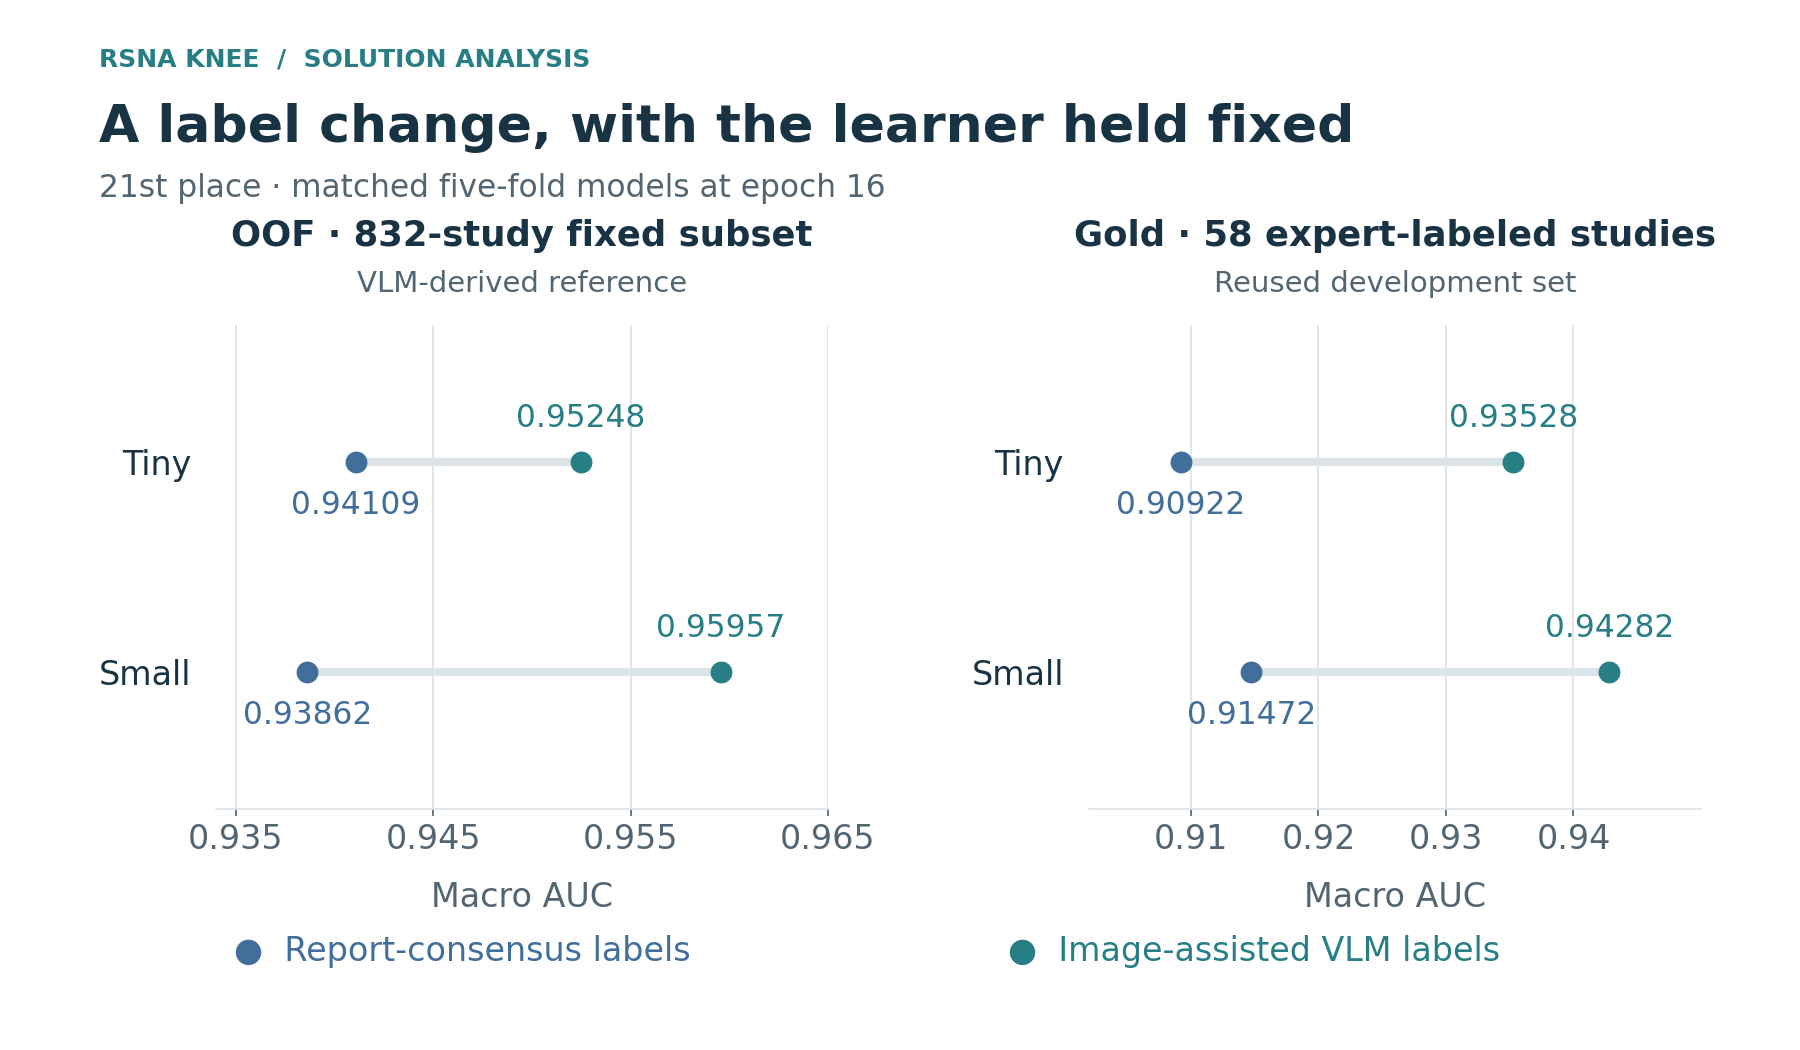
Figure 1. 21위의 fixed-epoch 비교. OOF는 미리 정한 무작위 832 study에서 image-assisted 확률이 0.5를 넘으면 positive로 두고 계산했다. Gold는 개발에 재사용한 전문가 사례 58건이다. 두 패널의 scale은 다르다.
| Student와 학습 target | 832-study OOF AUC | Expert-58 AUC |
|---|---|---|
| ConvNeXt-Tiny, report consensus | 0.94109 | 0.90922 |
| ConvNeXt-Tiny, image-assisted | 0.95248 | 0.93528 |
| ConvNeXt-Small, report consensus | 0.93862 | 0.91472 |
| ConvNeXt-Small, image-assisted | 0.95957 | 0.94282 |
큰 reference는 새 라벨과 같은 계보이므로 그 점수만으로 전문가 target에 더 가까워졌다고 입증할 수는 없다. 전문가 사례에서도 개선 방향이 같았다는 점이 annotation을 완성할 두 번째 근거였다. 다만 반복해서 확인한 58건은 독립적인 임상 test가 아니다. 두 열 모두 학습한 student를 평가한 점수이며, source 라벨표 자체의 AUC와도 구분해야 한다.
내 H1c에서도 같은 논리의 일부를 시험했다. Reader에는 판독문과 fluid-sensitive slice를 최대 열두 장, 평면마다 네 장씩 줬다. Report-only, 반복 판독, 다른 study의 영상으로 바꾼 판독을 포함한 control 전체에서 275회 호출했다. Pilot 백 사례를 재사용하고 4,307건을 추가 판독해 총 4,407 study의 라벨을 완성했다. 같은 조건의 complete five-fold mmE·mm12 student를 학습하고 clean baseline의 identity도 유지했다. 그 작은 student 설정에서 Public AUC는 mm12 0.914, control 0.911이었다.
Pilot에서는 coverage 문제가 이미 드러났다. 평면당 네 장으로는 국소적인 marrow finding을 놓칠 수 있었다. Effusion은 올바른 영상과 영상 교체에 반응했지만 contusion은 여전히 report 의존이 강했다. Wrong-image control은 영상이 답에 영향을 주는지, report anchoring이 있는지를 확인할 수 있다. 올바른 lesion을 근거로 판독했는지까지 입증하는 대조군은 아니다.
남은 질문은 구체적이었다. 필요한 anatomy를 더 잘 보여 주거나 그 정보를 더 잘 활용하는 reader를 쓰면, 같은 student가 더 유용한 target을 배울 수 있는가 하는 점이었다.
Reader 다양성과 근거 수집 비용
낮은 순위의 사례에서도 새 정보원과 같은 text의 반복 판독을 구분할 단서를 얻을 수 있다. 49위는 local Qwen reader와 공개 라벨을 평균해 label AUC 약 0.895를 얻었고, hosted descriptive reader를 더해 0.899로 올렸다. 반면 다섯 수준의 rubric 응답은 출력의 quantization 때문에 순위 구분이 뭉개져 0.809에 그쳤다고 보고했다. 공개 regex baseline보다도 낮았다. Mention·severity를 나누고 코드로 확률을 부여하는 schema가 더 효과적이었다. 의료적 정의가 중요하지 않았던 것이 아니라, 출력 표현에서 정보가 손실된 사례다.16
102위는 study당 응답 스무 개를 만들었다. Local model 두 개가 각각 원어 판독문 다섯 회, 영문 번역 판독문 다섯 회를 읽었다. 이후 unmentioned synovitis를 effusion·OA와 연결하는 명시적 규칙을 적용했다. Report interpretation을 상당히 많이 평균했지만, 모든 응답은 같은 원래 text와 미언급 소견에 대한 가정에 의존했다. 72위도 라벨 AUC가 나쁘지 않고 모델 이름이 달랐는데도 report-reader source를 더해 Public 개선을 얻지 못했다.1718
다양성이 도움이 되는 경우도 있다. Sakaku의 최종 Mix5는 Astra v1, Astra v2, 팀원이 만든 별도의 Astra source, Hulu, Qwen을 각각 30%, 20%, 30%, 10%, 10%로 결합했고 모든 소견에 같은 weight를 썼다. 앞서 소견별로 자유롭게 fusion weight를 맞췄을 때의 이점은 leave-one-out에서 유지되지 않았다. 최종 설계는 서로 다른 readout을 소수로 결합하고, 데이터에 맞춰 정할 weight의 수를 줄인 방식이었다. 특정 provider 하나나 계속 늘어나는 reader 목록이 필수라는 증거는 아니다.
Annotation 비용도 training 비용과 따로 봐야 한다. 영상 스물한 장의 packet, 277-image request, viewer session은 token, caching, latency, 실패, coverage 비용이 서로 다르다. 전체 작업에는 reader나 구독의 사용 여력, 영상 rendering, source identity 보관, 완료 사례를 건너뛰는 재개 방식, 확률 검사, student 학습, 최종 inference 시스템으로의 연결이 필요하다. Sakaku는 cached input, uncached input, output을 따로 기록하고 미완료 사례만 재개했다. 21위 저자는 자신의 remote-viewer 설정에서 추가 API 요금이나 subscription quota 소모 없이 annotation을 끝냈다고 보고했다. 그 환경의 접근 방식에 대한 설명이지 누구나 비용 없이 쓸 수 있다는 견적은 아니다.
이 사례들에서 supervision의 품질은 reader가 무슨 근거를 보고, 이를 어떤 target으로 표현하며, student가 그 target에서 무엇을 배우는지에 달려 있었다. Annotation을 개선하면 test-time 모델을 추가하지 않고도 classifier를 강화할 수 있다. 그러나 student의 입력이 해당 lesion을 crop이나 sampling으로 버렸다면 좋은 target만으로는 충분하지 않다.
2. 영상 정보와 모델 구조
물리 좌표와 영상의 범위·밀도
MRI study는 고정된 장수의 사진 묶음이 아니라 공간적인 측정값의 집합이다. 같은 array 크기라도 field of view가 다를 수 있고, 같은 slice 수라도 덮는 깊이가 다를 수 있다. Array에서 이웃한 두 slice의 물리적 간격도 일정하지 않을 수 있다. Classifier가 쓸 수 있는 근거는 preprocessing을 통과한 정보뿐이다. Forward pass 전에 버린 meniscus 경계는 backbone 용량을 늘려도 복구되지 않는다.
In-plane field of view가 $F$ mm이고 이를 $N$ pixel로 resize하면 nominal scale은 pixel당 $F/N$ mm다. 5위 시스템은 150 mm full-field 영상과 80 mm regional crop을 모두 384 pixel로 만들었다. 각각 약 0.39와 0.21 mm/pixel이다. 2 mm 구조는 전자에서 약 5.1 pixel, 후자에서 9.6 pixel을 차지한다. 선형 sampling density로는 거의 1.9배지만, interpolation으로 원래 acquisition에 없던 세부를 만드는 것은 아니다. 무릎 전체를 하나의 input grid에 압축할 때 이미 존재하는 국소 정보를 덜 잃는 것이 이점이다.1
Depth도 in-plane scale만큼 중요하다. Filename이나 instance number를 정렬했다고 물리적 slice 순서까지 맞는 것은 아니다. Slice의 patient-coordinate origin을 $P_k$, plane normal을 $n$이라 하면 $n^\top P_k$로 stack 안의 위치를 정할 수 있다. In-plane axis와 pixel spacing은 pixel을 patient-space 위치로 매핑한다. Crop, lesion annotation, 다른 sequence의 대응 view가 같은 기준의 transform을 사용해야 한다. 변환이 어긋나면 tensor pipeline이 오류 없이 돌아가도 라벨은 엉뚱한 anatomy와 연결된다.
“Three-slice input”도 실제로는 다른 입력일 수 있다. 원본에서 연속한 세 slice는 acquisition의 국소적인 depth sampling을 유지한다. Series에서 32개 위치를 균등하게 고른 뒤 이웃한 세 장을 쓰면 그 사이의 물리적 거리가 달라진다. 32위는 원 DICOM에서 실제로 인접한 slice를 썼다. 우승 팀의 sakaku branch는 sampling한 32개 위치에서 triplet을 만들었으므로 원본 기준으로는 연속하지 않을 수 있다. Target에 필요한 anatomy와 depth context가 slab 안에 남는지가 두 입력을 비교할 기준이다.98
Native-field N은 최대 204.8 mm field에서 0.4 mm/pixel을 유지하고 얇은 원본 slice를 약 3.5 mm slab으로 집계했다. S6F는 full-field와 함께 SKM-TEA localization model로 위치를 정한 local view를 사용했다. 이후에도 남는 coverage 문제는 finding별로 달랐다. Crop이 superior fluid pocket을 포함하는지, lateral-compartment view가 중요한 meniscus 경계를 자르는지, 선택한 위치 사이로 얇은 lesion이 빠지는지를 확인해야 했다.
범위를 넓히면 sampling density가 낮아질 수 있다. 977위는 44 slice를 유지한 채 범위를 중앙 2–98%로 넓히자 보고 점수가 0.926에서 0.917로 내려갔다. 넓은 범위에서 64 slice를 쓰면 0.928이었다. 원문은 이 점수를 Private이라고 명시하지 않는다. 이 비교에서 함께 바뀐 것은 span과 density다. Anatomy를 더 포함하더라도 국소적인 detail을 유지하려면 sampling 위치를 충분히 늘려야 했다.19
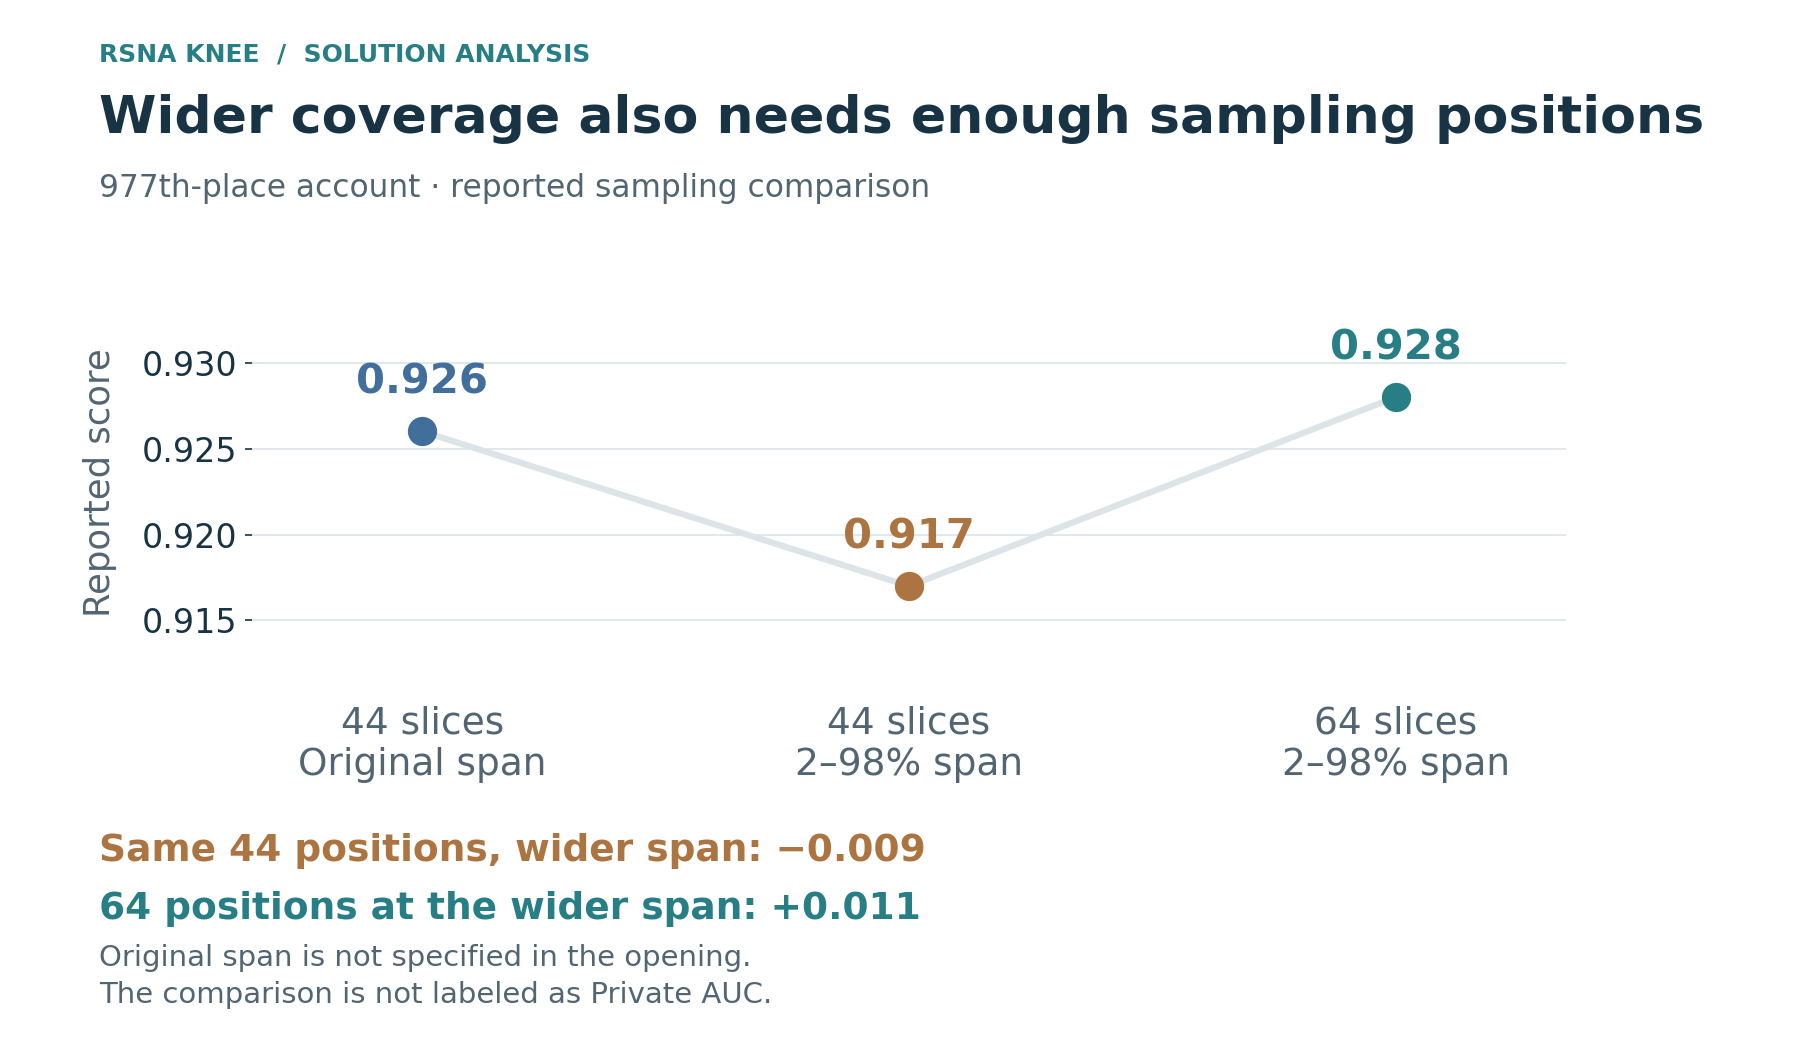
Figure 2. 977위의 기존 44-slice recipe는 0.926, 같은 44 slice로 범위를 2–98%까지 넓히면 0.917, 넓은 범위에서 64 slice를 쓰면 0.928이었다. 기존의 물리적 범위와 해당 점수가 Private인지는 원문에 명시되지 않았다.
2위는 초기 모델이 series당 영상 네 장만 읽는 입력 버그를 발견했다. 열다섯 장을 읽도록 고치자 58-case development AUC가 0.033 개선됐다. Private 이득도, sampling 증가만의 효과를 모두 분리한 값도 아니지만, 저자가 대부분의 architecture 변경보다 이 입력 수정을 중요하게 본 이유를 보여 준다. 74위의 초기 고정 장수 sampler도 특히 긴 series에서 손실이 컸고, 전체 slice의 약 28%를 놓쳤다. 이후 모든 slice를 읽는 방식으로 바꿨다. Coverage는 데이터 정리의 세부 사항이 아니라 모델이 학습할 정보를 결정하는 변수였다.311
Sequence role과 좌우 정규화, 누락된 view
Geometry가 맞아도 각 영상의 contrast와 역할은 따로 알려 줘야 한다. Fat-suppressed fluid-sensitive 영상, structural view, 서로 다른 plane은 finding의 서로 다른 근거를 보여 준다. 이를 순서 없는 stack으로 섞으면 network는 질환을 배우면서 영상의 역할까지 appearance로 알아내야 한다. 신뢰할 수 있는 role metadata는 이 부담을 줄이지만, 그 값이 무엇을 뜻하는지부터 확인해야 한다.
22위는 24,371 series를 확인했고 그중 13,046에서 쓸 만한 description을 찾지 못했다. 이름이 있어도 재촬영·reconstruction 뒤 실제 영상과 맞지 않는 사례가 있었다. 최종 선택 규칙은 host table과 DICOM acquisition field를 함께 썼다. Plane, inversion recovery, gradient-echo 여부, repetition·echo time, fat-suppression hint, obliquity, 2D/3D 정보다. Series 이름만 보고 PD와 T2를 기계적으로 나누지 않았고, echo time은 수치 그대로 모델에도 제공했다. Sequence·TR·TE가 모두 없는 subset에만 이름 기반 weighting fallback을 적용했다.7
Host의 Fat_Suppression flag도 해석이 필요했다. 저자는 이 값이 모든 fat-suppressed sequence의 물리적 분류라기보다 fluid-brightness를 나타낸다고 봤다. Water-selective acquisition과 inversion-recovery 영상에는 추가 규칙을 적용했다. 값의 생성 과정을 모른 채 “FS” token을 넣으면 의도와 다른 속성을 전달할 수 있다. 반대로 scanner, coil, sex, site를 구분하는 metadata를 무차별적으로 추가하면 site 관련 shortcut을 통해 report 예측만 강화할 수도 있다.
Laterality normalization은 medial·lateral anatomy를 같은 방향으로 맞추려는 설계다. 대부분의 target에서 중요한 것은 왼쪽 무릎인지 오른쪽 무릎인지보다 이 해부학적 구분이다. 다만 width flip이 모든 plane에서 같은 물리적 변환은 아니다. 977위는 sagittal triplet에서 channel 순서를 뒤집고 coronal·axial window에서는 width를 반전했다. 32위는 anatomical mirror TTA에 맞춰 sagittal position embedding도 변환했다. 입력을 뒤집으면 위치 정보도 같은 anatomy를 가리키도록 바뀌어야 한다.199
22위의 side 판정은 tag, image position, 작은 image classifier를 차례로 사용해 충돌을 해결했다. ACL 가까이의 유용한 oblique coronal acquisition은 남기고, obliquity만을 이유로 제거하지 않았다. 반복 acquisition은 attribute로 deduplicate했으며, slot에는 아직 없는 sequence type을 우선 배정하고 빈자리는 남는 series로 채웠다. Three-slice window가 series 경계를 넘지 않도록 한 것도 같은 목적이다. 각각 모델에 전달되는 anatomy와 contrast를 바꾸는 규칙이다.
Missing input에도 원인이 있다. 해당 acquisition이 없을 수도, selection이나 decoding이 실패했을 수도 있다. Missing role을 mask하는 것과 다른 contrast로 채우는 것은 다른 입력을 만든다. Sakaku의 모델은 slice의 유효성과 반복 여부를 표현하고 missing role을 mask했다. 22위는 특이한 weak-effusion group에 여러 inference-time 대체 방식을 적용해도 개선을 얻지 못했고, attribute-aware input도 격차의 일부만 회복했다. Expected shape의 tensor를 채우는 것만으로 필요한 view가 복구되는 것은 아니다.87
Window 집합과 finding별 aggregation
한 study에는 수많은 image window가 있지만, 주어지는 정답은 study 수준의 열두 finding뿐이다. Multiple-instance learning은 두 수준을 연결하는 실용적인 방법이다. 공통 2D encoder가 각 window의 feature를 만들고, aggregation head가 finding마다 어떤 window를 얼마나 반영할지 결정한다. 매번 완전한 3D volume을 처리하지 않으면서도 pretrained 2D backbone을 활용할 수 있다.
Finding별 attention을 사용하는 전형적인 모델에서 window feature를 $h_j$, attention score를 $s_{c,j}=w_c^\top\tanh(Vh_j)$라고 하면, pooled representation은 다음과 같다.
\[\beta_{c,j}=\frac{\exp(s_{c,j})}{\sum_k\exp(s_{c,k})},\qquad r_c=\sum_j\beta_{c,j}h_j.\]Finding마다 $\beta_{c,j}$를 따로 두면 ACL과 effusion이 서로 다른 영상 근거를 이용할 수 있다. Hierarchical 방식은 먼저 series 안의 window를 모으고, 그다음 study 안의 series를 모은다. Spatial 방식은 backbone feature map 안에서도 위치를 선택한다. 모두 어느 정보를 얼마나 반영할 것인가라는 문제를 서로 다른 수준에서 다룬다. 따라서 “MIL을 썼다”는 말만으로는 실제로 어떤 병목을 해결했는지 알 수 없다.
7위 모델은 위치 정보를 명시적으로 넣었다. 공통 CNN이 각 window를 격자 형태의 token으로 바꾸고, 각 token에 series의 종류와 공통 knee 좌표계의 3D 위치를 부여했다. Crop affine으로 crop 내부 좌표를 공통 좌표계에 되돌려 놓았다. Finding마다 두 query가 token을 읽었고, 별도의 gated MIL head도 예측을 만들었다. 두 head의 logit은 평균했다. Full series에 13개의 고정된 regional zoom view를 추가해, decoder가 넓은 문맥과 국소적인 세부 소견을 함께 비교할 수 있게 했다.4
이 모델은 training과 inference에서 사용하는 bag의 크기가 크게 달랐다. Inference에서는 선택한 모든 series와 zoom region의 매 slice마다 window를 평가했다. 작성자는 이렇게 커진 bag에 맞춰 attention을 날카롭게 조정했다. EfficientNetV2-S에는 1.75, ConvNeXt에는 1.25의 배수를 적용했다. 단순한 예로 그 이유를 볼 수 있다. 유용한 token 하나의 score가 $a$이고, 나머지 $K-1$개 token의 score가 $b$라면, sharpness $\tau$에서 유용한 token에 할당되는 attention은 다음과 같다.
\[\frac{1}{1+(K-1)\exp[-\tau(a-b)]}.\]Score 차이가 그대로인데 bag만 커지면 유용한 token의 비중이 줄어들 수 있다. Attention을 날카롭게 만들면 이를 보완할 수 있지만, 우연히 높게 나온 엉뚱한 token도 함께 강조할 수 있다. 위 배수는 해당 recipe에서 선택한 값이지, 촘촘한 MRI inference에 일반적으로 적용할 설정은 아니다.
22위 모델은 attention pooling 앞에 두 층의 window Transformer를 추가했다. Residual output projection은 0으로 초기화해, 처음에는 더 단순한 pooling 모델처럼 동작하게 했다. 작성자는 이 초기화가 없으면 모델이 collapse했다고 보고했다. Window token에는 plane, position, acquisition embedding을 넣었고, training 중에는 acquisition attribute를 일부 가렸다. 이 사례에서 중요한 architecture 질문은 “Transformer인가 CNN인가”보다 구체적이다. 이미 유용한 초기 동작을 유지하면서 window 사이의 정보 교환을 어떻게 추가할 것인가라는 문제다.7
S6F에도 finding별 spatial attention과 window attention이 있었다. 남은 문제는 token이 필요한 물리적 정보를 보존하는지, head가 그 역할과 위치를 구분하는지, 높은 attention이 실제 근거를 가리키도록 직접적인 supervision을 줬는지였다. 입력과 supervision이 그대로라면 head만 바꾸어도 예측은 기존 모델과 비슷하게 남을 수 있다.
Anatomy ROI와 lesion evidence
Anatomy ROI는 “이 finding을 어디에서 평가할 것인가”를 정한다. Lesion box는 “실제로 이상 소견이 보이는 위치는 어디인가”를 나타낸다. 정상 meniscus에도 anatomy ROI는 있으며, lesion annotation이 없다고 병변이 없는 것은 아니다. 우승 모델의 두 branch는 이 차이를 서로 다른 방식으로 활용했다.
Tascj의 branch는 finding별 3D ROI 안에서만 pooling했다. Feature vector가 $v_r$, cell과 ROI의 겹침 정도가 $o_{c,r}$, 학습한 attention score가 $a_{c,r}$라면, normalized attention은 다음과 같은 형태다.
\[\alpha_{c,r}=\frac{o_{c,r}\exp(a_{c,r})}{\sum_j o_{c,j}\exp(a_{c,j})}, \qquad h_c=\sum_r\alpha_{c,r}v_r.\]Normalization은 한 image 안이 아니라 관련 series의 cell과 slice 전체에 걸쳐 이루어진다. 보관된 구현은 subcell sampling으로 overlap을 추정하고 ROI의 depth 범위 밖을 mask한다. Overlap mass가 양수여야 하며, ROI가 비어 있으면 series 평균을 사용한다. Attention convolution을 0으로 초기화하면 overlap-weighted average에서 학습을 시작한다. Study label만으로 위치와 진단을 모두 알아내게 하는 대신, 정해진 영역 안에서 중요한 근거를 찾게 하는 방식이다.20
같은 branch에는 lesion coverage와 report embedding을 예측하는 auxiliary head도 있었다. 코드의 annotation-state mask는 사용할 수 없는 supervision을 제외하며, inference loader는 auxiliary head의 weight를 제거한다. 다만 ROI detector와 side classifier는 test에서도 실행된다. Training loss를 없앤다고 입력 영역을 찾는 비용까지 사라지는 것은 아니다.
Sakaku의 branch는 spatial annotation을 주로 공통 feature extractor를 학습시키는 데 사용했다. MCL, 두 meniscus, 세 OA compartment의 여섯 target은 global feature $g$와 anatomy-attended feature $a_c$를 다음과 같이 결합했다.
\[h_c=g+\gamma(a_c-g),\qquad \gamma_{\mathrm{init}}=0.1.\]Residual은 global pooling에 가까운 상태에서 시작해 local evidence를 얼마나 반영할지 학습한다. Regional MIL, attention mass constraint, reliable-negative window supervision이 attention을 유도했다. 나머지 여섯 target은 global spatial pooling을 유지했다. 모든 finding을 작은 영역으로 제한하지 않고, anatomy가 분명한 target에 위치 정보를 추가하면서 전체 context도 보존한 것이다.8
열두 target의 lesion-evidence head도 같은 backbone map을 재사용했다. Pooling한 evidence에서 training prevalence에 해당하는 항을 뺀 residual을 더했으며, 보고된 식은 $z=z_{\mathrm{main}}+0.25(e_{\mathrm{lesion}}-\operatorname{logit}\pi_{\mathrm{train}})$이다. Prevalence는 training data로 계산했다. 이 연산 자체가 최종 logit의 임상적 calibration을 보장하지는 않는다.
Annotation과 영상의 좌표도 일치해야 했다. Lesion archive는 특정 series와 slice에 요청한 finding을 기록했다. Supervision은 geometry가 맞고 triplet의 유효한 중앙 slice에 해당하며 eligibility rule을 충족할 때만 사용했다. 요청한 record의 누락, 보이지 않는 lesion, 명시적인 negative는 구분했다. 일반적인 masked spatial objective는 다음과 같다.
\[\mathcal L_{\mathrm{spatial}} =\frac{\sum_{i,c,r}m_{i,c,r}\,\ell(\hat e_{i,c,r},a_{i,c,r})} {\sum_{i,c,r}m_{i,c,r}},\]$m$는 lesion이 있다는 표시가 아니라, supervision을 적용해도 된다는 표시다. 분모가 양수일 때만 loss를 계산한다. 빠진 annotation을 모두 negative로 바꾸면, 병변의 위치를 찾는 문제 대신 annotation 과정에서 놓친 부분까지 따라 배우는 문제가 된다.
이 branch는 test에서 annotation file이나 detector pass가 필요하지 않았다. Classification을 위해 이미 계산한 image feature map을 사용하므로 crop마다 backbone을 다시 실행하지 않고 readout을 강화할 수 있었다. 이전의 half-image meniscus 방식은 backbone 평가 비용이 약 2.2배였다. Feature 재사용은 이와 다른 성능–비용 절충안이었다. Anatomy-aware package의 Public은 0.956에서 0.960으로 올랐지만 local 차이만으로는 결론을 내리기 어려웠다. 여러 component가 함께 바뀐 package 결과이며 특정 loss 하나의 효과는 아니다.8
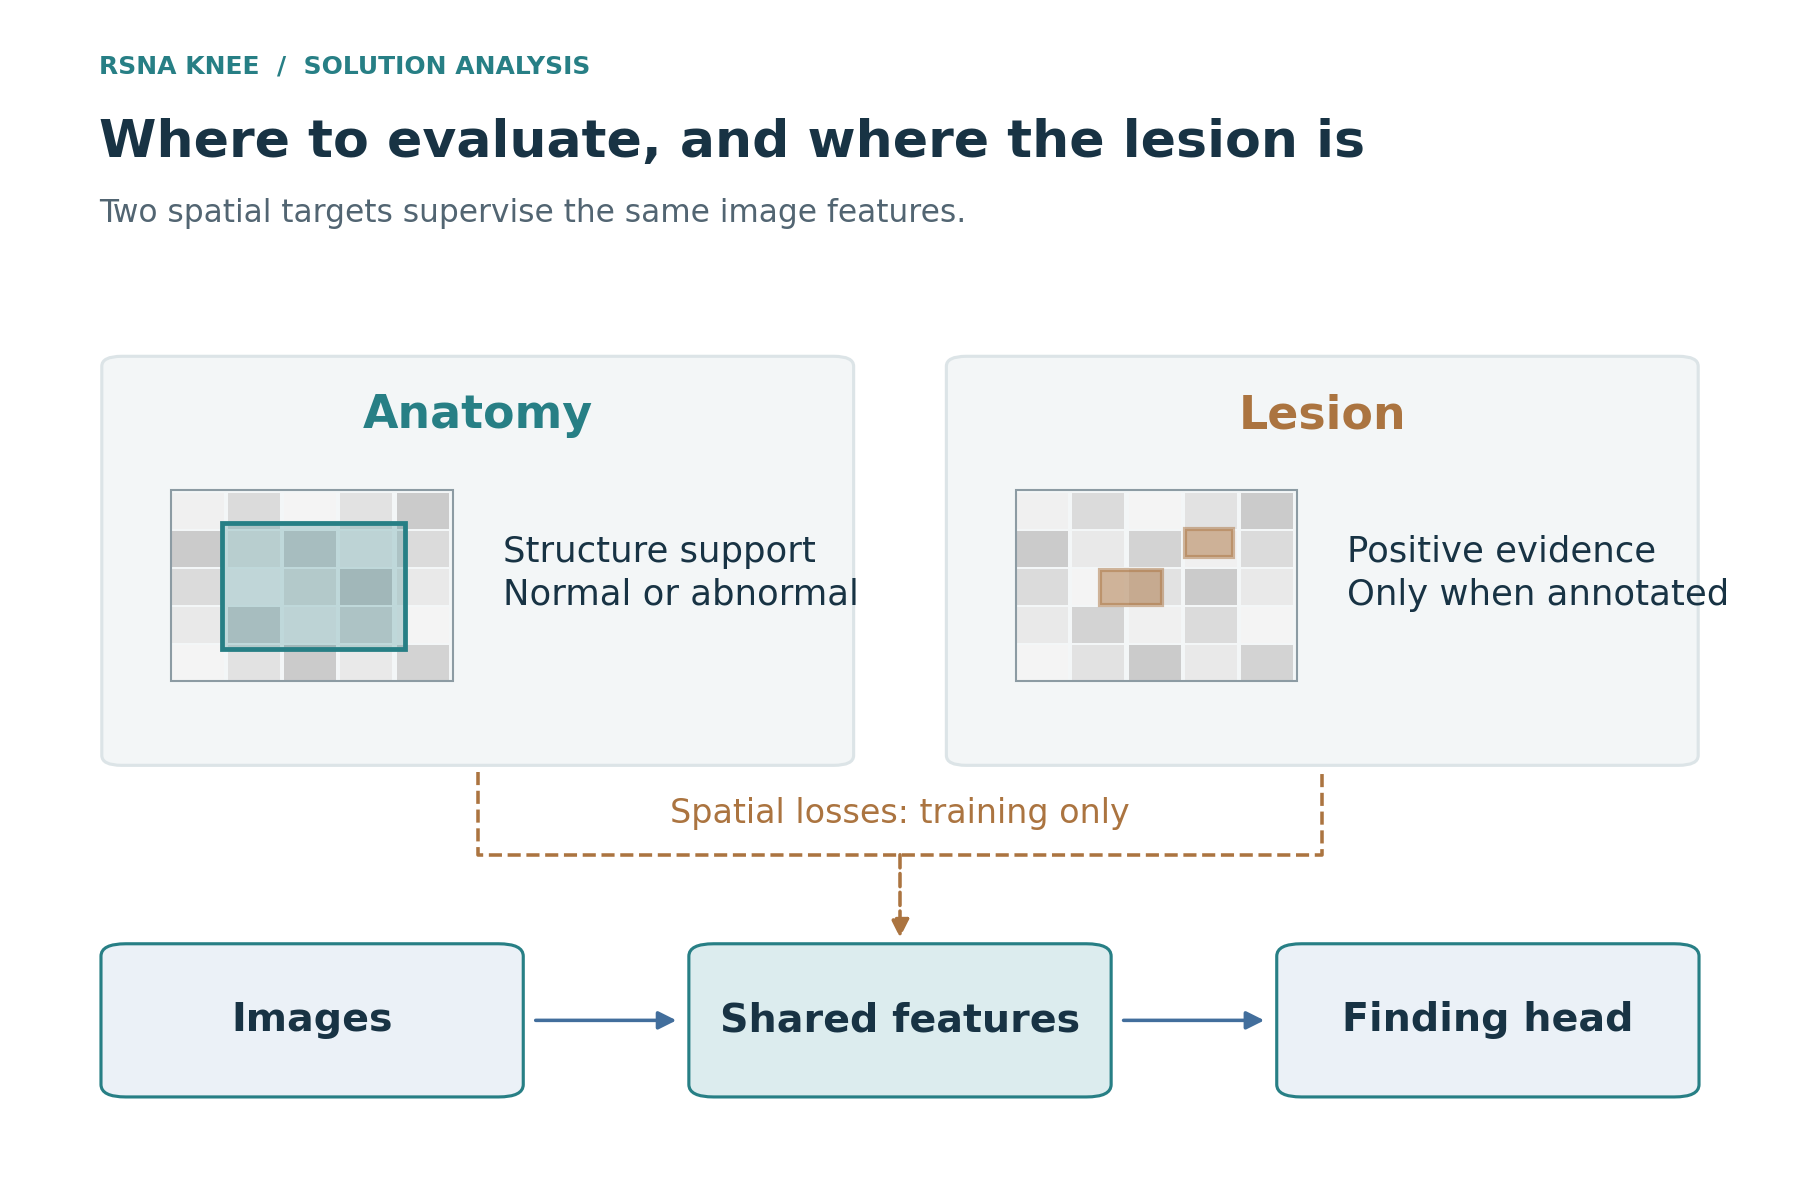
Figure 3. Anatomy ROI는 판독할 영역을 정하고 lesion evidence는 공간 target을 제공한다. 사용할 수 없는 annotation은 mask한다. Training에만 쓰는 spatial loss는 classifier feature를 재사용한다. Inference에서도 detector를 쓰는 방식은 별도의 test-time 비용이 든다.
Tascj의 six-channel variant는 인접 slice 여섯 장을 넣은 모델이 아니었다. Plane과 fat suppression으로 정한 역할별 영상을 patient 좌표계에서 현재 series에 맞춰 resampling해, 한 번의 encoder 평가에 여러 contrast를 제공했다. 좌표 기준을 맞춰도 촬영 자세나 움직임 때문에 sequence 사이의 anatomy는 완전히 일치하지 않을 수 있다. 임의의 image 여섯 장을 이어 붙이는 것과 구분되는 설계이며, 작성자는 backbone만 다양하게 바꾸는 것보다 이 view 변경에서 더 큰 이득을 얻었다고 보고했다.20
우승 모델은 Sakaku의 three-model branch와 Tascj의 branch를 1:1로 결합했다. Tascj의 다섯 run group에는 17개의 classification checkpoint가 있고, Sakaku는 세 개의 full-data model을 제공했다. 보관된 integration code에서도 branch 단위의 가중치를 확인할 수 있다. 스무 모델을 같은 비중으로 평균한 구성이 아니며, 이 숫자가 최적의 모델 개수라는 근거도 아니다.21
Compartment, 문맥, finding별 specialist
5위는 femur·tibia·patella mask로 네 crop region을 정했다. TotalSegmentator-MRI로 초기화한 nnU-Net을 competition series 1,200개로 학습했다. Regional crop을 tagged series로 추가하면서 평균 입력은 약 5.5개 series에서 17.6개로 늘었다. Bone segmentation과 laterality classification도 test에서 실행했으므로 spatial detail의 이점에는 추가 preprocessing과 영상 평가 비용이 따랐다.1
EfficientNetV2-M은 새 label과 더 긴 training으로 Private 0.954에 도달했고, 같은 모델과 label에 anatomy-guided crop을 추가하면 0.957이었다. Crop을 쓴 ConvNeXt-B는 0.958이었다. 앞선 0.946에서 0.954로의 변화는 label과 epoch가 함께 바뀌었으므로, 입력 효과를 더 직접적으로 보여 주는 비교는 crop 추가 단계다. Final ensemble도 0.958에 머물렀다. 이후 추가 모델에서 얻을 정보의 상당 부분을 강한 regional model이 이미 담고 있었던 셈이다.
| 입력 변경 | 구체적인 방법 | 보고된 한계 |
|---|---|---|
| 2위의 detail + context | Knee-centered close-up과 whole-knee evidence 결합 | Close-up만 썼을 때 Lateral Meniscus가 0.010 하락했고, context를 복원한 뒤 개선 |
| 5위의 regional crop | 관절과 compartment 구조에 더 많은 pixel 배정 | 강한 regional model에서는 specialist의 추가 이득이 약 0.001 이하 |
| 22위의 compartment input | Weight를 공유하면서 한 번에 한 compartment만 입력 | 사후 medial/lateral subtraction은 오히려 Public 0.007 하락 |
| 32위의 attention-guided zoom | Window를 선택한 뒤 원본 pixel을 약 2×로 확대해 다시 입력 | Finding을 더 늘리거나 zoom 비중을 20%에서 30%로 올리면 악화 |
2위의 close-up-only 모델은 whole-knee context를 복원하기 전까지 Lateral Meniscus에서 0.010을 잃었다. Local detail과 context가 서로 보완해야 했다. Commit을 고정해 확인한 공개 rewrite는 geometry와 tissue width로 knee centre를 추정하고, detail/context별 pooling을 gate로 결합한다. 유용한 localization 실험이 반드시 새로운 대규모 segmentation 학습을 요구하는 것은 아니었다.322
22위는 medial degeneration과의 상관관계로 lateral OA를 맞히는 오류를 겨냥했다. Weight를 공유하는 compartment model에 한 번에 한 compartment만 주고 lateral 입력을 뒤집어 방향을 맞췄다. Opposite compartment를 직접 보지 못하도록 제한한 것이다. 네 번째 compartment classifier는 일부 discordant negative의 label을 바꾸고 crop도 weight-bearing zone으로 옮겼다. 이 모델의 비중은 최종 lateral OA weight의 74%였다. Network 크기보다 허용하는 정보, anatomy 기준, supervision을 함께 바꾼 개입이다.7
32위 zoom model은 어려운 target마다 여섯 window group을 선택한 뒤 원본 DICOM으로 돌아가, lateral compartment나 patellofemoral 부위를 더 높은 해상도로 추출했다. Selector도 각 fold의 training pipeline에 속했다. Student는 held-out fold를 평가에만 사용해야 했다. Selector가 해당 사례를 학습했다면 비교의 독립성이 깨진다. Zoom은 Lateral Meniscus, Lateral OA, PF OA에만 반영했다. 비중을 늘리거나 다른 finding까지 확장하면 오히려 나빠졌다.9
5위는 crop이 놓친 근거를 직접 확인했다. 기존 bone crop에 포함된 slice는 effusion·synovitis 근거로 지목한 slice의 78–80%였으며, 누락된 것은 crop 위쪽에 있었다. Axial slab을 위로 20 mm 확장해 이 결함을 고쳤다. 성능이 낮은 finding을 대상으로 한 마흔 번의 짧은 fine-tuning에서는 Lateral Meniscus만 기준을 통과했고, main model의 앞 layer를 재사용했다. Specialist의 의미가 구체적이다. 예산을 채우기 위한 full model이 아니라 특정 오류를 줄이는 데 필요한 계산을 추가했다.
73위의 KneeSplatNet 실험은 이런 구성 요소의 기여를 어디까지 주장할 수 있는지 잘 보여 준다. Stride-16 feature cell을 공통 knee 좌표계로 옮기고, 8 mm 간격의 12 × 12 × 12 grid에 feature를 splatting했다. Fat-suppressed 영상과 그 외 영상의 bank를 분리하고, anatomical anchor, hit mask, medial–lateral difference volume을 더해, 일반적인 2.5D pooling 옆에 거친 3D representation을 구성했다. 단순히 attention block을 하나 더 붙인 것과는 다른 구체적인 geometry 설계였다.23
같은 checkpoint에서 inference component를 하나씩 끄고, 두 fold의 held-out study 477개를 LLM-derived reference로 평가했다. 3D path를 제거하면 macro AUC가 0.0049, geometry를 제거하면 0.0011, 앞 stage의 projection을 제거하면 0.0021 하락했다. 이 knockout은 학습된 network가 각 요소를 사용한다는 증거다. 같은 조건에서 학습한 단순한 모델보다 낫다는 증거는 아니다. 완성된 KneeSplatNet은 전체적으로 2.5D control을 이기지 못했다. Anterior compartment·PF OA의 개선과 함께 ACL·meniscus·contusion 성능은 낮아졌다.
최종 predictor는 2.5D ConvNeXt-Tiny 모델들과 patellofemoral close-up model을 결합했다. 3D-splat prototype의 knockout은 학습된 network가 무엇을 사용하는지 보여 줬고, matched simpler control은 그 사용이 전체 성능을 높였는지 시험했다. Finding별 이득은 specialist나 보완적인 branch를 검토할 근거가 될 수 있지만, 이 prototype이 최종 성능 개선을 입증한 것은 아니었다.
Pretraining과 외부 MRI의 활용
외부 MRI는 anatomy 초기화, task-specific encoder 학습, 독립적인 grading, 일부 target만 있는 training row 추가 등 여러 용도로 쓰였다. 용도에 따라 확인해야 할 domain·target 불일치도 달랐다.
2위의 mil-reader는 fastMRI knee image와 fastMRI+ box로 pretraining했다. PF specialist에는 OAI cartilage grade를 학습한 head를 추가했다. 5위 backbone은 OAI knee 2,414개의 MOAKS/WORMS grade에서 만든 327개 binary reading을 먼저 예측하도록 학습했다. 두 single-model 비교에서는 이 초기화로 약 +0.001 Public을 보고했다. 이는 외부 정보를 특정 방식으로 활용한 결과다. 외부 사례를 더 넣으면 그 자체로 유리하다는 뜻은 아니다.31
63위의 비교도 참고할 만하다. Competition triplet 약 371,000개와 fastMRI triplet 380,000개로 DINO pretraining을 세 epoch 수행했다. FastMRI가 없을 때는 효과가 없었지만, 이를 포함하면 OOF가 0.003, 외부 OAI 평가가 0.006 좋아졌다. 반면 OAI MOAKS를 추가 supervision으로 사용한 여섯 실험은 모두 부정적이었고, 주요 fold-0 variant 두 개는 0.010과 0.013 하락했다. 이 system에서는 self-supervised representation 학습에 image를 활용한 것은 도움이 되었지만, 시험한 partial-label supervision은 그렇지 않았다.24
977위 system은 radiographic joint-space grading을 supervision으로 삼는 OAI knee 5,178개를 추가했다. 이 사례들은 medial OA와 lateral OA 두 cell에만 loss를 주었다. Local macro AUC는 0.9277에서 0.9161로, lateral OA는 0.807에서 0.774로 떨어졌다. 작성자는 modality와 정의의 차이, 많은 외부 row가 두 finding만 supervision하면서 생긴 gradient 배분의 변화를 원인으로 추정했다. 어느 요인이 더 컸는지는 이 결과만으로 알 수 없다. 다만 training set을 늘려도 원하는 MRI target을 더 잘 배우는 것은 아니라는 점은 분명하다.19
74위는 OAI reader를 더 선택적으로 사용했다. 외부 모델이 비교적 잘 transfer하는 finding에서만 label의 순서를 조정하거나 투표에 참여시켰다. Medial meniscus와 medial OA는 다른 근거와 비교했을 때 coupling이 맞지 않아 label correction에서 제외했다. 32위의 OAI branch는 단독 Public이 0.960으로 main branch의 0.961보다 낮았지만, 두 branch를 섞으면 도움이 되었다. 단독 점수에서 이기는 대신 다른 오류를 제공한 경우다.119
외부 MRI의 활용은 추가 training image, 유용한 초기화, target에 맞춘 disease head, 외부 진단 panel의 네 가지로 구분할 수 있다. “OAI를 확보한다”는 말만으로는 실험이 정해지지 않는다. Modality, finding 정의, missing-label 처리, fold ancestry, 최종 prediction으로 연결하는 방식이 무엇인지까지 정해야 한다.
Optimization trajectory와 pretrained model의 적응
Label source가 좋아도 learner가 이를 충분히 학습해야 한다. Sakaku는 앞선 224-pixel CoAt 비교에서 backbone의 peak learning rate를 $8\times10^{-6}$에서 $8.944\times10^{-5}$로 높였다. Public은 0.936에서 0.944로 올랐지만, 58-case development AUC는 0.9283에서 0.9215로 떨어졌다. 이 변경은 stopping rule에 따라 실제 training을 이어 간 길이도 바꾸었다. 따라서 이 개입에서 더 나은 learning trajectory를 얻었다고 볼 수는 있지만, learning rate와 training 기간의 효과를 숫자로 분리한 비교는 아니다.8
최종 세 모델은 원래 30-epoch OneCycle horizon을 유지한 채 19 epoch까지 학습하고, epoch 15–19의 EMA checkpoint를 평균했다. 30-epoch schedule에서 19 epoch까지 학습하는 것과, 전체 decay를 19 epoch 안에 압축하는 것은 다르다. 각 update의 learning rate도, 평균하는 checkpoint도 달라진다. 재현하려면 stop epoch뿐 아니라 schedule horizon도 알아야 한다.
다른 solution에서도 같은 구분을 볼 수 있다. 7위 ConvNeXt는 30-epoch schedule을 epoch 20에서 멈추고 후반 weight를 평균했다. 5위의 새 label 비교에서는 training을 17 epoch에서 25 epoch로 늘렸다. 22위는 mid-training score로 변경을 채택하지 않았고, 후반 weight를 평균했다. Residual Transformer도 기존 pooling의 초기 동작을 보존하도록 초기화해야 했다. 성공한 recipe는 짧게 학습한 checkpoint만 보고 architecture의 가능성을 판단하지 않았다. 실제 optimization이 어떻게 진행되는지를 중요하게 다루었다.417
오래 학습하거나 모델을 키운다고 항상 좋아지지는 않았다. 7위는 더 큰 decoder, slice mixer, 강한 augmentation, 큰 backbone에서 반복해서 실패했다. 63위도 여러 대형 대안에서 비용에 맞는 이득을 찾지 못했다. Representation capacity가 부족한지, 입력이 불충분한지, 기존 feature를 충분히 adaptation하지 못했는지는 서로 다른 가설이다. 짧은 architecture 교체 실험만으로는 이를 구분할 수 없다.
계산 재사용과 runtime의 해석
Inference 비용에는 decoding, geometry·ROI 준비, backbone 평가, aggregation head, transfer, startup, 느린 사례의 처리까지 포함된다. Stage를 겹쳐 실행하거나 여러 member가 계산을 공유할 수도 있다. Notebook별 시간을 단순히 더하면 이런 상호작용을 무시하고, checkpoint FLOPs만 세면 그 밖의 비용을 빠뜨린다.
비슷한 study $N$개를 처리하고, study당 CPU 준비 시간이 $t_C$, GPU 시간이 $t_G$, 준비 worker가 $W_C$개, GPU worker가 $W_G$개인 단순한 stream을 생각해 보자. Stage를 겹쳐 실행하는 pipeline은 다음과 같은 처리 시간에 가까워진다.
\[T\approx T_{\mathrm{startup}} +\max\!\left(\frac{Nt_C}{W_C},\frac{Nt_G}{W_G}\right) +T_{\mathrm{tail}}.\]이는 throughput을 설명하는 근사 모델이며 hidden-test 소요 시간의 예측식은 아니다. Study마다 series·window 수가 다르고 file access·crop 실패는 처리 시간에 긴 tail을 만든다. Decoding이 병목이라면 backbone만 가속해도 효과가 작을 수 있다. 반대로 호환되는 모델이 한 번 decode한 study를 공유하면 작은 head를 제거하는 것보다 큰 이득을 얻을 수 있다.
5위 구현은 M1–M3가 쓸 DICOM decoding과 crop 배치를 한 번만 수행했고, Lateral Meniscus fine-tune에는 M3 앞부분 feature를 재사용했다. T4마다 하나의 process를 실행했다. 22위 system도 decode한 DICOM을 공유하고 segmentation/cropping과 model inference를 겹쳐 실행했다. 56개 network는 들어갔지만 61개는 항상 완료하지 못했다. 이는 전체 system에서 얻은 engineering 결과이지, network 개수로 시간을 환산하는 규칙이 아니다.17
1위의 efficiency 구현은 다른 설정이었다. 256-pixel 입력, 하나의 full-data checkpoint, fluid-sensitive series 선택, C++ DICOM 처리, FP16 TensorRT를 사용해 training data로 구성한 1,200-study benchmark에서 230초를 기록했다. 처리 overhead를 크게 줄일 수 있다는 유용한 근거다. Full 384-pixel winning ensemble의 hidden-test runtime으로 읽어서는 안 된다.25
중단과 실패를 어떻게 처리하는지도 runtime의 의미를 바꾼다. 2위 kernel은 core prediction부터 기록하고, 각 budget 안에서 끝난 specialist를 추가한다. 읽지 못한 study에는 default를 쓴다. 7위 notebook은 실패한 사례에 neutral rank를 남길 수 있다. 5위는 stage별 budget을 두고, 22위는 실패한 모델을 빼고 weight를 다시 정규화한다. 내가 선언한 방식은 member, window, series를 조용히 줄이지 않고, 정한 composition 전체를 계산하거나 실패하는 것이었다. 이들의 decoding 공유와 효율적인 batching은 활용할 수 있다. 그러나 실행 중 구성을 바꾸는 fallback의 완료 기록만으로 내 고정된 전체 composition도 들어간다고 판단할 수는 없다.
Inference 결과에는 정확한 operator와 execution policy가 함께 명시돼야 한다. Sample pass는 visible case의 동작을, component estimate는 제안한 구성의 예상 비용을, full run은 실제 workload에서의 완료 가능성을 보여 준다. View를 효율적으로 계산하는 것과 그 view로 의도한 finding을 학습하는 것은 또 다른 문제다. Classifier가 판독 관행의 상관관계를 배우고 있을 가능성은 여전히 남는다.
3. Report의 영향, validation, distillation
Report-site effect와 관측 모델
Report에서 만든 target에는 영상 소견뿐 아니라 판독 관행도 반영됐다. Cartilage loss, fluid, synovitis를 어느 정도부터 적는지는 기관마다 달랐을 수 있다. 한편 acquisition 차이 때문에 MRI만 보고도 촬영 기관을 알아낼 수 있었다. 따라서 finding을 더 정확히 읽지 못해도, 어느 기관의 영상인지 구분하는 것만으로 training reference를 더 잘 예측할 수 있다. Patient group을 나누면 같은 환자를 외우는 문제는 줄지만, 같은 기관의 다른 환자에게도 통하는 reporting shortcut은 남는다.
38위 solution의 report-positive 비율은 language에 따라 lateral OA 4.6–30.3%, PF OA 10.0–43.7%, synovitis 0.5–13.7%였다. Language별 image model의 평균 예측과 report-positive 비율 사이의 correlation은 lateral OA 0.99, medial OA 0.96이었다. 33위 분석에서는 acquisition metadata만으로 report language를 98% accuracy로 예측했다. Majority-class baseline은 39%였다. 실제 prevalence가 달랐을 가능성은 남아 있다. 다만 이 결과는 image model이 판독 관행의 proxy를 학습할 수 있었다는 점을 보여 준다.1526
그 과정을 단순화해 보자. $Y$는 expert가 정의한 finding, $R$는 report에 그 finding이 기록되었는지, $X$는 MRI, $S$는 site라고 하자. 다음과 같이 정의한다.
\[a_s=\Pr(R=1\mid Y=0,S=s),\qquad b_s=\Pr(R=1\mid Y=1,S=s).\]$R\perp X\mid(Y,S)$를 가정하고 $\eta(x,s)=\Pr(Y=1\mid X=x,S=s)$로 쓰면,
\[\mathbb E[R\mid X=x,S=s] =a_s+(b_s-a_s)\eta(x,s).\]$b_s>a_s$이면 한 site 안에서는 report probability가 disease probability의 순서를 보존한다. 하지만 site마다 offset과 sensitivity가 다르면 서로 다른 site의 사례 순서는 뒤집힐 수 있다. 두 사례의 disease probability를 0.70과 0.40으로 가정하자. Reporting parameter가 각각 $(a,b)=(0.05,0.55)$와 $(0.20,0.95)$이면 report probability는 0.40과 0.50이다. 각 site 안에서는 report가 질병 정보를 담고 있어도, site를 가로질러 비교하면 임상적 순서와 반대가 된다.
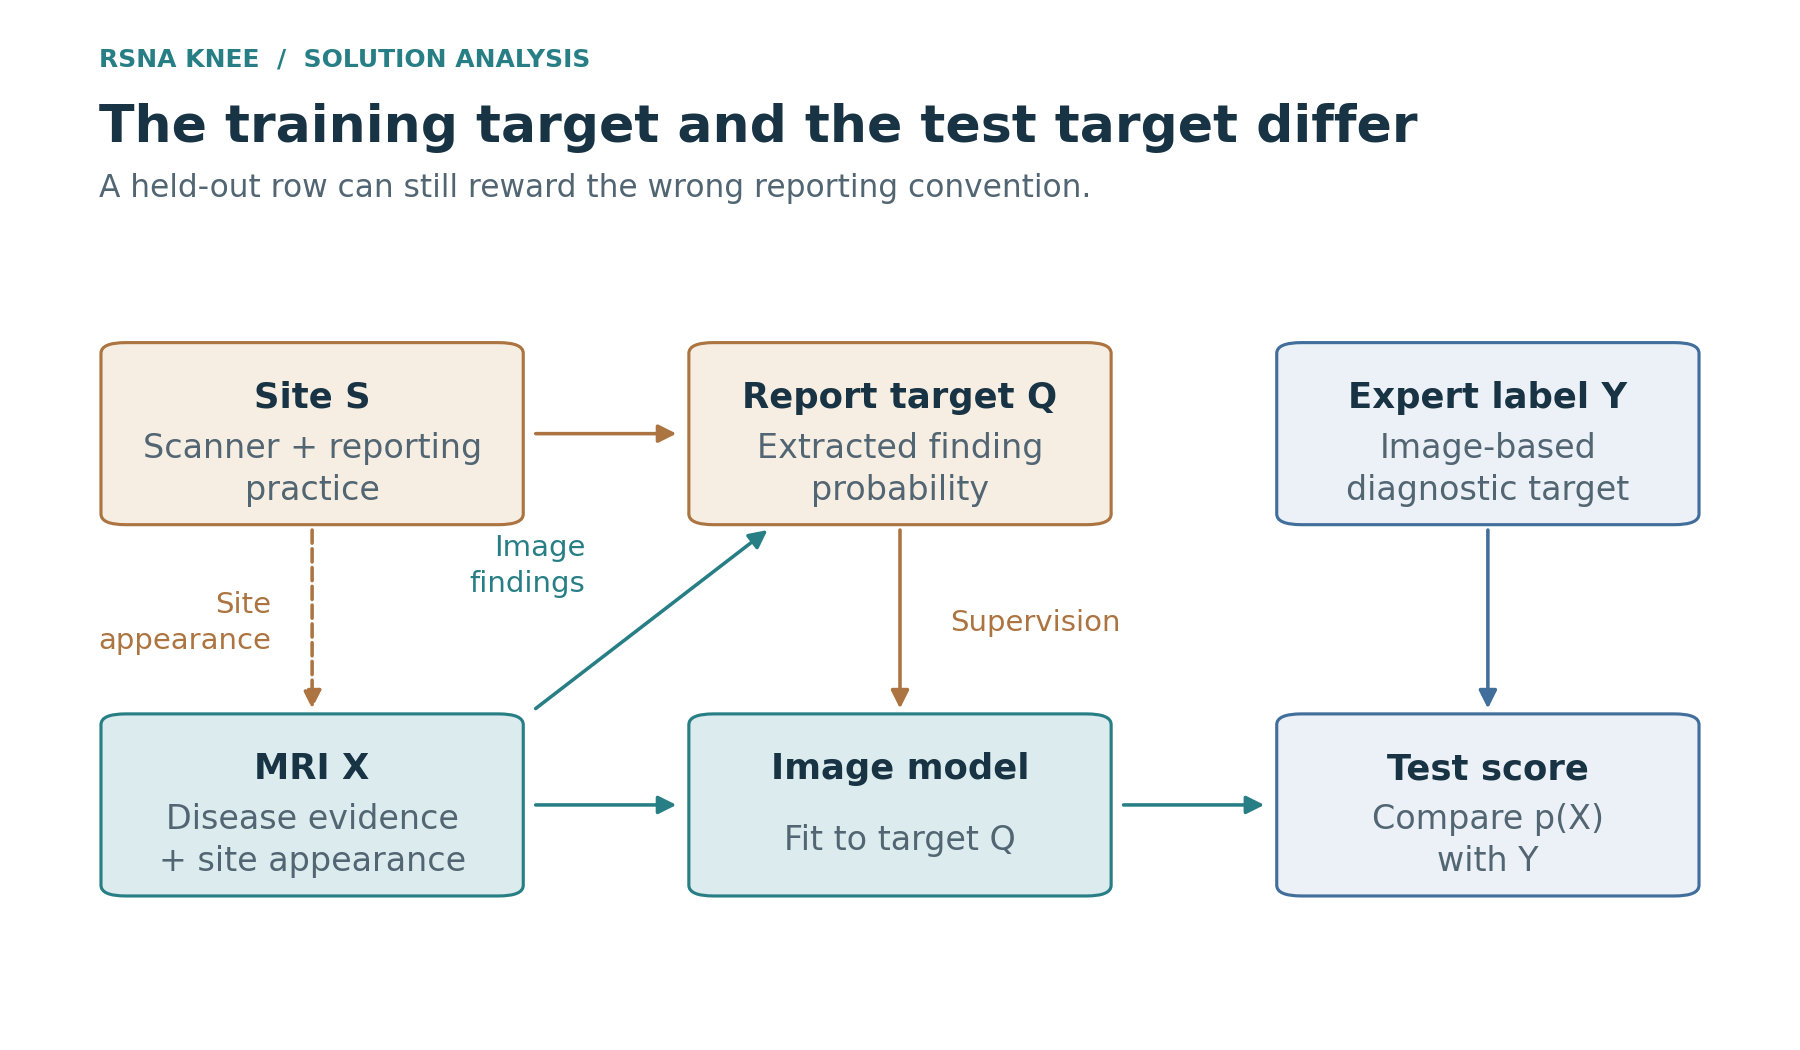
Figure 4. Report target에는 영상의 임상적 근거와 site별 report 관행이 함께 반영된다. Site는 acquisition의 외형과 실제 환자 구성에도 영향을 준다. Fold를 나누는 것만으로 이 작용들을 분리할 수는 없다.
실제 target은 binary $R$가 아니라 report에서 추출한 soft probability였다. 그래도 질병의 근거와 판독 관행이 섞여 있다는 문제는 같다. Weight가 없는 expected BCE를 population 수준에서 최소화하고 model class에 제약이 없다고 가정하면, 최적 예측은 $\mathbb E[Q\mid X=x]$다. 여기서 $Q$는 만든 target이다. Fold를 어떻게 나누어도 loss가 학습시키는 conditional expectation 자체는 바뀌지 않는다.
33위, 38위, 72위가 training에만 사용한 site term은 loss에서 reporting component를 따로 표현할 수 있게 했다.
\[\mathcal L=\sum_{i,c}w_{i,c}\, \ell_{\mathrm{BCE}}\!\left(q_{i,c}, \sigma\!\left(f_c(x_i)+u_{s_i,c}+g_c(m_i)\right)\right).\]$u$는 site table, $m_i$는 acquisition metadata, $g$는 선택적으로 넣는 metadata branch다. Inference에는 image logit $f_c(x)$만 남겼다. 이 식은 공통 설계를 모아 쓴 것으로, 72위는 site table을 사용했지만 33위의 acquisition MLP는 쓰지 않았다. 의도는 판독 관행을 training-only branch가 따로 표현하게 해, 최종 image path가 그 정보를 모두 학습할 필요를 줄이는 것이다. 그렇다고 $f$가 site-invariant해지는 것은 아니다. Image network가 여전히 site를 알아볼 수 있고, site 간 차이를 전부 제거하면 실제 case mix에 관한 정보까지 잃을 수 있다.
Report 관행과 질병 근거를 구분한 개입
판독 관행의 영향은 지역별 비율 차이보다 개입 실험에서 더 분명하게 드러났다. 33위 작성자는 같은 checkpoint에서 acquisition-dependent component를 inference 때만 끄면 Public/Private이 0.947/0.929에서 0.959/0.944로 개선되는 것을 먼저 확인했다. 같은 checkpoint를 비교했으므로 training seed 차이는 없다. Acquisition component가 expert test label에서는 도움이 되지 않는 특성까지 학습하고 있었을 가능성을 보여 준 결과다.26
그 뒤의 controlled training progression은 별개의 비교다.
| OrthoFoundation-L recipe | Public | Private |
|---|---|---|
| Acquisition input과 trap 없이 학습 | 0.949 | 0.932 |
| Site term 추가 | 0.955 | 0.940 |
| Acquisition branch와 empirical-Bayes 초기화 | 0.960 | 0.946 |
| 언급되지 않은 finding에 teacher-spread target 적용 | 0.962 | 0.947 |
Site term은 random effect로 regularization했고, acquisition MLP의 output은 0으로 초기화했다. 마지막 행에서는 target도 바뀌므로, 전체 progression에는 site 모델링과 target 재구성이 함께 들어 있다. 작성자는 같은 recipe를 CoAtNet backbone에도 적용해 0.961/0.948을 보고했다.
38위는 바꾼 component를 되돌려 넣는 비교로 방향을 확인했다. Main label, recipe, seed를 유지하면서 language별 training offset을 넣자 0.949/0.935에서 0.953/0.938로 좋아졌다. 반대로 metadata로 예측한 site의 learned offset을 test에 다시 더하면 같은 checkpoint가 0.950/0.936으로 내려갔다. 이후 site key를 29개로 세분화한 결과는 0.955/0.941이었다. 처음 offset을 넣은 효과, test에서 복원한 효과, site 구분을 세분화한 효과는 별개다. 세 이득을 합산할 수는 없지만, 개입 방향을 되돌렸을 때 결과도 나빠졌다는 점은 중요한 근거다.15
72위는 두 해상도에서 같은 개입을 반복했다.
| Student 입력 | Site bias 없음, Public/Private | Site bias 있음, Public/Private |
|---|---|---|
| 288 pixels | 0.947 / 0.932 | 0.953 / 0.939 |
| 384 pixels | 0.948 / 0.933 | 0.954 / 0.940 |
Private 차이는 두 경우 모두 +0.007이었다. 그 뒤 label teacher도 site bias를 넣어 다시 학습했을 때는 0.955/0.942였다. 이 결과는 target 생성 과정까지 바꾼 후속 개입이며, 처음의 site-only ablation 점수와 구분해야 한다.18
다른 팀들은 training logit 대신 target이나 final prediction을 바꿨다. 63위는 site cluster별 target rank를 전체 target distribution 쪽으로 일부 이동시켰다. 이 단계에서 three-model bundle은 0.955/0.942에서 0.957/0.947로 개선됐다. 하지만 완전히 mapping하면 partial mapping보다 나빴다. Mapping strength 1.0에서 gold AUC는 0.9371에서 0.9268로 떨어졌다. 이 recipe에서는 site 간 distribution 차이를 전부 없애는 것이 최선은 아니었다.24
228위는 metadata만으로 report를 예측하는 모델을 학습하고, 그 rank의 작은 일부를 public blend에서 뺐다. 먼저 prior를 더했을 때 Public이 나빠지는지 확인해 방향을 점검했다. 초기 debiasing은 Private을 0.942에서 0.945로 높였고, 이후 Public이 가장 좋았던 refinement는 0.944였다. 246위는 OA compartment 사이의 과도한 coupling을 줄였다. 이 correction은 report-reference OOF의 reader–member 조합 아홉 개 모두에서 손해였지만, 외부 expert panel은 반대 방향을 지지했다.2728
Label distribution 보정, training-only nuisance branch, final rank subtraction은 pipeline의 서로 다른 지점에 개입한다. 이 결과들은 local과 Public이 어긋났을 때 무엇을 확인해야 하는지 보여 준다. Learner가 실제 finding을 더 잘 읽은 것인지, 아니면 report 작성 방식을 더 잘 맞힌 것인지 구분해야 한다.
Pooled AUC, within-site AUC, 평가 기준의 차이
고정된 binary reference $Z$에 대해 pooled AUC는 site 사이의 비교로 분해할 수 있다.
\[\operatorname{AUC}_{\mathrm{pooled}} =\sum_{s,t}\pi_s^+\pi_t^-A_{s,t},\]여기서 $\pi_s^+=\Pr(S=s\mid Z=1)$, $\pi_t^-=\Pr(S=t\mid Z=0)$이고, $A_{s,t}$는 site $s$의 reference-positive 사례와 site $t$의 reference-negative 사례를 비교한 점수다. Tie에는 절반의 점수를 준다. $Z$가 report-derived reference라면 positive·negative 구분도 report를 따른다. 아직 알지 못하는 expert annotation에 따른 집단이 아니다.
Pooled AUC에는 site 안의 순서와 site 사이의 offset이 모두 반영된다. Mean within-site AUC는 $s\ne t$인 비교를 제외하고, 정한 방식에 따라 site별 결과를 합친다. 그러므로 두 metric은 다른 질문에 답한다. 실제 prevalence가 높은 집단을 잘 구분하던 모델도 within-site 평가에서는 불리해질 수 있다. 반대로 report 관행에 기대던 모델이라면, 점수 하락이 없애려던 shortcut이 줄어든 결과일 수도 있다. 점수 하나만으로 두 설명을 구분할 수는 없다.
72위의 실험에서 site bias를 추가하면 pooled report-reference OOF는 0.912 → 0.906으로 떨어졌지만, mean within-site OOF는 0.906 → 0.907로 거의 같았다. Public은 0.006 좋아졌고, 종료 후 공개된 Private도 0.007 좋아졌다. 작성자가 나중에 single model 26개를 대상으로 구한 Private과의 Spearman correlation은 pooled report OOF −0.83, within-site OOF +0.56, gold-58 +0.78, Public +0.94였다.18
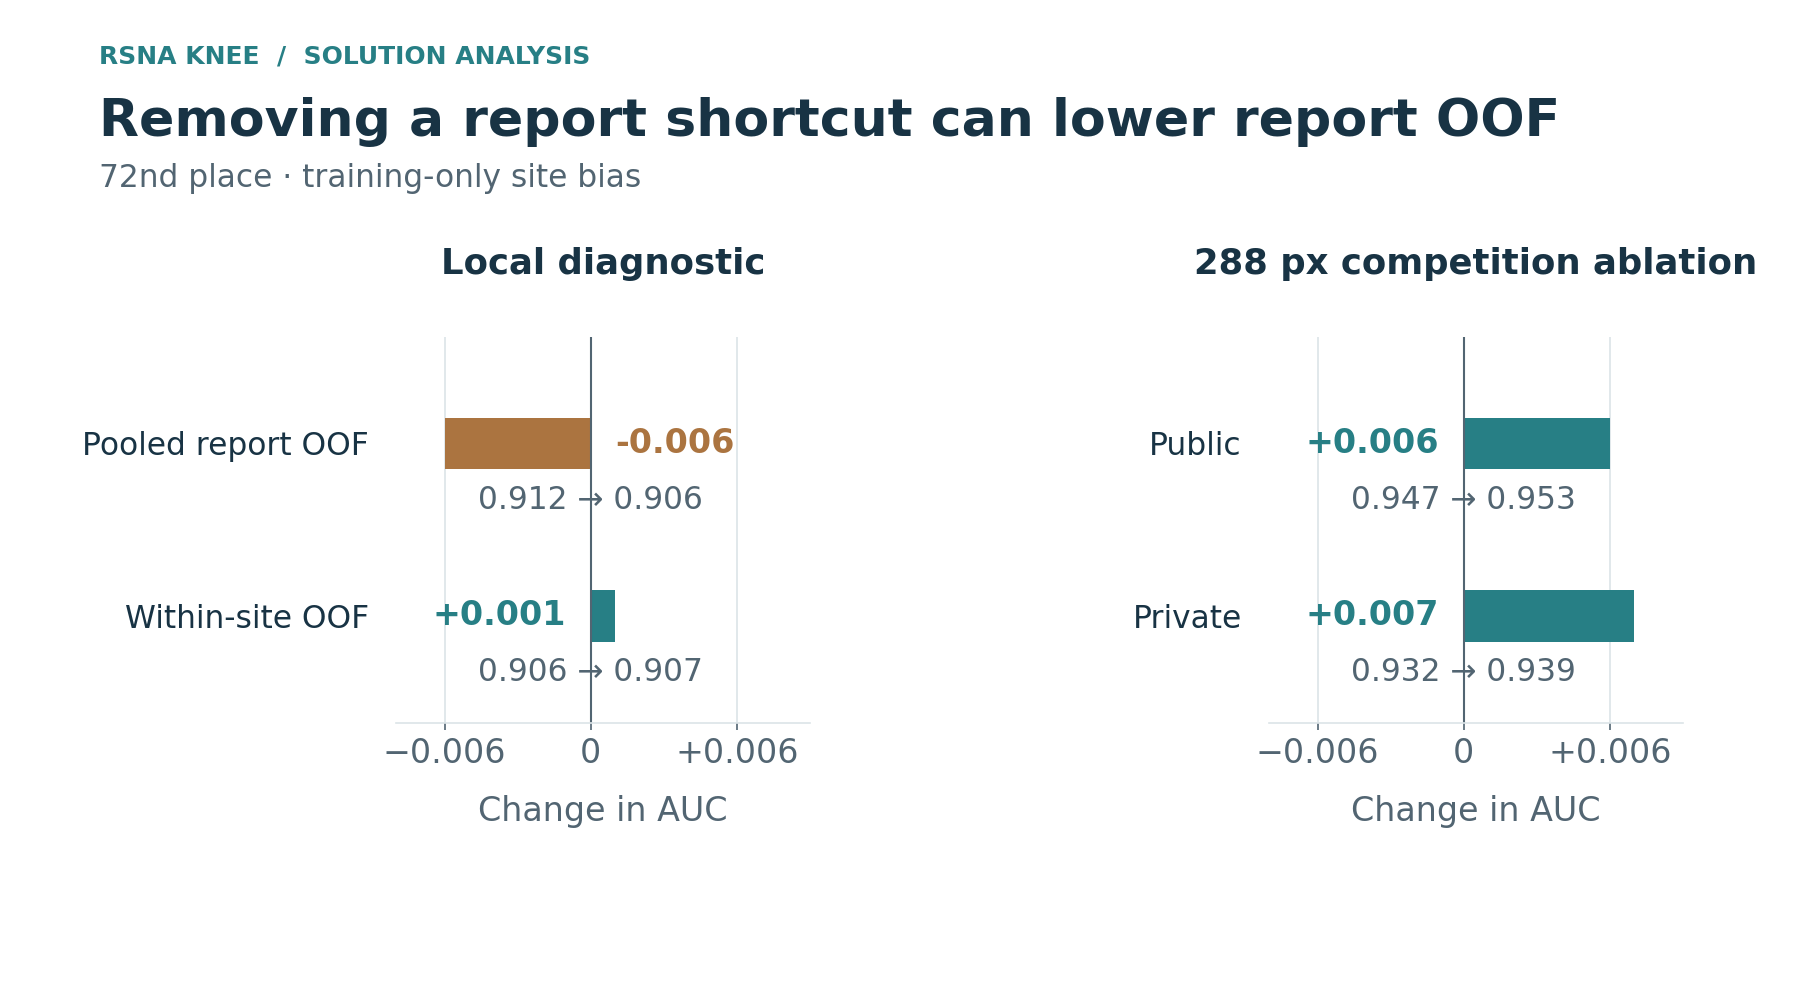
Figure 5. 72위의 report-reference 진단과 정확한 288-pixel site-only competition 비교. Pooled/within-site local reference는 competition의 expert annotation과 다르다. Private은 마감 후 공개되었다.
후속 pseudo-label 결과는 within-site 평가의 한계도 드러냈다. 작성자의 within-site 최고 모델은 OOF가 부풀려진 계보를 사용했고, Private은 0.942로 final model보다 낮았다. Within-site로 채점하더라도 label ancestry가 맞는 비교여야 했다. 점수 집계 방식을 바꾼다고 prediction에 들어간 leakage까지 없어지지는 않는다.
22위는 study 4,342개의 five-fold prediction을 고정된 Astra image-reading reference로 평가했다. Training label을 바꾸어도 평가 reference는 유지했다. 실험 전에 acceptance rule을 정하고, 다른 supervision으로 학습한 member를 넣을 때마다 local과 Public delta를 함께 기록했다. Main label을 교체한 비교 하나에서는 local +0.0031, Public +0.003이었다.7 두 결과가 같은 방향이었다는 점은 이 비교를 뒷받침하지만, VLM reference를 독립적인 임상 정답으로 바꾸어 주지는 않는다.
1위가 후반에 사용한 development system도 image-assisted reference를 고정했지만 metric은 달랐다. Sakaku는 열 개의 candidate fold 중 과거 LB와의 일치도가 높은 435-study fold 하나를 held-out으로 선택했다. 나머지 report study 3,914개와 expert case 58개로 학습했다. Probability로 weight를 준 SoftAUC는 다음과 같다.
\[\operatorname{SoftAUC}(p,q)= \frac{\sum_{i\ne j}q_i(1-q_j) \left[\mathbf1(p_i>p_j)+\tfrac12\mathbf1(p_i=p_j)\right]} {\sum_{i\ne j}q_i(1-q_j)}.\]불확실한 reference probability를 threshold로 이진화하지 않고 그대로 반영하는 방식이다. 따라서 값의 척도도 hard-label AUC와 다르다. 과거 leaderboard 결과를 보고 고른 단일 development fold였으며, ten-fold 평균 CV도 독립적인 test도 아니었다. Tascj도 candidate reference score와 과거 Public 결과를 비교했다고 설명했다.814 Reference를 고정하면 변경을 일관되게 비교할 수 있다. 다만 그 reference를 고르는 데 쓴 피드백은 이후 점수의 해석에도 남는다.
Gold-58의 불확실성과 반복 사용 이력
Expert study 58건은 target 정의를 직접 확인할 수 있는 자료였다. 그러나 성능이 비슷한 모델을 모두 순서대로 세우기에는 독립적인 사례가 부족했다. 각 finding의 positive는 보고에 따라 9–35개였다. Positive가 아홉 개뿐인 target에서는 그중 한 사례가 수많은 positive–negative pair에 관여한다. 애매한 사례 하나로 모델의 선호 순서가 바뀔 수 있고, macro 평균을 낸다고 독립적인 환자 수가 늘지는 않는다.
49위는 paired gold macro의 변동을 약 0.0125, fold 실험의 seed 변동을 약 0.0026으로 추정했다. 74위가 보고한 gold bootstrap SD는 약 0.016이었다. 서로 다른 통계량이며 실험 조건도 다르므로 하나의 상수처럼 바꾸어 사용할 수 없다. Paired resampling은 두 모델이 공통으로 어려워하는 사례를 유지하므로, 독립적인 confidence interval 두 개를 나란히 보는 것보다 유용할 때가 많다. 그래도 좁은 paired interval은 여전히 선택한 사례와 reference를 조건으로 한 결과다.1611
2위의 tune/check split은 구체적인 실패를 드러냈다. Finding 하나씩 추가로 blind reading했을 때 24개의 tuning case에서는 0.066 좋아졌지만, 34개의 checking case에서는 0.019 나빠졌다. 작성자는 이후 PF OA floor를 비롯한 규칙에는 58개 전체를 사용했다고도 명시했다. 초기에 유용한 split이 있었다고 해서, 같은 사례로 나중에 계산한 모든 score가 held-out인 것은 아니다.3
1위의 reading guide 비교에서도 다른 구분이 필요하다. 같은 58개로 guide를 맞추고 적용하면 0.943 AUC, out-of-fold로 적용하면 0.936이었다. 이 fold exclusion은 expert answer로 guide를 맞추는 단계의 노출을 다룬다. 그 전에 같은 사례를 참고해 prompt, rubric, image selection, annotation 방식을 바꾸었던 피드백까지 없애지는 않는다. Sakaku의 새 설명은 이 경계를 분명히 했다. Production annotation에 answer key를 직접 주입하지는 않았지만, 그보다 앞선 development에서는 gold feedback을 사용했다.148
74위는 초기 model selection이 잘 맞지 않은 뒤 gold의 용도를 바꾸었다. Gold로 epoch와 weight를 고르면 gold는 약 0.003 좋아졌지만 LB는 0.001 나빠졌다. 이후에는 paired check, leave-one-out sensitivity, random half-split을 주로 큰 퇴보를 걸러 내는 데 썼고, member 선택에는 외부 panel을 함께 사용했다. 최종 선택한 두 candidate는 gold의 선호 순서가 뒤집혔다. 하나는 gold 0.947 / Private 0.948, 다른 하나는 gold 0.942 / Private 0.949였다.11
Gold는 라벨 해석이 크게 다른 경우를 구분하고, 확신에 찬 오답을 찾고, extractor가 의도한 임상 질문에 답하는지 확인하는 데 유용했다. 하지만 개발 과정에서 여러 번 사용한 뒤에는 천분의 일 차이로 blend를 고를 근거로 삼기 어려웠다. 문제는 전문가 annotation의 가치가 아니라 panel에 어떤 역할을 맡기느냐에 있었다.
외부 expert set도 조건부 근거였다. 246위는 OAI knee 2,399개와 OAI를 학습하지 않은 모델 세 개로 OA decorrelation을 평가했다. 반대 방향의 control과 사전에 정한 규칙도 사용했다. 방향은 재현되었지만, raw OAI는 transfer를 과대평가했다. OAI의 compartment 사이 coupling이 competition expert case보다 훨씬 약했기 때문이다. Coupling에 맞춰 reweighting하면 예상 효과의 크기가 크게 달라졌다. 21위도 OAI MOAKS, WORMS, KneeMRI 평가를 따로 다루었고, competition의 열두 label을 그대로 한 번 더 얻은 것처럼 취급하지 않았다.286
Training에서 제외했다는 것과 selection에 영향을 주지 않았다는 것은 별개다. 외부 panel이 training과 독립적이려면 모델과 그 ancestor가 모두 해당 panel을 학습하지 않았어야 한다. 선택 과정에는 그 panel의 피드백으로 다음 선택을 바꾸는 순간부터 영향을 준다. Local score를 같은 양의 추정치처럼 합치기보다 출처와 사용 이력을 구분해야 각각의 진단 가치를 살릴 수 있다.
모델 간 비교의 불확실성
보고된 noise estimate마다 무엇을 반복했는지가 다르다. Patient bootstrap은 prediction을 고정한 채 평가 사례가 바뀌면 어떻게 되는지를 묻는다. 새 training seed는 평가 사례를 고정한 채 optimization과 sampling이 바뀌면 어떻게 되는지를 묻는다. 독립적인 label reader는 target을 만드는 과정을 바꾼다. 셋 중 하나로 나머지 둘을 대신할 수 없다.
$D$를 candidate와 control의 score 차이, $U$를 training randomness, $B$를 정한 protocol에 따른 evaluation-case sampling이라고 하자. Total variance의 법칙은 다음과 같다.
\[\operatorname{Var}(D) =\mathbb E_U\!\left[\operatorname{Var}(D\mid U)\right] +\operatorname{Var}_U\!\left(\mathbb E[D\mid U]\right).\]학습이 끝난 candidate와 control 하나씩으로 하는 bootstrap은 두 fitted model을 고정한 상태에서 첫 번째 항을 다룬다. Training draw가 달라졌을 때 두 모델의 차이가 얼마나 바뀌는지는 추정하지 않는다. 반대로 같은 expert panel에서 seed를 두 번 바꿔도 새 panel로 transfer하는지는 확인되지 않는다. 이 식은 빠진 불확실성을 구분해 준다. 서로 다른 solution이 보고한 표준편차를 제곱해 더해도 된다는 근거는 아니다.
Resampling 단위도 중요하다. AUC는 positive–negative pair를 평균하지만, 한 환자가 여러 비교에 등장하므로 pair term은 독립적이지 않다. Positive가 아홉 개라면 의심스러운 positive study 하나가 모든 negative와의 비교에 영향을 준다. Pair 수를 독립적인 임상 관측 수처럼 취급하면 정밀도가 실제보다 훨씬 높아 보인다. 21위의 continuation 비교는 patient/report group 단위로 resampling해, split에서 지키려 했던 의존 관계를 유지했다. Finding별 분석에서도 필요한 grouping을 보존해야 하며, resample에서 한 class가 사라져 AUC를 정의할 수 없을 때 어떻게 처리했는지 밝혀야 한다.
Paired design은 피할 수 있는 변동을 일부 줄인다. Candidate와 control에 같은 fold, update budget, inference coverage를 쓰면, 서로 무관한 best run 두 개의 차이보다 해석하기 쉽다. 그렇다고 모든 불확실성이 사라지지는 않는다. Label을 바꾸면 optimization trajectory도 바뀌고, 사례별로 이득의 방향이 다를 수 있다. 다른 fold나 seed에서 반복하면 관측한 mechanism이 그 변화에도 유지되는지 확인할 수 있다. 이 반복을 새로운 expert label을 얻은 것처럼 해석할 필요는 없다.
77위가 보고한 약 0.0025의 seed 변동과 0.002 안팎의 판단 기준은 해당 실험에서 정한 운영상의 선택이었다. 22위는 약 0.003의 seed variability를 보고했고, compartment model의 lateral OA에서는 변동이 훨씬 컸다. 각 숫자 뒤의 모델과 target이 다르다. 더 높은 순위의 팀이 썼다는 이유로 cutoff를 가져와 이 competition AUC의 고유한 성질처럼 취급해서는 안 됐다.127
Variance estimate로 고칠 수 없는 bias도 있다. Candidate와 evaluator가 같은 report 관행을 재현한다면, 매우 좁은 confidence interval로도 잘못된 개선을 정밀하게 확인할 수 있다. Variant를 서른 개 살펴본 뒤 가장 좋은 interval만 제시했다면, 그 interval은 선택된 비교를 조건으로 한다. Expert panel을 참고해 annotation protocol을 작성했다면, 나중에 panel을 나누어도 그 사용 이력은 되돌릴 수 없다. 설득력 있어 보이는 local 결과가 transfer하지 않는 이유는 이렇게 서로 다를 수 있다.
따라서 불확실성도 해당 비교에 맞게 평가해야 한다. Effect가 작아도 mechanism과 배포 비용을 고려하면 유용할 수 있다. 반대로 local effect가 커도 reference shortcut이나 잘못된 decoder에서 나온 개선이라면 신뢰하기 어렵다. Effect, 관련 반복 실험, 아직 설명되지 않은 불일치를 함께 제시해야 한다. 이를 고정된 minimum detectable difference 하나로 요약할 수는 없다.
Distillation target과 전체 학습·평가 경계
Teacher prediction은 영상 근거를 더하거나 불확실한 target을 부드럽게 만들 수 있다. 학습 라벨의 오류를 되풀이할 수도 있다. “OOF teacher”나 “self-distillation”이라는 이름만으로는 어느 경우인지 알 수 없다. 평가에서 무엇을 제외할지는 최종 estimator가 만들어지는 과정 전체를 보고 정해야 한다.
21위의 구성에서는 teacher의 training target 생성과 student의 held-out 평가를 구분해야 한다. Outer fold $k$의 training partition을 $T_k$, validation partition을 $V_k$라고 하자. Teacher는 $T_k$로 학습한 뒤 그 학습 row들을 다시 예측했다. Student target은 다음과 같다.
\[q_i^{(k)}=0.75q_i+0.25t_k(x_i),\qquad i\in T_k.\]Student도 $T_k$ 안에서만 학습했고, 두 모델 모두 $V_k$를 학습에서 제외했다. 따라서 outer training 안의 teacher target은 in-sample이며 inner OOF는 아니다. 그렇다고 student의 outer-held-out 비교가 무효가 되지는 않는다. Teacher는 dense inference와 center crop으로 안정적인 확률을 만들고, student는 window sampling과 augmentation을 적용하며 학습했다. 이 질문에 답하는 데 inner OOF teacher가 반드시 필요했던 것은 아니다.6
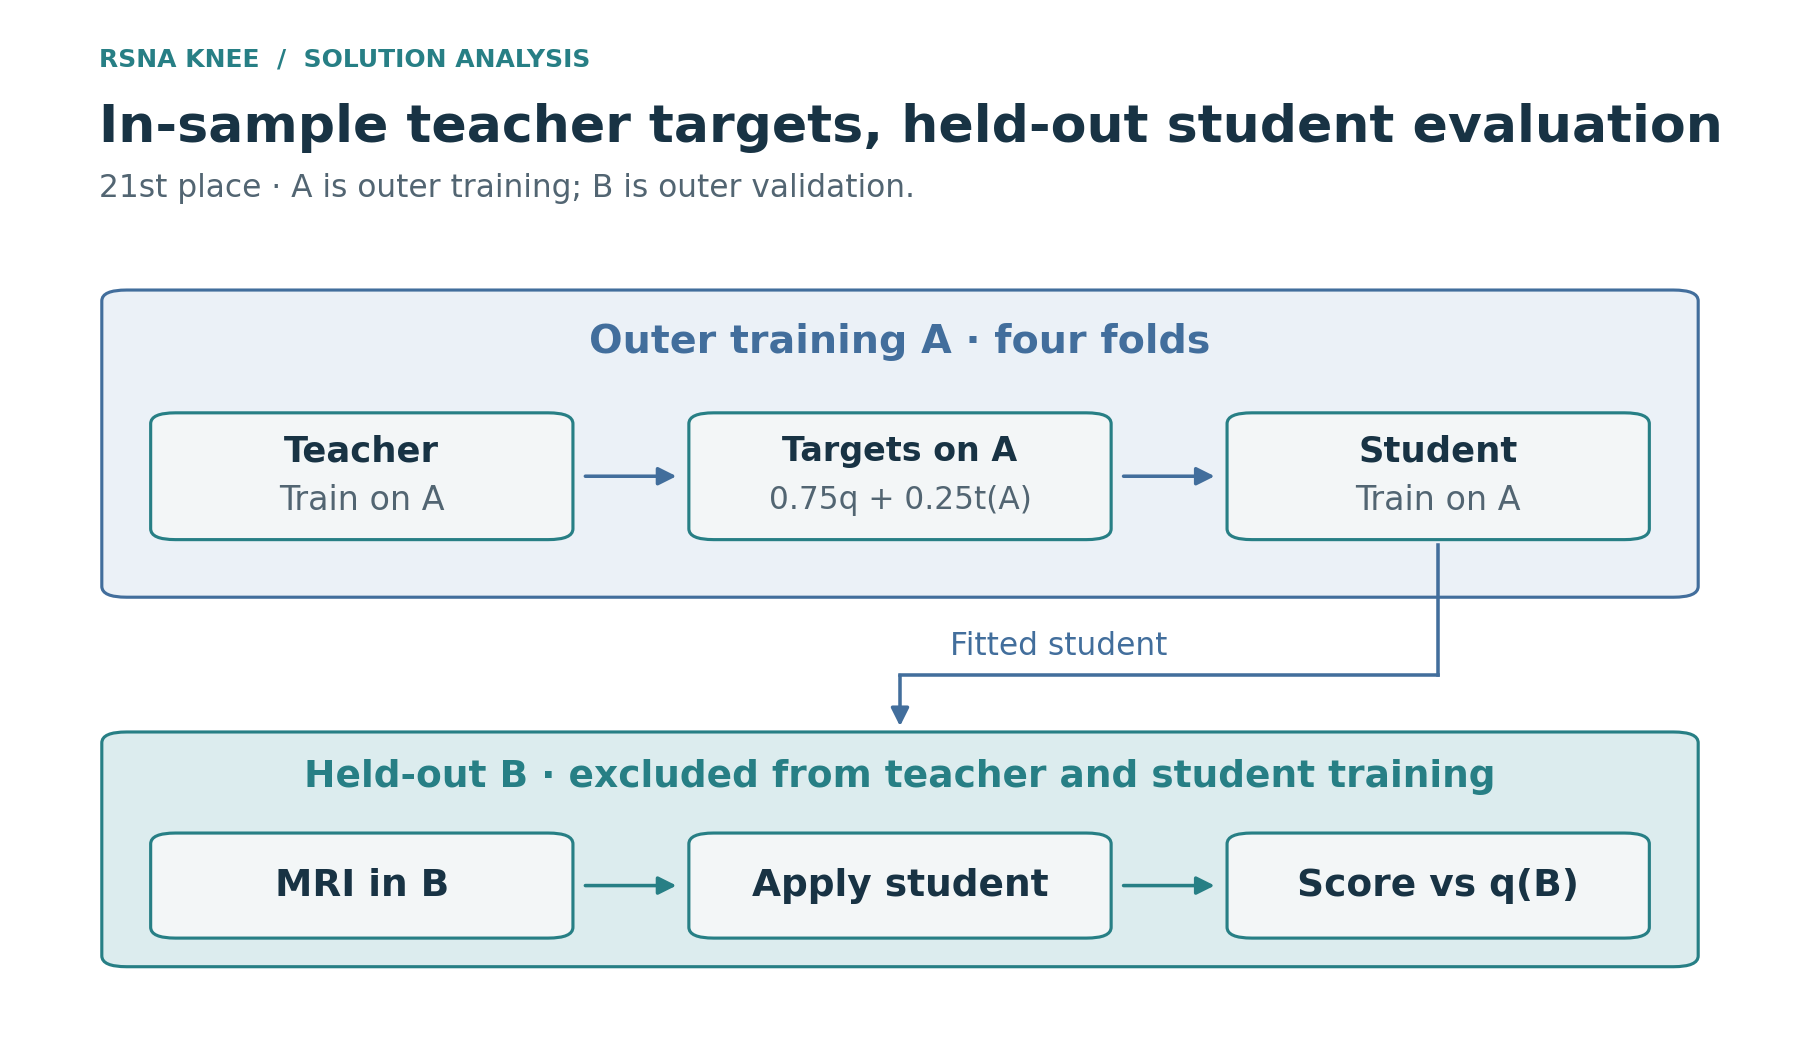
Figure 6. 21위의 teacher는 자신이 학습한 outer-training row를 예측한다. Teacher와 student 모두 outer validation fold를 제외하고, 평가는 원래 LLM reference를 사용한다. 그 이전의 annotation과 선택 과정에서 어떤 사례를 봤는지는 별도로 구분해야 한다.
저자는 같은 checkpoint에서 두 epoch를 더 학습하되, 한 arm은 LLM target을 유지하고 다른 arm은 distillation target을 쓰도록 조건을 맞췄다. Distillation의 추가 OOF 이득은 보고값 0.000477, patient/report-group bootstrap interval은 [0.000112, 0.000900]이었다. 보고된 delta를 그대로 인용했다. 표시된 두 점수의 차는 0.000478로 마지막 자리가 다르다. Gold 변화는 작았다. 반면 처음부터 다시 학습한 student는 LLM-reference OOF 0.958492 / gold 0.940240 / Public 0.963이었고, LLM-only continuation은 0.960760 / 0.943083 / 0.962였다. Local에서 더 좋았던 continuation이 Public에서도 더 좋은 모델은 아니었다.
평가가 오염되는 경우는 다르다. $T_k$의 target을 만드는 teacher가 $V_k$로 학습했거나, calibration·transformation을 validation 정답에 맞췄다면 student가 그 정보를 물려받는다. Student가 원래 validation row를 직접 학습했는지만 확인해서는 부족하다. Global OOF 표에서 각 row 자체를 그 row의 producer가 제외했더라도, 후속 outer 평가가 요구하는 조건은 충족하지 못할 수 있다. 해당 fold 전체가 pipeline의 모든 학습 단계에서 빠져야 한다면 그 조건을 따로 확인해야 한다.
49위는 sealed-fold audit으로 이 차이를 정량화했다. 모든 teacher에서 fold 3을 제외했을 때 라벨 한 라운드의 report validation 이득은 약 +0.004였지만, global teacher를 쓴 구성에서는 약 +0.011이었다. Local 이득이 세 배 가까이 커졌다고 연구 성과도 그만큼 늘어난 것은 아니었다. 478위도 LB가 그대로인 동안 held-out report AUC가 0.923 → 0.931로 올랐다고 보고했다. 후기 teacher가 그 fold를 학습한 영향이 포함돼 있었다.1629
내 teacher 후속 모델에도 같은 구분이 필요하다. Student를 clean fold로 학습해도 target에 들어간 full-data 공개 parent의 정보는 남는다. 그런 모델을 final predictor로 사용할 수는 있지만, local 점수를 전체 pipeline의 clean held-out 추정치로 제시할 수는 없다. 반대로 앞의 outer-training-only teacher는 해당 student 비교에 필요한 제외 조건을 이미 지킨다. 이 질문에 nested teacher OOF까지 요구해도 평가 경계는 달라지지 않고 작업만 늘어난다.
Teacher 반복, calibration, 공유 오류
8위 팀은 class weighting과 ranking loss 때문에 teacher 예측 평균이 0.37–0.46으로 올라간 반면, 라벨 평균은 0.10–0.40에 있다는 것을 확인했다. Scale을 확인하지 않고 두 확률을 평균하면 teacher의 학습 목적함수 때문에 target의 의미까지 바뀔 수 있다. 이 팀은 다른 세 fold에서 소견별 isotonic regression을 fit해 해당 fold의 예측을 보정한 뒤, calibrated OOF를 고정된 원본 $S$와 다시 섞었다.5
\[q^{(t+1)}=0.6S+0.4\widehat p^{(t)}_{\mathrm{OOF,cal}}.\]매번 직전 target을 다시 섞으면 두 번째 라운드에서 원본이 직접 차지하는 계수는 $0.6^2=0.36$이 된다. $S$를 고정하면 그 감소를 피할 수 있다. 다만 teacher를 거쳐 간접적으로 전달되는 오류가 사라지는 것은 아니고, isotonic calibration에도 어떤 자료로 fit하고 평가했는지의 계보가 있다. 고정 anchor는 원본의 직접 비중을 명확히 유지하는 설계이지, target이 틀어지지 않는다는 보증은 아니다.
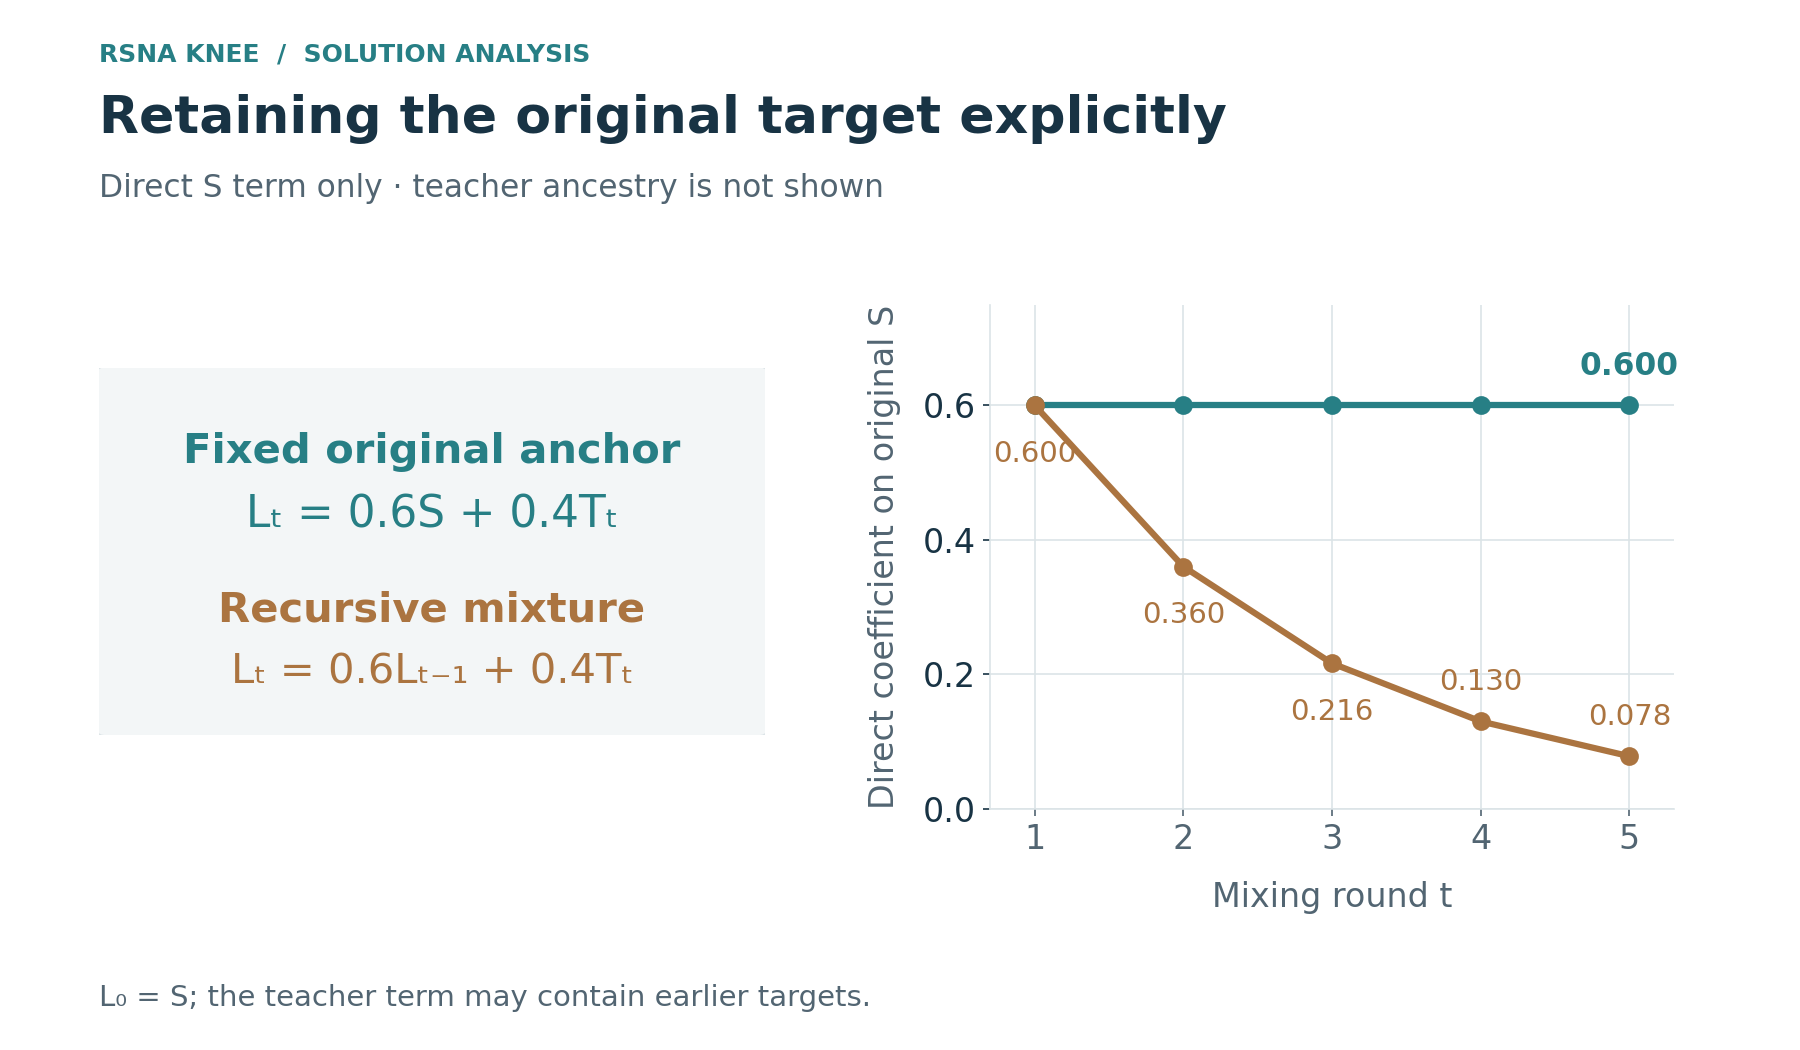
Figure 7. Teacher 바깥에서 원본에 직접 곱하는 계수는 원본을 고정하면 매 라운드 0.6이다. 직전 target을 재귀적으로 섞으면 0.6의 라운드 수 제곱으로 줄어든다. 이 값이 전체 계보에서 원본의 영향력을 나타내는 것은 아니다. Teacher도 원본 정보를 간접적으로 전달할 수 있다.
Teacher 반복의 효과는 recipe마다 달랐다.
| 해법 | 효과가 있었던 변경 | 한계 또는 반례 |
|---|---|---|
| 49위 | Five-fold teacher 라운드가 matched Public 비교에서 개선 | 같은 텍스트 계보의 더 큰 teacher를 쓴 라운드는 제자리 |
| 72위 | Report source마다 teacher를 따로 만들어 Private 0.923 → 0.931 | 텍스트 extractor를 늘리거나 강한 student로 한 라운드 더 돌려도 무이득 |
| 76위 | Gold로 fine-tune한 teacher가 전문가 기준을 다른 study로 전파 | 네 번째 generation과 pseudo-label OAI 영상 추가는 control과 동점 |
| 77위 | OOF를 섞은 라벨이 여러 student backbone에서 개선 | ConvNeXt-T에서는 해당 relabeling의 Public 개선이 없었음 |
| 478위 | 첫 라운드 student ensemble이 Private 0.933 → 0.938 | 이후 라운드, teacher 비중 확대, fastMRI 약 10,000건 추가로 더 오르지 않음 |
76위 recipe는 “새 정보”라는 말을 더 구체적으로 설명해 준다. Teacher head를 먼저 전문가 사례로 fine-tune하고, 그 예측을 report만 있는 study에 퍼뜨렸다. 이렇게 하면 supervision의 정보원이 달라진다. 동시에 gold 세트를 학습에 사용한 것이므로 이후에는 독립 평가자로 쓰기 어려워진다. 보고된 가장 큰 이득은 초기에 나왔으며, teacher 비중을 50%에서 75%로 높여도 더 좋아지지 않았다.30
74위는 target 일부를 같은 이전 모델들이 만들었기 때문에 여러 라운드와 추가 모델이 plateau에 도달했다고 설명했다. 별도로 학습한 OAI reader가 일부 소견의 교정에 도움이 됐지만, medial meniscus와 medial OA를 지나치게 함께 예측해 그 소견에는 사용하지 않았다. 같은 학습량으로 continuation control을 둔 결과, 개선 일부가 단순한 추가 epoch가 아니라 교정된 라벨에서 왔음을 구분할 수 있었다.11
Encoder가 다르면 같은 teacher도 서로 다르게 근사할 수 있다. 하지만 그 차이가 독립적인 진단 근거는 아니다. 위의 plateau 사례들은 다음 round의 두 효과를 구분하게 한다. 기존 신호를 더 잘 학습한 것인지, 실제로 다른 정보를 받아들인 것인지다. 학습량을 맞춘 continuation control과 parent별 오류 비교가 이를 구분하는 데 도움이 된다.
Public 비교, 소견별 probe, 반복 선택
Public과 Private의 전체 순서는 잘 맞았지만, 그 상관으로 작은 후보 차이 하나하나의 신뢰도를 정할 수는 없다. 2위 팀은 후기 제출에서 순위 상관 0.977, 72위 저자는 단일 모델 26개에서 0.94를 보고했다. 약한 시스템부터 강한 시스템까지 넓게 포함한 집합은 상관이 높아도 가까운 두 ensemble의 순서는 뒤집힐 수 있다. 0.003 아래는 정보가 없고 그 위는 믿을 만하다는 보편 경계도 이 결과에서 나오지 않는다.318
제출 operator를 미리 정하면 Public으로 더 좁은 질문을 확인할 수 있다. 다른 열한 column을 모두 0.5로 고정한 single-finding probe는 다음 관계를 따른다.
\[M_{\mathrm{probe}}=\frac{A_c+11/2}{12}, \qquad A_c=12M_{\mathrm{probe}}-5.5.\]8위 팀은 이 항등식을 사용했다. 표시 macro 점수의 한 단계 0.001이 역산한 소견 AUC에서는 0.012의 한 단계가 된다. 49위는 고정된 base prediction에서 column 하나를 반전하는 방식을 썼다. 반전은 동점에 절반을 주는 경우까지 포함해 $A_c$를 $1-A_c$로 바꾸므로 다음이 성립한다.
\[A_c=\tfrac12+6(M_{\mathrm{base}}-M_{\mathrm{inverted}}).\]각 macro 점수를 가장 가까운 0.001로 반올림한다고 가정하면, 상수 column probe는 열두 배를 곱한 뒤의 최대 반올림 오차가 0.006이다. Column 반전으로 구한 추정치의 한계도 0.006이다. 두 반올림 오차의 차이가 최대 0.001이고 여기에 여섯 배를 적용하기 때문이다. 이는 표시 반올림만의 오차 한계이며, 표본이나 학습 변동의 confidence interval은 아니다.
두 식은 macro AUC의 정의에서 나오는 관계이지, test 성능을 원하는 정밀도로 알아내는 방법은 아니다. 표시 반올림의 영향도 증폭되고, 모든 probe가 같은 Public 사례를 사용한다. 약한 소견을 찾거나 미리 정한 specialist를 확인하는 데에는 유용하지만, 소견별 weight를 많이 탐색하는 데 적합한 근거는 아니다.516
2위의 specialist 비교에는 성공과 실패가 모두 있다. PF OA specialist의 소견별 probe는 명시된 비교 모델에 비해 Public 0.920에서 0.944, Private 약 0.908에서 0.932로 올랐다. Lateral specialist도 Public 0.920 → 0.932였지만, 이후 Private은 약 0.944로 core member의 0.956보다 낮았다. 유용한 probe라도 보지 못한 사례에서는 가까운 대안 중 잘못된 쪽을 고를 수 있다.3
228위의 제출 과정은 반복 선택의 비용을 보여 준다. 기전에 근거해 처음 성공한 debiasing 후보는 0.960/0.945였고, 비슷한 변경을 약 25개 시험한 뒤 선택한 후보는 0.961/0.944였다. 기본 교정의 이득은 전이됐지만 Public 최고를 만든 추가 변경은 그렇지 않았다. 63위도 소견별 weight를 튜닝한 결과가 0.958/0.942로, uniform-weight 대안의 0.960/0.948보다 낮았다고 보고했다.2724
Public은 미리 정한 predictor의 transfer, specialist, report correction을 비교하는 데 유용했다. 그렇다고 높은 전체 순위 상관이나 반올림된 점수에 맞춘 반복 탐색으로 비슷한 후보 사이의 모든 선택을 해결할 수는 없다. 성공한 predictor를 기존 parent에 추가할 때는 질문이 하나 더 생긴다. 두 prediction을 결합하면 parent가 아직 틀리는 사례를 바로잡을 수 있는가?
4. Prediction bank와 최종 조합
단독 성능과 추가 정보
유용한 family에는 별개의 두 특성이 있다. 단독으로 얼마나 잘 예측하는지, 다른 predictor의 어떤 오류를 고칠 수 있는지다. 단독 성능이 좋으면 유망한 기반이 되고, 순위 오류를 얼마나 보완하는지가 추가할 가치를 결정한다. Architecture 이름, parameter 수, 완료한 run 수는 이 특성을 간접적으로만 설명한다.
Binary 소견 하나에서 base predictor의 점수를 $b_i$, 후보의 점수를 $u_i$라고 하자. Weight $w$로 두 점수를 단순 혼합하면 positive 사례 $i$와 negative 사례 $j$ 사이의 margin은 다음과 같다.
\[m_{ij}(w)=(1-w)(b_i-b_j)+w(u_i-u_j).\]그에 따른 AUC 변화는
\[\Delta\mathrm{AUC}(w) =\frac{1}{n_+n_-}\sum_{i:Y_i=1}\sum_{j:Y_j=0} \left[H\!\left(m_{ij}(w)\right)-H\!\left(m_{ij}(0)\right)\right],\]이다. 여기서 $H(a)$는 $a>0$일 때 1, $a<0$일 때 0, 동점일 때 0.5다. 후보를 추가해 충분한 수의 pair 순서를 바로잡고, 이미 맞던 pair를 지나치게 뒤집지 않아야 도움이 된다. Base와 상관이 높다고 가치가 0인 것은 아니다. 적은 수의 pair를 고치는 것만으로도 의미가 있을 수 있다. 반대로 상관이 낮다고 유용한 것도 아니다. 달라진 pair 중 상당수가 오답으로 바뀔 수 있다.
따라서 일반적인 diversity 통계는 ensemble의 목적함수보다 진단값으로 쓰는 편이 맞다. 다른 view나 더 나은 target 때문에 예측이 달라질 수도 있지만, calibration이 나쁘거나 단순히 noisy해서 달라질 수도 있다. 적합한 reference에서 pair별 오류를 보면 그 이유를 구분하는 데 도움이 된다. 다만 report label에서 확인한 보완 효과가 expert target에서도 같다는 보장은 없다.
단독 AUC가 같아도 평균한 결과는 정해지지 않는다. 앞의 두 study가 positive, 뒤의 두 study가 negative인 네 사례를 생각해 보자. Base 점수 $(0.9,0.4,0.6,0.1)$의 AUC는 0.75다. 후보 점수 $(0.5,0.9,0.1,0.6)$도 AUC 0.75지만, 두 점수를 반반 평균하면 두 positive가 모두 두 negative보다 높아져 AUC 1.0이 된다. 두 번째 예에서는 $(0.9,0.4,0.8,0.1)$과 $(0.4,0.9,0.8,0.1)$이 각각 다시 0.75를 낸다. 그러나 확률 평균은 공통된 hard negative를 두 positive보다 위에 놓아 AUC가 0.5로 내려간다. Component AUC만으로는 결정적인 margin 구조를 알 수 없다.
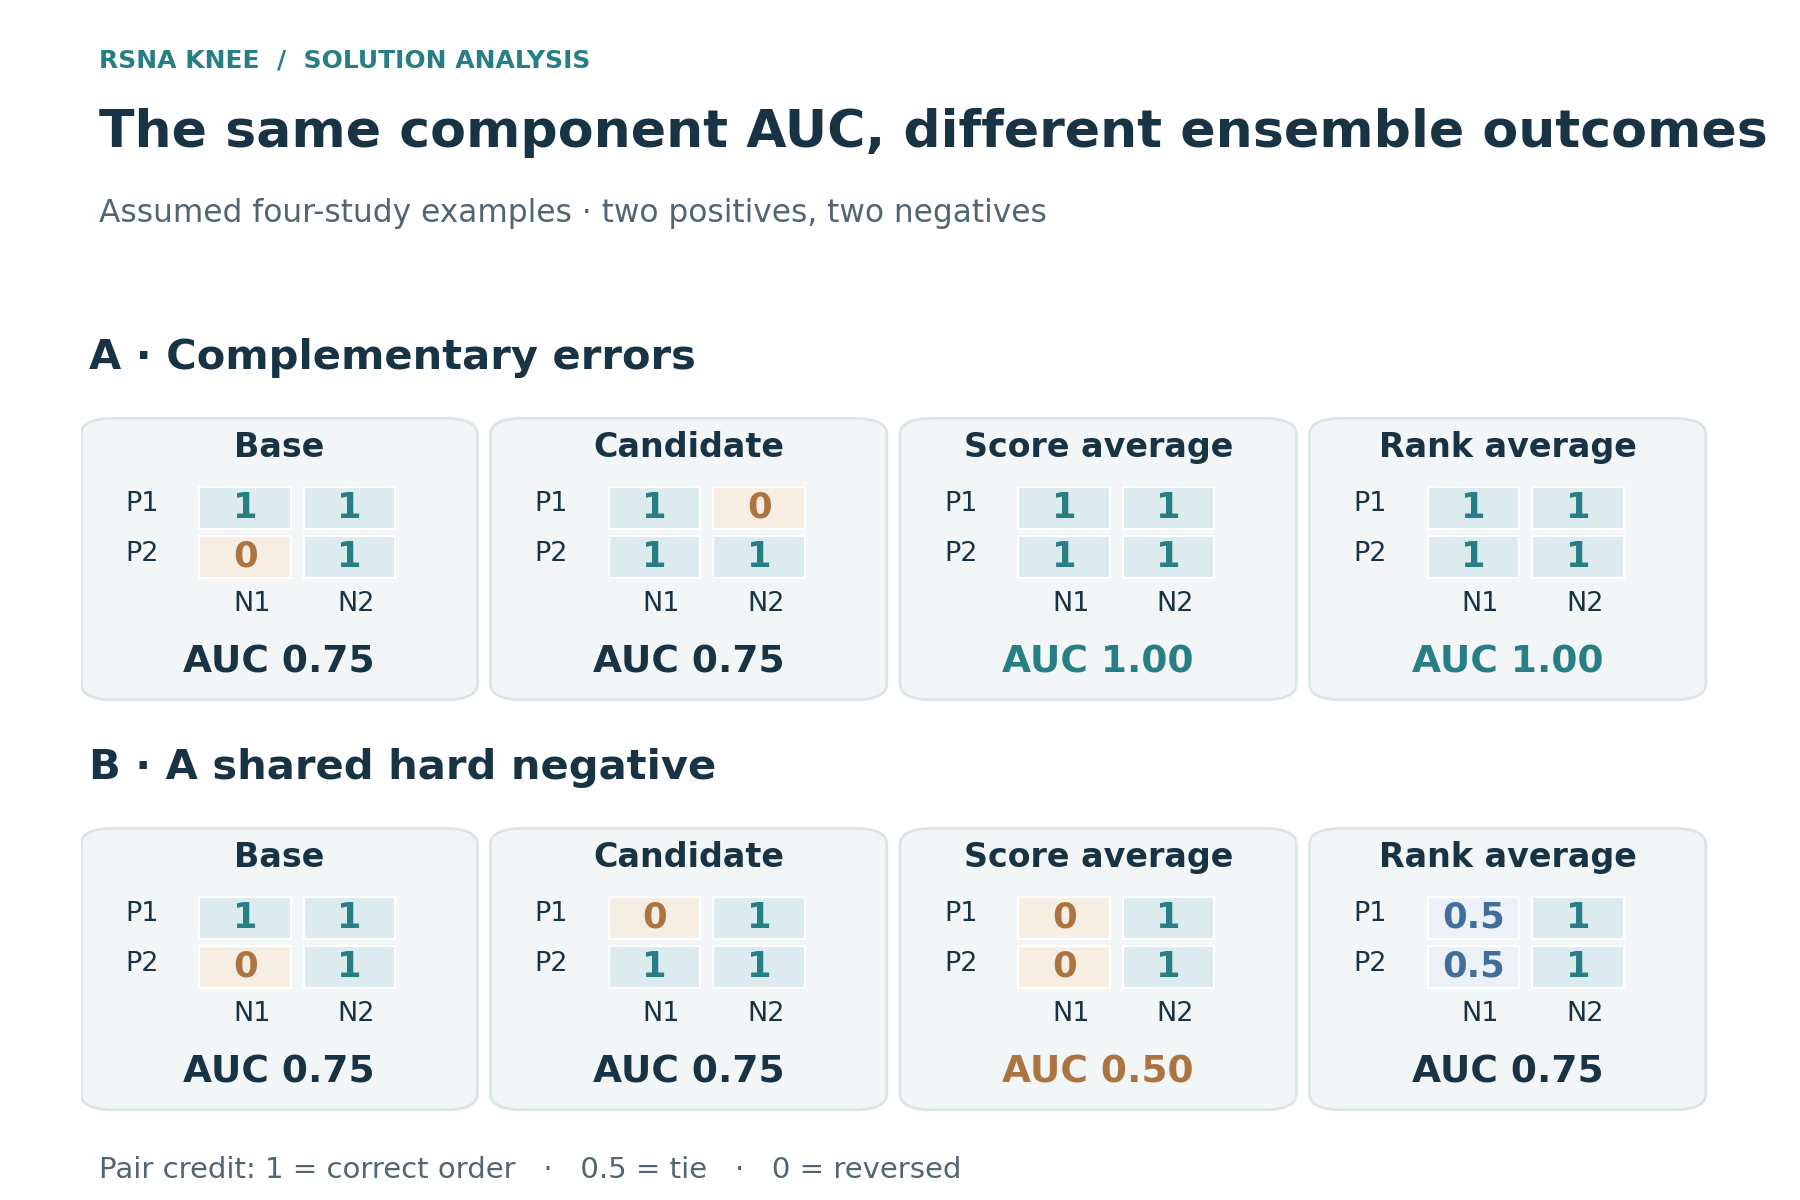
Figure 8. 앞의 두 study가 positive, 뒤의 두 study가 negative인 binary 예다. 두 예 모두 각 component의 AUC는 0.75다. Raw score 평균은 1.0까지 오르거나 0.5로 내려갈 수 있으며, operator를 바꾸면 이 결과도 달라질 수 있다.
내 complete OOF bank가 있었기 때문에 학습 캠페인을 다시 돌리지 않고 margin, fold, target, 대체 조합을 비교할 수 있었다. 하지만 bank의 규모가 충분히 강하거나 서로 보완되는 정보원을 보장하지는 않았다. 같은 teacher의 student를 반복해 만들면 prediction file은 늘어나도 hard-negative 구조는 상당 부분 남을 수 있다.
Probability·logit·rank 혼합
대표적인 세 operator는 서로 다른 양을 평균한다. 모델별 확률이 $p_{m,c}(x)$이고 합이 1인 비음수 weight를 쓰면 probability 평균은
\[p_c^{\mathrm{prob}}(x)=\sum_m w_{m,c}p_{m,c}(x),\]이다. 반면 logit 평균은 다음과 같다.
\[p_c^{\mathrm{logit}}(x) =\sigma\!\left(\sum_m w_{m,c}\operatorname{logit}p_{m,c}(x)\right).\]Logit 평균을 쓰려면 확률이 0보다 크고 1보다 작아야 하며, 끝점이 나올 수 있다면 clipping 규칙을 명시해야 한다. 수치적 clipping은 그 operator의 일부이지 새로운 calibration 결과가 아니다.
Rank 혼합은 먼저 각 점수를 평가 batch $B$ 안의 위치로 바꾼다.
\[\rho_B(p_i)=\frac{\operatorname{rank}_{B,\mathrm{average}}(p_i)}{|B|}, \qquad s_{i,c}^{\mathrm{rank}}=\sum_m w_{m,c}\rho_B(p_{m,i,c}).\]개별 predictor에 strictly increasing transform을 적용하면 그 predictor의 AUC는 유지된다. 그러나 변환한 점수를 섞은 결과의 순위까지 유지되는 것은 아니다. Probability 평균에서는 넓은 확률 범위를 쓰는 모델이 좁은 범위를 쓰는 모델보다 수치적으로 큰 영향을 준다. Rank 변환은 scale 차이를 상당 부분 없애면서 점수 간격 정보도 버린다. Logit 평균은 confidence를 또 다른 방식으로 반영한다. 최종 지표가 AUC라고 이 operator들이 같아지지는 않는다.
공개 시스템의 최종 operator도 서로 달랐다. 21위는 자체 family 안에서 fold logit을 평균하고 sigmoid를 적용한 뒤, 두 family와 public contribution의 확률을 각각 0.45, 0.45, 0.10으로 섞었다. 302위는 자체 모델을 공개 base에 더할 때 percentile rank 대신 standardized logit을 썼다. 반면 다른 public-stack 확장들은 여러 단계에 rank를 적용했다. 같은 architecture family를 사용해도 최종 estimator는 다르다.631
Rank 혼합에는 구현상의 조건이 하나 더 있다. Rank를 매기는 study 집합에 의존한다는 점이다. 전체 cohort의 rank를 사용하는 predictor를 몇 사례씩 따로 실행한 뒤, 그 혼합값을 그대로 비교할 수 있다고 가정해서는 안 된다. 각 component의 상대 rank가 cohort에 따라 달라지고, 혼합은 바로 그 상대 위치를 사용하기 때문이다. 499위 팀은 100 row가 넘을 때 작동하는 production rank branch를 확인하려고 전문가 study 58건과 다른 study 46건을 합친 104건을 실행했다. 이렇게 하면 구현 경로에 더 가까운 replay가 되지만, 전문가 58건은 여전히 여러 번 사용한 development panel이었다.32
저장한 CSV에도 모델 이름 이상의 정보가 필요하다. Raw probability인지, logit 평균에 sigmoid를 적용한 값인지, percentile인지, 이미 rank를 섞은 결과인지 구분해야 한다. Rank를 calibrated probability처럼 취급하면 학습과 조합이 달라진다. 이 구분을 놓치면 whole-bank search가 의도와 다른 대상을 정교하게 최적화하게 된다.
새로운 arm과 구성 비중의 변화
공개 H 계열은 하나의 flat average가 아니라 계층적인 조합이었다. 구조를 단순화하면 Raptor arm 안에서 384-pixel predictor와 224-pixel predictor를 0.65와 0.35로 결합하고, 그 arm을 소견별 weight로 R6와 섞는다. 412위 글에 적힌 Raptor 비중은 Synovitis 0.8, PF OA 0.6, Baker’s cyst 0.35, Lateral OA 0.2, 나머지 소견 0.5다. 소량의 reader를 넣는 단계가 그 밖에 더 있다.33
이 구조에서는 S6 predictor를 어디에 추가하는지가 중요하다. Outer re-ranking 이전에 소량의 reader를 제외한 base를 다음처럼 단순화하자.
\[H_c=w_c A_c+(1-w_c)B_c,\]여기서 $A_c$는 Raptor-arm score, $B_c$는 R6-arm score다. R6 arm 일부를 대체하면 다음과 같다.
\[H_c^{\mathrm{inside}} =w_c A_c+(1-w_c)\left[(1-\beta)B_c+\beta S_c\right].\]이 단계에서 S6의 직접 계수는 $(1-w_c)\beta$다. $\beta=0.3$이면 Synovitis는 0.06, PF OA는 0.12, Baker’s cyst는 0.195, Lateral OA는 0.24, 나머지 소견은 0.15가 된다. 반대로 전체 base 뒤에 S6 arm을 추가하면 다음과 같은 형태가 된다.
\[H_c^{\mathrm{outside}} =(1-\delta)\rho_B(H_c)+\delta\rho_B(S_c).\]후자는 기존 모든 arm의 배분을 바꾸면서 S6에 outer 계수 $\delta$를 준다. 중간에 rank transform이 있으므로 그 계수가 최종 prediction의 영향력을 모두 설명하지는 못한다. 그래도 두 구성이 서로 다른 비교라는 점은 이 식만으로 확인할 수 있다.
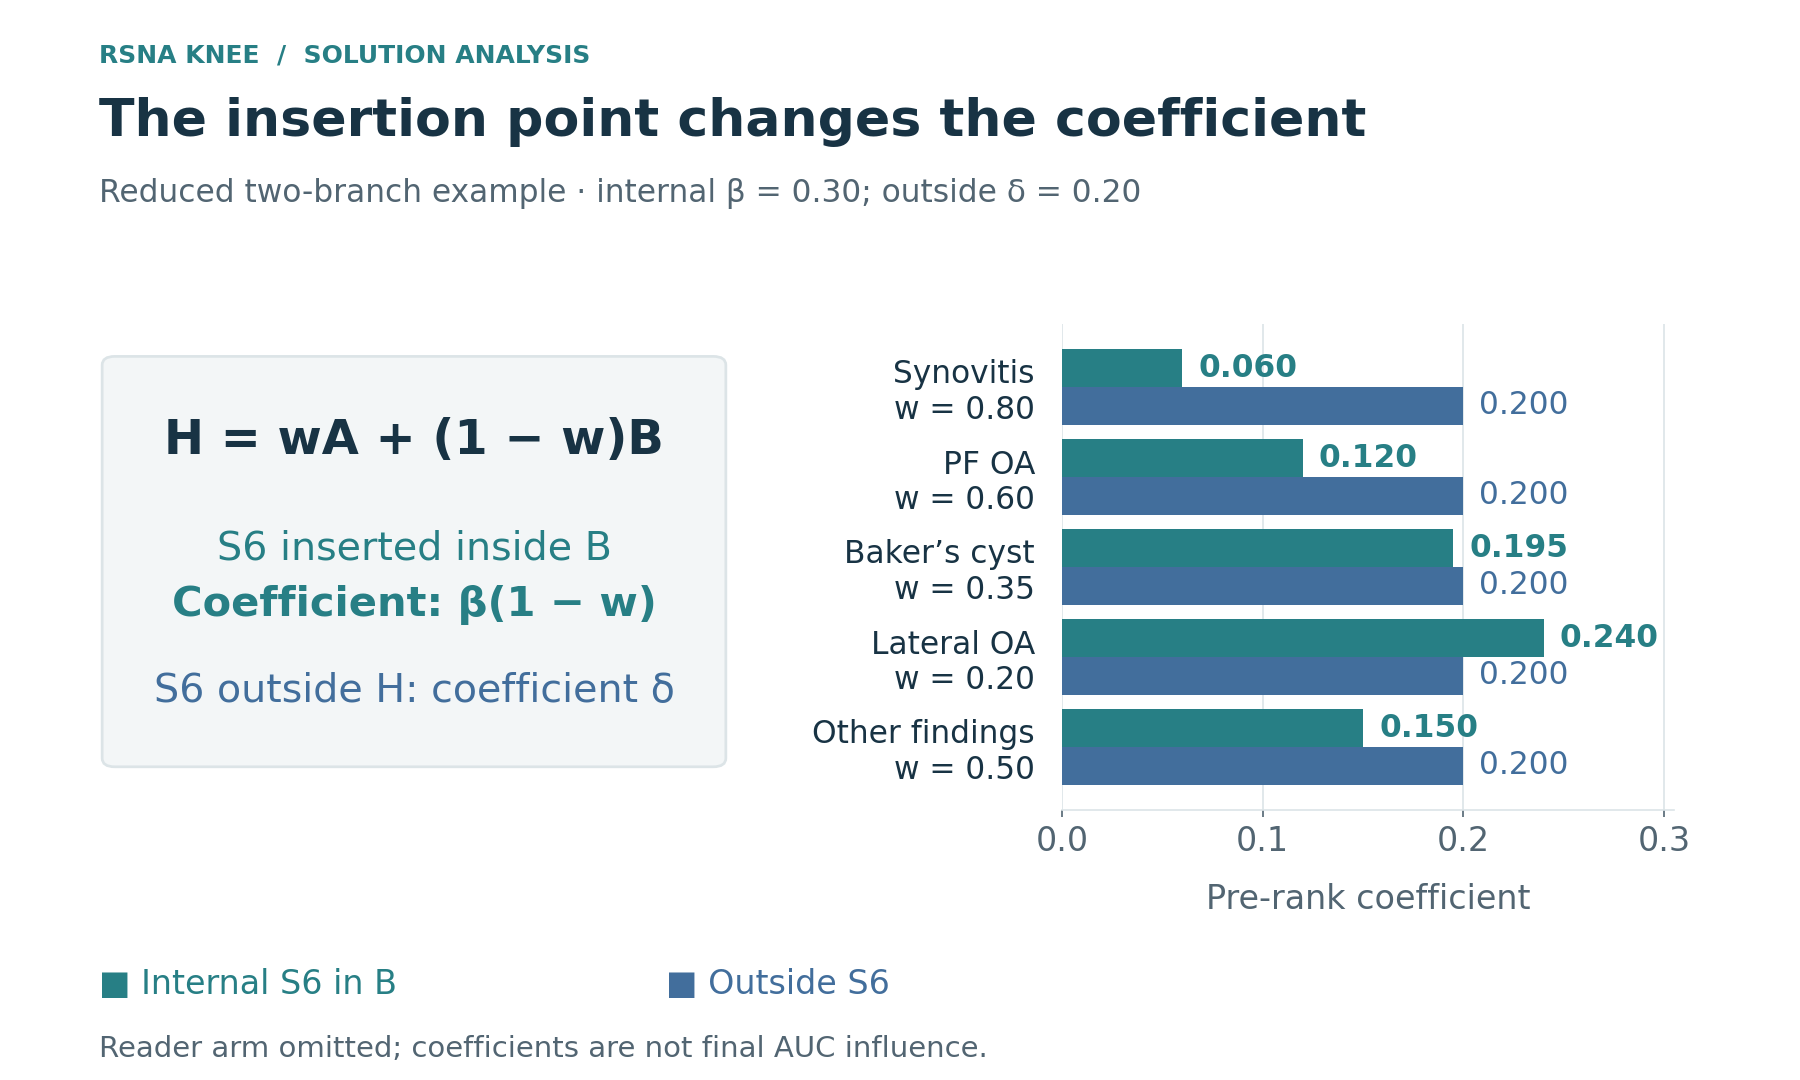
Figure 9. Outer re-ranking 전에 단순화한 두 arm의 직접 계수다. R6 안의 S6 weight 0.3은 R6 비중의 0.3배가 되며, 조합 뒤에 weight 0.2로 추가하는 것은 다른 배분이다. 이 식의 비교에서는 소량의 reader를 제외했다.
Northstar 팀은 R6 쪽 내부에 S6를 넣어 표시 Private 0.942를 얻었다. 412위 팀은 S6를 outer rank arm으로 0.20 또는 0.35만큼 추가해 0.943을 얻었다. 후자는 Northstar가 훨씬 큰 비중에서만 시험했던 소량의 reader도 유지했다. 따라서 두 팀의 차이를 S6 위치만의 효과로 해석할 수는 없다. 더 적절한 근거는 412위 자체 control이다. 같은 public recipe에 S6 arm을 뒤에 붙였을 때 0.942에서 0.943으로 올랐다.3433
내 package도 seed나 family를 추가하면 S6의 총비중, N/V3의 균형, outer rank normalization이 동시에 바뀔 수 있었다. 그 결과가 측정한 것은 package 전체의 변경이었다. 유용한 coarse 배분을 고르는 근거는 될 수 있지만, 새 checkpoint 하나의 독립적인 이득을 뜻하지는 않는다.
공개 stack에 모델을 추가한 결과
중위권의 여러 해법은 익숙한 공개 parent에서 시작하므로 비교할 가치가 있다. 별도로 학습한 predictor를 추가하는 방법이 언제 유용했고, 어디까지 개선됐는지 보여 준다.
| 사례 | 자체 성분 또는 새 arm | 대응 Private 결과 |
|---|---|---|
| 478위 | Outer weight 0.15의 five-fold ConvNeXt-S student | 공개 parent 0.942 → 선택한 혼합 0.943 |
| 412위 | 공개 S6 predictor를 0.20 또는 0.35로 추가 | 재현 parent 0.942 → 최종 두 혼합 모두 0.943 |
| 507위 | 소견별 base 변경과 재학습한 reader | 배포 parent 0.942 → 선택한 변형 0.943 |
| 내 제출 | Outer weight 0.25의 자체 N/V3 rank block | H parent 0.942 → 선택한 혼합 0.943 |
478위의 student는 단독으로도 Public 0.952, Private 0.939로 상당히 강했다. 공개 조합 안에 0.05를 주면 표시 Private은 0.942였고, 0.15를 주면 0.943이었다. 이후 student를 더 만들고, 비중을 높이고, fastMRI로 학습한 변형을 넣어도 표시 점수는 더 오르지 않았다. Student를 뒤에 추가하는 대신 R6 일부를 대체하는 방법도 덜 유리했다. 공개 튜닝 때문에 Private 기여가 잘 보이지 않았다는 저자의 해석은 가능하다. 다만 paired 결과가 직접 보여 주는 것은 더 좁다. 이 자체 모델이 이 operator와 이 parent에서 작은 추가 이득을 냈다는 사실이다.29
507위는 물려받은 소견별 weight를 바꾸고 재학습한 256-pixel reader를 추가했다. 전체 실행 경로의 gold replay는 0.9384에서 0.9419로 올랐지만 Public은 0.958에서 0.957로 내려갔고, Private은 0.942에서 0.943으로 올랐다. 저자는 작은 gold 우위를 선택 방향을 정하는 근거로 썼으며, 한 번도 사용하지 않은 검증 결과로 보지는 않았다. Reader와 배분이 함께 바뀌었으므로 어느 하나만의 효과로 돌릴 수는 없다.35
자체 기여가 더 큰 사례도 있었다. 129위 시스템은 compartment-routed ConvNeXt, slice-context 모델, CoAt family로 만든 자체 rank block에 50%를 주고 0.946을 기록했다. 243위는 단독 Public 0.954를 보고했고, 공개 3D R6 component를 유지하면서 2D에 배정된 몫의 절반을 자체 모델로 대체했다. 최종 Private은 0.944였다. 전체 시스템을 단순한 50/50 혼합이라고 부르는 것보다 이 설명이 정확하다. 302위는 자체 모델 열여덟 개를 추가했고 그중 열 개는 전문가 등급이 있는 OAI 무릎으로 학습했다. 그러나 짧은 원문에는 외부 데이터, 모델 수, standardized-logit operator의 이득을 나눌 만큼 ablation이 없다.133631
유용한 자체 모델 비중은 parent와 operator에 따라 달랐다. 15% arm도 도움이 될 수 있고, 50% arm도 타당할 수 있으며, bank가 커져도 추가 이득이 없을 수 있다. Weight는 오류가 서로 보완된다는 가설의 일부다. 독립성을 입증하는 값도, 최종 조합에 반드시 포함해야 한다는 근거도 아니다.
215위는 또 다른 경로를 택했다. 자체 RadImageNet 기반 arm에 공개 혼합의 25%를 준 뒤, magnetic-field-strength group 안에서 rank를 부분적으로 교정했다. 마지막 field correction을 쓰지 않았을 때 Public 0.958이었고, correction 0.35에서는 0.960, 0.5에서는 0.957이었다. 선택한 전체 시스템의 Private은 0.944지만, 원문에는 field correction 자체의 matched Private delta가 없다.37
이 연산은 각 test group의 점수 분포를 mapping에 사용하므로 transductive하다. 저자는 train에서 fit한 inductive 버전을 local에서 비교했지만, 제출에는 transductive 방식을 사용했다. 둘 다 training-only site logit을 제거하는 방법과는 다르다. 구체적인 acquisition 효과가 의심될 때 분포 기반 후처리를 시험할 수는 있다. 그렇다고 모든 test group에 자동으로 적용할 정규화는 아니다. 실제 유병률과 중증도 차이도 신호일 수 있고, DICOM tag가 없으면 field strength를 지어내는 대신 결측을 별도로 처리해야 한다.
Weight space에서의 모델 적응
220위 팀은 새로운 prediction file을 추가하는 것과 다른 방법을 썼다. 공개 checkpoint를 한 epoch fine-tune하면서 전문가 study 58건이 batch에 들어가도록 명시적으로 sampling하고, 그 결과 parameter를 원본과 평균했다. Main reader에 사용한 soup는 다음과 같다.
\[\theta_{\mathrm{soup}} =0.25\theta_0+\sum_{r=1}^{4}0.1875\theta_r.\]계수의 합은 1이지만 parameter 평균은 다섯 prediction function의 평균과 같은 연산이 아니다. Fine-tune들이 같은 architecture와 가까운 초기화를 공유하기 때문에, 서로 다른 model family의 parameter를 평균하는 것과 달리 local weight averaging이 의미를 가질 수 있다. 제출 시스템에는 다른 reader, specialist, 3D contribution도 들어갔다. Private 0.944는 package의 결과이며 soup만의 성능 측정값이 아니다.38
이 구분은 Northstar에서 성능이 낮아진 fine-tuning 결과를 읽을 때도 중요하다. 이 팀은 원래 nartaa inference를 재현해 Private 0.930을 얻고, 자체 라벨과 80% training split에서 fine-tune해 0.926을 얻었다. 그 결과는 해당 적응 방식이 predictor를 약화했다는 근거다. 공개 checkpoint의 모든 adaptation이 나쁘다는 증거는 아니다. 라벨 target, 사용할 수 있던 데이터, gold 노출, schedule, parameter averaging이 220위 방식과 다르다.34
공개 weight를 활용하는 경로는 여러 가지였다. Final-only anchor로 유지하거나, 코드를 clean exclusion 아래 재현하거나, supervision을 바꾸거나, 통제한 target으로 fine-tune하거나, teacher로 쓸 수 있었다. 만들어지는 자산과 필요한 평가 경계가 각각 다르므로 공개 모델과 자체 모델이라는 구분만으로 선택할 수는 없었다.
단일 모델의 강도와 ensemble 규모
공개 결과는 compact ensemble이 항상 이긴다는 규칙을 지지하지 않는다. 1위 최종 구성은 한 branch의 classification checkpoint 열일곱 개와 다른 branch의 full-data model 세 개를 결합했다. 22위는 여러 group의 network 56개를 썼다. 모두 상당히 큰 ensemble이다. 각 경로의 단독 강도와 target별로 보완되는 view가 있었기 때문에 그 규모가 유용했다.
반면 포화된 사례도 있다. 7위는 full-data ConvNeXt-S 모델 하나로 Private 0.958을 얻었고, 최종 ensemble은 0.957이었다. 72위의 최종 모델 자체가 five-fold family였으며, 이전 모델과 섞으면 더 낮았다. 5위의 최고 M3 family도 표시 최종 점수 0.958과 같았다. 뒤의 두 사례는 fold ensemble과 그보다 큰 조합을 비교한 것이다. Five-fold family 자체가 이미 여러 checkpoint를 평균한다.
내 bank도 추가와 교체를 모두 비교할 수 있어야 했다. 약한 component를 빼는 조합도 허용하되, 선택되지 않은 complete clean family는 보존해야 한다. 탐색을 기록된 package에 member 하나를 더하는 방식으로 제한하면 이전 선택이 이후의 탐색 범위까지 결정한다. 더 넓은 search는 bank 안의 선택을 개선할 수 있지만, bank에 없는 강한 feature나 supervision을 만들어 내지는 못한다. 조합을 개선하는 일과 다음 연구 투자를 바꾸는 일이 나뉘는 지점이다.
5. 연구 판단의 오류와 당시의 대안
앞의 기술적 차이들은 다음에 무엇을 연구할지에도 직접 영향을 준다. Target을 개선하면 inference 경로를 늘리지 않고도 모델을 강화할 수 있다. 입력 범위를 바꾸면 backbone을 키워도 복구할 수 없던 근거를 제공할 수 있다. Report shortcut이 원인이라면 local 점수가 높아지는 것 자체가 잘못된 방향을 가리킬 수도 있다. 최종 결과가 나오기 전에도 연구 방향을 다시 검토할 신호는 있었다. 나는 그 불확실성을 시험하기보다 기존 pipeline을 더 잘 작동시키는 데 머무를 때가 많았다.
반복된 문제는 관측한 결과로 판단할 수 있는 범위를 넘어 더 큰 결정을 내린 것이었다. Prediction이 clean하다고 채점 target까지 타당한 것은 아니다. Pilot이 실패했다고 가능한 모든 구현이 실패한 것은 아니다. Bank가 커졌다고 독립적인 정보가 늘어난 것도 아니다. 이 구분을 지켰다면 다음 비교뿐 아니라 그 때문에 뒤로 미룰 작업도 달라졌을 것이다.
학습 target의 정의와 검증
판독문과 라벨의 불일치에는 서로 다른 세 문제가 있었다. Extractor가 판독문을 제대로 옮겼는가, 판독문에 필요한 소견이 있는가, 판독문에 적힌 소견이 대회의 positive 기준에 맞는가. Annotation을 한 번 더 하기 전에 어느 단계가 잘못됐는지부터 구분했어야 했다. 추출 오류라면 extractor를 고쳐야 하고, 소견이 빠졌다면 다른 정보원이 필요하다. 중증도 기준이 다르면 target 정의를 고쳐야 한다. Student가 작은 lesion을 볼 수 없다면 입력도 바꿔야 한다. 같은 판독문을 다시 읽히는 것으로 네 문제를 모두 해결할 수는 없다.13
필요했던 것은 target을 만드는 방법 두 가지를 같은 student로 비교하는 실험이었다. 한쪽은 기존 report-derived target을 유지하고, 다른 쪽은 low-grade 소견을 positive로 처리하거나 영상에 있는 소견이 판독문에서 빠지는 문제처럼 특정 오류를 고친다. Student, fold, update budget, inference coverage는 고정한다. 불일치 사례에서는 무엇이 바뀌었는지, 무작위 표본에서는 그 문제가 얼마나 흔한지 확인할 수 있다. 차이가 큰 사례만 골라서는 전체 데이터에서의 가치를 추정할 수 없다.
대조군도 남은 설명들을 구분할 수 있어야 한다. 영상을 바꾸어 넣으면 reader가 시각 입력에 반응하는지 알 수 있고, 인용한 slice를 검토하면 관련 해부 구조를 근거로 답했는지 확인할 수 있다. 어느 쪽도 예측 성능에 도움이 된다는 증거는 아니다. 유망한 annotation을 전체 corpus로 확대하려면 matched student 비교가 여전히 필요하다.
Student에 도움이 되고, 남은 오류도 수정한 reader가 얻을 수 있는 정보로 줄어들 여지가 있다면 규모를 늘릴 이유가 생긴다. 이전 답을 반복하거나, student가 볼 수 없는 근거에 의존하거나, 적절한 평가에서는 개선이 사라진다면 설계나 정보원을 바꿔야 한다. 관찰 기간에 따라 달라지는 churn target이나 moderator의 조치를 정답으로 삼는 text task도 마찬가지다. 기록된 결과를 잘 맞히는 것은 유용할 수 있지만, 그것만으로 다른 outcome에 대한 주장까지 뒷받침되지는 않는다.
순위 성능과 학습용 확률의 차이
확률 분석은 라벨을 평가하는 방식에도 문제가 있었음을 보여 준다. 모델 output에 strictly increasing transform을 적용해도 AUC는 변하지 않는다. 그러나 변환한 값을 soft BCE target으로 넣으면 student가 받는 학습 신호는 달라진다. Gradient가 $p-q$이므로 study 사이의 순서가 같아도 $q$의 confidence를 바꾸면 gradient가 바뀐다.
라벨표의 AUC가 좋다는 이유로 확률값 자체의 품질 검토를 대신할 수는 없었다. 확신에 찬 잘못된 positive, 반반에 가까운 값, 누락된 annotation은 학습에 다르게 작용한다. Image learner를 고정한 채 근거가 있는 mapping을 바꾸는 편이 더 적절한 비교였다. 명시적인 negative는 유지하고 실제 응답 누락은 mask하거나, 전문가 기준과 어긋난다고 확인한 report group의 confidence를 낮추는 식이다. 각 상태가 얼마나 흔한지, 어느 사례의 gradient가 크게 바뀌는지부터 살펴봐야 했다.
전문가 정답으로 calibration을 fit했다면 해당 평가에 필요한 fold exclusion을 지켜야 한다. 그 이전에 recipe를 설계하며 같은 사례를 참고했다면 그 이력도 development exposure로 남는다. 1위와 5위의 분석은 이런 문제를 조사하는 방법을 보여 준 것이지, 내 라벨에 그대로 복사할 수 있는 변환을 제공한 것은 아니다.141 효과는 matched student로 확인해야 했다. 수치 표현은 그것을 사용하는 연산에 맞춰 평가해야 한다. Distillation target, propensity weight, ordinal regression outcome, rank blend가 모두 숫자라고 해서 같은 성질을 요구하는 것은 아니다.
Pilot의 범위와 결론의 범위
H1c는 이미 대조군을 갖춘 image-assisted 실험이었다. Report-only 비교, 반복 판독, 다른 study의 영상 대입을 포함했고, matched five-fold student도 완성했다. Mm12의 Public은 0.914로 control의 0.911보다 높았다. 남은 질문은 이득이 제한적이었던 이유였다. 일부 output은 올바른 영상과 잘못된 영상에 모두 반응했지만 contusion은 여전히 판독문에 강하게 의존했다. 이 결과 다음에는 image-assisted supervision의 성능 한계를 넓게 단정하기보다 coverage와 grounding을 조사했어야 했다.
다음 비교에서는 진단 정의를 유지하면서 view를 바꿀 수 있었다. 고정 packet을 더 넓은 series coverage나 필요한 위치의 재확인과 비교하는 것이다. Reader를 먼저 고정하면 coverage 효과를 구분할 수 있다. 그것만으로 판단하기 어려우면 더 강한 reader를 포함한 전체 recipe도 합리적인 대안이다. 국소적인 marrow finding을 모은 작은 challenge set에서는 interface가 필요한 근거를 보여 주는지, 별도의 무작위 표본에서는 그 변화가 얼마나 널리 중요한지 확인할 수 있다. 개선한 annotation이 학습에 도움이 되는지는 그다음 matched student로 판단해야 한다.
골라 놓은 실패 사례만 해결했다고 전체 corpus를 annotation할 근거가 생기지는 않는다. 두 표본에서 믿을 만한 결과가 나오고 student에도 도움이 된다면 확대할 수 있다. 충분한 coverage와 적절한 student를 갖추고도 실패한다면 해당 경로를 중단하거나 정보원을 바꿀 근거가 된다.
이렇게 해야 pilot의 중단 기준을 세우면서도 초기 실패 하나를 방법 전체에 대한 기각으로 확대하지 않을 수 있다. 복구할 수 없는 geometry, 쓸 수 없는 영상, 신호를 받아들이지 못하는 learner, 기한 안에 감당할 수 없는 전체 비용은 그 경로를 중단할 이유다. 학습 체계가 다르다면 초기 checkpoint가 incumbent보다 낮다는 이유만으로 기각하기는 어렵다. 두 체계에서 초기 성능과 최종 성능의 관계가 비교 가능한지 먼저 확인해야 한다. 약한 retriever와 잘린 문서로 시험한 뒤 retrieval 전체를 기각하는 경우에도 같은 오류가 생긴다. 실패한 설정은 확인했지만 더 넓은 주장은 아직 시험하지 않은 것이다.
부분 교체 실험과 전체 recipe의 구분
초기 architecture 변경은 DINOv2에 맞춘 recipe 안에서 시험했고, drop-in 성능이 나쁘면 더 넓은 대안에도 불리한 근거로 받아들였다. 9월의 learning rate × fine-tuning depth 진단은 같은 architecture 안에서도 변경들이 강하게 상호작용할 수 있음을 보여 줬다. 다른 backbone이 성공하리라는 증거는 아니었다. 다만 일부를 따로 교체한 결과만으로 결합 recipe를 설명할 수는 없다는 뜻이었다.
본격적으로 대안을 비교하려면 supervision, 물리적 coverage, normalization, aggregation, optimization을 그 설계에 맞게 갖춘 구현이 먼저 필요하다. 입력과 prediction path도 확인해야 재현 실패인지, 제대로 구현했지만 transfer하지 않은 방법인지 구분할 수 있다. 전체 비교가 유망하다면 비싼 component를 빼거나 바꾸어 다음 투자 대상을 찾을 수 있다. Infrastructure 오류가 반복된 것을 가설을 기각할 독립적인 근거가 쌓였다고 해석해서는 안 된다.
Reader와 coverage를 예로 들면 순서가 분명해진다. $a$는 기존·수정 reader를, $b$는 compact·더 넓은 annotation packet을 선택한다고 하자. 각 조건에서 같은 student recipe를 학습하고 그 비교에 적합한 동일한 reference로 평가한 점수를 $S_{ab}$라고 하면 interaction contrast는 다음과 같다.
\[I=(S_{11}-S_{10})-(S_{01}-S_{00}).\]Coverage의 효과가 두 reader에서 같은지를 묻는 식이다. 조건에 따라 라벨은 다시 만들되 student split, update budget, inference 설정, scoring은 고정한다. 각 조건의 annotation 비용도 함께 적어야 한다. 학습을 반복하면 상호작용이 유지되는지 확인할 수 있지만, 표시된 점수 네 개만으로 불확실성을 추정할 수는 없다.
대안을 시험하기 전에 네 조건을 반드시 모두 실행할 필요는 없다. 첫 비교는 전체 recipe가 다른 두 조건, $S_{11}$과 $S_{00}$ 사이일 수 있다. 여기서 개선이 나오면 우선 결합 recipe를 지지하는 결과로 읽고, 비싼 coverage 확장이 꼭 필요했는지 확인할 수 있다. 실패했다면 정보를 제대로 활용하지 못한 것인지, 제대로 시험했는데도 개선이 없었던 것인지 구분해야 한다. 각 재료를 나누는 대조군은 그 답이 다음 투자를 바꿀 때 추가하면 된다.
2위의 결과도 slice를 더 보여 준 효과만이 아니라 reader와 coverage를 함께 개선한 recipe의 근거다.3 내 다음 비교에서도 같은 구분이 필요했다. 비용·준비 상태·미루게 되는 대안을 따졌다면, 맞지 않는 환경에서 모든 component가 drop-in으로 먼저 이기지 않더라도 강한 end-to-end 시스템을 한 번 재현할 수 있었다. Tokenization과 pretraining, missing-value의 의미와 feature construction, retriever와 context window도 서로 영향을 줄 수 있다. Factorial ablation의 정밀함은 실제 결정을 바꿀 때 유용하다. 어느 baseline도 시험하려는 시스템을 충실하게 구현하지 못한 상태라면, 정밀한 factorial 비교부터 할 단계는 아니다.
OOF bank의 규모와 예측 정보
초기 bank에서 완성한 OOF run 66개 중 57개는 기본 입력을 공유하는 DINOv2-small의 라벨 변형이었다. 8월 진단에서는 그 bank에서 얻은 ensemble 이득이 내가 줄이려던 격차보다 훨씬 작다는 사실을 이미 확인했다. 살펴본 bank의 개선이 정체됐다는 경고였지, ensemble 자체의 한계는 아니었다. 그런데도 더 강한 예측 정보원을 만드는 것보다 bank의 entry를 늘리는 쪽이 계속 쉬운 선택이었다.
동일 가중치로 평균하는 K개 predictor를 생각해 보자. Member $m$의 확률 오차를 공통 성분과 member별 성분으로 쓰면 다음과 같다.
\[e_m(x)=b(x)+u_m(x),\qquad \bar e(x)=b(x)+\frac{1}{K}\sum_{m=1}^{K}u_m(x).\]평균은 두 번째 항을 바꾸지만 이 분해에서 공통 성분은 남는다. 실제 성분을 관측한 것도, AUC를 예측하는 식도 아니다. 앞의 pair-order 예제가 시사한 한계를 표현한 것이다. 예측값이 서로 달라도 같은 소견을 놓치거나 같은 hard negative에서 실패할 수 있다. Seed, 비슷한 라벨 혼합, 같은 teacher의 student는 근사 성능을 높이면서도 새로운 정보원을 제공하지 않을 수 있다.
따라서 다음 투자에는 두 비교가 필요했다. 가장 강한 standalone family와의 비교, 그리고 실제로 배포할 parent에 더했을 때의 비교다. 더 나은 target, 놓친 해부 구조를 보여 주는 view, 더 강해질 근거가 있는 전체 learner는 단일 family의 성능을 높이거나, 다른 오류를 보완하거나, 비용을 낮추거나, 교체를 가능하게 할 수 있다. Global correlation이 낮다는 것만으로는 어느 기여도 입증되지 않는다. 강한 standalone과 약하지만 보완적인 모델은 둘 다 whole-bank search에 남길 가치가 있다.
Complete family를 보존한다고 같은 계보를 계속 늘려야 하는 것은 아니다. Matched 비교를 반복해도 개선이 정체되고 준비된 대안이 있다면 신규 투자를 옮겼어야 했다. 거의 끝난 유용한 family를 완성하는 것과 그다음 한 주를 후속 모델로 채우는 것은 별개다. Time series에서도 비슷한 window 변형들이 같은 regime에서 실패할 수 있다. 같은 과거를 다시 sampling하는 것과 예측 시점에 쓸 수 있는 새 변수를 추가하는 것은 다르다. Tabular 모델들이 inference에서 쓸 수 없는 feature를 공유한다면 독립적인 확인도 아니다. 중요한 다양성은 사용할 수 있는 정보와 실제로 고치는 오류에 있다.
Clean OOF와 평가 기준의 타당성
내 primary score는 9월 30일 개별 family 열네 개를 비교했을 때 유용해 보였다. 그러나 10월 6일 package 열 개에서는 Public과의 Pearson correlation이 −0.322였다. 작은 과거 표본으로 Public이 언제나 옳다거나 OOF가 무효라고 할 수는 없다. 한 종류의 비교에서 잘 맞았다는 사실만으로 다른 종류의 선택에도 해당 reader를 적용할 근거가 생기지는 않았다는 뜻이다.
72위의 site 개입은 이후 이런 역전이 생기는 기전을 분명하게 보여 줬다.18 고정된 report reference는 같은 label 계보 안의 optimizer 변경을 비교하면서도, 판독 관행을 교정한 모델에는 낮은 점수를 줄 수 있다. 그 글의 Private correlation 분석은 당시 알 수 없었지만, 내 local·Public 불일치만으로도 reference를 조사하고 자동으로 package를 제외하는 규칙을 중단할 이유는 충분했다.
Reader 점수는 조건부 진단 자료로 남겨야 했다. 출처, 제외 group, label 계보, 이전 사용 이력, 적합한 비교 범위를 함께 정해야 한다. Label을 바꾸는 비교를 같은 label source와의 일치도만으로 결정해서는 안 된다. 거의 같은 seed 비교를 위해 새 annotation 시스템부터 만들 필요도 없다. 편리한 local proxy가 있다고 final-only 공개 anchor가 clean OOF가 되는 것도 아니다.
불일치에는 구체적인 대조군이 필요했다. Site 안의 순위는 좋아졌지만 site 사이의 offset을 잃었는가? Decoder가 positive의 기준을 바꿨는가? Local inference에서 다른 crop이나 reducer를 썼는가? Candidate가 evaluator의 parent를 공유하는가? Aggregate correlation을 다시 계산해도 이 설명들을 구분할 수는 없다. 적절한 matched 비교가 나왔다면 해당 선택에서 reader를 다시 신뢰할 수 있었을 것이다. 선호하는 순서를 보여 준다는 이유로 고른 새 panel은 그 근거가 될 수 없다. Evaluator 조사는 결정을 뒷받침할 만큼 확인했거나 남은 한계를 인정한 채 결정할 수 있을 때 끝나야 한다. 범위를 정한 transfer 비교까지 모두 멈출 이유는 아니었다.
다른 대회에서도 내려야 할 결정과 validation 설계가 맞는지를 봐야 한다. Random split은 알고리즘을 비교하면서도 미래 regime을 놓칠 수 있고, 익숙한 test suite는 바뀐 interface를 놓칠 수 있다. Validation을 포기하거나 다른 편리한 metric 하나에 모든 결정을 맡겨서 해결할 문제는 아니다.
미결정 상태와 후속 연구 배분
9월의 label 비교에서 표시 Public은 0.913 대 0.911이었다. 결정 기록에도 미리 정한 기준을 충족했는지 판단할 수 없다고 적었지만, 이후 queue는 기존 label에 남았다. “교체할 근거가 부족하다”가 기존 campaign을 계속할 근거가 된 것이다.
문제는 0.002가 반드시 의미 있었다거나 없었다는 데 있지 않다. 불확실한 비교 하나가 별도의 논거 없이 더 큰 자원 배분을 결정했다. Expert label에서 더 좋게 나온 쪽으로 모든 강한 learner를 바꿀 수도 없었다. Panel은 작고 이미 사용됐으며 다른 대상을 평가했다. 이 비교에는 판단 보류일 때의 조치가 필요했다.
두 target을 더 강한 matched student로 시험하거나, target 정의가 어긋난 사례를 조사하거나, teacher 정보의 효과를 일반적인 smoothing과 비교할 수 있었다. 각각 때문에 미뤄야 할 작업도 명시해야 했다. 입력이나 capacity 때문에 바뀐 target을 활용하지 못하는 약한 learner를 반복하면 계속 판단하기 어려울 수 있다.
사전 규칙에는 확대, 중단·재설계, 판단 보류의 후속 행동이 있어야 한다. 보류라면 원인을 구분할 비교를 더 할지, 어떤 기한과 조건으로 임시 default를 유지할지, 기회비용 때문에 더 조사하지 않을지 정해야 한다. 전환 비용이 크거나 시간이 부족하면 incumbent를 유지할 수 있다. 그것은 위험과 일정에 대한 선택이지 두 방법이 동등하다는 통계적 결론이 아니다. Threshold로 반응적인 tuning을 줄이더라도 incumbent에 무제한 연구 시간을 줄 수는 없다. 남은 개선 여지, 필요한 근거, 대신 할 수 있는 연구를 함께 따져야 한다.
전문가 사례의 반복 사용과 개발 피드백
앞의 expert panel 분석은 GPU 사용량만으로 보이지 않던 자원을 드러낸다. 아직 독립적으로 얻을 수 있는 피드백이다. Rubric, reader, calibration, epoch, blend를 바꾸는 데 같은 사례를 썼다면 정답이 training loader에 들어가지 않았어도 선택에는 여러 번 영향을 줬다.
비슷한 모델을 비교하기 전에 panel의 용도를 정했어야 했다. 일부는 의미상의 진단과 target 생성에 쓰고, 개발에 쓰지 않은 subset은 처음 확인할 때 제한적인 검증 자료로 쓸 수 있다. 나누는 실익이 없을 만큼 작다면 개발에 의도적으로 사용하고 다른 자료로 보완하는 편이 나을 수도 있다. 같은 사례로 protocol을 만든 뒤 random half-split을 반복해도 이전 노출이 사라지지는 않는다.
Expert calibration으로 predictor가 충분히 좋아진다면 panel을 개발에 쓸 가치가 있다. 문제는 그 이득을 얻고도 같은 자료를 독립적인 test처럼 내세우는 것이다. Paired bootstrap은 학습된 candidate들을 조건으로 사례 변화에 대한 민감도를 측정한다. 새로운 사례를 얻는 방법도, 바뀐 annotation 과정을 검증하는 방법도 아니다.
사람이 직접 본 오류 사례, prompt 개발 내내 사용한 공개 benchmark, 반복해서 확인한 특정 월의 validation data에서도 같은 문제가 생긴다. Gradient descent가 본 row뿐 아니라 판단을 바꾼 피드백을 추적해야 한다. 많이 사용한 자료에 비슷한 모델의 선호 순서가 달려 있다면, 같은 점수의 소수 자릿수를 늘리기보다 선택을 단순하게 하거나 다른 비교를 찾는 편이 낫다.
Student 성능과 ensemble 기여
내 T* target은 여러 standalone engine을 개선했지만 해당 parent package의 개선은 훨씬 작거나 표시 Public이 같았다. Student가 좋아졌다는 증거이지, 그 이득을 ensemble에서 더할 수 있거나 supervision이 독립적으로 확인됐다는 뜻은 아니다. Regularization과 학습 개선으로 여러 architecture가 같은 유용한 지식과 같은 target 오류를 물려받을 수 있다.
다음 generation에서는 student의 architecture, schedule, outer exclusion을 고정해야 했다. 기존 target과 teacher를 한 번 섞은 target을 비교하되 원래 source의 비중을 명시적으로 고정해 남겨야 한다. 직전 mixture로 source 자체를 계속 바꾸는 방식과 구분하는 것이다. Teacher 정보가 smoothing 이상의 효과를 냈는지가 질문이라면 smoothing control이 적합하다. Inner training의 teacher target이 in-sample이면 그대로 밝히고, 전체 estimator에서 outer validation을 제외해야 한다. Full-data 공개 teacher가 outer 사례를 봤거나 계보를 몰라 exclusion을 확인할 수 없다면 그 후손은 final-only다.
Parent의 중요한 오류가 바뀐다면 다음 generation에 투자할 이유가 있다. Teacher-derived reference에 더 잘 맞을 뿐이거나, 원래 유용했던 signal을 잃거나, 보완 효과가 더 생기지 않는다면 mixture나 정보원을 바꿔야 한다. Architecture 이름이 달라져도 계보는 사라지지 않는다. Language model의 teacher 답을 반복해서 표현만 바꾼다고 독립적인 supervision이 생기지 않는 것과 같다.
독립성이 유일한 가치는 아니다. Student는 느린 teacher를 대체하고, 여러 member를 압축하고, runtime 안에서 더 저렴한 근사를 제공할 수도 있다. 이때 필요한 것은 속도와 transfer의 근거다. 이를 다양성으로 설명해서는 안 되며, 성능 정체가 자동으로 teacher round를 늘릴 이유가 되어서도 안 된다.
공개 baseline의 역할과 과적합 가정
H의 우위가 Private에서는 사라지리라는 내 기대는 맞지 않았다. H는 내가 완성한 자체 조합보다도 강했다. 그렇다고 Public 선택에 따른 낙관적 편향이 전혀 없었다는 뜻은 아니다. Private을 모르는 개발 당시에는, 이미 Public에서 앞선 predictor를 기대만으로 낮춰 볼 것이 아니라 점수가 있는 fallback을 남기고 미리 정한 소수의 대안을 비교했어야 했다.
Provenance에 따라 역할을 정하는 것이 맞았다. Final-only 공개 자료는 배포할 anchor, clean reproduction의 출발점, 어떤 기전의 근거가 될 수 있다. 역할마다 필요한 작업과 주장할 수 있는 범위가 다르다. 나중에 S6F가 내 가장 강한 complete family가 된 것은 전체 recipe를 재현할 가치를 보여 준다. 그 정확한 학습 경로가 몇 주 전부터 준비돼 있었다는 뜻은 아니다.
내 Public 비교 중에도 coarse grid와 scored fallback을 미리 정한 것이 있었고, 그 설계는 유지할 가치가 있었다. H에 자체 block을 더할 때는 parent, member, reducer, 비중이 명확해야 한다. Inner arm 교체와 outer rank block 추가는 서로 다른 변경이다. Parent를 고정하고 전체 설계가 맞춰진 arm 하나를 비교하면 transfer나 보완 효과를 시험할 수 있다. 결과를 볼 때마다 작은 weight를 새로 정해 반복하면 같은 hidden subset에 선택이 점점 더 맞춰진다. 좋은 결과는 미리 정한 비교를 지지하지만, 같은 방법의 모든 변형까지 좋다는 뜻은 아니다.
제출 전에 두 결과의 다음 행동을 정해야 했다. 도움이 안 되면 H를 유지하고 그 비교를 끝낼 수 있었다. Clean OOF 자산까지 버릴 필요는 없다. 도움이 되더라도 weight를 조금 더 바꾸는 것이 최종 선택을 바꿀 이유가 있어야 다음 제출을 쓸 수 있다. 어느 결과에도 같은 행동을 할 것이라면 모델 선택을 위한 비교로서 당장의 가치는 작다. 새로운 source나 기전이 생기면 그때 다시 검토할 수 있다.
Comparator는 기준이지 필수 member가 아니다. 점수가 있는 fallback을 유지하면서 교체 조합을 검토하면 이전 자산을 보존할 수 있다. 이미 들인 노력을 정당화하려고 최종 predictor를 고를 필요도 없다.
추론 시간 상한과 실행 가능한 선택지
연구 선택지는 끝까지 마치는 비용으로 비교해야 했다. Annotation에는 렌더링, 자료 접근, 호출, 복구, 품질 확인, matched student, 통합이 포함된다. 새 family에는 충분한 학습, 필요한 경우 전체 fold의 학습 완료, artifact 회수, 최종 inference 구현이 필요하다. Inference 경로도 decoding, transfer, compilation, 메모리 동작, aggregation, 유효한 output까지 포함한다. 짧은 개별 작업만 비교하면 실제로 선택할 predictor를 만드는 비용을 과소평가한다.
공개 비용의 집계 범위도 맞아야 한다. 준우승 팀의 약 100 GPU-hours는 research를 제외한 최종 seed 학습량이고, 내 약 1,445 rented box-hours는 훨씬 넓은 campaign의 시간이었다. 둘을 나눠서는 효율을 측정할 수 없다. 비교할 것은 다음 연구 과제가 무엇을 만들며 어떤 일을 미루게 하는지였다.
348위 작성자는 유망한 fastMRI-pretrained 경로의 접근 요건이 host의 accessibility 기준에 맞지 않는다고 판단해 사용하지 않았다. 새 공식 판정이 아니라 작성자의 판단이었다.39 Source 접근, license, 준비, inference 가능성도 투자 결정에 포함된다. 이후 self-training은 standalone ConvNeXt-T Private 0.937, CoAtNet과 결합하면 0.933이었지만, 최종 선택 뒤에 나온 측정값이므로 앞선 선택을 정당화할 수는 없었다.
남은 단계를 순서대로 실행해야 한다면 마감에서 다음과 같이 역산할 수 있다.
\[t_{\mathrm{ready}}+T_{\mathrm{qualification}}+T_{\mathrm{run}} +T_{\mathrm{collection}}+T_{\mathrm{selection}}\leq t_{\mathrm{deadline}}.\]Platform 대기는 해당 단계에 넣고, 병렬 작업은 중복 합산하지 않고 critical path로 계산한다. 계획값이지 보장된 소요 시간은 아니다. 실행 시간만으로 구한 마지막 시작 시각은 안전한 제출 시각이 아니며, sample 통과와 component 예상 시간의 합도 전체 runtime의 실측값은 아니다.
Inference의 목적에도 제약이 붙는다. Predictor 집합이 $\mathcal S$, 명시한 operator가 $C$라면 다음과 같다.
\[\max_{\mathcal S,C} M\!\left(C(\mathcal S)\right) \quad\text{subject to}\quad T_{\mathrm{complete}}(\mathcal S,C)\leq 540\ \mathrm{minutes}.\]$M$은 하나로 명시한 성능 추정치이지 local·Public을 임의로 합친 점수가 아니다. 상한에 가깝게 시간을 쓴다고 예측이 더 좋아지지는 않는다. Decoding 공유는 전체 비용을 줄일 수 있고, 메모리 경합과 오래 걸리는 study는 늘릴 수 있다. Training target이나 공간 감독을 개선하면 test-time backbone을 추가하지 않고도 배포 모델을 강화할 수 있다. 준비 상태와 관계없이 무조건 우선할 방법은 아니지만 조사할 이유는 된다.
막판에 확장한 조합 일부는 timeout으로 끝났다. 최종 선택에 쓸 결과가 없어진 것이지 AUC가 영인 예측을 만든 것은 아니다. 근거 있는 재시도나 재설계가 여전히 유용할 수 있고, 일시적인 platform 오류라면 상태 확인과 복구가 필요하다. 재현 구현이 잘못됐다면 구현을 고쳐야 한다. 유효한 비교에서 개선이 없었다면 가설이나 연구 배분을 재검토해야 한다. 이를 같은 실패로 취급하면 진전 없이 작업만 반복하기 쉽다.
과학적으로 유용한 질문과 scored fallback이 있다면 near-cap 시도도 합리적일 수 있다. 그러나 준비한 모든 선택지를 실행할 이유는 없다. 여섯 개를 준비했다고 모두 돌릴 필요는 없었다. 그 시간의 대안은 다른 seed, 더 나은 annotation, 전체 recipe의 재현, 준비된 compact package일 수 있었다. 결과 회수와 선택에 필요한 여유도 남겨야 했다.
Complete-or-fail은 내 실행 정책이었지 보편 원칙은 아니다. Budget-adaptive estimator도 배분, 기본값, 일부 stage만 끝났을 때의 동작을 명시하고 검증했다면 정당한 설계가 될 수 있다. 무엇을 실행하는지 조용히 바꾸면서 모든 계산을 마친 ensemble의 정확도를 가져다 쓸 수는 없다. 실행 정책 자체도 prediction 경로와 함께 선택하고 평가해야 한다.
기존 자산의 보존과 연구 배분의 전환
Complete clean OOF, 변하지 않는 model identity, whole-bank replacement search, final-only 구분은 여전히 유용하다. Family를 보존하는 것과 후속 모델에 투자하는 것은 다르다. 과거의 지출이 다음 실험의 가치를 입증하지는 않는다.
나는 standalone이 약하고 local과 Public이 역전된다는 사실을 이미 기록했다. 같은 진단을 다시 적어도 queue는 바뀌지 않았다. 중요한 경고에는 실제 배분 선택이 필요했다. 더 강한 supervision, 준비된 전체 recipe의 재현, 정체된 실험군의 축소, 또는 무엇을 배울지 정한 후속 연구 중에서 골라야 했다. 새 근거나 바뀐 선택 없이 audit만 반복하면 병목은 그대로이고 주의력만 소모된다.
이미 빌린 GPU를 계속 가동하면 하드웨어 시간 낭비는 줄일 수 있다. 그렇다고 계획·해석·배포에 쓸 내 시간이 무한해지지는 않는다. 유용한 장기 학습을 돌리면서 더 중요한 비교를 준비할 수 있었다. 손쉽게 공급할 수 있는 variant가 연구 방향까지 정하게 두어서는 안 됐다. 한 실험군을 줄여도 대회를 계속할 수 있었고 기존 bank를 버릴 필요도 없었다.
6. 다른 대회에 적용할 연구 절차
학습 목표·입력 정보·제약의 초기 점검
다른 프로젝트에서도 먼저 학습 문제를 시험할 수 있을 만큼 구체적으로 정의해야 한다. 실제 평가 target, 관측 training target이 만들어진 과정, inference에서 쓸 수 있는 정보, 평가의 group·time·site 경계, 실제 자원 제약이 그 내용이다. RSNA에서는 판독문의 누락, 임상 기준, 해부학적 coverage, hidden-inference 용량을 처음부터 backbone과 함께 따졌어야 했다.
저렴한 baseline은 그 정의의 잘못을 드러낼 수 있다. 완벽한 도메인 지식을 갖춘 뒤에만 학습하자는 뜻은 아니다. 남은 가정에 따라 첫 본격적인 비교가 달라져야 한다. Target 문제라면 바꾼 supervision과 적절한 learner, 입력 문제라면 빠진 view, 실행 문제라면 실제 workload에 맞는 전체 연산 경로를 시험한다. 잘못된 입력을 발견하는 데 새 OOF bank 전체는 필요하지 않다. 반대로 smoke test로 다른 학습 체계의 최종 가치를 결정할 수도 없다.
일부 사람에게만 outcome이 기록되거나, split이 미래 regime을 놓치거나, 중요한 해부 구조가 learner에 도달하지 않는다면 search를 더 정교하게 할수록 잘못된 문제만 더 잘 풀 수 있다. 기존 search space에 hyperparameter를 추가하기 전에 문제 설정을 바꿔야 할 이유다.
실험 결과별 후속 판단
실행 자체가 잘못된 경우, 해당 조건에서 실제로 개선이 없었던 경우, 근거가 서로 충돌하는 경우, 내려야 할 결정에 직접 답하는 비교를 구분해야 한다.
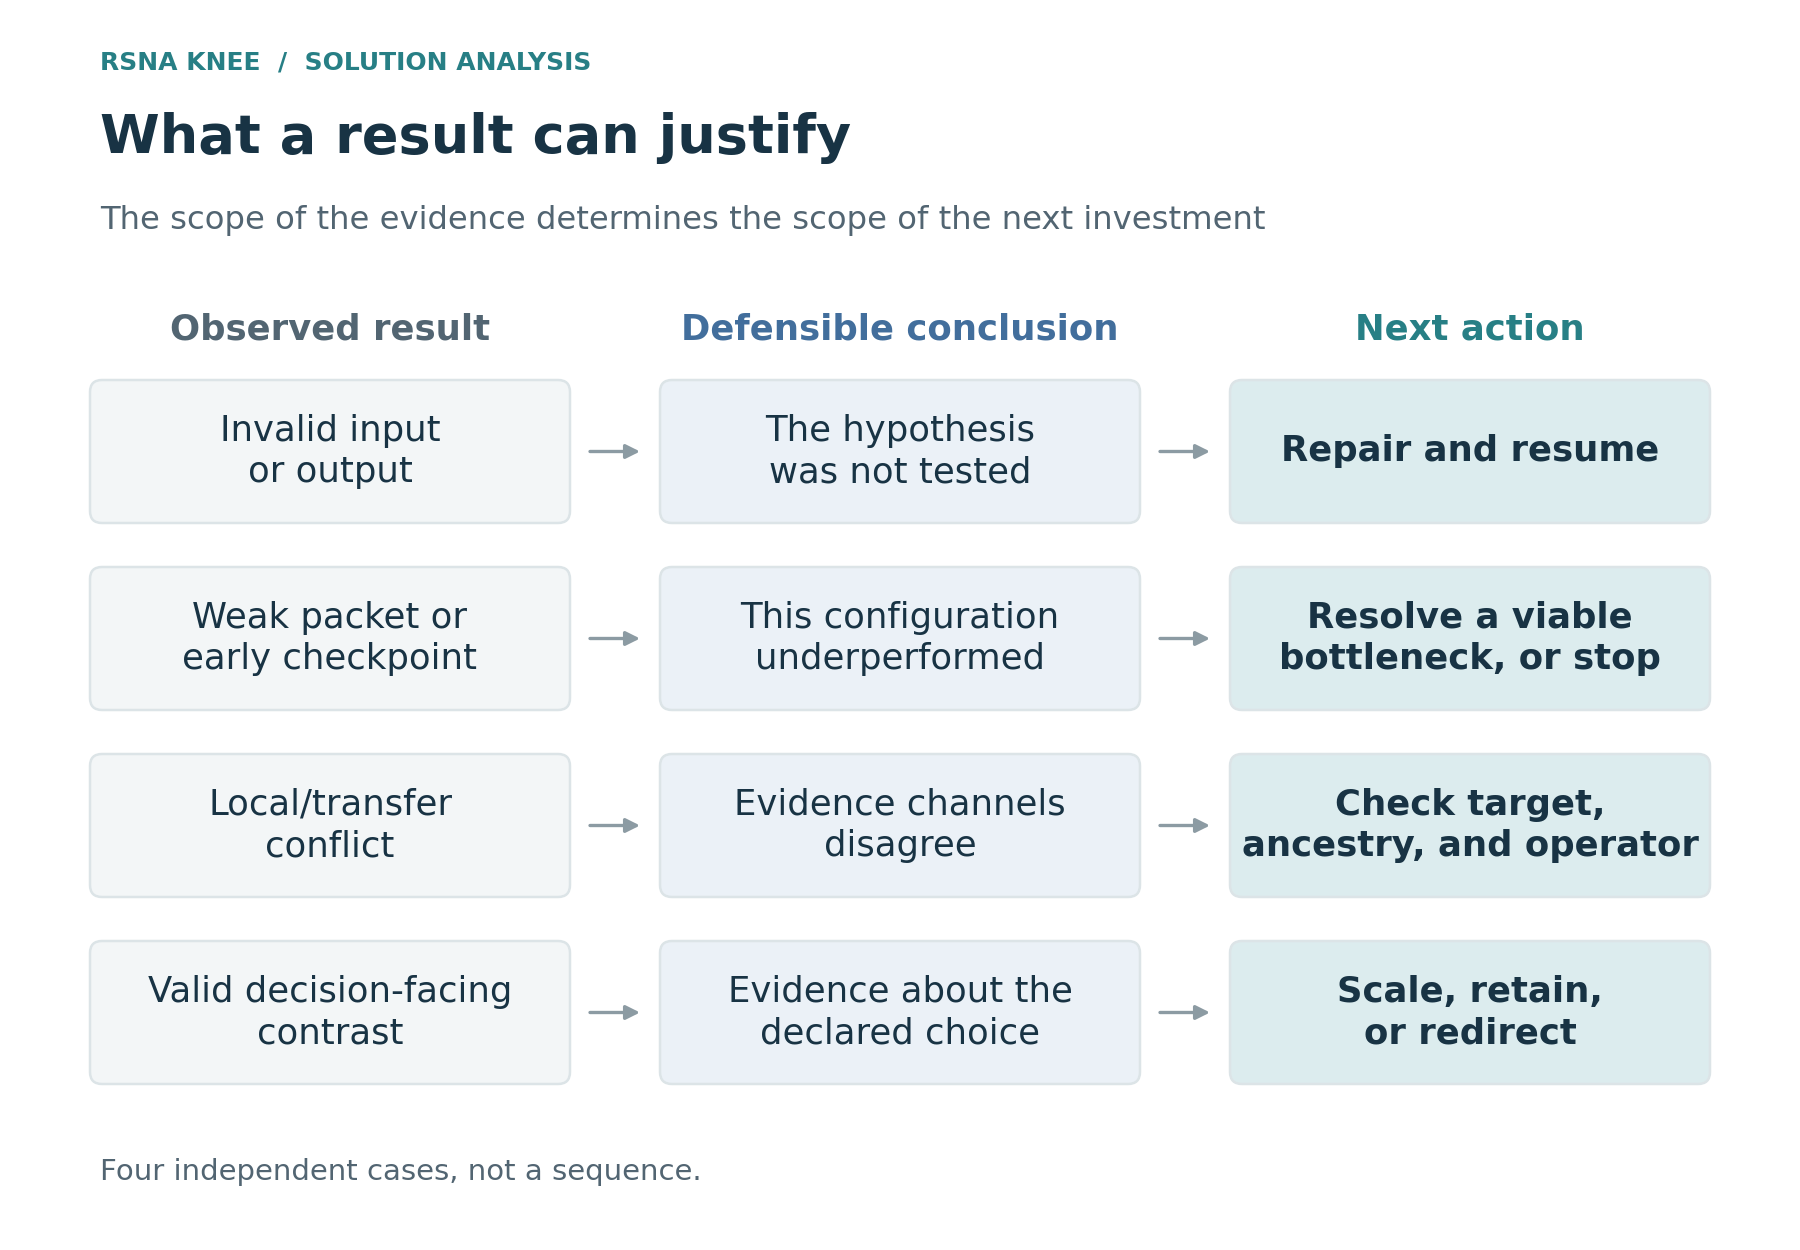
Figure 10. 모든 실험이 순서대로 통과해야 할 단계가 아니라 서로 다른 유형의 증거다. 더 넓은 주장을 하려면 그에 맞는 비교가 필요하다. 해결할 수 있고 아직 확인되지 않은 병목이라면 추가 비교를 할 이유가 있지만, 비용이 지나치게 크거나 필요한 조건이 성립하지 않는다면 중단할 이유도 있다.
입력이나 output이 유효하지 않았다면 고치고, 올바르게 완료한 부분을 재사용해 이어가면 된다. 적절한 전체 비교에서 이득이 없었다면 구체적인 미해결 기전 때문에 추가 시험이 필요한 경우가 아닌 한 해당 실험군을 줄이거나 방향을 바꿔야 한다. 근거가 제한적이라면 무엇을 구분하지 못했는지 적고 그 확인 비용이 타당한지 판단해야 한다. Local과 transfer가 충돌했다면 metric 하나를 언제나 옳다고 정할 것이 아니라 불일치의 원인을 조사해야 한다.
개선이 확인된 결과에도 적용 범위가 있다. Complete family 하나, 같은 runtime의 교체 모델, 또는 미리 정한 Public 비교 하나를 실행할 근거일 수 있다. 개선된 모델에서 만들 수 있는 모든 architecture·target blend·seed에 자동으로 예산이 생기지는 않는다. 결과가 지지한 기전에 맞춰 확대하고, 다음 조건에서 이득이 사라지는지도 알 수 있도록 control을 유지해야 한다.
다음 결정을 위한 짧은 실험 기록
다음 선택을 명확히 해 준다면 기록은 짧아도 된다.
| 판단 항목 | 비용을 쓰기 전에 확인할 질문 | 다음 행동을 바꿀 근거 |
|---|---|---|
| 병목 | 현재 predictor에서 어떤 오류나 부족한 기능이 성능을 제한하는가? | 원인이 다른 기전이라는 증거 |
| 변경과 control | 무엇을 바꾸고 고정하며, learner가 실제로 받는 것은 무엇인가? | 가설을 시험할 수 있는 수준의 matched contrast |
| 평가 | 어떤 target·사례·group 제외 조건·이전 피드백이 비교의 근거인가? | 확인된 reference 또는 배포 경로의 불일치 |
| 전체 비용 | 최종 선택 가능한 예측이 되려면 무엇을 끝내야 하는가? | 준비 상태, critical-path 시간, 미루게 되는 다른 선택지 |
| 결과별 조치 | 개선 확인·개선 없음·실험 무효·판단 보류 뒤에 각각 무엇을 할 것인가? | 다른 실험, 연구 배분, 최종 선택 |
가설이 바뀔 때 기록도 바꾸면 된다. 점수가 나올 때마다 새로운 대형 연구 계획을 만들 필요는 없다. 어느 결과에도 같은 run을 이어갈 것이라면 진단이나 학습 목적은 있을 수 있지만 당장의 선택에는 기여가 작다. 그 목적을 명시해야 일상적인 탐색이 incumbent를 지지하는 근거처럼 보이는 일을 막을 수 있다.
Target 순서, split의 제외 조건, input identity, 선언한 inference 동작은 틀리면 비교가 무효가 되므로 확인할 가치가 있다. 새 failure mode가 없는데 끝난 검사를 반복해도 예측에 필요한 새 정보는 얻지 못한다. Run 수 대신 audit 수를 진전의 척도로 삼아서는 안 된다.
증거에 따른 연구 배분의 변경
세 역할이 함께 필요하다. 현재 쓸 수 있는 predictor, 그 성능을 제한하는 기전을 바꾸려는 본격적인 시도, 그 시도를 해석하는 데 필요한 진단이다. 배분은 고정 비율이 아니라 병목과 준비 상태에 따라 달라져야 한다. 긴 전체 학습 하나에 대부분의 compute를 쓰는 것이 맞을 수 있고, 다른 시점에는 작은 annotation 연구가 그 학습을 준비하는 가장 유용한 작업일 수 있다.
연구 단계를 바꾸는 기준도 몇 주 차인지보다 근거여야 한다. Baseline이 작동하면 target과 view가 충분한지 묻는다. 유용한 전체 recipe가 나오면 complete OOF를 확보하고 실제 parent에 대한 기여를 시험한다. 후속 모델의 개선이 정체되면 bank를 보존하면서 다음 큰 투자를 다른 정보원이나 기전으로 옮긴다. 유용한 공개 시스템이 나오면 fork 목록을 더 만드는 대신 그 역할과 전체 재현·통합 비용을 정한다.
경고에는 실제 조치가 따라야 한다. Standalone이 약하면 더 강해질 근거가 있는 recipe를 찾고, reference의 순위가 반복해서 뒤집히면 selector의 적용 범위를 제한해야 한다. Student는 강하지만 parent에 기여하지 못하면 distillation을 더 하기 전에 교체, compression, 남은 오류를 조사해야 한다. 모든 candidate가 comparator를 standalone으로 이겨야 한다는 규칙이 아니다. 어떤 새 기능을 얻을 수 있어야 그 비용을 쓸 만한지 정하는 조건이다.
마감이 가까워지면 준비된 선택지 중 무엇이 아직 최종 선택을 바꿀 수 있는지가 우선이다. Scored fallback은 가치 있는 막판 시도를 보호하지만 준비·문제 해결·회수·선택 비용을 없애 주지는 않는다. Platform 대기를 포함해 실제로 output을 얻고 결정할 시점부터 역산해야 한다. 이론상 실행을 시작할 수 있는 마지막 시각이 기준은 아니다. Timeout은 해당 시도의 끝이고, 재설계한다면 새로 명시한 비교가 필요하다.
다음 실험은 지금까지의 근거로 확인한 문제에 맞춰 골라야 한다. Target에 필요한 정보가 없을 때, 입력이 그 근거를 놓칠 때, 평가 reference가 잘못된 방향을 지지할 때 필요한 대응은 서로 다르다. 내 OOF 자산은 그런 비교를 시작할 기준으로 남겨 둘 수 있었다. 이를 보존하기 위해 비슷한 후속 모델에 계속 투자할 필요는 없었다.
원문 출처와 비교 범위
각 글에는 서로 다른 개발 과정이 담겨 있다. 라벨표 평가, matched student 실험, component 제거, package 제출, 마감 후 probe로 확인할 수 있는 내용은 서로 다르다. 아래 notebook과 classifier 링크는 operator를 확인할 때 참고한 구현이다.
RB & Matheus & Tucker & Tony, 5th-place solution. Report label의 의미, 평가 fold를 제외하고 fit한 calibration, matched 개선과 여러 변경이 묶인 개선의 구분. ↩︎ ↩︎2 ↩︎3 ↩︎4 ↩︎5 ↩︎6 ↩︎7 ↩︎8 ↩︎9
RSNA hosts, Competition annotation guidance. Positive 기준은 이 대회의 정의이며 일반적인 임상 진단 규칙은 아니다. ↩︎
MURAD, 2nd-place solution. 판독문의 누락, 전체 영상 판독, 소견별 근거 선택, blind read를 더 늘렸을 때의 실패. ↩︎ ↩︎2 ↩︎3 ↩︎4 ↩︎5 ↩︎6 ↩︎7 ↩︎8 ↩︎9 ↩︎10
Barry, 7th-place solution with no external training data. 세 판독 protocol과 소견별 과도한 positive 판단. ↩︎ ↩︎2 ↩︎3 ↩︎4
joinT fusion, 8th-place solution. Image-first disagreement 재판독과 소견별 supervision mixture. ↩︎ ↩︎2 ↩︎3 ↩︎4
Driz Lo, 21st-place solution. 모든 series를 볼 수 있는 viewer, 확률 진단, fixed-epoch student 비교. ↩︎ ↩︎2 ↩︎3 ↩︎4 ↩︎5 ↩︎6 ↩︎7
matsurih, 22nd-place solution. Metadata를 함께 제공한 montage, 영상을 우선하는 framing, 과제별 라벨. ↩︎ ↩︎2 ↩︎3 ↩︎4 ↩︎5 ↩︎6 ↩︎7 ↩︎8 ↩︎9 ↩︎10
sakaku, 1st-place solution: better labels, anatomy-aware MRI models. 같은 우승 팀의 추가 글이다. Matched CoAt 비교, 호출 한도가 정해진 reader, 연속 출력과 Mix5. ↩︎ ↩︎2 ↩︎3 ↩︎4 ↩︎5 ↩︎6 ↩︎7 ↩︎8
Honda Gen-AI EXPs, 32nd-place solution. Report·image가 어긋난 cell 847개를 특정해 바꾼 비교로, 전체 image weight를 바꾼 ablation은 아니다. ↩︎ ↩︎2 ↩︎3 ↩︎4 ↩︎5
chengtingyi, Astra Is All You Need?. Target별 contact sheet, blind-reader의 보완 효과, prompt reference 노출과 annotation 비용 비교. ↩︎
Amanie El-Hajj, 74th-place solution. 소견별 reader 선택과 crop·zoom에 대한 민감도. ↩︎ ↩︎2 ↩︎3 ↩︎4 ↩︎5 ↩︎6
Civitasmass, Multimodal LLM relabeling and OOF self-distillation. 단순 multimodal 판독과 여러 단계의 판독 비교. ↩︎ ↩︎2
129th-place solution. 직접 image reader의 실패와 report-rubric 대안. ↩︎ ↩︎2
tascj, 1st-place solution. 확률값 검토와 trained-guide 비교. ↩︎ ↩︎2 ↩︎3 ↩︎4
the fault in our stars, The Hospital Is a Variable Too. Report group의 전문가 positive rate, level 보정과 counter-test. ↩︎ ↩︎2 ↩︎3
Komil Parmar, 49th-place solution. Reader·schema와 report 정보의 한계. 개별 local-reader 비교는 원문의 라벨 절에 있다. ↩︎ ↩︎2 ↩︎3 ↩︎4
102nd-place solution. Study당 report 응답 스무 개와 명시적인 missing-label 규칙. ↩︎
menphim, 72nd-place solution. Site bias 개입, pooled/within-site 평가, report-reader 추가 비교. ↩︎ ↩︎2 ↩︎3 ↩︎4 ↩︎5
977th-place solution. OAI 실험은 radiograph에서 만든 partial supervision을 썼으며 MOAKS head 사례와 같은 supervision이 아니다. ↩︎ ↩︎2 ↩︎3
tascj, Box-pooling classifier source, 1위 solution. 보관된 코드에서 pooling 연산과 auxiliary head 처리를 확인했다. ↩︎ ↩︎2
tascj, Final inference notebook. 보관된 integration은 두 branch를 1:1로 평균한다. Checkpoint 수와 run group 수는 다르다. ↩︎
MURAD, commit을 고정한 model source, knee-centre/local-view source. 대회 후 rewrite의 정적 코드 확인이며, 원래 submission을 재실행한 결과는 아니다. ↩︎
Volkopat, 73위 KneeSplatNet 설명. Staged reader, geometry prototype과 같은 checkpoint의 knockout, 실제로 최종 선택한 2.5D model ensemble을 구분했다. ↩︎
63위 solution. SSL과 partial-supervision 비교는 작성자의 모델과 reference panel에서 얻은 결과다. ↩︎ ↩︎2 ↩︎3
tascj, Efficiency inference notebook. 보관된 source에서 1,200-study 준비 branch와 packaged TensorRT 구현을 확인했다. ↩︎
hirokenn, 33위 silver solution. Training-only trap, inference-only 개입, acquisition 예측, controlled progression을 실험한 기록. ↩︎ ↩︎2
Akhyar Ahmad, 228위 report-style prior subtraction. Metadata-only prior, 방향 확인, P7/P25의 순서 역전을 다룬다. ↩︎ ↩︎2
246위 report label과 expert label. OA coupling, report-reference에서의 반대 결과, 독립적인 OAI 평가를 다룬다. ↩︎ ↩︎2
Prahas Duggireddy, Own models on radiology reports. 첫 라운드 이득, 이후 plateau, teacher 때문에 생긴 평가 오염을 명시한 기록. ↩︎ ↩︎2
76th-place RSNA Knee AI solution. Gold로 튜닝한 teacher, 반복 generation, matched 실패 사례, 물려받는 supervision. ↩︎
Mikkel Chávez Petersen, 302nd-place solution. 자체 모델 열여덟 개와 standardized-logit 평균을 보고했으며, component별 ablation 표는 제공하지 않는다. ↩︎ ↩︎2
Jay Gautam, 499th-place solution. Study 104건에 대한 배포 경로 replay, gold checkpoint 선택 노출, split-half 선택 규칙, S6 weight. Split을 반복해도 새로운 독립 전문가 사례가 늘지는 않는다. ↩︎
M. Ehtasham, 412th-place solution. S6 outer-arm 비교, 물려받은 소견별 weight, 마지막 stage의 fallback 동작. ↩︎ ↩︎2
Northstar, 65-submission postmortem. S6의 배치 위치, 자체 arm의 한계, 원본·fine-tuned CoAtNet의 inference control. ↩︎ ↩︎2
yu_kuo14, 507th-place solution. Upstream과 반복 선택 노출을 밝힌 전체 경로 gold 평가. ↩︎
Chris Deotte, 243rd-place solution. Hybrid annotation과 공개 3D component를 유지한 2D 몫의 혼합. ↩︎
Robson, 215th-place field-strength rank correction. 보고된 Public correction 과정과 최종 package의 Private 점수는 별개다. ↩︎
Semyon Davshits와 Ivan Safonov, 220th-place solution. Gold-batch를 사용한 한 epoch fine-tune, parameter soup, 최종 multi-reader package. ↩︎
Shivoo29, 348th-place solution. 선택한 공개 혼합, 그 이후의 self-training 결과, 제출하지 않기로 한 외부 pretraining 경로를 구분했다. ↩︎